You are viewing a plain text version of this content. The canonical link for it is here.
Posted to commits@iotdb.apache.org by qi...@apache.org on 2023/07/07 07:37:36 UTC
[iotdb] branch docccccc updated: restructure docs except for SQL-Manual (#10447)
This is an automated email from the ASF dual-hosted git repository.
qiaojialin pushed a commit to branch docccccc
in repository https://gitbox.apache.org/repos/asf/iotdb.git
The following commit(s) were added to refs/heads/docccccc by this push:
new fdd84900174 restructure docs except for SQL-Manual (#10447)
fdd84900174 is described below
commit fdd84900174e580573073cecd29995aec3ef1569
Author: ZhaoXin <x_...@163.com>
AuthorDate: Fri Jul 7 15:37:30 2023 +0800
restructure docs except for SQL-Manual (#10447)
---
.../Syntax-Conventions/Session-And-TsFile-API.md | 2 +-
docs/zh/UserGuide/Tools-System/Benchmark.md | 368 ++
docs/zh/UserGuide/Tools-System/CLI.md | 276 +
.../UserGuide/Tools-System/Import-Export-Tool.md | 427 ++
docs/zh/UserGuide/Tools-System/Maintenance-Tool.md | 388 ++
docs/zh/UserGuide/Tools-System/Monitor-Tool.md | 109 +
.../UserGuide/User-Manuel/Authority-Management.md | 535 ++
.../UserGuide/User-Manuel/Database-Programming.md | 6079 ++++++++++++++++++++
docs/zh/UserGuide/User-Manuel/Delete-Data.md | 160 +
docs/zh/UserGuide/User-Manuel/Operate-Metadata.md | 1182 ++++
.../User-Manuel/Operator-and-Expression.md | 849 +++
docs/zh/UserGuide/User-Manuel/Query-Data.md | 2845 +++++++++
docs/zh/UserGuide/User-Manuel/Syntax-Rule.md | 287 +
docs/zh/UserGuide/User-Manuel/Trigger.md | 467 ++
docs/zh/UserGuide/User-Manuel/Write-Delete-Data.md | 256 +
15 files changed, 14229 insertions(+), 1 deletion(-)
diff --git a/docs/zh/UserGuide/Syntax-Conventions/Session-And-TsFile-API.md b/docs/zh/UserGuide/Syntax-Conventions/Session-And-TsFile-API.md
index 42327c64348..1e209599e15 100644
--- a/docs/zh/UserGuide/Syntax-Conventions/Session-And-TsFile-API.md
+++ b/docs/zh/UserGuide/Syntax-Conventions/Session-And-TsFile-API.md
@@ -19,7 +19,7 @@
-->
-## Session And TsFile API
+# Session And TsFile API
在使用Session、TsFIle API时,如果您调用的方法需要以字符串形式传入物理量(measurement)、设备(device)、数据库(database)、路径(path)等参数,**请保证所传入字符串与使用 SQL 语句时的写法一致**,下面是一些帮助您理解的例子。具体代码示例可以参考:`example/session/src/main/java/org/apache/iotdb/SyntaxConventionRelatedExample.java`
diff --git a/docs/zh/UserGuide/Tools-System/Benchmark.md b/docs/zh/UserGuide/Tools-System/Benchmark.md
new file mode 100644
index 00000000000..da2472ee1f3
--- /dev/null
+++ b/docs/zh/UserGuide/Tools-System/Benchmark.md
@@ -0,0 +1,368 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 概述
+
+IoT-benchmark 是基于 Java 和大数据环境开发的时序数据库基准测试工具,由清华大学软件学院研发并开源。它使用方便,支持多种写入以及查询方式,支持存储测试信息和结果以供进一步查询或分析,支持与 Tableau 集成以可视化测试结果。
+
+下图1-1囊括了测试基准流程及其他扩展功能。这些流程可以由IoT-benchmark 统一来完成。IoT Benchmark 支持多种工作负载,包括**纯写入、纯查询、写入查询混合**等,支持**软硬件系统监控、测试指标度量**等监控功能,还实现了**初始化数据库自动化、测试数据分析及系统参数优化**等功能。
+
+
+
+图1-1
+
+借鉴 YCSB 测试工具将工作负载生成、性能指标测量和数据库接口三个组件分离的设计思想,IoT-benchmark 的模块化设计如图1-2所示。与基于 YCSB 的测试工具系统不同的是,IoT-benchmark 增加了系统监控模块,支持测试数据和系统指标监控数据的持久化。此外也增加了一些特别针对时序数据场景的特殊负载测试功能,如支持物联网场景的批量写入和多种乱序数据写入模式。
+
+
+
+图1-2
+
+
+
+目前 IoT-benchmark 支持如下时间序列数据库、版本和连接方式:
+
+| 数据库 | DB-Engines排名 | 版本 | 连接方式 |
+| --------------- | -------------- | ------- | -------------------------------------------------------- |
+| InfluxDB | 1 | v1.x | SDK |
+| v2.0 | | | |
+| TimescaleDB | 5 | -- | jdbc |
+| OpenTSDB | 8 | -- | Http Request |
+| QuestDB | 10 | v6.0.7 | jdbc |
+| TDengine | 13 | 2.2.0.2 | jdbc |
+| VictoriaMetrics | 16 | v1.64.0 | Http Request |
+| KairosDB | 17 | -- | Http Request |
+| IoTDB | 19 | v1.0 | jdbc、sessionByTablet、sessionByRecord、sessionByRecords |
+| v0.13 | | | |
+
+表1-1大数据测试基准对比
+
+##
+
+## 软件安装与环境搭建
+
+### IoT Benchmark 运行的前置条件
+
+1. Java 8
+2. Maven 3.6+
+3. 对应的合适版本的数据库,如 Apache IoTDB 1.0
+
+
+
+### IoT Benchmark 的获取方式
+
+- **获取二进制包**:进入https://github.com/thulab/iot-benchmark/releases 下载需要的安装包。下载下来为一个压缩文件,选择文件夹解压即可使用。
+- 源代码编译(可用户 Apache IoTDB 1.0 的测试):
+ - 第一步(编译 IoTDB Session 最新包):进入官网 https://github.com/apache/iotdb/tree/rel/1.0 下载 IoTDB 源码,在根目录下运行命令 mvn clean package install -pl session -am -DskipTests 编译 IoTDB Session 的最新包。
+ - 第二步(编译 IoTDB Benchmark 测试包):进入官网 https://github.com/thulab/iot-benchmark 下载源码,在根目录下运行 mvn clean package install -pl iotdb-1.0 -am -DskipTests 编译测试 Apache IoTDB 1.0版本的测试包,测试包位置与根目录的相对路径为 ./iotdb-1.0/target/iotdb-1.0-0.0.1/iotdb-1.0-0.0.1
+
+
+
+### IoT Benchmark 的测试包结构
+
+测试包的目录结构如下图1-3所示。其中测试配置文件为conf/config.properties,测试启动脚本为benchmark.sh (Linux & MacOS) 和 benchmark.bat (Windows),详细文件用途见表1-2所示。
+
+
+
+图1-3文件和文件夹列表
+
+| 名称 | 子文件 | 用途 |
+| ---------------- | ----------------- | ------------------------- |
+| benchmark.bat | - | Windows环境运行启动脚本 |
+| benchmark.sh | - | Linux/Mac环境运行启动脚本 |
+| conf | config.properties | 测试场景配置文件 |
+| logback.xml | 日志输出配置文件 | |
+| lib | - | 依赖库文件 |
+| LICENSE | - | 许可文件 |
+| bin | startup.sh | 初始化脚本文件夹 |
+| ser-benchmark.sh | - | 监控模式启动脚本 |
+
+表1-2文件和文件夹列表用途
+
+### IoT Benchmark 执行测试
+
+1. 按照测试需求修改配置文件,主要参数介绍见 1.2 节,对应配置文件为conf/config.properties,**比如测试****Apache** **IoTDB 1.0,则需要修改 DB_SWITCH=IoTDB-100-SESSION_BY_TABLET**
+2. 启动被测时间序列数据库
+3. 通过运行
+4. 启动IoT-benchmark执行测试。执行中观测被测时间序列数据库和IoT-benchmark状态,执行完毕后查看结果和分析测试过程。
+
+### IoT Benchmark 结果说明
+
+测试的所有日志文件被存放于 logs 文件夹下,测试的结果在测试完成后被存放到 data/csvOutput 文件夹下,例如测试后我们得到了如下的结果矩阵:
+
+
+
+- Result Matrix
+ - OkOperation:成功的对应操作次数
+ - OkPoint:对于写入操作,是成功写入的点数;对于查询操作,是成功查询到的点数。
+ - FailOperation:失败的对应操作次数
+ - FailPoint:对于写入操作是写入失败的点数
+- Latency(mx) Matrix
+ - AVG:操作平均耗时
+ - MIN:操作最小耗时
+ - Pn:操作整体分布的对应分位值,比如P25是下四分位数
+
+
+
+## 主要参数介绍
+
+本节重点解释说明了主要参数的用途和配置方法。
+
+### 工作模式和操作比例
+
+- 工作模式参数“BENCHMARK_WORK_MODE”可选项为“默认模式”和“服务器监控”;其中“服务器监控”模式可直接通过执行ser-benchmark.sh脚本启动,脚本会自动修改该参数。“默认模式”为常用测试模式,结合配置OPERATION_PROPORTION参数达到“纯写入”、“纯查询”和“读写混合”的测试操作比例定义
+
+- 当运行ServerMode来执行被测时序数据库运行环境监控时IoT-benchmark依赖sysstat软件相关命令;如果需要持久化测试过程数据时选择MySQL或IoTDB,则需要安装该类数据库;ServerMode和CSV的记录模式只能在Linux系统中使用,记录测试过程中的相关系统信息。因此我们建议使用MacOs或Linux系统,本文以Linux(Centos7)系统为例,如果使用Windows系统,可以使用conf文件夹下的benchmark.bat脚本启动IoT-benchmark。
+
+ 表1-3测试模式
+
+| 模式名称 | BENCHMARK_WORK_MODE | 模式内容 |
+| ---------------------- | ------------------- | ------------------------------------------------------------ |
+| 常规测试模式 | testWithDefaultPath | 支持多种读和写操作的混合负载 |
+| 服务器资源使用监控模式 | serverMODE | 服务器资源使用监控模式(该模式下运行通过ser-benchmark.sh脚本启动,无需手动配置该参数 |
+
+### 服务器连接信息
+
+工作模式指定后,被测时序数据库的信息要如何告知IoT-benchmark呢?当前通过“DB_SWITCH”告知被测时序数据库类型;通过“HOST”告知被测时序数据库网络地址;通过“PORT”告知被测时序数据库网络端口;通过“USERNAME”告知被测时序数据库登录用户名;通过“PASSWORD”告知被测时序数据库登录用户的密码;通过“DB_NAME”告知被测时序数据库名称;通过“TOKEN”告知被测时序数据库连接认证Token(InfluxDB 2.0使用);
+
+### 写入场景构建参数
+
+表1-4写入场景构建参数
+
+| 参数名称 | 类型 | 示例 | 系统描述 |
+| -------------------------- | ------ | ------------------------- | ------------------------------------------------------------ |
+| CLIENT_NUMBER | 整数 | 100 | 客户端总数 |
+| GROUP_NUMBER | 整数 | 20 | 存储组的数量;仅针对IoTDB。 |
+| DEVICE_NUMBER | 整数 | 100 | 设备总数 |
+| SENSOR_NUMBER | 整数 | 300 | 每个设备的传感器总数 |
+| INSERT_DATATYPE_PROPORTION | 字符串 | 1:1:1:1:1:1 | 设备的数据类型比例,BOOLEAN:INT32:INT64:FLOAT:DOUBLE:TEXT |
+| POINT_STEP | 整数 | 1000 | 数据间时间戳间隔,即生成的数据两个时间戳之间的固定长度。 |
+| OP_MIN_INTERVAL | 整数 | 0 | 操作最小执行间隔:若操作耗时大于该值则立即执行下一个,否则等待 (OP_MIN_INTERVAL-实际执行时间) ms;如果为0,则参数不生效;如果为-1,则其值和POINT_STEP一致 |
+| IS_OUT_OF_ORDER | 布尔 | false | 是否乱序写入 |
+| OUT_OF_ORDER_RATIO | 浮点数 | 0.3 | 乱序写入的数据比例 |
+| BATCH_SIZE_PER_WRITE | 整数 | 1 | 批写入数据行数(一次写入多少行数据) |
+| START_TIME | 时间 | 2022-10-30T00:00:00+08:00 | 写入数据的开始时间戳;以该时间戳为起点开始模拟创建数据时间戳。 |
+| LOOP | 整数 | 86400 | 总操作次数:具体每种类型操作会按OPERATION_PROPORTION定义的比例划分 |
+| OPERATION_PROPORTION | 字符 | 1:0:0:0:0:0:0:0:0:0:0 | # 各操作的比例,按照顺序为 写入:Q1:Q2:Q3:Q4:Q5:Q6:Q7:Q8:Q9:Q10, 请注意使用英文冒号。比例中的每一项是整数。 |
+
+按照表1-4配置参数启动可描述测试场景为:向被测时序数据库压力写入30000个(100个设备,每个设备300个传感器)时间序列2022年10月30日一天的顺序数据,总计25.92亿个数据点。其中每个设备的300个传感器数据类型分别为50个布尔、50个整数、50个长整数、50个浮点、50个双精度、50个字符。如果我们将表格中IS_OUT_OF_ORDER的值改为true,那么他表示的场景为:向被测时序数据库压力写入30000个时间序列2022年10月30日一天的数据,其中存在30%的乱序数据(到达时序数据库时间晚于其他生成时间晚于自身的数据点)。
+
+### 查询场景构建参数
+
+表1-5查询场景构建参数
+
+| 参数名称 | 类型 | 示例 | 系统描述 |
+| -------------------- | ---- | --------------------- | ------------------------------------------------------------ |
+| QUERY_DEVICE_NUM | 整数 | 2 | 每条查询语句中查询涉及到的设备数量 |
+| QUERY_SENSOR_NUM | 整数 | 2 | 每条查询语句中查询涉及到的传感器数量 |
+| QUERY_AGGREGATE_FUN | 字符 | count | 在聚集查询中使用的聚集函数,比如count、avg、sum、max_time等 |
+| STEP_SIZE | 整数 | 1 | 时间过滤条件的时间起点变化步长,若设为0则每个查询的时间过滤条件是一样的,单位:POINT_STEP |
+| QUERY_INTERVAL | 整数 | 250000 | 起止时间的查询中开始时间与结束时间之间的时间间隔,和Group By中的时间间隔 |
+| QUERY_LOWER_VALUE | 整数 | -5 | 条件查询子句时的参数,where xxx > QUERY_LOWER_VALUE |
+| GROUP_BY_TIME_UNIT | 整数 | 20000 | Group by语句中的组的大小 |
+| LOOP | 整数 | 10 | 总操作次数:具体每种类型操作会按OPERATION_PROPORTION定义的比例划分 |
+| OPERATION_PROPORTION | 字符 | 0:0:0:0:0:0:0:0:0:0:1 | 写入:Q1:Q2:Q3:Q4:Q5:Q6:Q7:Q8:Q9:Q10 |
+
+表1-6查询类型及示例 SQL
+
+| 编号 | 查询类型 | IoTDB 示例 SQL |
+| ---- | ---------------------------- | ------------------------------------------------------------ |
+| Q1 | 精确点查询 | select v1 from root.db.d1 where time = ? |
+| Q2 | 时间范围查询 | select v1 from root.db.d1 where time > ? and time < ? |
+| Q3 | 带值过滤的时间范围查询 | select v1 from root.db.d1 where time > ? and time < ? and v1 > ? |
+| Q4 | 时间范围聚合查询 | select count(v1) from root.db.d1 where and time > ? and time < ? |
+| Q5 | 带值过滤的全时间范围聚合查询 | select count(v1) from root.db.d1 where v1 > ? |
+| Q6 | 带值过滤的时间范围聚合查询 | select count(v1) from root.db.d1 where v1 > ? and time > ? and time < ? |
+| Q7 | 时间分组聚合查询 | select count(v1) from root.db.d1 group by ([?, ?), ?, ?) |
+| Q8 | 最新点查询 | select last v1 from root.db.d1 |
+| Q9 | 倒序范围查询 | select v1 from root.sg.d1 where time > ? and time < ? order by time desc |
+| Q10 | 倒序带值过滤的范围查询 | select v1 from root.sg.d1 where time > ? and time < ? and v1 > ? order by time desc |
+
+
+
+
+
+按照表1-5配置参数启动可描述测试场景为:从被测时序数据库执行10次2个设备2个传感器的倒序带值过滤的范围查询,SQL语句为:select s_0,s_31from data where time >2022-10-30T00:00:00+08:00 and time < 2022-10-30T00:04:10+08:00 and s_0 > -5 and device in d_21,d_46 order by time desc。
+
+### 测试过程和测试结果持久化
+
+IoT-benchmark目前支持通过配置参数“TEST_DATA_PERSISTENCE”将测试过程和测试结果持久化到IoTDB、MySQL和CSV;其中写入到MySQL和CSV可以定义分库分表的行数上限,例如“RECORD_SPLIT=true、RECORD_SPLIT_MAX_LINE=10000000”表示每个数据库表或CSV文件按照总行数为1千万切分存放;如果记录到MySQL或IoTDB需要提供数据库链接信息,分别包括“TEST_DATA_STORE_IP”数据库的IP地址、“TEST_DATA_STORE_PORT”数据库的端口号、“TEST_DATA_STORE_DB”数据库的名称、“TEST_DATA_STORE_USER”数据库用户名、“TEST_DATA_STORE_PW”数据库用户密码。
+
+如果我们设置“TEST_DATA_PERSISTENCE=CSV”,测试执行时和执行完毕后我们可以在IoT-benchmark根目录下看到新生成的data文件夹,其下包含csv文件夹记录测试过程;csvOutput文件夹记录测试结果。如果我们设置“TEST_DATA_PERSISTENCE=MySQL”,它会在测试开始前在指定的MySQL数据库中创建命名如“testWithDefaultPath_被测数据库名称_备注_测试启动时间”的数据表记录测试过程;会在名为“CONFIG”的数据表(如果不存在则创建该表),写入本次测试的配置信息;当测试完成时会在名为“FINAL_RESULT”的数据表(如果不存在则创建该表)中写入本次测试结果。
+
+# 实际案例
+
+我们以中车青岛四方车辆研究所有限公司应用为例,参考《ApacheIoTDB在智能运维平台存储中的应用》中描述的场景进行实际操作说明。
+
+测试目标:模拟中车青岛四方所场景因切换时间序列数据库实际需求,对比预期使用的IoTDB和原有系统使用的KairosDB性能。
+
+测试环境:为了保证在实验过程中消除其他无关服务与进程对数据库性能的影响,以及不同数据库之间的相互影响,本实验中的本地数据库均部署并运行在资源配置相同的多个独立的虚拟机上。因此,本实验搭建了 4 台 Linux( CentOS7 /x86) 虚拟机,并分别在上面部署了IoT-benchmark、 IoTDB数据库、KairosDB数据库、MySQL数据库。每一台虚拟机的具体资源配置如表2-1所示。每一台虚拟机的具体用途如表2-2所示。
+
+表2-1虚拟机配置信息
+
+| 硬件配置信息 | 系统描述 |
+| ------------ | -------- |
+| OS System | CentOS7 |
+| CPU核数 | 16 |
+| 内存 | 32G |
+| 硬盘 | 200G |
+| 网卡 | 千兆 |
+
+
+
+表2-2虚拟机用途
+
+| IP | 用途 |
+| ---------- | ------------- |
+| 172.21.4.2 | IoT-benchmark |
+| 172.21.4.3 | Apache-iotdb |
+| 172.21.4.4 | KaiosDB |
+| 172.21.4.5 | MySQL |
+
+## 写入测试
+
+场景描述:创建100个客户端来模拟100列车、每列车3000个传感器、数据类型为DOUBLE类型、数据时间间隔为500ms(2Hz)、顺序发送。参考以上需求我们需要修改IoT-benchmark配置参数如表2-3中所列。
+
+表2-3配置参数信息
+
+| 参数名称 | IoTDB值 | KairosDB值 |
+| -------------------------- | --------------------------- | ---------- |
+| DB_SWITCH | IoTDB-013-SESSION_BY_TABLET | KairosDB |
+| HOST | 172.21.4.3 | 172.21.4.4 |
+| PORT | 6667 | 8080 |
+| BENCHMARK_WORK_MODE | testWithDefaultPath | |
+| OPERATION_PROPORTION | 1:0:0:0:0:0:0:0:0:0:0 | |
+| CLIENT_NUMBER | 100 | |
+| GROUP_NUMBER | 10 | |
+| DEVICE_NUMBER | 100 | |
+| SENSOR_NUMBER | 3000 | |
+| INSERT_DATATYPE_PROPORTION | 0:0:0:0:1:0 | |
+| POINT_STEP | 500 | |
+| OP_MIN_INTERVAL | 0 | |
+| IS_OUT_OF_ORDER | false | |
+| BATCH_SIZE_PER_WRITE | 1 | |
+| LOOP | 10000 | |
+| TEST_DATA_PERSISTENCE | MySQL | |
+| TEST_DATA_STORE_IP | 172.21.4.5 | |
+| TEST_DATA_STORE_PORT | 3306 | |
+| TEST_DATA_STORE_DB | demo | |
+| TEST_DATA_STORE_USER | root | |
+| TEST_DATA_STORE_PW | admin | |
+| REMARK | demo | |
+
+首先在172.21.4.3和172.21.4.4上分别启动被测时间序列数据库Apache-IoTDB和KairosDB,之后在172.21.4.2、172.21.4.3和172.21.4.4上通过ser-benchamrk.sh脚本启动服务器资源监控(图2-1)。然后按照表2-3在172.21.4.2分别修改iotdb-0.13-0.0.1和kairosdb-0.0.1文件夹内的conf/config.properties文件满足测试需求。先后使用benchmark.sh启动对Apache-IoTDB和KairosDB的写入测试。
+
+
+
+图2-1服务器监控任务
+
+ 例如我们首先启动对KairosDB的测试,IoT-benchmark会在MySQL数据库中创建CONFIG数据表存放本次测试配置信息(图2-2),测试执行中会有日志输出当前测试进度(图2-3)。测试完成时会输出本次测试结果(图2-3),同时将结果写入FINAL_RESULT数据表中(图2-4)。
+
+
+
+图2-2测试配置信息表
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+
+图2-3测试进度和结果
+
+
+
+图2-4测试结果表
+
+之后我们再启动对Apache-IoTDB的测试,同样的IoT-benchmark会在MySQL数据库CONFIG数据表中写入本次测试配置信息,测试执行中会有日志输出当前测试进度。测试完成时会输出本次测试结果,同时将结果写入FINAL_RESULT数据表中。
+
+依照测试结果信息我们知道同样的配置写入Apache-IoTDB和KairosDB写入延时时间分别为:55.98ms和1324.45ms;写入吞吐分别为:5,125,600.86点/秒和224,819.01点/秒;测试分别执行了585.30秒和11777.99秒。并且KairosDB有写入失败出现,排查后发现是数据磁盘使用率已达到100%,无磁盘空间继续接收数据。而Apache-IoTDB无写入失败现象,全部数据写入完毕后占用磁盘空间仅为4.7G(如图2-5所示);从写入吞吐和磁盘占用情况上看Apache-IoTDB均优于KairosDB。当然后续还有其他测试来从多方面观察和对比,比如查询性能、文件压缩比、数据安全性等。
+
+
+
+图2-5磁盘使用情况
+
+那么测试过程中各个服务器资源使用情况如何呢?每个写操作具体的表现如何呢?这个时候我们就可以通过安装和使用Tableau来可视化服务器监控表和测试过程记录表内的数据了。Tableau的使用本文不展开介绍,通过它连接测试数据持久化的数据表后具体结果下如图(以Apache-IoTDB为例):
+
+
+
+
+
+图2-6Tableau可视化测试过程
+
+
+
+## 查询测试
+
+场景描述:在写入测试场景下模拟10个客户端对时序数据库Apache-IoTDB内存放的数据进行全类型查询任务。配置如下:
+
+表2-4配置参数信息
+
+| 参数名称 | 示例 |
+| -------------------- | --------------------- |
+| CLIENT_NUMBER | 100 |
+| QUERY_DEVICE_NUM | 2 |
+| QUERY_SENSOR_NUM | 2 |
+| QUERY_AGGREGATE_FUN | count |
+| STEP_SIZE | 1 |
+| QUERY_INTERVAL | 250000 |
+| QUERY_LOWER_VALUE | -5 |
+| GROUP_BY_TIME_UNIT | 20000 |
+| LOOP | 30 |
+| OPERATION_PROPORTION | 0:1:1:1:1:1:1:1:1:1:1 |
+
+执行结果:
+
+
+
+图2-7查询测试结果
+
+## 其他参数说明
+
+之前章节中针对Apache-IoTDB和KairosDB进行写入性能对比,但是用户如果要执行模拟真实写入速率测试该如何配置?测试时间过长该如何控制呢?生成的模拟数据有哪些规律吗?如果IoT-Benchmark服务器配置较低,可以使用多台机器模拟压力输出吗?
+
+表2-5配置参数信息
+
+| 场景 | 参数 | 值 | 说明 |
+| ------------------------------------------------------------ | -------------------------- | ------------------------------------------------------------ | --------------------------------- |
+| 模拟真实写入速率 | OP_INTERVAL | -1 | 也可输入整数控制操作间隔 |
+| 指定测试时长(1小时) | TEST_MAX_TIME | 3600000 | 单位 ms;需要LOOP执行时间大于该值 |
+| 定义模拟数据规律:支持全部数据类型,数量平均分类;支持五种数据分布,数量平均分布;字符串长度为10;小数位数为2 | INSERT_DATATYPE_PROPORTION | 1:1:1:1:1:1 | 数据类型分布比率 |
+| LINE_RATIO | 1 | 线性 | |
+| SIN_RATIO | 1 | 傅里叶函数 | |
+| SQUARE_RATIO | 1 | 方波 | |
+| RANDOM_RATIO | 1 | 随机数 | |
+| CONSTANT_RATIO | 1 | 常数 | |
+| STRING_LENGTH | 10 | 字符串长度 | |
+| DOUBLE_LENGTH | 2 | 小数位数 | |
+| 三台机器模拟300台设备数据写入 | BENCHMARK_CLUSTER | true | 开启多benchmark模式 |
+| BENCHMARK_INDEX | 0、1、3 | 以2.3章节写入参数为例:0号负责设备编号0~99数据写入;1号负责设备编号100~199数据写入;2号负责设备点好200~299数据写入; | |
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Tools-System/CLI.md b/docs/zh/UserGuide/Tools-System/CLI.md
new file mode 100644
index 00000000000..2ef4bb3fd3c
--- /dev/null
+++ b/docs/zh/UserGuide/Tools-System/CLI.md
@@ -0,0 +1,276 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# SQL 命令行终端 (CLI)
+
+IOTDB 为用户提供 cli/Shell 工具用于启动客户端和服务端程序。下面介绍每个 cli/Shell 工具的运行方式和相关参数。
+> \$IOTDB\_HOME 表示 IoTDB 的安装目录所在路径。
+
+## 安装
+如果使用源码版,可以在 iotdb 的根目录下执行
+
+```shell
+> mvn clean package -pl cli -am -DskipTests
+```
+
+在生成完毕之后,IoTDB 的 Cli 工具位于文件夹"cli/target/iotdb-cli-{project.version}"中。
+
+如果你下载的是二进制版,那么 Cli 可以在 sbin 文件夹下直接找到。
+
+## 运行
+
+### Cli 运行方式
+安装后的 IoTDB 中有一个默认用户:`root`,默认密码为`root`。用户可以使用该用户尝试运行 IoTDB 客户端以测试服务器是否正常启动。客户端启动脚本为$IOTDB_HOME/sbin 文件夹下的`start-cli`脚本。启动脚本时需要指定运行 IP 和 RPC PORT。以下为服务器在本机启动,且用户未更改运行端口号的示例,默认端口为 6667。若用户尝试连接远程服务器或更改了服务器运行的端口号,请在-h 和-p 项处使用服务器的 IP 和 RPC PORT。<br>
+用户也可以在启动脚本的最前方设置自己的环境变量,如 JAVA_HOME 等 (对于 linux 用户,脚本路径为:"/sbin/start-cli.sh"; 对于 windows 用户,脚本路径为:"/sbin/start-cli.bat")
+
+Linux 系统与 MacOS 系统启动命令如下:
+
+```shell
+Shell > bash sbin/start-cli.sh -h 127.0.0.1 -p 6667 -u root -pw root
+```
+Windows 系统启动命令如下:
+
+```shell
+Shell > sbin\start-cli.bat -h 127.0.0.1 -p 6667 -u root -pw root
+```
+回车后即可成功启动客户端。启动后出现如图提示即为启动成功。
+
+```
+ _____ _________ ______ ______
+|_ _| | _ _ ||_ _ `.|_ _ \
+ | | .--.|_/ | | \_| | | `. \ | |_) |
+ | | / .'`\ \ | | | | | | | __'.
+ _| |_| \__. | _| |_ _| |_.' /_| |__) |
+|_____|'.__.' |_____| |______.'|_______/ version <version>
+
+Successfully login at 127.0.0.1:6667
+```
+输入`quit`或`exit`可退出 cli 结束本次会话,cli 输出`quit normally`表示退出成功。
+
+### Cli 运行参数
+
+|参数名|参数类型|是否为必需参数| 说明| 例子 |
+|:---|:---|:---|:---|:---|
+|-disableISO8601 |没有参数 | 否 |如果设置了这个参数,IoTDB 将以数字的形式打印时间戳 (timestamp)。|-disableISO8601|
+|-h <`host`> |string 类型,不需要引号|是|IoTDB 客户端连接 IoTDB 服务器的 IP 地址。|-h 10.129.187.21|
+|-help|没有参数|否|打印 IoTDB 的帮助信息|-help|
+|-p <`rpcPort`>|int 类型|是|IoTDB 连接服务器的端口号,IoTDB 默认运行在 6667 端口。|-p 6667|
+|-pw <`password`>|string 类型,不需要引号|否|IoTDB 连接服务器所使用的密码。如果没有输入密码 IoTDB 会在 Cli 端提示输入密码。|-pw root|
+|-u <`username`>|string 类型,不需要引号|是|IoTDB 连接服务器锁使用的用户名。|-u root|
+|-maxPRC <`maxPrintRowCount`>|int 类型|否|设置 IoTDB 返回客户端命令行中所显示的最大行数。|-maxPRC 10|
+|-e <`execute`> |string 类型|否|在不进入客户端输入模式的情况下,批量操作 IoTDB|-e "show databases"|
+|-c | 空 | 否 | 如果服务器设置了 `rpc_thrift_compression_enable=true`, 则 CLI 必须使用 `-c` | -c |
+
+下面展示一条客户端命令,功能是连接 IP 为 10.129.187.21 的主机,端口为 6667 ,用户名为 root,密码为 root,以数字的形式打印时间戳,IoTDB 命令行显示的最大行数为 10。
+
+Linux 系统与 MacOS 系统启动命令如下:
+
+```shell
+Shell > bash sbin/start-cli.sh -h 10.129.187.21 -p 6667 -u root -pw root -disableISO8601 -maxPRC 10
+```
+Windows 系统启动命令如下:
+
+```shell
+Shell > sbin\start-cli.bat -h 10.129.187.21 -p 6667 -u root -pw root -disableISO8601 -maxPRC 10
+```
+
+### CLI 特殊命令
+下面列举了一些CLI的特殊命令。
+
+| 命令 | 描述 / 例子 |
+|:---|:---|
+| `set time_display_type=xxx` | 例如: long, default, ISO8601, yyyy-MM-dd HH:mm:ss |
+| `show time_display_type` | 显示时间显示方式 |
+| `set time_zone=xxx` | 例如: +08:00, Asia/Shanghai |
+| `show time_zone` | 显示CLI的时区 |
+| `set fetch_size=xxx` | 设置从服务器查询数据时的读取条数 |
+| `show fetch_size` | 显示读取条数的大小 |
+| `set max_display_num=xxx` | 设置 CLI 一次展示的最大数据条数, 设置为-1表示无限制 |
+| `help` | 获取CLI特殊命令的提示 |
+| `exit/quit` | 退出CLI |
+
+### 使用 OpenID 作为用户名认证登录
+
+OpenID Connect (OIDC) 使用 keycloack 作为 OIDC 服务权限认证服务。
+
+#### 配置
+配置位于 iotdb-common.properties,设定 authorizer_provider_class 为 org.apache.iotdb.commons.auth.authorizer.OpenIdAuthorizer 则开启了 openID 服务,默认情况下值为 org.apache.iotdb.commons.auth.authorizer.LocalFileAuthorizer 表示没有开启 openID 服务。
+
+```
+authorizer_provider_class=org.apache.iotdb.commons.auth.authorizer.OpenIdAuthorizer
+```
+如果开启了 openID 服务则 openID_url 为必填项,openID_url 值为 http://ip:port/realms/{realmsName}
+
+```
+openID_url=http://127.0.0.1:8080/realms/iotdb/
+```
+####keycloack 配置
+
+1、下载 keycloack 程序(此教程为21.1.0版本),在 keycloack/bin 中启动 keycloack
+
+```shell
+Shell > cd bin
+Shell > ./kc.sh start-dev
+```
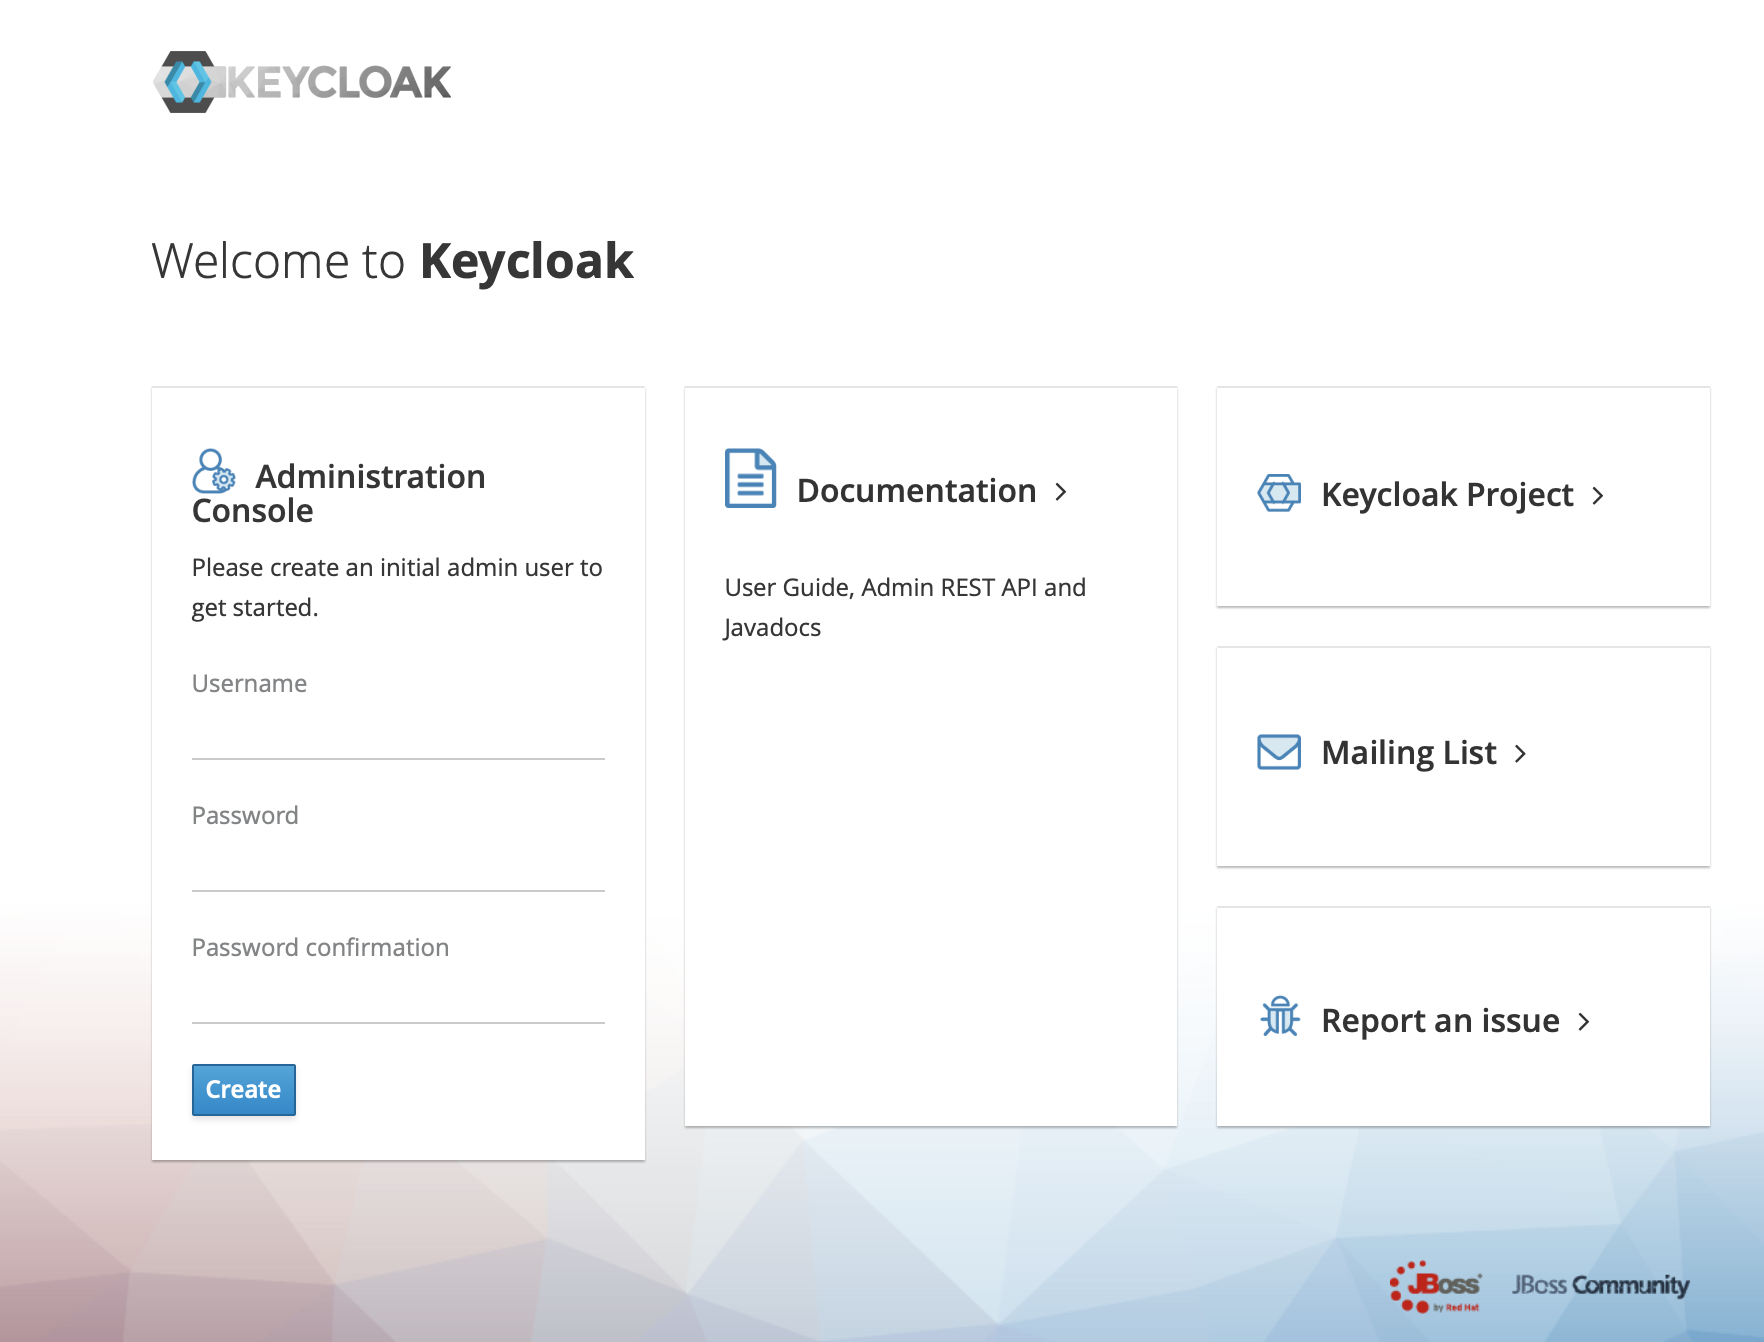
+2、使用 https://ip:port 登陆 keycloack, 首次登陆需要创建用户
+
+
+
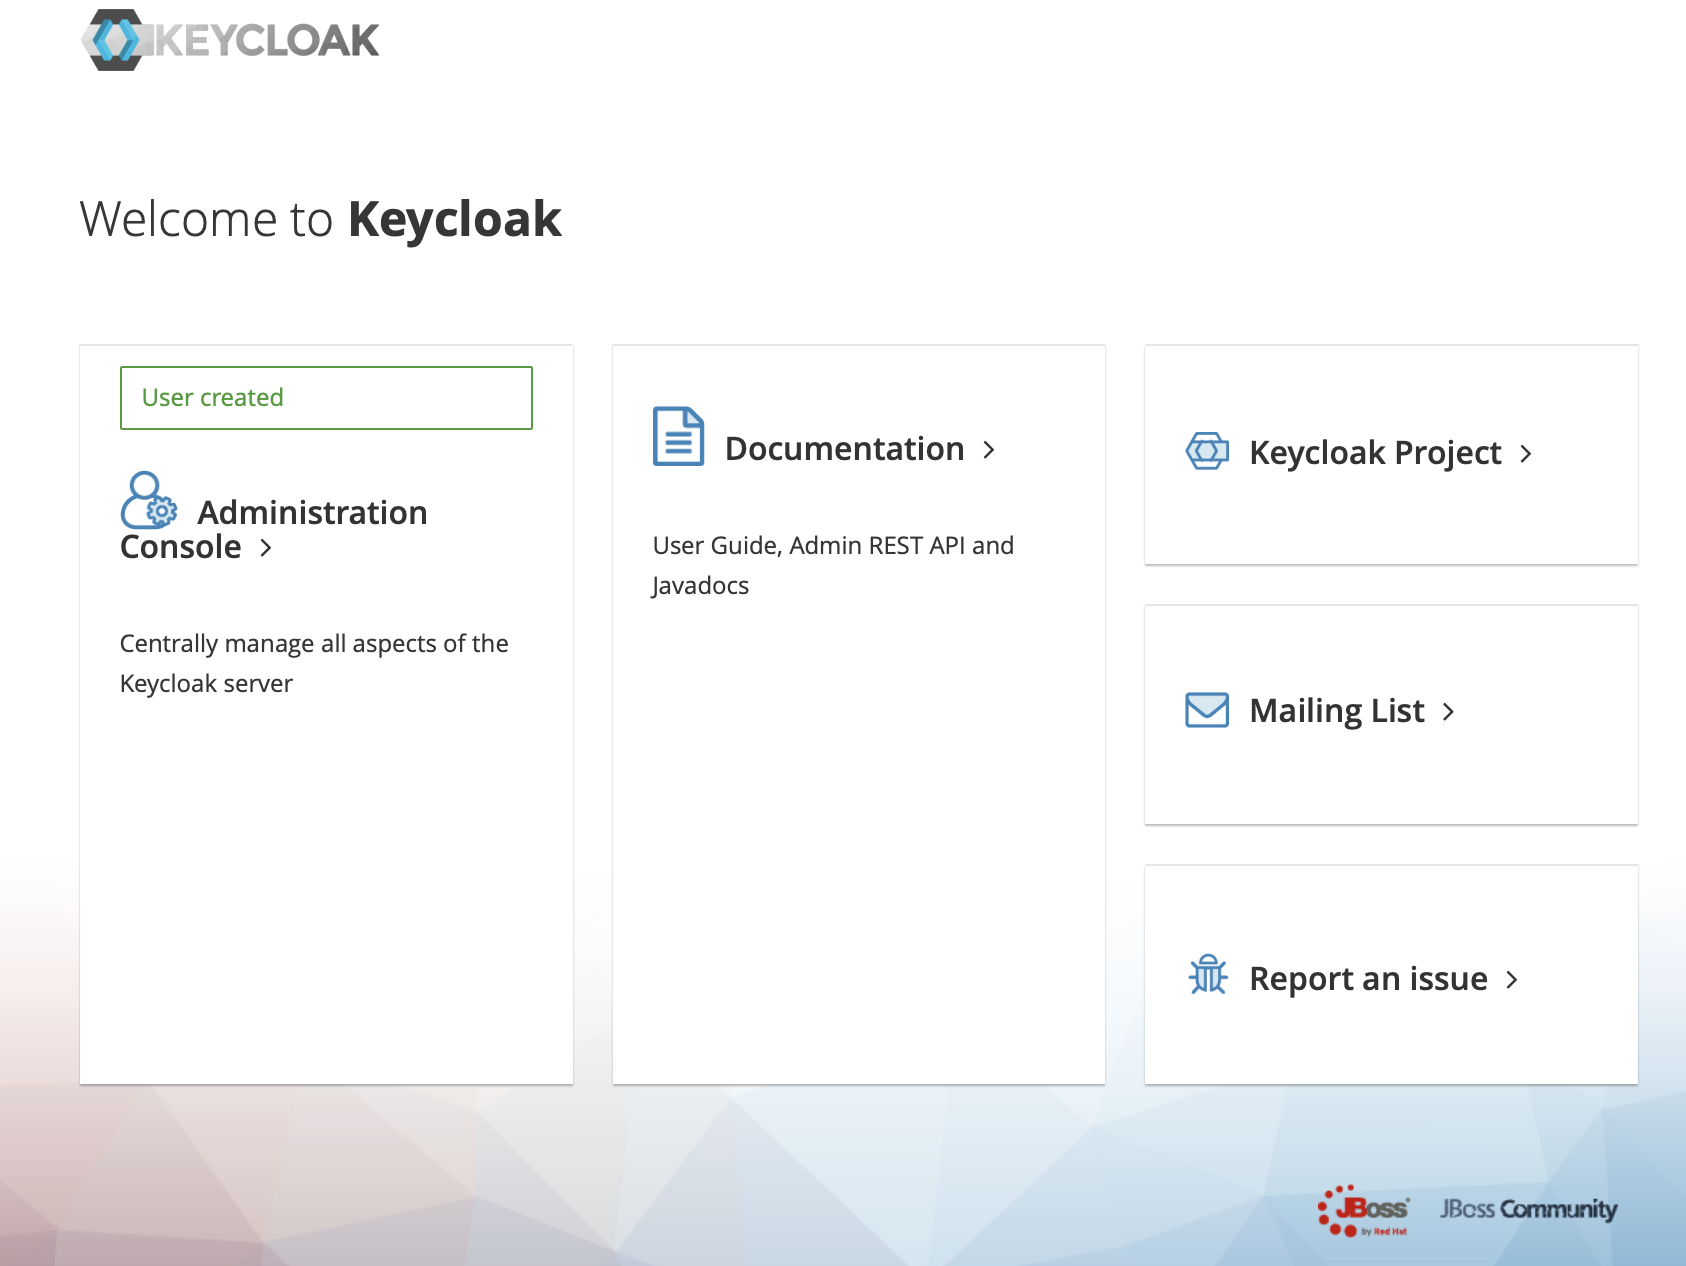
+3、点击 Administration Console 进入管理端
+
+
+
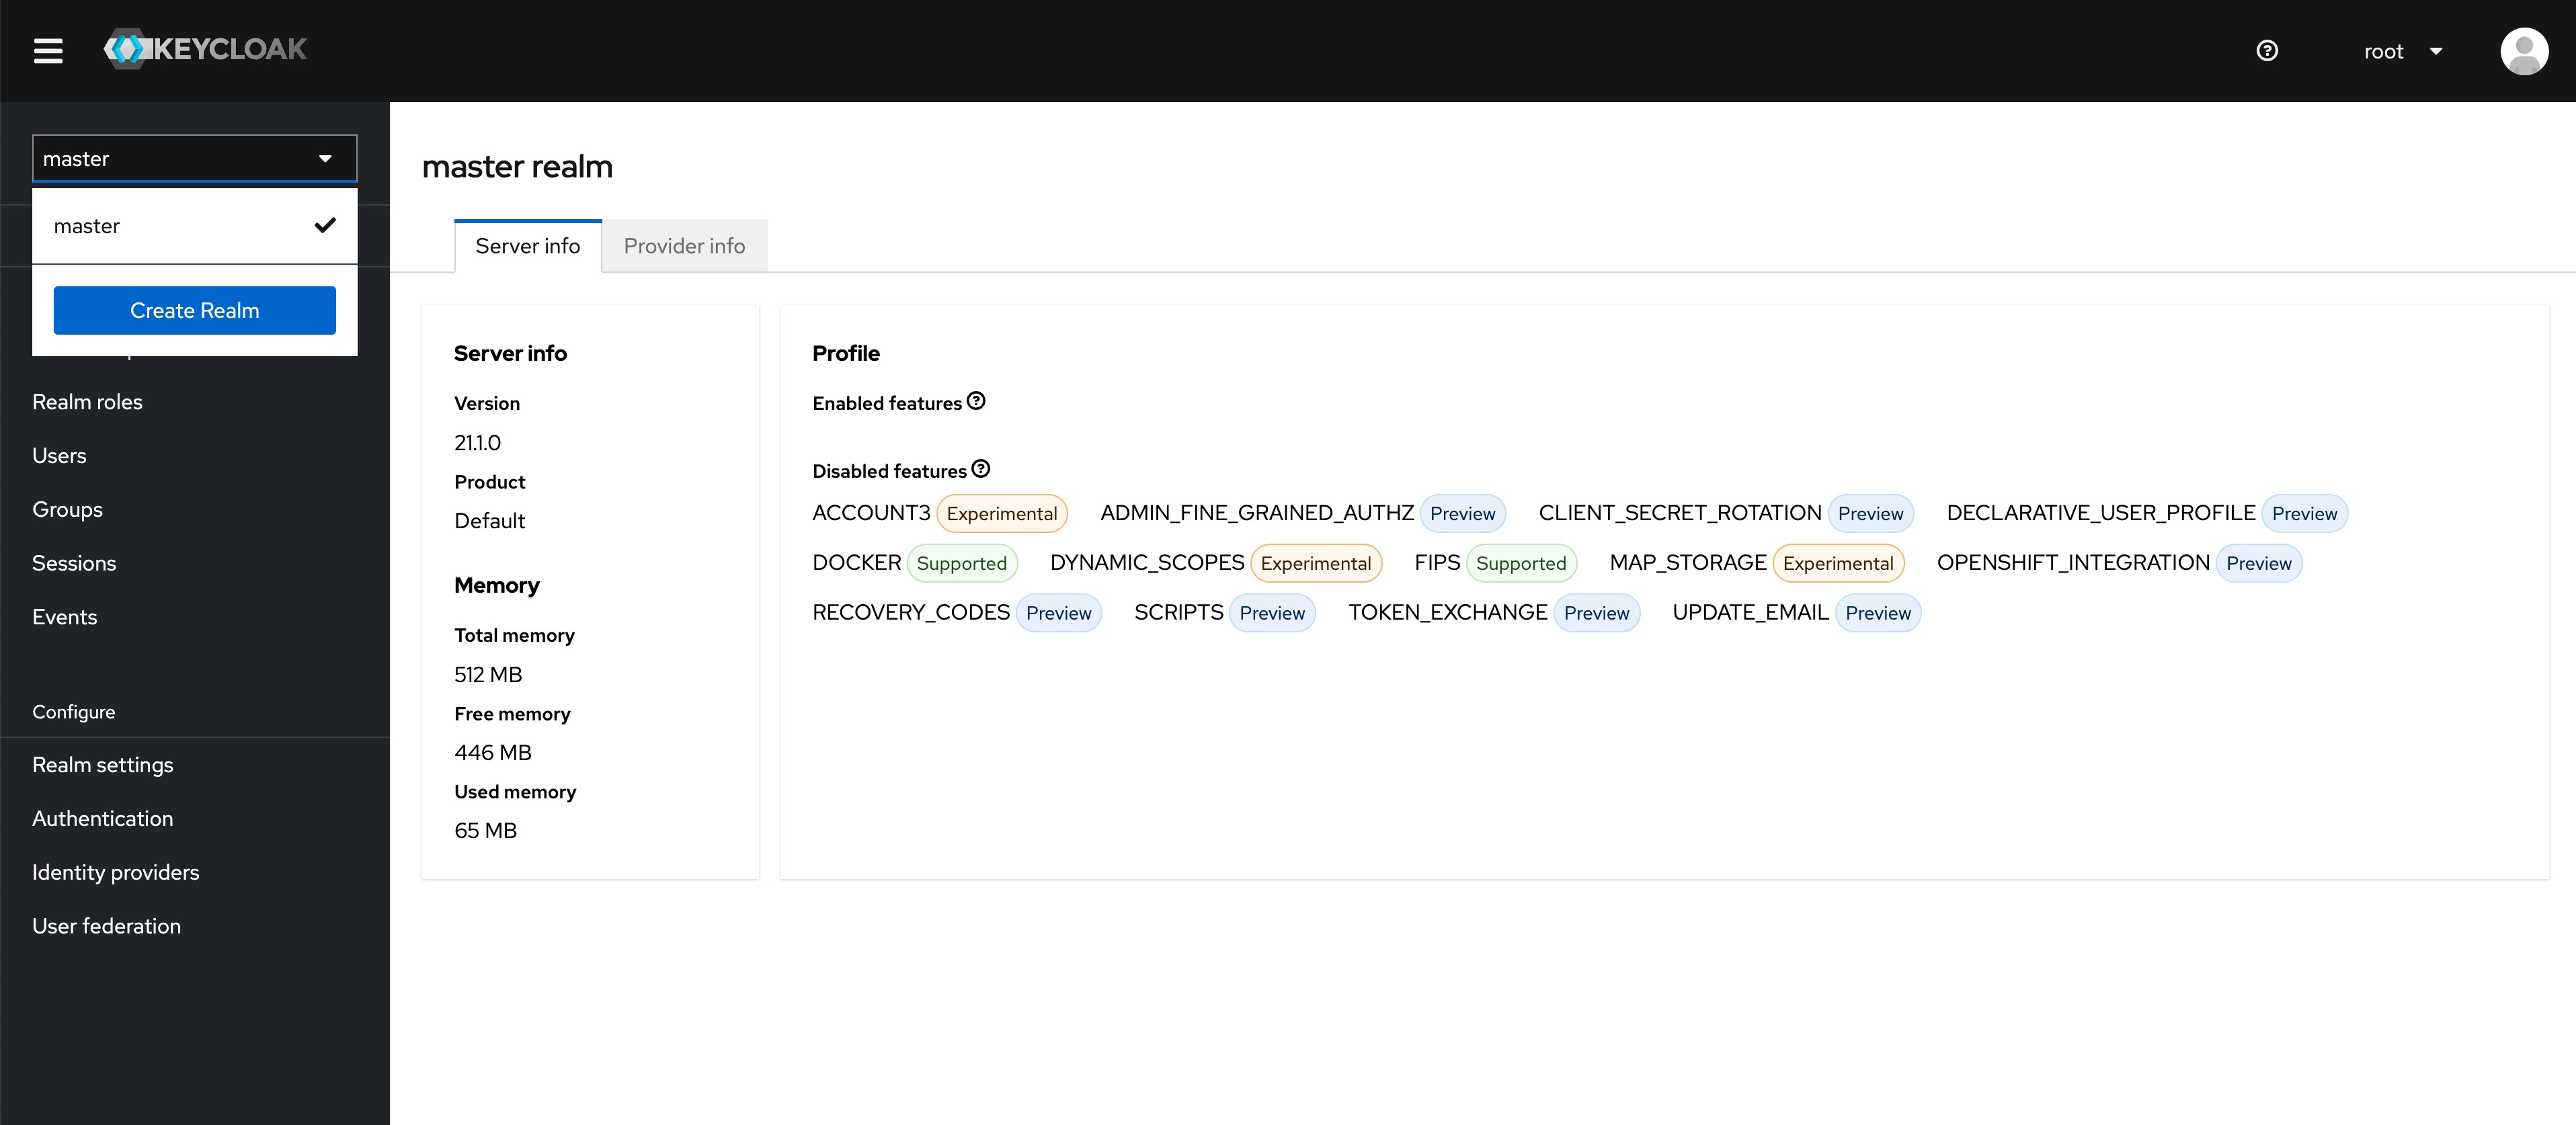
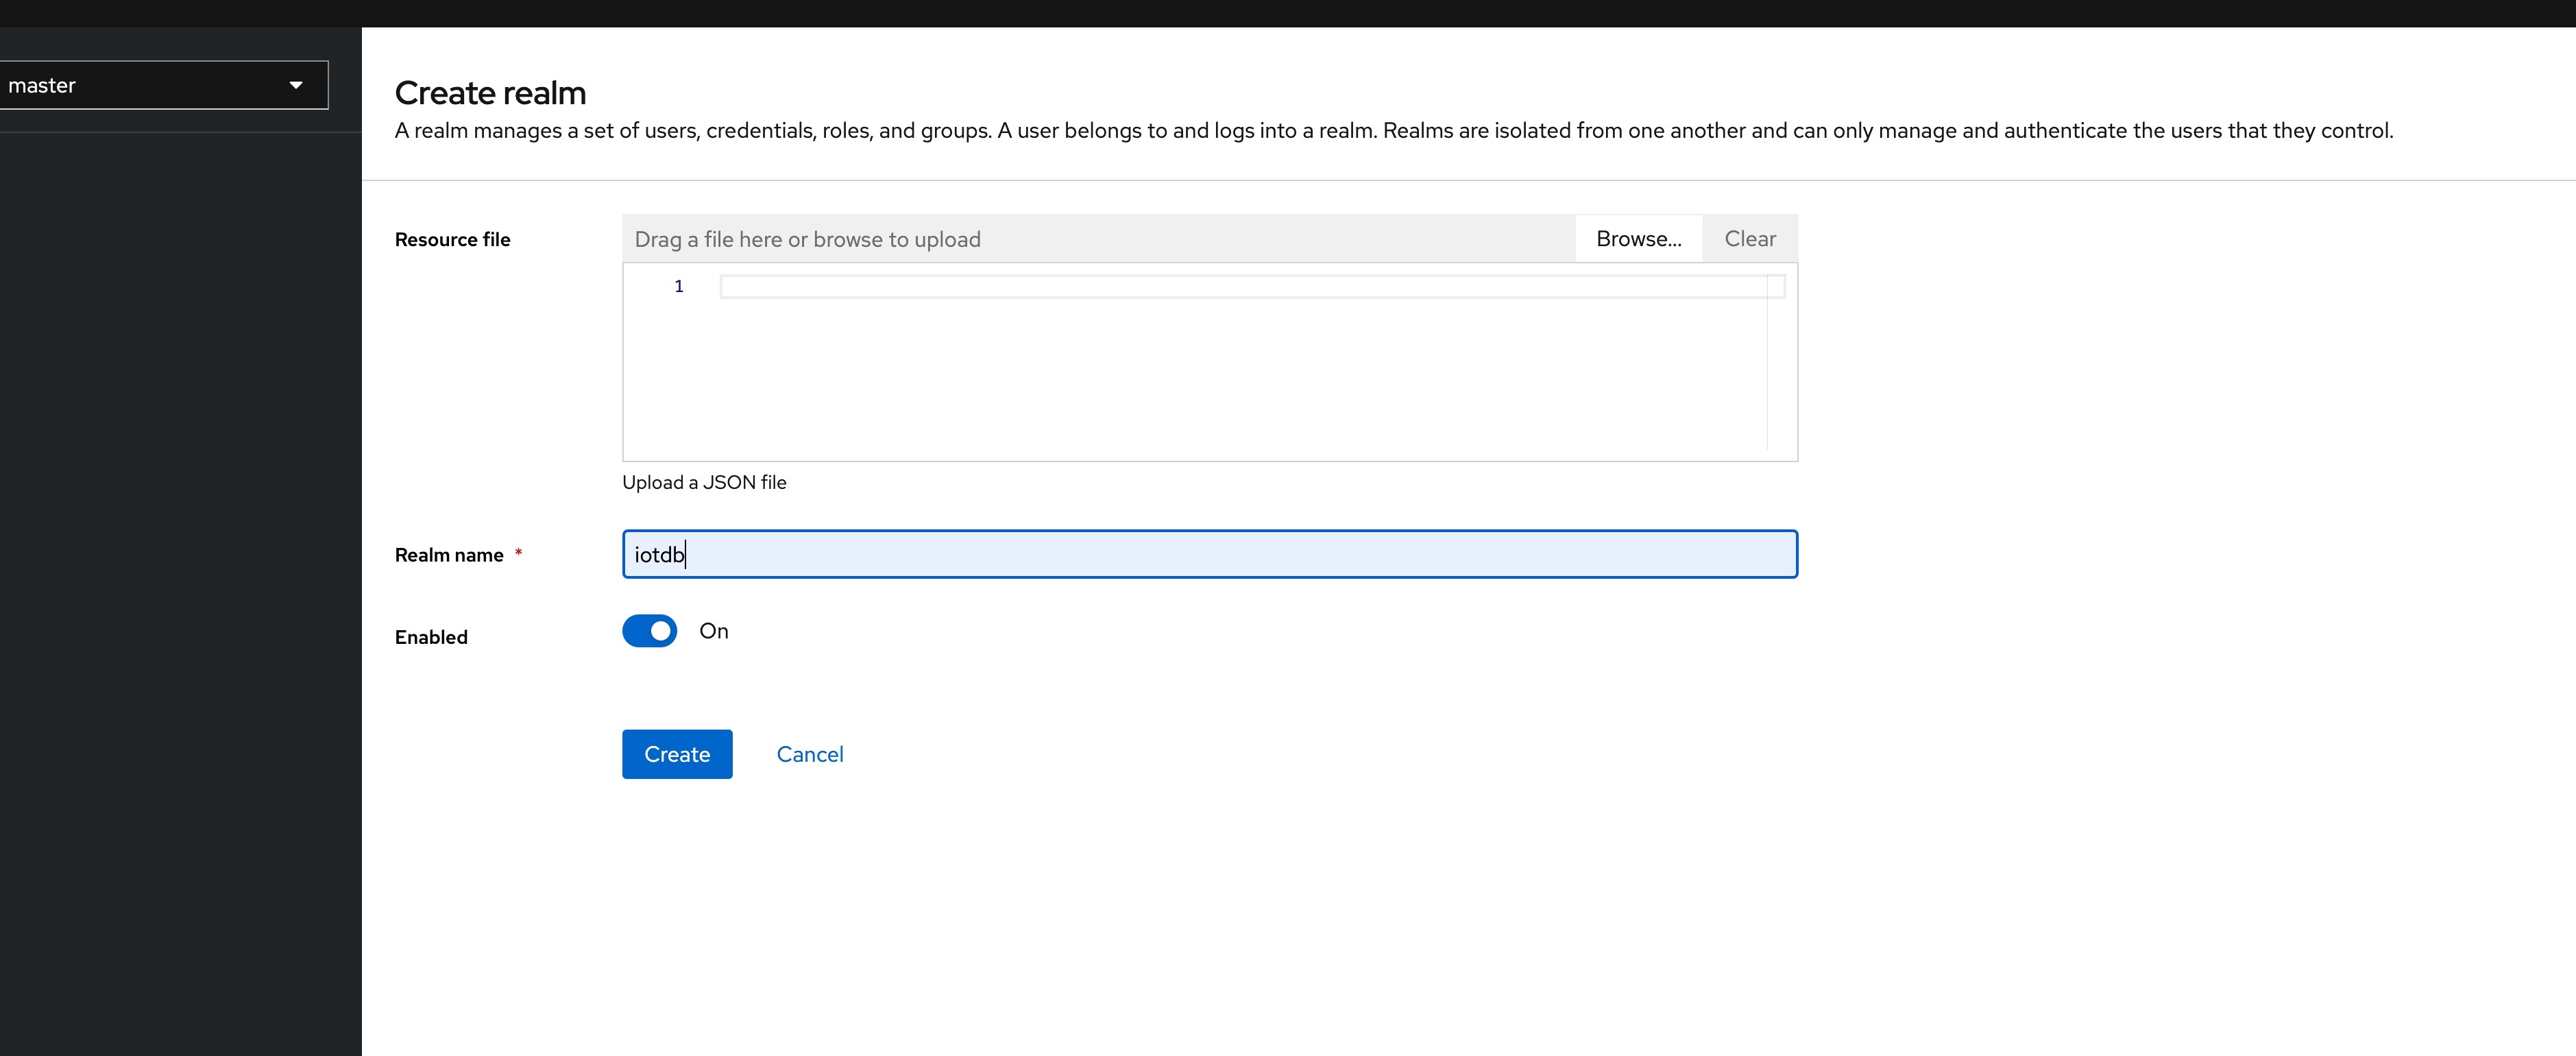
+4、在左侧的 Master 菜单点击 Create Realm, 输入 Realm Name 创建一个新的 Realm
+
+
+
+
+
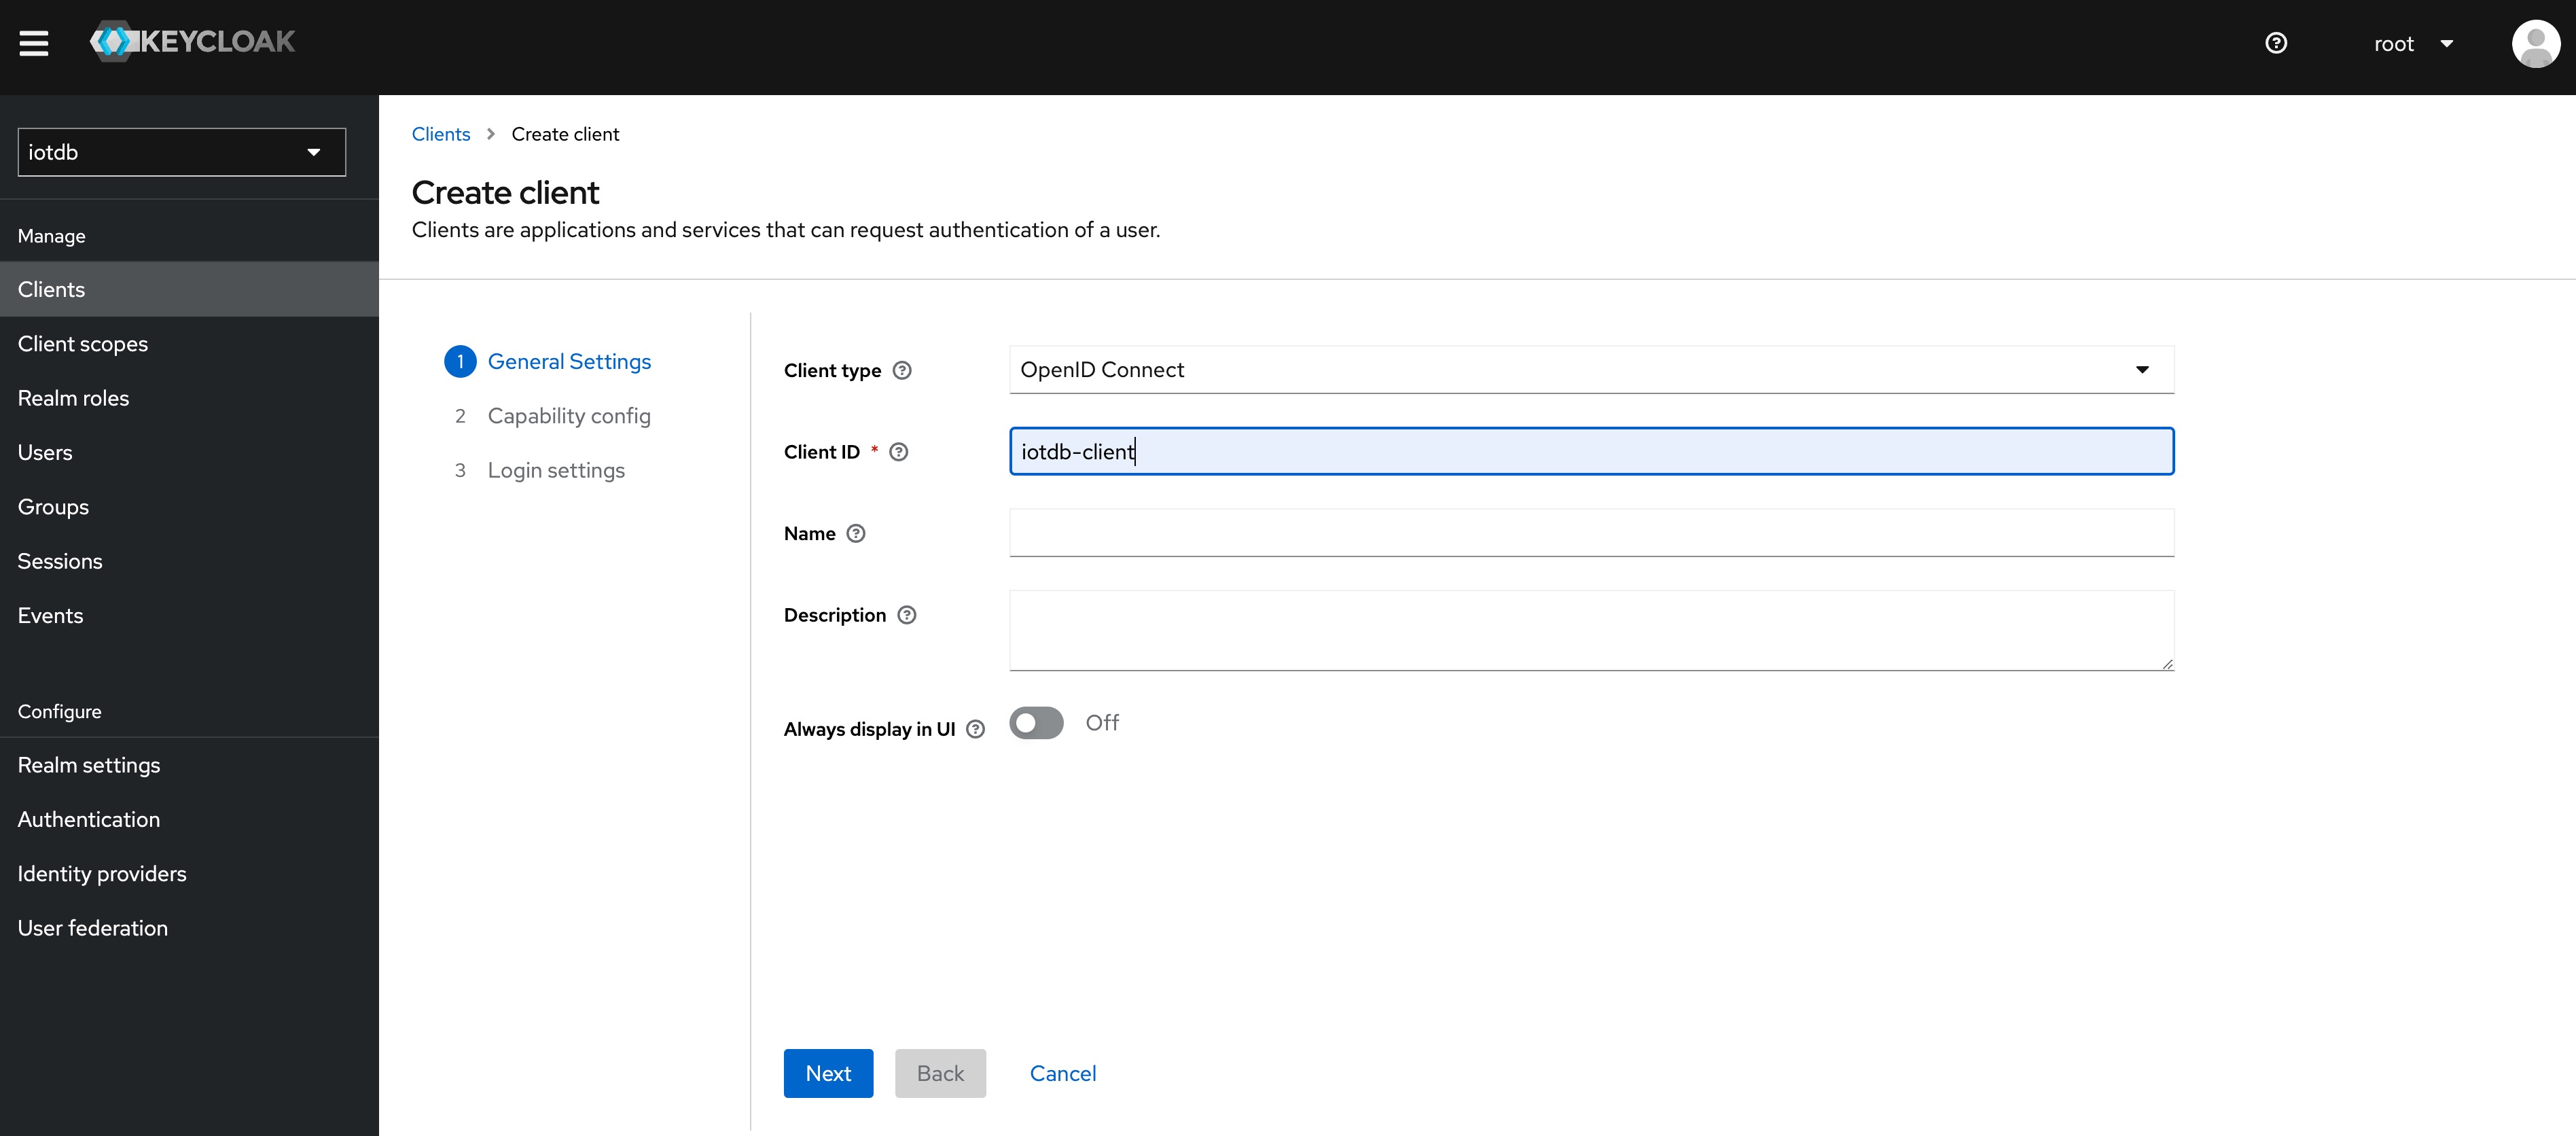
+5、点击左侧菜单 Clients,创建 client
+
+
+
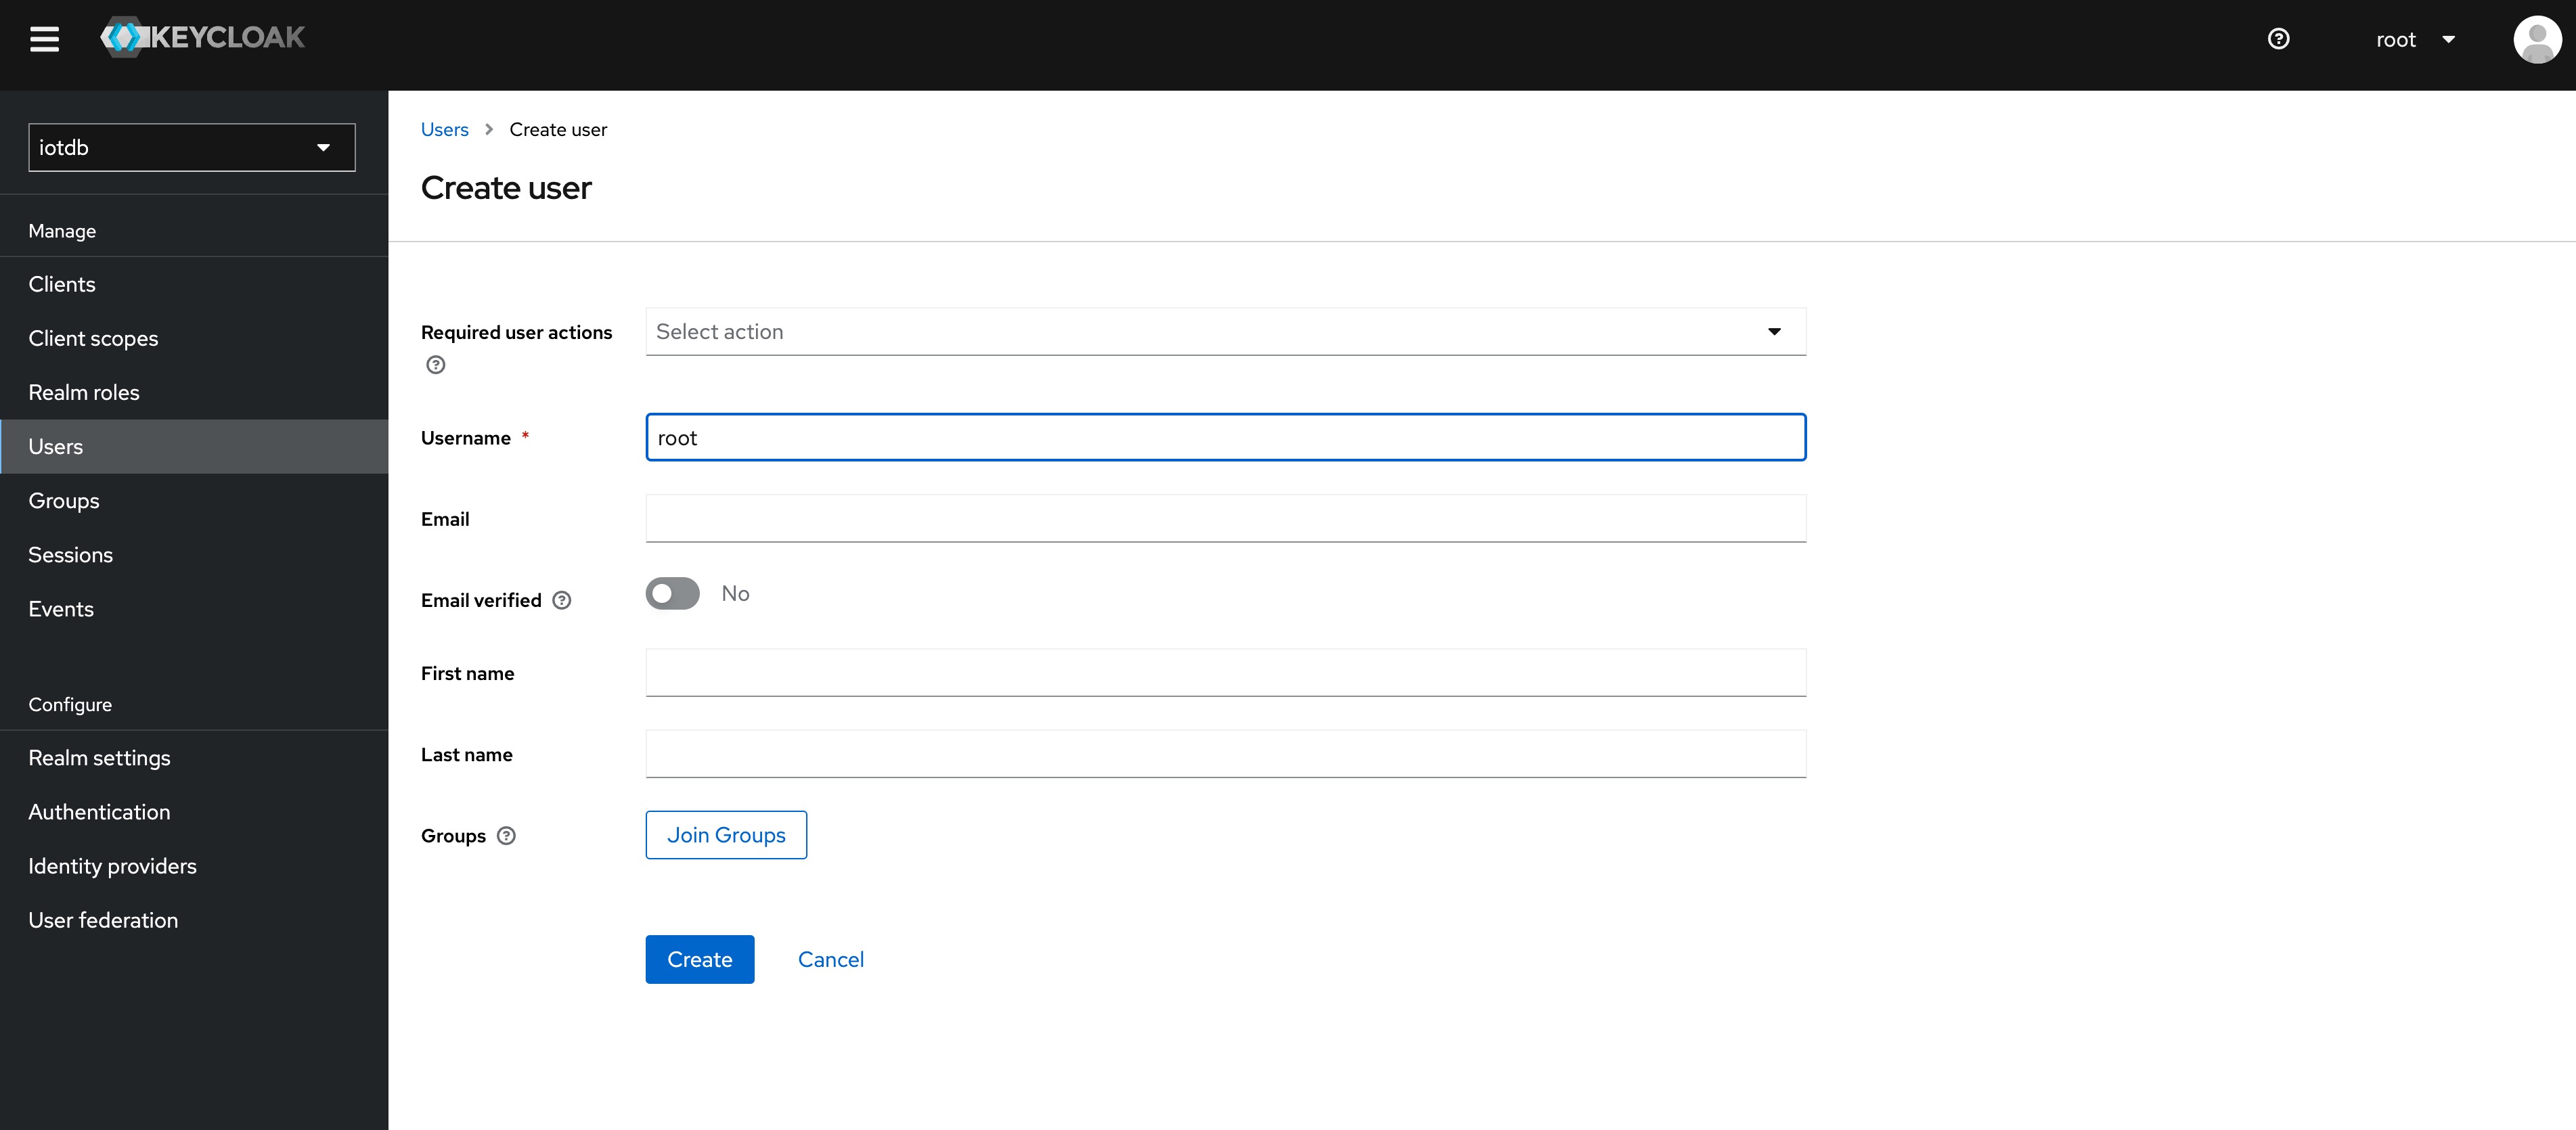
+6、点击左侧菜单 User,创建 user
+
+
+
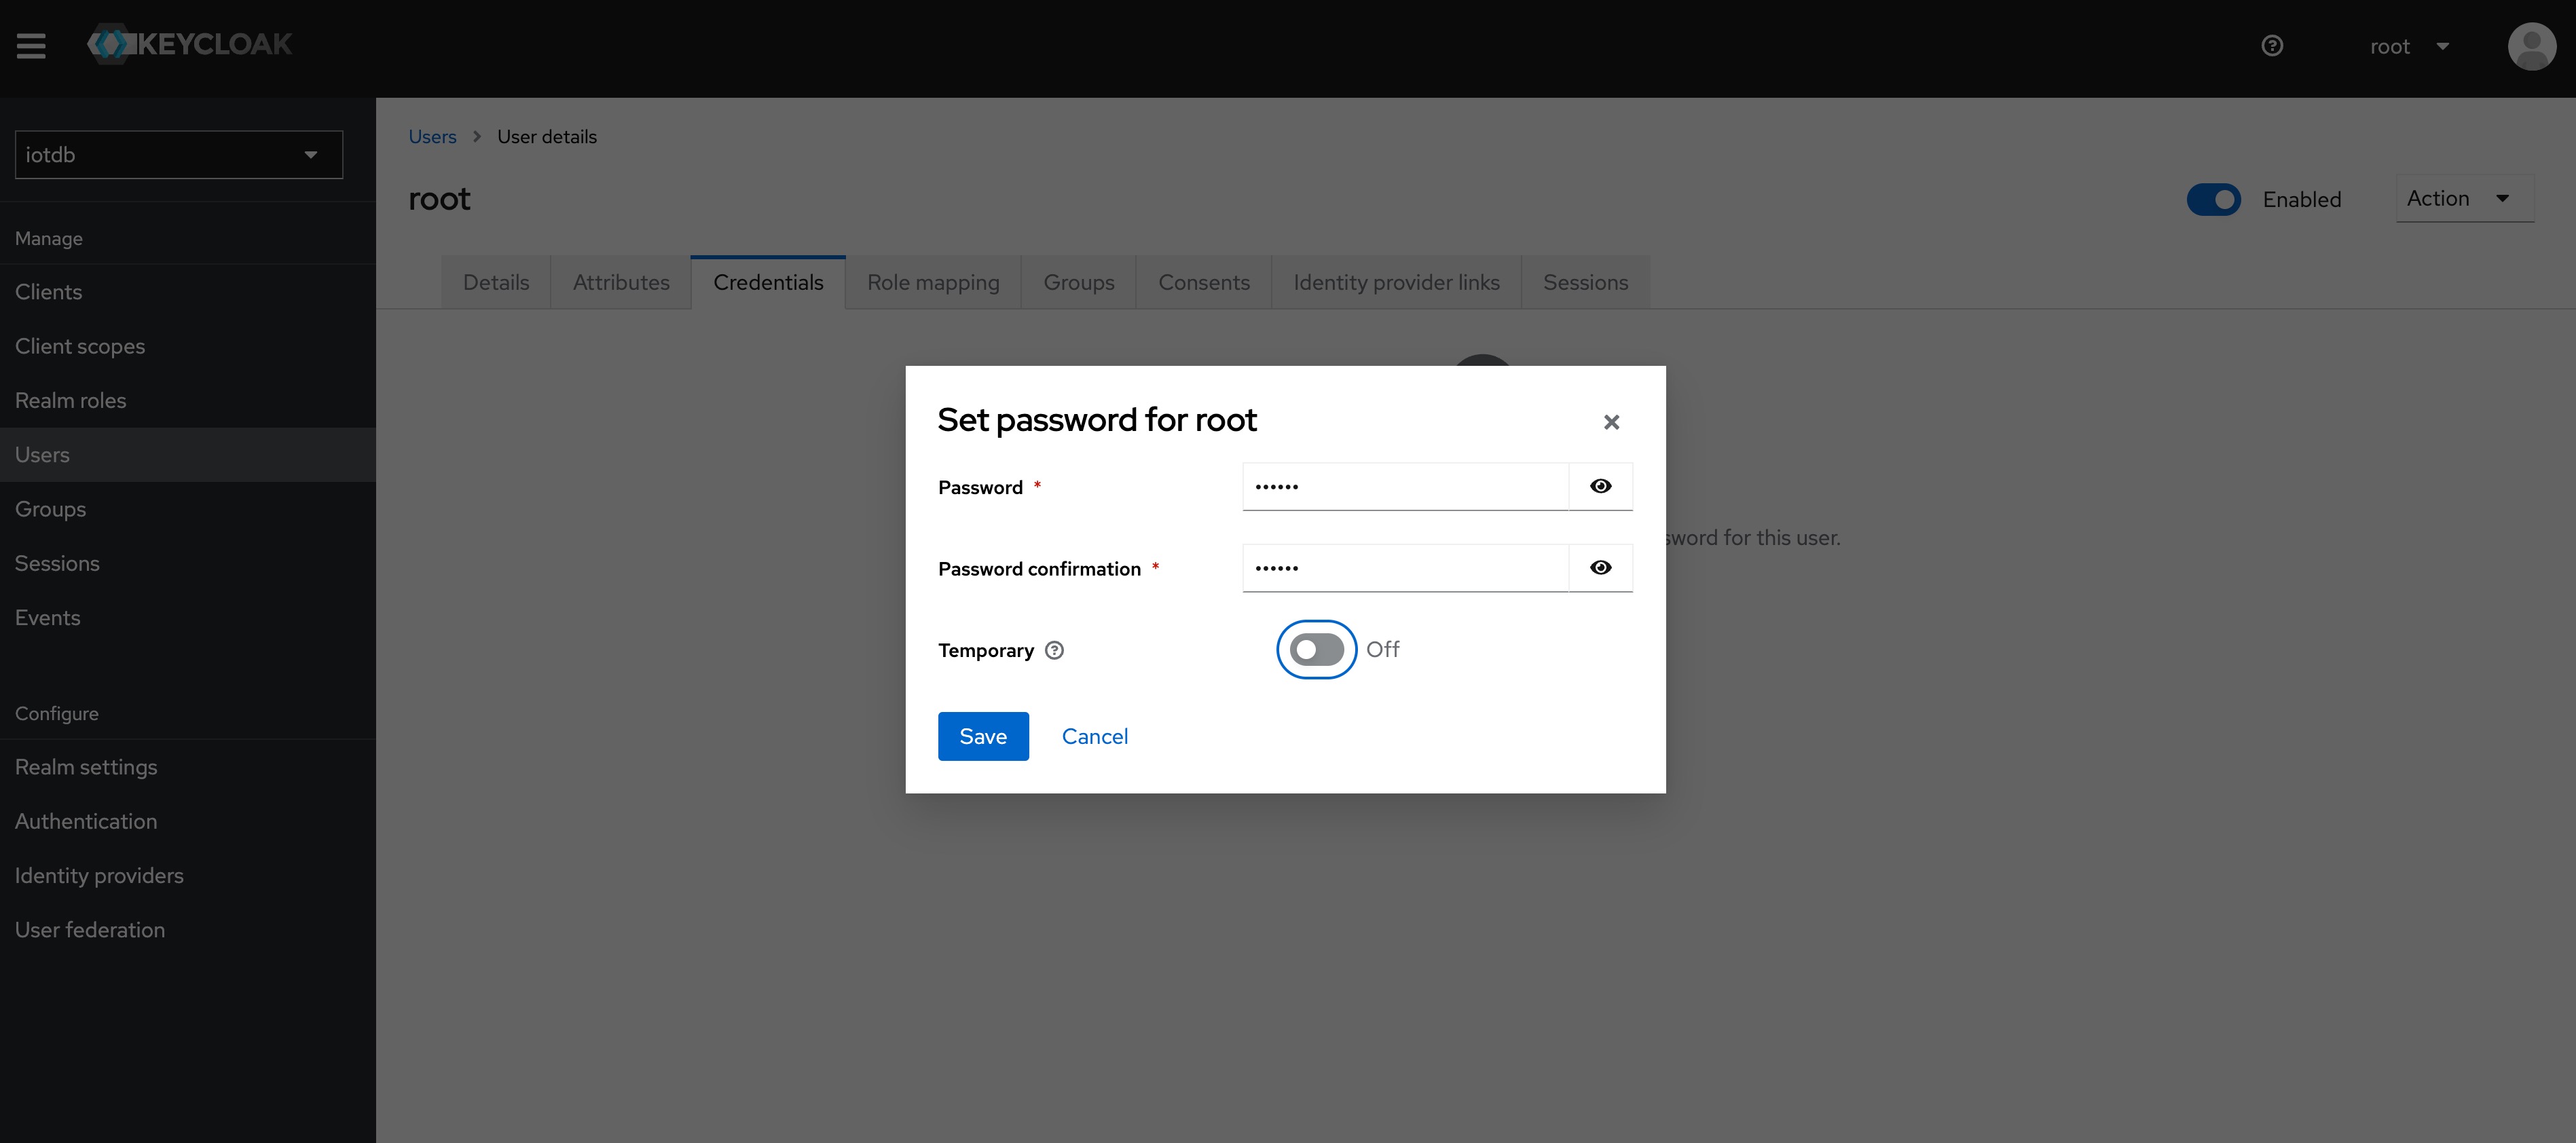
+7、点击新创建的用户 id,点击 Credentials 导航输入密码和关闭 Temporary 选项,至此 keyclork 配置完成
+
+
+
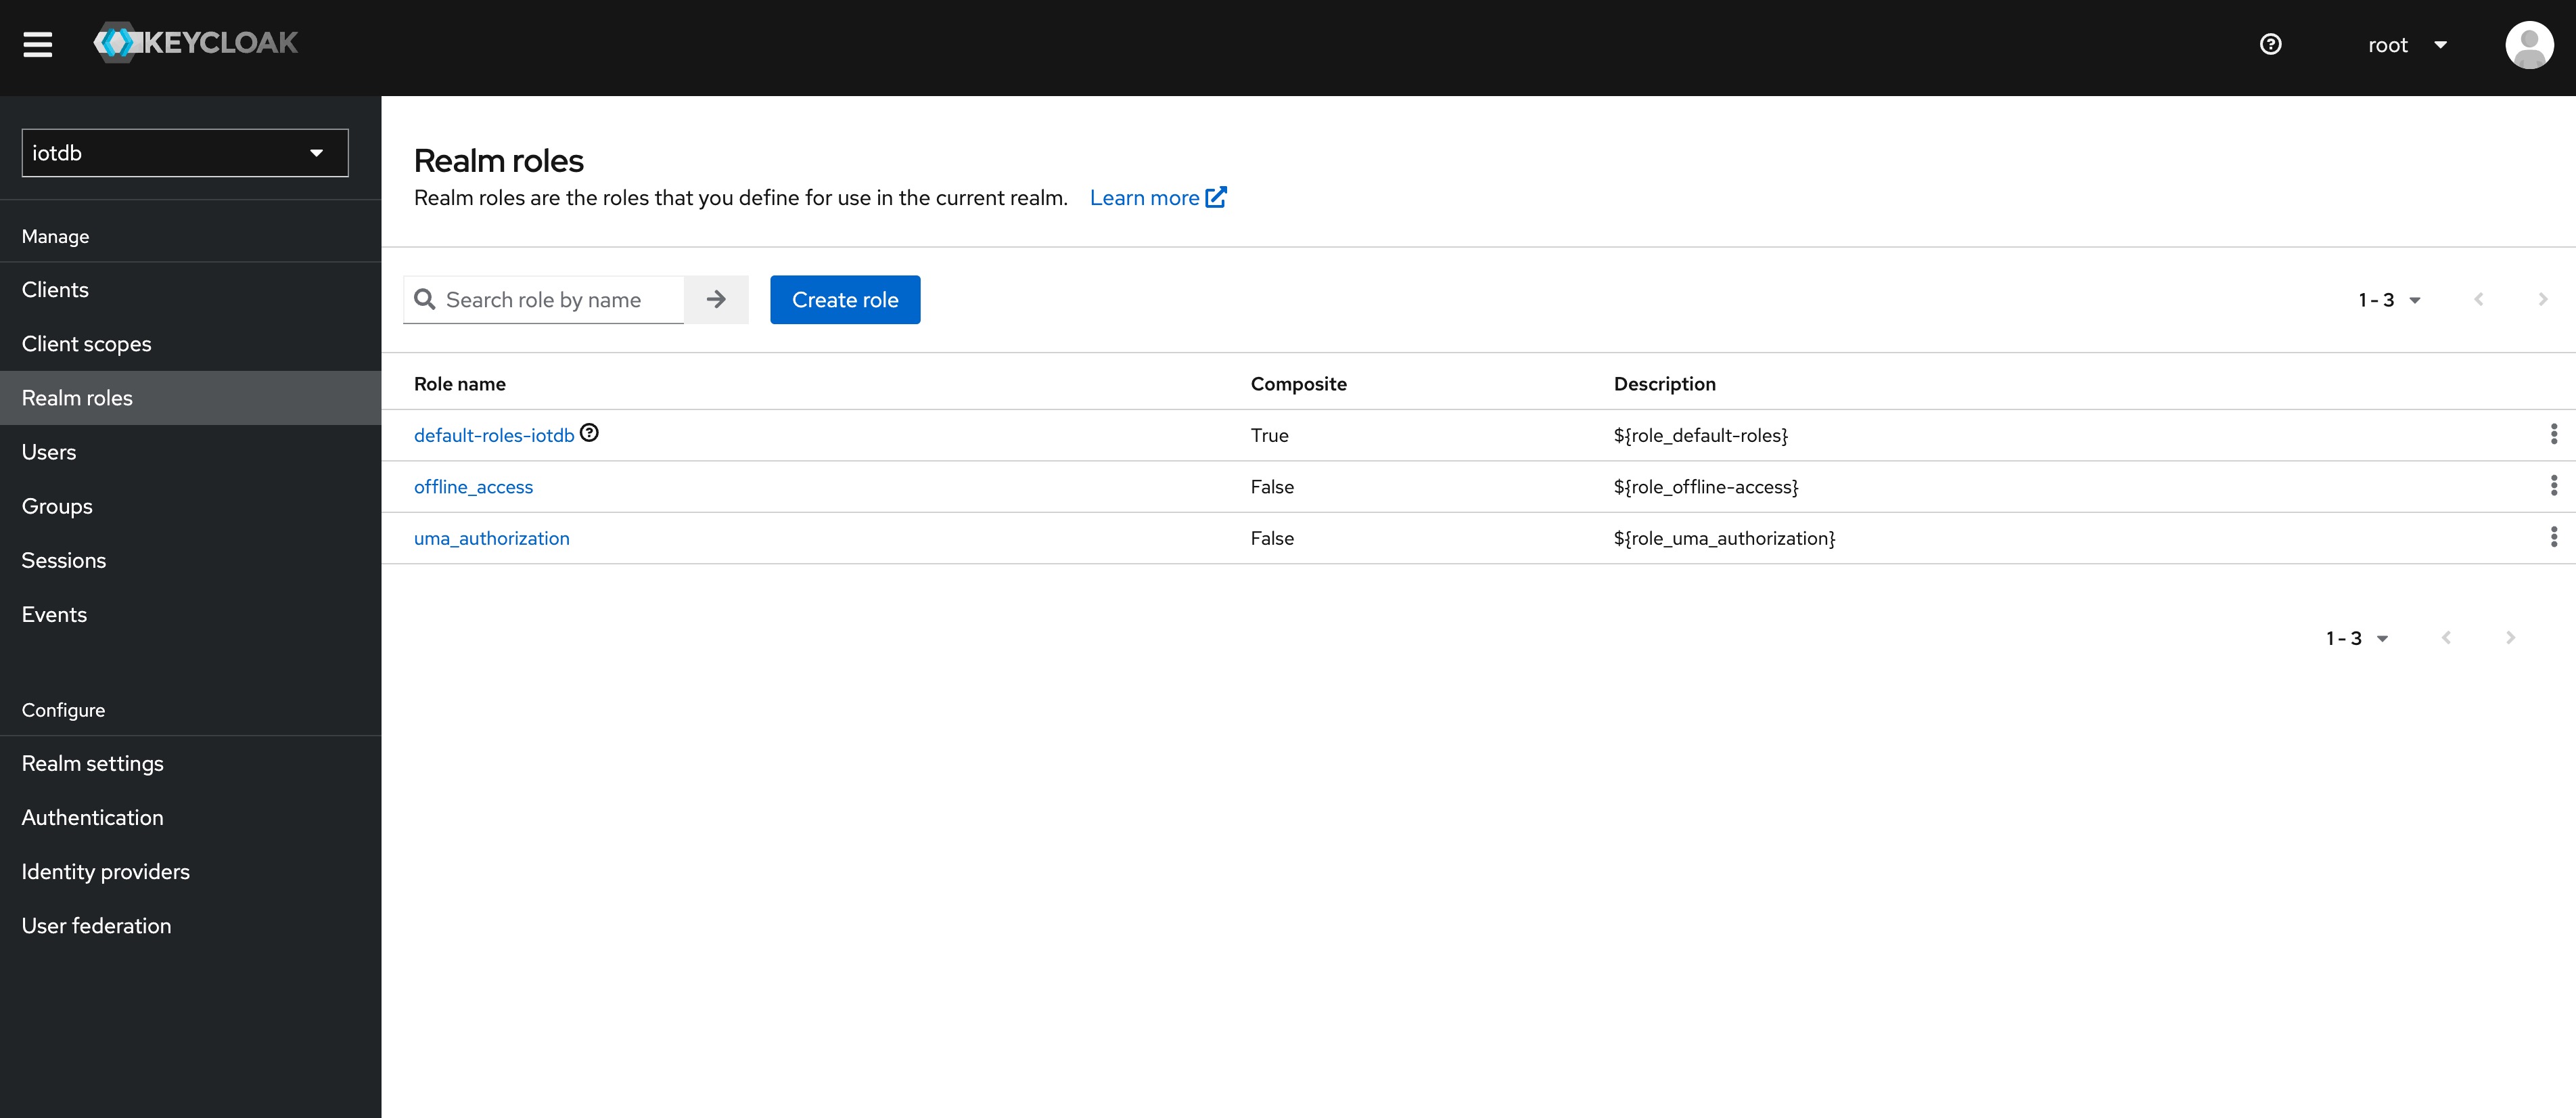
+8、创建角色,点击左侧菜单的 Roles然后点击Create Role 按钮添加角色
+
+
+
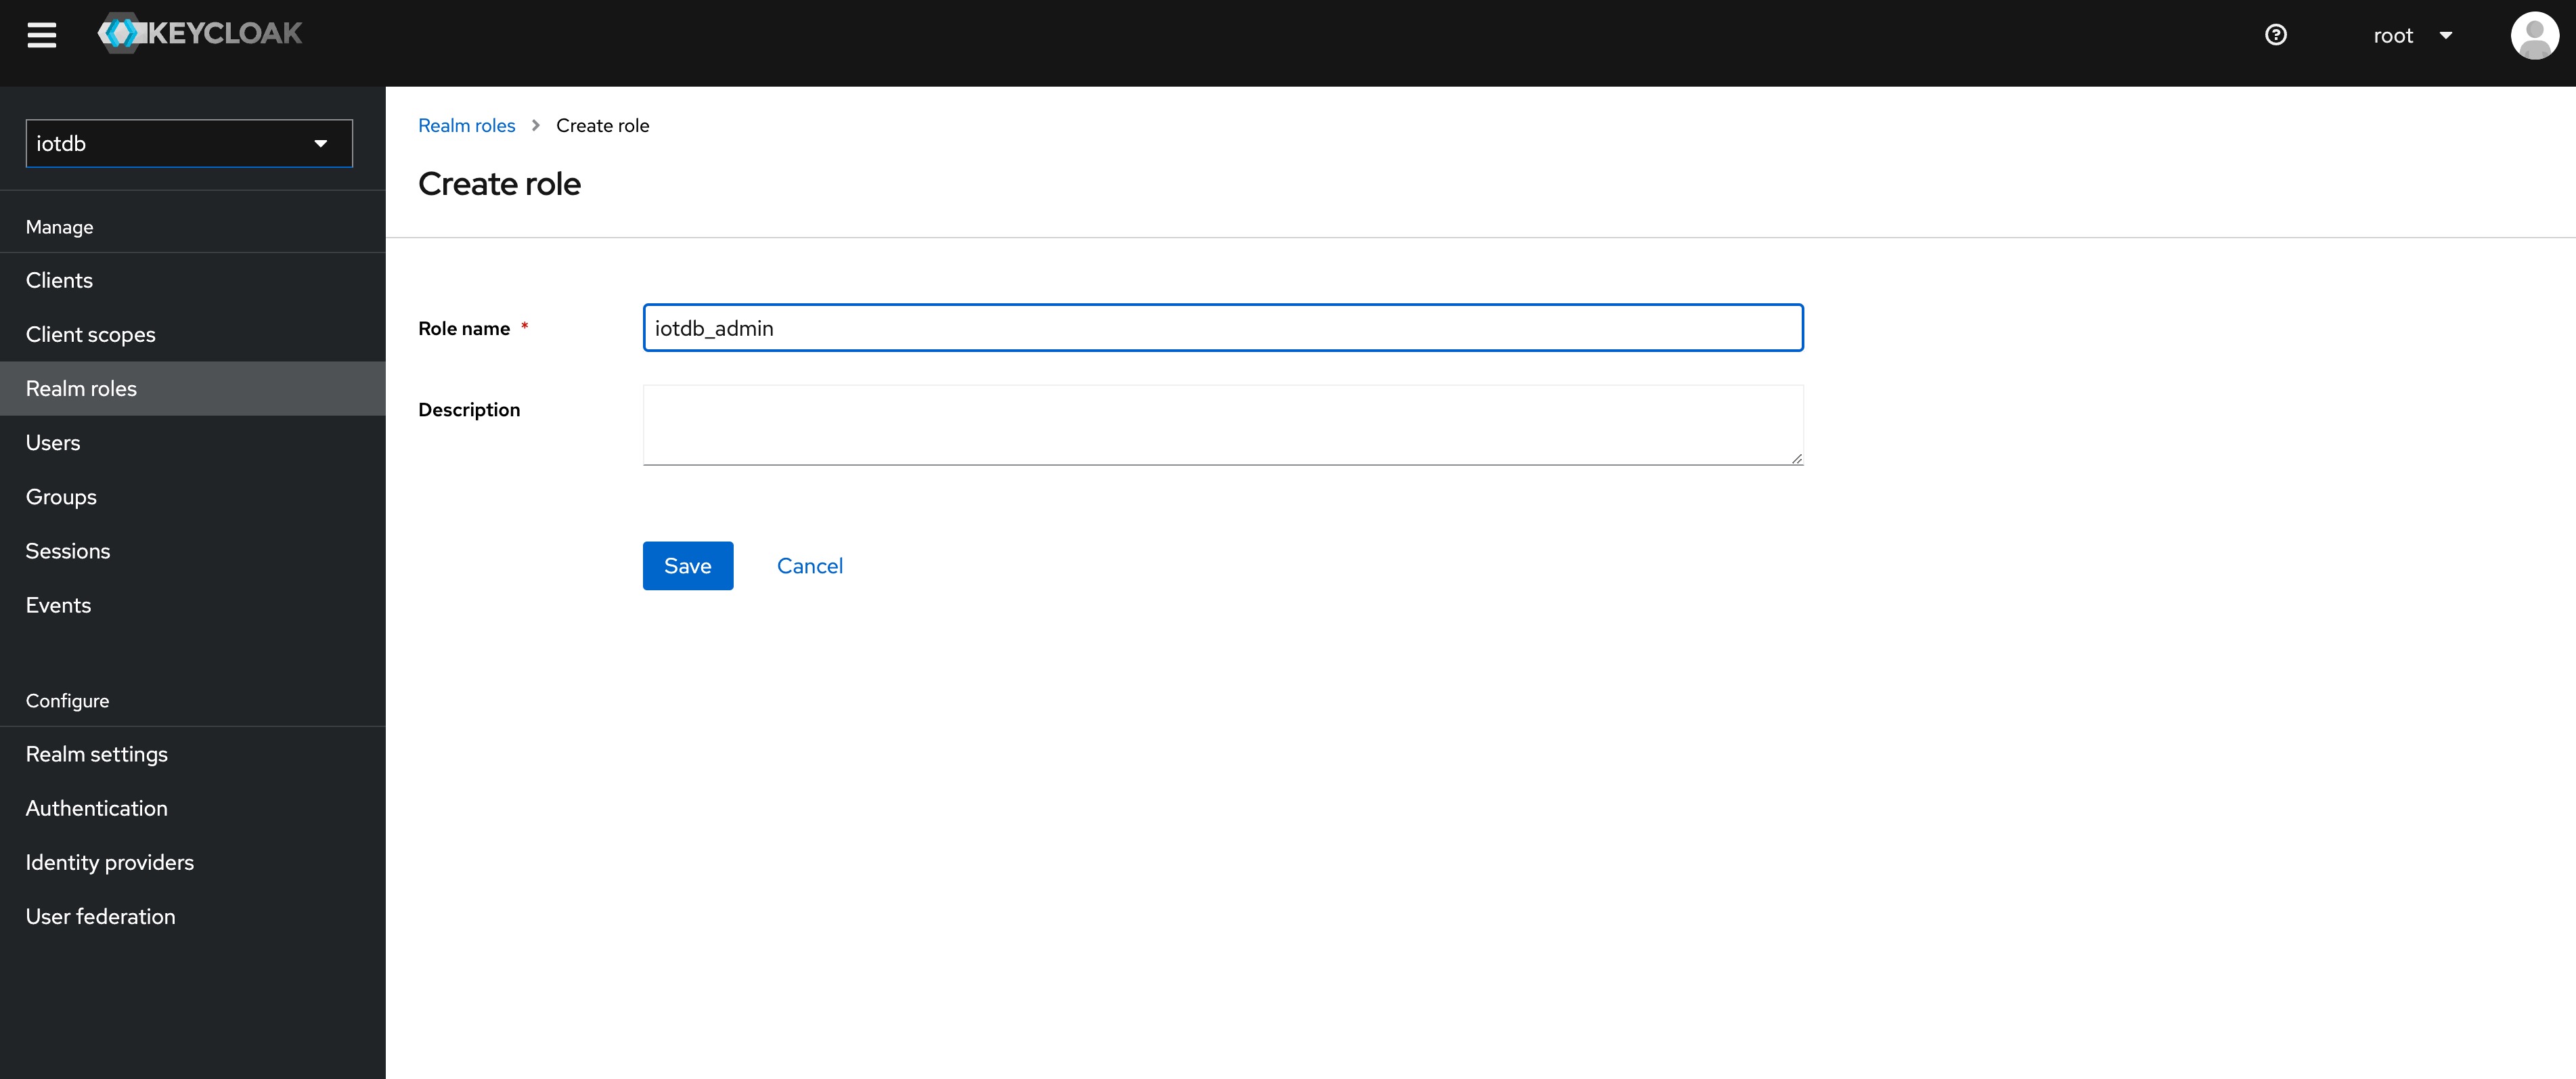
+9、在Role Name 中输入`iotdb_admin`,点击save 按钮。提示:这里的`iotdb_admin`不能为其他名称否则即使登陆成功后也将无权限使用iotdb的查询、插入、创建 database、添加用户、角色等功能
+
+
+
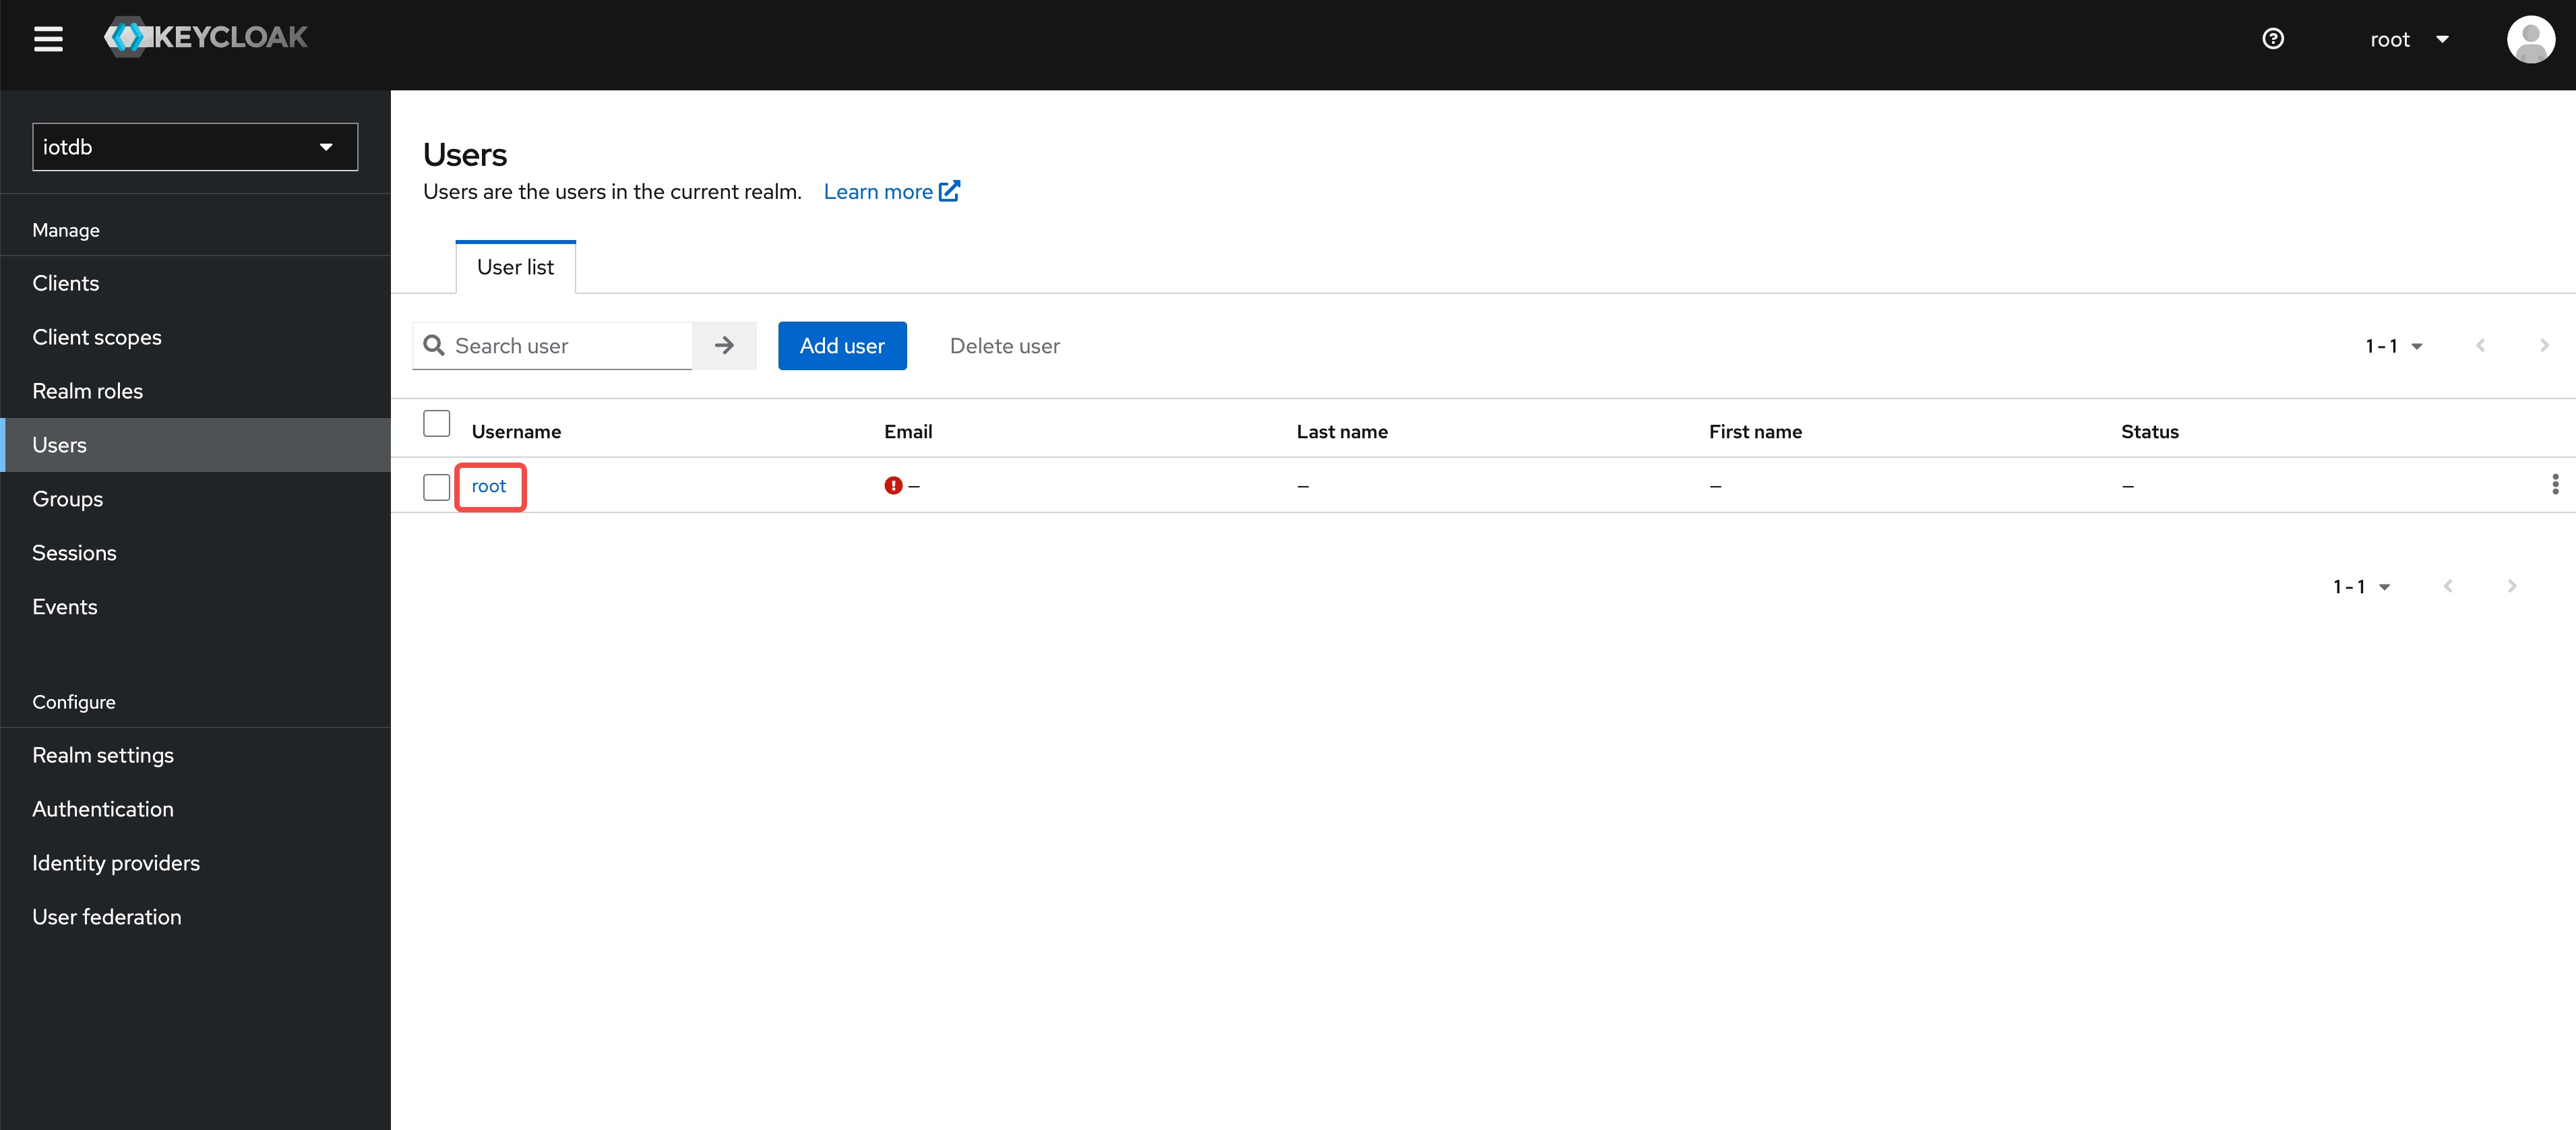
+10、点击左侧的User 菜单然后点击用户列表中的用户为该用户添加我们刚创建的`iotdb_admin`角色
+
+
+
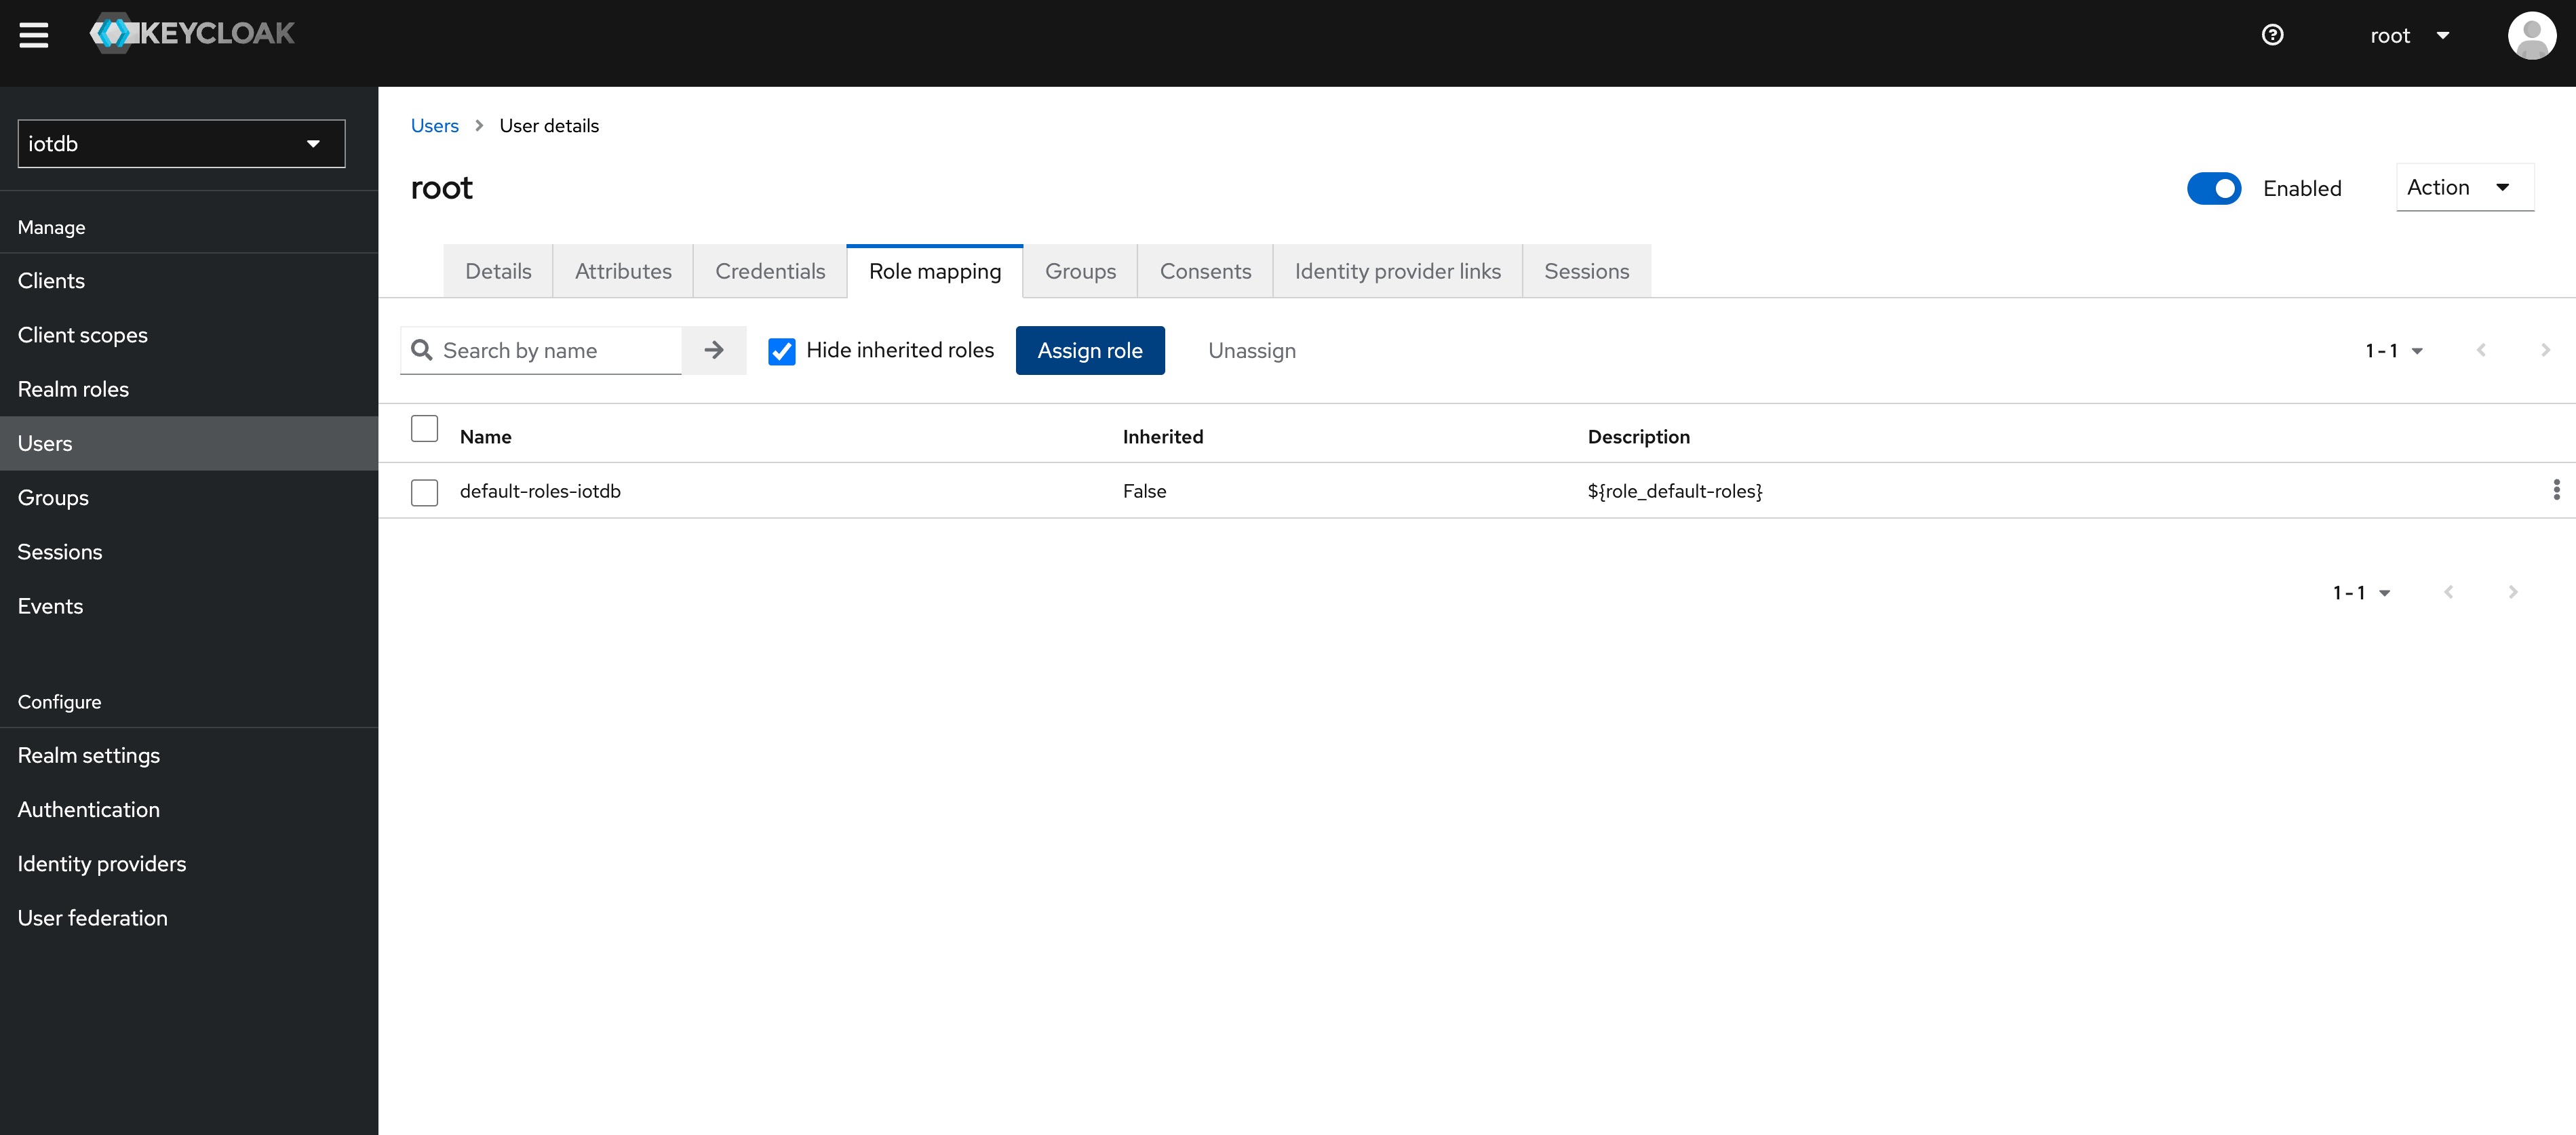
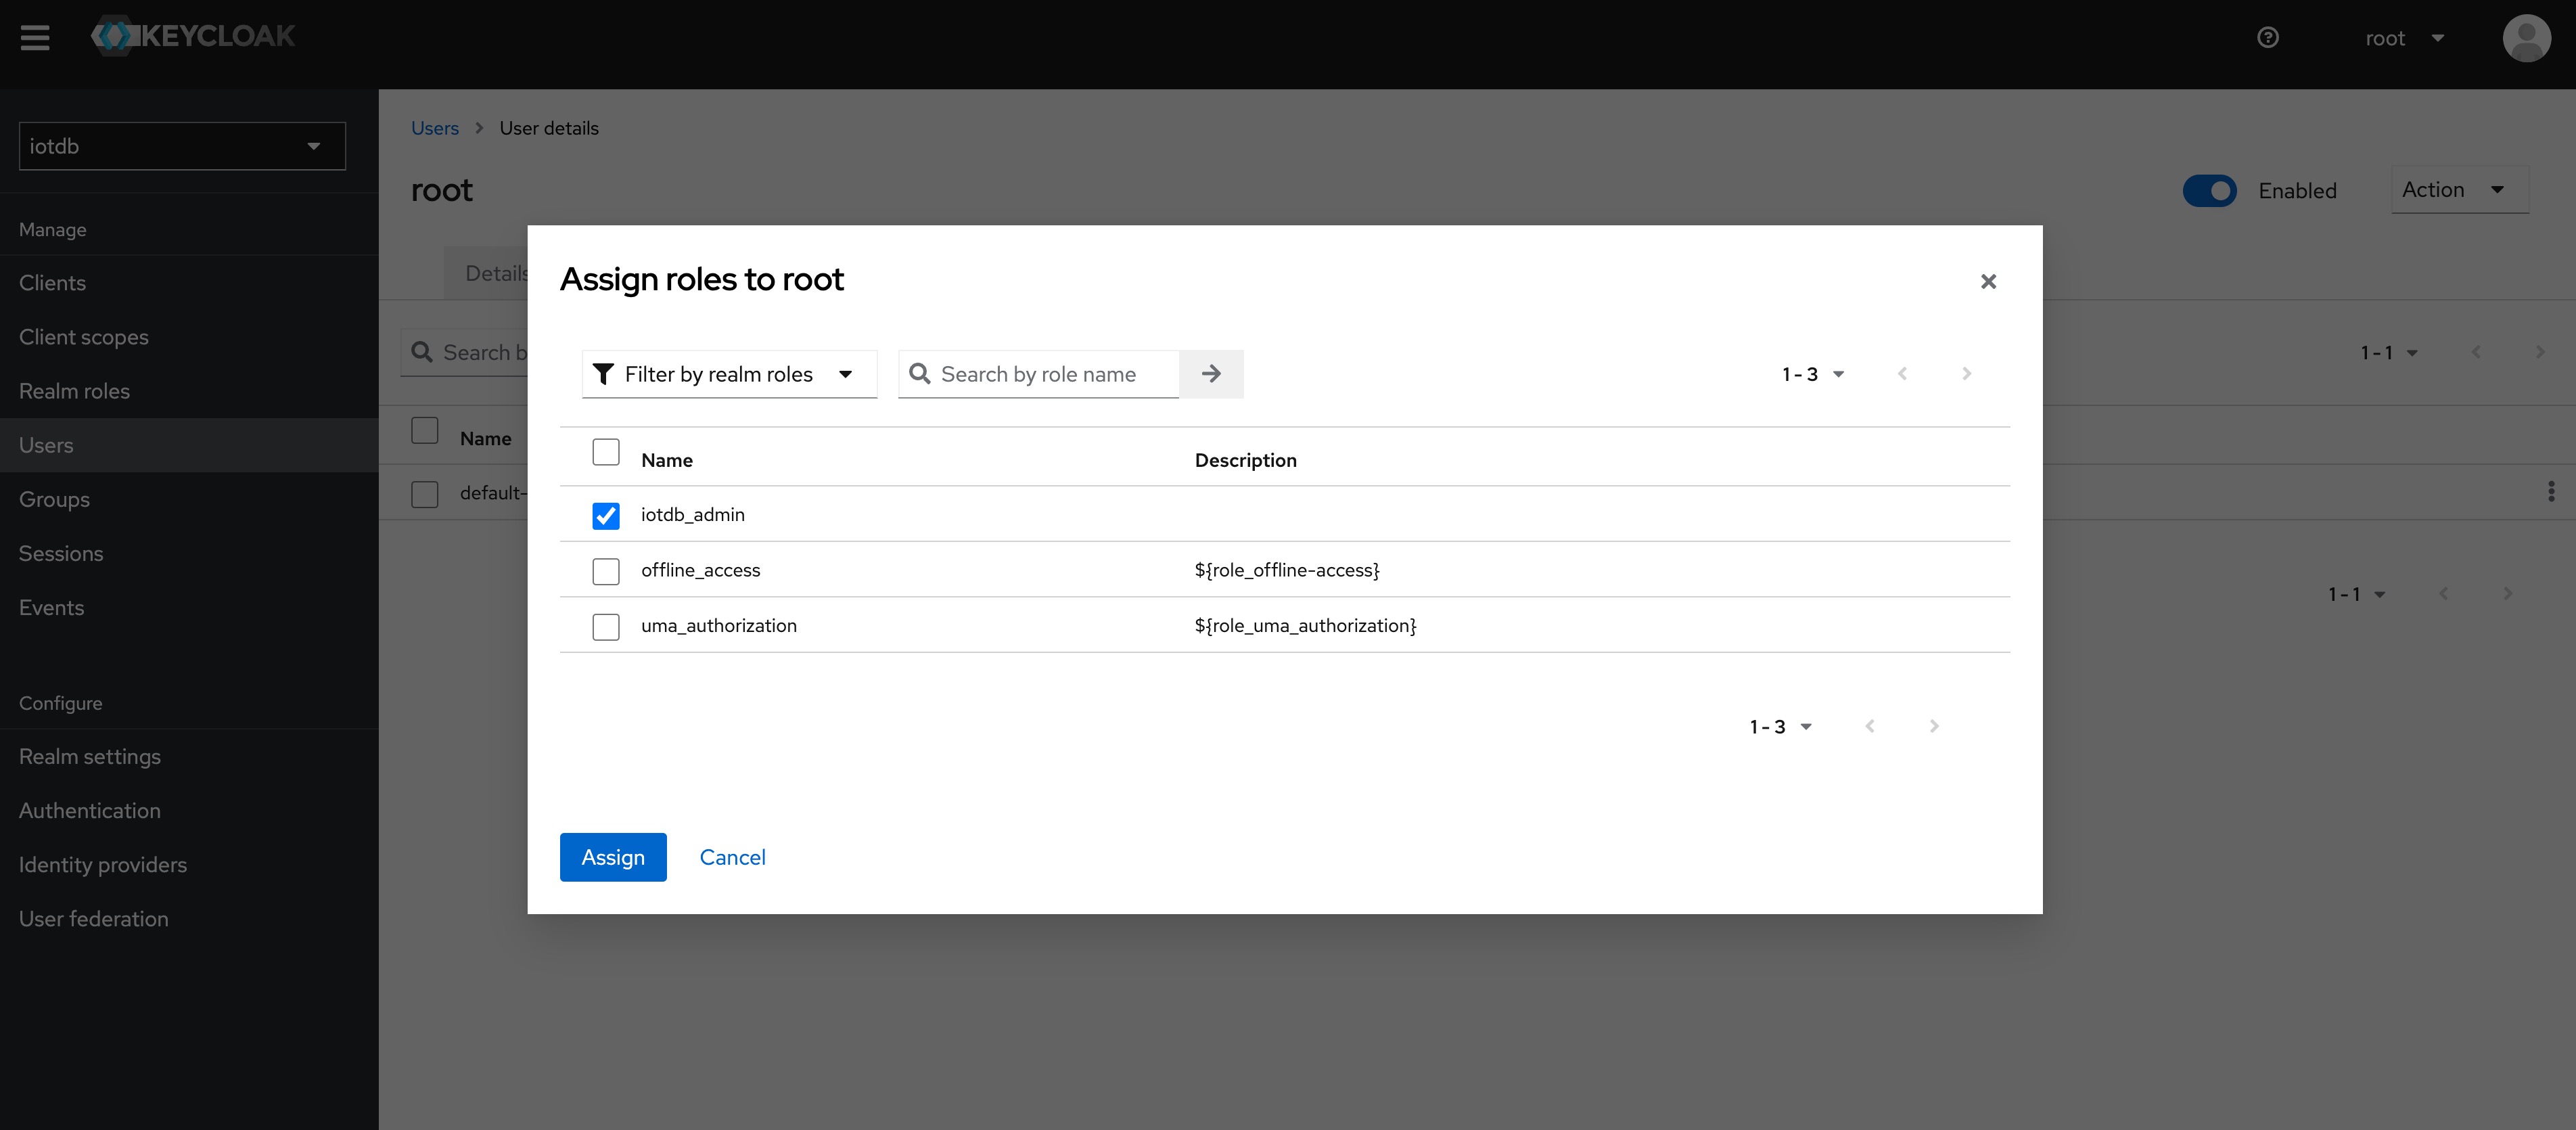
+11、选择Role Mappings ,在Assign role选择`iotdb_admin`增加角色
+
+
+
+
+
+提示:如果用户角色有调整需要重新生成token并且重新登陆iotdb才会生效
+
+以上步骤提供了一种 keycloak 登陆 iotdb 方式,更多方式请参考 keycloak 配置
+
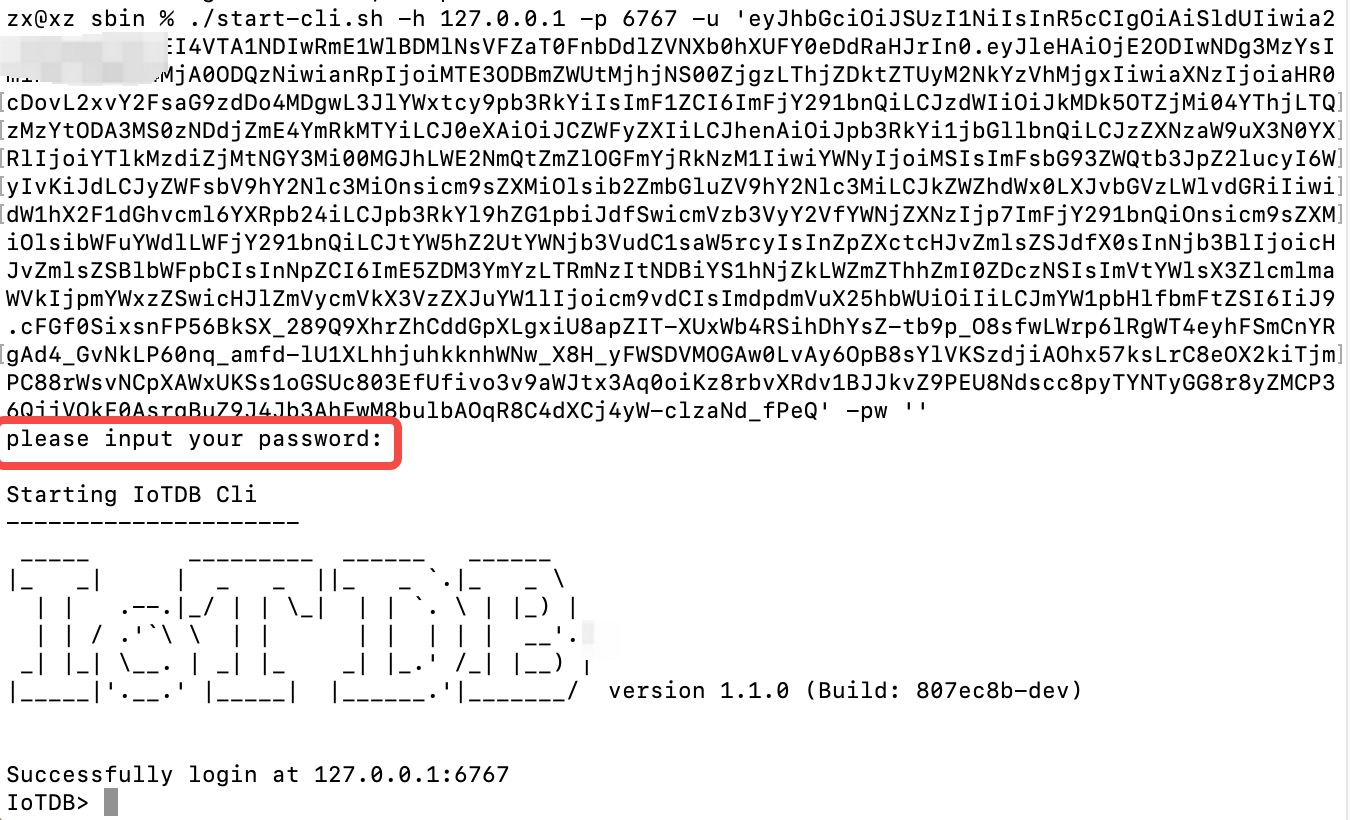
+若对应的 IoTDB 服务器开启了使用 OpenID Connect (OIDC) 作为权限认证服务,那么就不再需要使用用户名密码进行登录。
+替而代之的是使用 Token,以及空密码。
+此时,登录命令如下:
+
+```shell
+Shell > bash sbin/start-cli.sh -h 10.129.187.21 -p 6667 -u {my-access-token} -pw ""
+```
+
+其中,需要将{my-access-token} (注意,包括{})替换成你的 token,即 access_token 对应的值。密码为空需要再次确认。
+
+
+
+如何获取 token 取决于你的 OIDC 设置。 最简单的一种情况是使用`password-grant`。例如,假设你在用 keycloack 作为你的 OIDC 服务,
+并且你在 keycloack 中有一个被定义成 public 的`iotdb`客户的 realm,那么你可以使用如下`curl`命令获得 token。
+(注意例子中的{}和里面的内容需要替换成具体的服务器地址和 realm 名字):
+```shell
+curl -X POST "http://{your-keycloack-server}/realms/{your-realm}/protocol/openid-connect/token" \ -H "Content-Type: application/x-www-form-urlencoded" \
+ -d "username={username}" \
+ -d "password={password}" \
+ -d 'grant_type=password' \
+ -d "client_id=iotdb-client"
+```
+
+示例结果如下:
+
+```json
+{"access_token":"eyJhbGciOiJSUzI1NiIsInR5cCIgOiAiSldUIiwia2lkIiA6ICJxMS1XbTBvelE1TzBtUUg4LVNKYXAyWmNONE1tdWNXd25RV0tZeFpKNG93In0.eyJleHAiOjE1OTAzOTgwNzEsImlhdCI6MTU5MDM5Nzc3MSwianRpIjoiNjA0ZmYxMDctN2NiNy00NTRmLWIwYmQtY2M2ZDQwMjFiNGU4IiwiaXNzIjoiaHR0cDovL2F1dGguZGVtby5wcmFnbWF0aWNpbmR1c3RyaWVzLmRlL2F1dGgvcmVhbG1zL0lvVERCIiwiYXVkIjoiYWNjb3VudCIsInN1YiI6ImJhMzJlNDcxLWM3NzItNGIzMy04ZGE2LTZmZThhY2RhMDA3MyIsInR5cCI6IkJlYXJlciIsImF6cCI6ImlvdGRiIiwic2Vzc2lvbl9zdGF0ZSI6IjA2MGQyODYyLTE0ZWQtNDJmZS1 [...]
+```
+
+### Cli 的批量操作
+当您想要通过脚本的方式通过 Cli / Shell 对 IoTDB 进行批量操作时,可以使用-e 参数。通过使用该参数,您可以在不进入客户端输入模式的情况下操作 IoTDB。
+
+为了避免 SQL 语句和其他参数混淆,现在只支持-e 参数作为最后的参数使用。
+
+针对 cli/Shell 工具的-e 参数用法如下:
+
+Linux 系统与 MacOS 指令:
+
+```shell
+Shell > bash sbin/start-cli.sh -h {host} -p {rpcPort} -u {user} -pw {password} -e {sql for iotdb}
+```
+
+Windows 系统指令
+```shell
+Shell > sbin\start-cli.bat -h {host} -p {rpcPort} -u {user} -pw {password} -e {sql for iotdb}
+```
+
+在 Windows 环境下,-e 参数的 SQL 语句需要使用` `` `对于`" "`进行替换
+
+为了更好的解释-e 参数的使用,可以参考下面在 Linux 上执行的例子。
+
+假设用户希望对一个新启动的 IoTDB 进行如下操作:
+
+1. 创建名为 root.demo 的 database
+
+2. 创建名为 root.demo.s1 的时间序列
+
+3. 向创建的时间序列中插入三个数据点
+
+4. 查询验证数据是否插入成功
+
+那么通过使用 cli/Shell 工具的 -e 参数,可以采用如下的脚本:
+
+```shell
+# !/bin/bash
+
+host=127.0.0.1
+rpcPort=6667
+user=root
+pass=root
+
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "CREATE DATABASE root.demo"
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "create timeseries root.demo.s1 WITH DATATYPE=INT32, ENCODING=RLE"
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "insert into root.demo(timestamp,s1) values(1,10)"
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "insert into root.demo(timestamp,s1) values(2,11)"
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "insert into root.demo(timestamp,s1) values(3,12)"
+bash ./sbin/start-cli.sh -h ${host} -p ${rpcPort} -u ${user} -pw ${pass} -e "select s1 from root.demo"
+```
+
+打印出来的结果显示如下,通过这种方式进行的操作与客户端的输入模式以及通过 JDBC 进行操作结果是一致的。
+
+```shell
+ Shell > bash ./shell.sh
++-----------------------------+------------+
+| Time|root.demo.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.001+08:00| 10|
+|1970-01-01T08:00:00.002+08:00| 11|
+|1970-01-01T08:00:00.003+08:00| 12|
++-----------------------------+------------+
+Total line number = 3
+It costs 0.267s
+```
+
+需要特别注意的是,在脚本中使用 -e 参数时要对特殊字符进行转义。
+
diff --git a/docs/zh/UserGuide/Tools-System/Import-Export-Tool.md b/docs/zh/UserGuide/Tools-System/Import-Export-Tool.md
new file mode 100644
index 00000000000..f74c52efecf
--- /dev/null
+++ b/docs/zh/UserGuide/Tools-System/Import-Export-Tool.md
@@ -0,0 +1,427 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 导入导出工具
+
+针对于不同场景,IoTDB 为用户提供多种批量导入数据的操作方式,本章节向大家介绍最为常用的两种方式为 CSV文本形式的导入 和 TsFile文件形式的导入。
+
+## TsFile导入导出工具
+
+TsFile 是在 IoTDB 中使用的时间序列的文件格式,您可以通过CLI等工具直接将存有时间序列的一个或多个 TsFile 文件导入到另外一个正在运行的IoTDB实例中。
+### 介绍
+加载外部 tsfile 文件工具允许用户向正在运行中的 Apache IoTDB 中加载 tsfile 文件。或者您也可以使用脚本的方式将tsfile加载进IoTDB。
+
+### 使用SQL加载
+用户通过 Cli 工具或 JDBC 向 Apache IoTDB 系统发送指定命令实现文件加载的功能。
+
+#### 加载 tsfile 文件
+
+加载 tsfile 文件的指令为:`load '<path/dir>' [sglevel=int][verify=true/false][onSuccess=delete/none]`
+
+该指令有两种用法:
+
+1. 通过指定文件路径(绝对路径)加载单 tsfile 文件。
+
+第一个参数表示待加载的 tsfile 文件的路径。load 命令有三个可选项,分别是 sglevel,值域为整数,verify,值域为 true/false,onSuccess,值域为delete/none。不同选项之间用空格隔开,选项之间无顺序要求。
+
+SGLEVEL 选项,当 tsfile 对应的 database 不存在时,用户可以通过 sglevel 参数的值来制定 database 的级别,默认为`iotdb-datanode.properties`中设置的级别。例如当设置 level 参数为1时表明此 tsfile 中所有时间序列中层级为1的前缀路径是 database,即若存在设备 root.sg.d1.s1,此时 root.sg 被指定为 database。
+
+VERIFY 选项表示是否对载入的 tsfile 中的所有时间序列进行元数据检查,默认为 true。开启时,若载入的 tsfile 中的时间序列在当前 iotdb 中也存在,则会比较该时间序列的所有 Measurement 的数据类型是否一致,如果出现不一致将会导致载入失败,关闭该选项会跳过检查,载入更快。
+
+ONSUCCESS选项表示对于成功载入的tsfile的处置方式,默认为delete,即tsfile成功加载后将被删除,如果是none表明tsfile成功加载之后依然被保留在源文件夹。
+
+若待加载的 tsfile 文件对应的`.resource`文件存在,会被一并加载至 Apache IoTDB 数据文件的目录和引擎中,否则将通过 tsfile 文件重新生成对应的`.resource`文件,即加载的 tsfile 文件所对应的`.resource`文件不是必要的。
+
+示例:
+
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile'`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' sglevel=1`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' onSuccess=delete`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true sglevel=1`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false sglevel=1`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true onSuccess=none`
+* `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false sglevel=1 onSuccess=delete`
+
+
+2. 通过指定文件夹路径(绝对路径)批量加载文件。
+
+第一个参数表示待加载的 tsfile 文件夹的路径。选项意义与加载单个 tsfile 文件相同。
+
+示例:
+
+* `load '/Users/Desktop/data'`
+* `load '/Users/Desktop/data' verify=false`
+* `load '/Users/Desktop/data' verify=true`
+* `load '/Users/Desktop/data' verify=true sglevel=1`
+* `load '/Users/Desktop/data' verify=false sglevel=1 onSuccess=delete`
+
+**注意**,如果`$IOTDB_HOME$/conf/iotdb-datanode.properties`中`enable_auto_create_schema=true`时会在加载tsfile的时候自动创建tsfile中的元数据,否则不会自动创建。
+
+### 使用脚本加载
+
+若您在Windows环境中,请运行`$IOTDB_HOME/tools/load-tsfile.bat`,若为Linux或Unix,请运行`load-tsfile.sh`
+
+```bash
+./load-tsfile.bat -f filePath [-h host] [-p port] [-u username] [-pw password] [--sgLevel int] [--verify true/false] [--onSuccess none/delete]
+-f 待加载的文件或文件夹路径,必要字段
+-h IoTDB的Host地址,可选,默认127.0.0.1
+-p IoTDB的端口,可选,默认6667
+-u IoTDb登录用户名,可选,默认root
+-pw IoTDB登录密码,可选,默认root
+--sgLevel 加载TsFile自动创建Database的路径层级,可选,默认值为iotdb-common.properties指定值
+--verify 是否对加载TsFile进行元数据校验,可选,默认为True
+--onSuccess 对成功加载的TsFile的处理方法,可选,默认为delete,成功加载之后删除源TsFile,设为none时会 保留源TsFile
+```
+
+#### 使用范例
+
+假定服务器192.168.0.101:6667上运行一个IoTDB实例,想从将本地保存的TsFile备份文件夹D:\IoTDB\data中的所有的TsFile文件都加载进此IoTDB实例。
+
+首先移动至`$IOTDB_HOME/tools/`,打开命令行,然后执行
+
+```bash
+./load-tsfile.bat -f D:\IoTDB\data -h 192.168.0.101 -p 6667 -u root -pw root
+```
+
+等待脚本执行完成之后,可以检查IoTDB实例中数据已经被正确加载
+
+#### 常见问题
+
+- 找不到或无法加载主类
+ - 可能是由于未设置环境变量$IOTDB_HOME,请设置环境变量之后重试
+- 提示-f option must be set!
+ - 输入命令缺少待-f字段(加载文件或文件夹路径),请添加之后重新执行
+- 执行到中途崩溃了想重新加载怎么办
+ - 重新执行刚才的命令,重新加载数据不会影响加载之后的正确性
+
+## 导出 TsFile
+
+TsFile 工具可帮您 通过执行指定sql、命令行sql、sql文件的方式将结果集以TsFile文件的格式导出至指定路径.
+
+### 使用 export-tsfile.sh
+
+#### 运行方法
+
+```shell
+# Unix/OS X
+> tools/export-tsfile.sh -h <ip> -p <port> -u <username> -pw <password> -td <directory> [-f <export filename> -q <query command> -s <sql file>]
+
+# Windows
+> tools\export-tsfile.bat -h <ip> -p <port> -u <username> -pw <password> -td <directory> [-f <export filename> -q <query command> -s <sql file>]
+```
+
+参数:
+* `-h <host>`:
+ - IoTDB服务的主机地址。
+* `-p <port>`:
+ - IoTDB服务的端口号。
+* `-u <username>`:
+ - IoTDB服务的用户名。
+* `-pw <password>`:
+ - IoTDB服务的密码。
+* `-td <directory>`:
+ - 为导出的TsFile文件指定输出路径。
+* `-f <tsfile name>`:
+ - 为导出的TsFile文件的文件名,只需写文件名称,不能包含文件路径和后缀。如果sql文件或控制台输入时包含多个sql,会按照sql顺序生成多个TsFile文件。
+ - 例如:文件中或命令行共有3个SQL,-f 为"dump",那么会在目标路径下生成 dump0.tsfile、dump1.tsfile、dump2.tsfile三个TsFile文件。
+* `-q <query command>`:
+ - 在命令中直接指定想要执行的查询语句。
+ - 例如: `select * from root.** limit 100`
+* `-s <sql file>`:
+ - 指定一个SQL文件,里面包含一条或多条SQL语句。如果一个SQL文件中包含多条SQL语句,SQL语句之间应该用换行符进行分割。每一条SQL语句对应一个输出的TsFile文件。
+* `-t <timeout>`:
+ - 指定session查询时的超时时间,单位为ms
+
+
+除此之外,如果你没有使用`-s`和`-q`参数,在导出脚本被启动之后你需要按照程序提示输入查询语句,不同的查询结果会被保存到不同的TsFile文件中。
+
+#### 运行示例
+
+```shell
+# Unix/OS X
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./
+# or
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -q "select * from root.**"
+# Or
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt
+# Or
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt -f myTsFile
+# Or
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt -f myTsFile -t 10000
+
+# Windows
+> tools/export-tsfile.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./
+# Or
+> tools/export-tsfile.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -q "select * from root.**"
+# Or
+> tools/export-tsfile.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt
+# Or
+> tools/export-tsfile.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt -f myTsFile
+# Or
+> tools/export-tsfile.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s ./sql.txt -f myTsFile -t 10000
+```
+
+#### Q&A
+
+- 建议在导入数据时不要同时执行写入数据命令,这将有可能导致JVM内存不足的情况。
+
+## CSV导入导出工具
+
+CSV 是以纯文本形式存储表格数据,您可以在CSV文件中写入多条格式化的数据,并批量的将这些数据导入到 IoTDB 中,在导入数据之前,建议在IoTDB中创建好对应的元数据信息。如果忘记创建元数据也不要担心,IoTDB 可以自动将CSV中数据推断为其对应的数据类型,前提是你每一列的数据类型必须唯一。除单个文件外,此工具还支持以文件夹的形式导入多个 CSV 文件,并且支持设置如时间精度等优化参数。具体操作方式请参考 [CSV 导入导出工具](../Maintenance-Tools/CSV-Tool.md)。
+
+### 使用 export-csv.sh
+
+#### 运行方法
+
+```shell
+# Unix/OS X
+> tools/export-csv.sh -h <ip> -p <port> -u <username> -pw <password> -td <directory> [-tf <time-format> -datatype <true/false> -q <query command> -s <sql file>]
+
+# Windows
+> tools\export-csv.bat -h <ip> -p <port> -u <username> -pw <password> -td <directory> [-tf <time-format> -datatype <true/false> -q <query command> -s <sql file>]
+```
+
+参数:
+
+* `-datatype`:
+ - true (默认): 在CSV文件的header中时间序列的后面打印出对应的数据类型。例如:`Time, root.sg1.d1.s1(INT32), root.sg1.d1.s2(INT64)`.
+ - false: 只在CSV的header中打印出时间序列的名字, `Time, root.sg1.d1.s1 , root.sg1.d1.s2`
+* `-q <query command>`:
+ - 在命令中直接指定想要执行的查询语句。
+ - 例如: `select * from root.** limit 100`, or `select * from root.** limit 100 align by device`
+* `-s <sql file>`:
+ - 指定一个SQL文件,里面包含一条或多条SQL语句。如果一个SQL文件中包含多条SQL语句,SQL语句之间应该用换行符进行分割。每一条SQL语句对应一个输出的CSV文件。
+* `-td <directory>`:
+ - 为导出的CSV文件指定输出路径。
+* `-tf <time-format>`:
+ - 指定一个你想要得到的时间格式。时间格式必须遵守[ISO 8601](https://calendars.wikia.org/wiki/ISO_8601)标准。如果说你想要以时间戳来保存时间,那就设置为`-tf timestamp`。
+ - 例如: `-tf yyyy-MM-dd\ HH:mm:ss` or `-tf timestamp`
+* `-linesPerFile <int>`:
+ - 指定导出的dump文件最大行数,默认值为`10000`。
+ - 例如: `-linesPerFile 1`
+* `-t <timeout>`:
+ - 指定session查询时的超时时间,单位为ms
+
+除此之外,如果你没有使用`-s`和`-q`参数,在导出脚本被启动之后你需要按照程序提示输入查询语句,不同的查询结果会被保存到不同的CSV文件中。
+
+#### 运行示例
+
+```shell
+# Unix/OS X
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss
+# or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -q "select * from root.**"
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s sql.txt
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt -linesPerFile 10
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt -linesPerFile 10 -t 10000
+
+# Windows
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./
+# Or
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss
+# or
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -q "select * from root.**"
+# Or
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -s sql.txt
+# Or
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt
+# Or
+> tools/export-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt -linesPerFile 10
+# Or
+> tools/export-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -td ./ -tf yyyy-MM-dd\ HH:mm:ss -s sql.txt -linesPerFile 10 -t 10000
+```
+
+#### SQL 文件示例
+
+```sql
+select * from root.**;
+select * from root.** align by device;
+```
+
+`select * from root.**`的执行结果:
+
+```sql
+Time,root.ln.wf04.wt04.status(BOOLEAN),root.ln.wf03.wt03.hardware(TEXT),root.ln.wf02.wt02.status(BOOLEAN),root.ln.wf02.wt02.hardware(TEXT),root.ln.wf01.wt01.hardware(TEXT),root.ln.wf01.wt01.status(BOOLEAN)
+1970-01-01T08:00:00.001+08:00,true,"v1",true,"v1",v1,true
+1970-01-01T08:00:00.002+08:00,true,"v1",,,,true
+```
+
+`select * from root.** align by device`的执行结果:
+
+```sql
+Time,Device,hardware(TEXT),status(BOOLEAN)
+1970-01-01T08:00:00.001+08:00,root.ln.wf01.wt01,"v1",true
+1970-01-01T08:00:00.002+08:00,root.ln.wf01.wt01,,true
+1970-01-01T08:00:00.001+08:00,root.ln.wf02.wt02,"v1",true
+1970-01-01T08:00:00.001+08:00,root.ln.wf03.wt03,"v1",
+1970-01-01T08:00:00.002+08:00,root.ln.wf03.wt03,"v1",
+1970-01-01T08:00:00.001+08:00,root.ln.wf04.wt04,,true
+1970-01-01T08:00:00.002+08:00,root.ln.wf04.wt04,,true
+```
+
+布尔类型的数据用`true`或者`false`来表示,此处没有用双引号括起来。文本数据需要使用双引号括起来。
+
+#### 注意
+
+注意,如果导出字段存在如下特殊字符:
+
+1. `,`: 导出程序会在`,`字符前加`\`来进行转义。
+
+### 使用 import-csv.sh
+
+#### 创建元数据 (可选)
+
+```sql
+CREATE DATABASE root.fit.d1;
+CREATE DATABASE root.fit.d2;
+CREATE DATABASE root.fit.p;
+CREATE TIMESERIES root.fit.d1.s1 WITH DATATYPE=INT32,ENCODING=RLE;
+CREATE TIMESERIES root.fit.d1.s2 WITH DATATYPE=TEXT,ENCODING=PLAIN;
+CREATE TIMESERIES root.fit.d2.s1 WITH DATATYPE=INT32,ENCODING=RLE;
+CREATE TIMESERIES root.fit.d2.s3 WITH DATATYPE=INT32,ENCODING=RLE;
+CREATE TIMESERIES root.fit.p.s1 WITH DATATYPE=INT32,ENCODING=RLE;
+```
+
+IoTDB 具有类型推断的能力,因此在数据导入前创建元数据不是必须的。但我们仍然推荐在使用 CSV 导入工具导入数据前创建元数据,因为这可以避免不必要的类型转换错误。
+
+#### 待导入 CSV 文件示例
+
+通过时间对齐,并且header中不包含数据类型的数据。
+
+```sql
+Time,root.test.t1.str,root.test.t2.str,root.test.t2.int
+1970-01-01T08:00:00.001+08:00,"123hello world","123\,abc",100
+1970-01-01T08:00:00.002+08:00,"123",,
+```
+
+通过时间对齐,并且header中包含数据类型的数据。(Text类型数据支持加双引号和不加双引号)
+
+```sql
+Time,root.test.t1.str(TEXT),root.test.t2.str(TEXT),root.test.t2.int(INT32)
+1970-01-01T08:00:00.001+08:00,"123hello world","123\,abc",100
+1970-01-01T08:00:00.002+08:00,123,hello world,123
+1970-01-01T08:00:00.003+08:00,"123",,
+1970-01-01T08:00:00.004+08:00,123,,12
+```
+
+通过设备对齐,并且header中不包含数据类型的数据。
+
+```sql
+Time,Device,str,int
+1970-01-01T08:00:00.001+08:00,root.test.t1,"123hello world",
+1970-01-01T08:00:00.002+08:00,root.test.t1,"123",
+1970-01-01T08:00:00.001+08:00,root.test.t2,"123\,abc",100
+```
+
+通过设备对齐,并且header中包含数据类型的数据。(Text类型数据支持加双引号和不加双引号)
+
+```sql
+Time,Device,str(TEXT),int(INT32)
+1970-01-01T08:00:00.001+08:00,root.test.t1,"123hello world",
+1970-01-01T08:00:00.002+08:00,root.test.t1,"123",
+1970-01-01T08:00:00.001+08:00,root.test.t2,"123\,abc",100
+1970-01-01T08:00:00.002+08:00,root.test.t1,hello world,123
+```
+
+#### 运行方法
+
+```shell
+# Unix/OS X
+>tools/import-csv.sh -h <ip> -p <port> -u <username> -pw <password> -f <xxx.csv> [-fd <./failedDirectory>] [-aligned <true>] [-tp <ms/ns/us>] [-typeInfer <boolean=text,float=double...>] [-linesPerFailedFile <int_value>]
+# Windows
+>tools\import-csv.bat -h <ip> -p <port> -u <username> -pw <password> -f <xxx.csv> [-fd <./failedDirectory>] [-aligned <true>] [-tp <ms/ns/us>] [-typeInfer <boolean=text,float=double...>] [-linesPerFailedFile <int_value>]
+```
+
+参数:
+
+* `-f`:
+ - 指定你想要导入的数据,这里可以指定文件或者文件夹。如果指定的是文件夹,将会把文件夹中所有的后缀为txt与csv的文件进行批量导入。
+ - 例如: `-f filename.csv`
+
+* `-fd`:
+ - 指定一个目录来存放保存失败的行的文件,如果你没有指定这个参数,失败的文件将会被保存到源数据的目录中,然后文件名是源文件名加上`.failed`的后缀。
+ - 例如: `-fd ./failed/`
+
+* `-aligned`:
+ - 是否使用`aligned`接口? 默认参数为`false`。
+ - 例如: `-aligned true`
+
+* `-batch`:
+ - 用于指定每一批插入的数据的点数。如果程序报了`org.apache.thrift.transport.TTransportException: Frame size larger than protect max size`这个错的话,就可以适当的调低这个参数。
+ - 例如: `-batch 100000`,`100000`是默认值。
+
+* `-tp`:
+ - 用于指定时间精度,可选值包括`ms`(毫秒),`ns`(纳秒),`us`(微秒),默认值为`ms`。
+
+* `-typeInfer <srcTsDataType1=dstTsDataType1,srcTsDataType2=dstTsDataType2,...>`:
+ - 用于指定类型推断规则.
+ - `srcTsDataType` 包括 `boolean`,`int`,`long`,`float`,`double`,`NaN`.
+ - `dstTsDataType` 包括 `boolean`,`int`,`long`,`float`,`double`,`text`.
+ - 当`srcTsDataType`为`boolean`, `dstTsDataType`只能为`boolean`或`text`.
+ - 当`srcTsDataType`为`NaN`, `dstTsDataType`只能为`float`, `double`或`text`.
+ - 当`srcTsDataType`为数值类型, `dstTsDataType`的精度需要高于`srcTsDataType`.
+ - 例如:`-typeInfer boolean=text,float=double`
+
+* `-linesPerFailedFile <int>`:
+ - 用于指定每个导入失败文件写入数据的行数,默认值为10000。
+ - 例如:`-linesPerFailedFile 1`
+
+#### 运行示例
+
+```sh
+# Unix/OS X
+>tools/import-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd ./failed
+# or
+>tools/import-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd ./failed
+# or
+> tools\import-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd ./failed -tp ns
+# or
+> tools\import-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd ./failed -tp ns -typeInfer boolean=text,float=double
+# or
+> tools\import-csv.sh -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd ./failed -tp ns -typeInfer boolean=text,float=double -linesPerFailedFile 10
+# Windows
+>tools\import-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv
+# or
+>tools\import-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd .\failed
+# or
+> tools\import-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd .\failed -tp ns
+# or
+> tools\import-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd .\failed -tp ns -typeInfer boolean=text,float=double
+# or
+> tools\import-csv.bat -h 127.0.0.1 -p 6667 -u root -pw root -f example-filename.csv -fd .\failed -tp ns -typeInfer boolean=text,float=double -linesPerFailedFile 10
+```
+
+#### 注意
+
+注意,在导入数据前,需要特殊处理下列的字符:
+
+1. `,` :如果text类型的字段中包含`,`那么需要用`\`来进行转义。
+2. 你可以导入像`yyyy-MM-dd'T'HH:mm:ss`, `yyy-MM-dd HH:mm:ss`, 或者 `yyyy-MM-dd'T'HH:mm:ss.SSSZ`格式的时间。
+3. `Time`这一列应该放在第一列。
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Tools-System/Maintenance-Tool.md b/docs/zh/UserGuide/Tools-System/Maintenance-Tool.md
new file mode 100644
index 00000000000..611840b3832
--- /dev/null
+++ b/docs/zh/UserGuide/Tools-System/Maintenance-Tool.md
@@ -0,0 +1,388 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 运维工具
+## 集群管理工具
+以本地环境为例,演示 IoTDB 集群的启动、扩容与缩容。
+
+**注意:本文档为使用本地不同端口,进行伪分布式环境部署的教程,仅用于练习。在真实环境部署时,一般不需要修改节点端口,仅需配置节点 IPV4 地址或域名即可。**
+
+### 1. 准备启动环境
+
+解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster0 目录。
+
+### 2. 启动最小集群
+
+在 Linux 环境中,部署 1 个 ConfigNode 和 1 个 DataNode(1C1D)集群版,默认 1 副本:
+```
+./cluster0/sbin/start-confignode.sh
+./cluster0/sbin/start-datanode.sh
+```
+
+### 3. 验证最小集群
+
++ 最小集群启动成功,启动 Cli 进行验证:
+```
+./cluster0/sbin/start-cli.sh
+```
+
++ 在 Cli 执行 [show cluster details](https://iotdb.apache.org/zh/UserGuide/Master/Maintenance-Tools/Maintenance-Command.html#%E6%9F%A5%E7%9C%8B%E5%85%A8%E9%83%A8%E8%8A%82%E7%82%B9%E4%BF%A1%E6%81%AF)
+ 指令,结果如下所示:
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort |SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+Total line number = 2
+It costs 0.242s
+```
+
+### 4. 准备扩容环境
+
+解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster1 目录和 cluster2 目录
+
+### 5. 修改节点配置文件
+
+对于 cluster1 目录:
+
++ 修改 ConfigNode 配置:
+
+| **配置项** | **值** |
+|--------------------------------|-----------------|
+| cn\_internal\_address | 127.0.0.1 |
+| cn\_internal\_port | 10711 |
+| cn\_consensus\_port | 10721 |
+| cn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
++ 修改 DataNode 配置:
+
+| **配置项** | **值** |
+|----------------------------------------|-----------------|
+| dn\_rpc\_address | 127.0.0.1 |
+| dn\_rpc\_port | 6668 |
+| dn\_internal\_address | 127.0.0.1 |
+| dn\_internal\_port | 10731 |
+| dn\_mpp\_data\_exchange\_port | 10741 |
+| dn\_schema\_region\_consensus\_port | 10751 |
+| dn\_data\_region\_consensus\_port | 10761 |
+| dn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
+对于 cluster2 目录:
+
++ 修改 ConfigNode 配置:
+
+| **配置项** | **值** |
+|--------------------------------|-----------------|
+| cn\_internal\_address | 127.0.0.1 |
+| cn\_internal\_port | 10712 |
+| cn\_consensus\_port | 10722 |
+| cn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
++ 修改 DataNode 配置:
+
+| **配置项** | **值** |
+|--------------------------------------|-----------------|
+| dn\_rpc\_address | 127.0.0.1 |
+| dn\_rpc\_port | 6669 |
+| dn\_internal\_address | 127.0.0.1 |
+| dn\_internal\_port | 10732 |
+| dn\_mpp\_data\_exchange\_port | 10742 |
+| dn\_schema\_region\_consensus\_port | 10752 |
+| dn\_data\_region\_consensus\_port | 10762 |
+| dn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
+### 6. 集群扩容
+
+将集群扩容至 3 个 ConfigNode 和 3 个 DataNode(3C3D)集群版,
+指令执行顺序为先启动 ConfigNode,再启动 DataNode:
+```
+./cluster1/sbin/start-confignode.sh
+./cluster2/sbin/start-confignode.sh
+./cluster1/sbin/start-datanode.sh
+./cluster2/sbin/start-datanode.sh
+```
+
+### 7. 验证扩容结果
+
+在 Cli 执行 `show cluster details`,结果如下:
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort|SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 2|ConfigNode|Running| 127.0.0.1| 10711| 10721| | | | | |
+| 3|ConfigNode|Running| 127.0.0.1| 10712| 10722| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
+| 4| DataNode|Running| 127.0.0.1| 10731| | 127.0.0.1| 6668| 10741| 10751| 10761|
+| 5| DataNode|Running| 127.0.0.1| 10732| | 127.0.0.1| 6669| 10742| 10752| 10762|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+Total line number = 6
+It costs 0.012s
+```
+
+### 8. 集群缩容
+
++ 缩容一个 ConfigNode:
+```
+# 使用 ip:port 移除
+./cluster0/sbin/remove-confignode.sh 127.0.0.1:10711
+
+# 使用节点编号移除
+./cluster0/sbin/remove-confignode.sh 2
+```
+
++ 缩容一个 DataNode:
+```
+# 使用 ip:port 移除
+./cluster0/sbin/remove-datanode.sh 127.0.0.1:6668
+
+# 使用节点编号移除
+./cluster0/sbin/remove-confignode.sh 4
+```
+
+### 9. 验证缩容结果
+
+在 Cli 执行 `show cluster details`,结果如下:
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort|SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 3|ConfigNode|Running| 127.0.0.1| 10712| 10722| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
+| 5| DataNode|Running| 127.0.0.1| 10732| | 127.0.0.1| 6669| 10742| 10752| 10762|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+Total line number = 4
+It costs 0.005s
+```
+
+
+## 数据文件夹概览工具
+
+IoTDB数据文件夹概览工具用于打印出数据文件夹的结构概览信息,工具位置为 tools/tsfile/print-iotdb-data-dir。
+
+### 用法
+
+- Windows:
+
+```bash
+.\print-iotdb-data-dir.bat <IoTDB数据文件夹路径,如果是多个文件夹用逗号分隔> (<输出结果的存储路径>)
+```
+
+- Linux or MacOs:
+
+```shell
+./print-iotdb-data-dir.sh <IoTDB数据文件夹路径,如果是多个文件夹用逗号分隔> (<输出结果的存储路径>)
+```
+
+注意:如果没有设置输出结果的存储路径, 将使用相对路径"IoTDB_data_dir_overview.txt"作为默认值。
+
+### 示例
+
+以Windows系统为例:
+
+`````````````````````````bash
+.\print-iotdb-data-dir.bat D:\github\master\iotdb\data\datanode\data
+````````````````````````
+Starting Printing the IoTDB Data Directory Overview
+````````````````````````
+output save path:IoTDB_data_dir_overview.txt
+data dir num:1
+143 [main] WARN o.a.i.t.c.conf.TSFileDescriptor - not found iotdb-common.properties, use the default configs.
+|==============================================================
+|D:\github\master\iotdb\data\datanode\data
+|--sequence
+| |--root.redirect0
+| | |--1
+| | | |--0
+| |--root.redirect1
+| | |--2
+| | | |--0
+| |--root.redirect2
+| | |--3
+| | | |--0
+| |--root.redirect3
+| | |--4
+| | | |--0
+| |--root.redirect4
+| | |--5
+| | | |--0
+| |--root.redirect5
+| | |--6
+| | | |--0
+| |--root.sg1
+| | |--0
+| | | |--0
+| | | |--2760
+|--unsequence
+|==============================================================
+`````````````````````````
+
+## TsFile概览工具
+
+TsFile概览工具用于以概要模式打印出一个TsFile的内容,工具位置为 tools/tsfile/print-tsfile。
+
+### 用法
+
+- Windows:
+
+```bash
+.\print-tsfile-sketch.bat <TsFile文件路径> (<输出结果的存储路径>)
+```
+
+- Linux or MacOs:
+
+```shell
+./print-tsfile-sketch.sh <TsFile文件路径> (<输出结果的存储路径>)
+```
+
+注意:如果没有设置输出结果的存储路径, 将使用相对路径"TsFile_sketch_view.txt"作为默认值。
+
+### 示例
+
+以Windows系统为例:
+
+`````````````````````````bash
+.\print-tsfile.bat D:\github\master\1669359533965-1-0-0.tsfile D:\github\master\sketch.txt
+````````````````````````
+Starting Printing the TsFile Sketch
+````````````````````````
+TsFile path:D:\github\master\1669359533965-1-0-0.tsfile
+Sketch save path:D:\github\master\sketch.txt
+148 [main] WARN o.a.i.t.c.conf.TSFileDescriptor - not found iotdb-common.properties, use the default configs.
+-------------------------------- TsFile Sketch --------------------------------
+file path: D:\github\master\1669359533965-1-0-0.tsfile
+file length: 2974
+
+ POSITION| CONTENT
+ -------- -------
+ 0| [magic head] TsFile
+ 6| [version number] 3
+||||||||||||||||||||| [Chunk Group] of root.sg1.d1, num of Chunks:3
+ 7| [Chunk Group Header]
+ | [marker] 0
+ | [deviceID] root.sg1.d1
+ 20| [Chunk] of root.sg1.d1.s1, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-9032452783138882770,maxValue:9117677033041335123,firstValue:7068645577795875906,lastValue:-5833792328174747265,sumValue:5.795959009889246E19]
+ | [chunk header] marker=5, measurementID=s1, dataSize=864, dataType=INT64, compressionType=SNAPPY, encodingType=RLE
+ | [page] UncompressedSize:862, CompressedSize:860
+ 893| [Chunk] of root.sg1.d1.s2, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-8806861312244965718,maxValue:9192550740609853234,firstValue:1150295375739457693,lastValue:-2839553973758938646,sumValue:8.2822564314572677E18]
+ | [chunk header] marker=5, measurementID=s2, dataSize=864, dataType=INT64, compressionType=SNAPPY, encodingType=RLE
+ | [page] UncompressedSize:862, CompressedSize:860
+ 1766| [Chunk] of root.sg1.d1.s3, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-9076669333460323191,maxValue:9175278522960949594,firstValue:2537897870994797700,lastValue:7194625271253769397,sumValue:-2.126008424849926E19]
+ | [chunk header] marker=5, measurementID=s3, dataSize=864, dataType=INT64, compressionType=SNAPPY, encodingType=RLE
+ | [page] UncompressedSize:862, CompressedSize:860
+||||||||||||||||||||| [Chunk Group] of root.sg1.d1 ends
+ 2656| [marker] 2
+ 2657| [TimeseriesIndex] of root.sg1.d1.s1, tsDataType:INT64, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-9032452783138882770,maxValue:9117677033041335123,firstValue:7068645577795875906,lastValue:-5833792328174747265,sumValue:5.795959009889246E19]
+ | [ChunkIndex] offset=20
+ 2728| [TimeseriesIndex] of root.sg1.d1.s2, tsDataType:INT64, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-8806861312244965718,maxValue:9192550740609853234,firstValue:1150295375739457693,lastValue:-2839553973758938646,sumValue:8.2822564314572677E18]
+ | [ChunkIndex] offset=893
+ 2799| [TimeseriesIndex] of root.sg1.d1.s3, tsDataType:INT64, startTime: 1669359533948 endTime: 1669359534047 count: 100 [minValue:-9076669333460323191,maxValue:9175278522960949594,firstValue:2537897870994797700,lastValue:7194625271253769397,sumValue:-2.126008424849926E19]
+ | [ChunkIndex] offset=1766
+ 2870| [IndexOfTimerseriesIndex Node] type=LEAF_MEASUREMENT
+ | <s1, 2657>
+ | <endOffset, 2870>
+||||||||||||||||||||| [TsFileMetadata] begins
+ 2891| [IndexOfTimerseriesIndex Node] type=LEAF_DEVICE
+ | <root.sg1.d1, 2870>
+ | <endOffset, 2891>
+ | [meta offset] 2656
+ | [bloom filter] bit vector byte array length=31, filterSize=256, hashFunctionSize=5
+||||||||||||||||||||| [TsFileMetadata] ends
+ 2964| [TsFileMetadataSize] 73
+ 2968| [magic tail] TsFile
+ 2974| END of TsFile
+---------------------------- IndexOfTimerseriesIndex Tree -----------------------------
+ [MetadataIndex:LEAF_DEVICE]
+ └──────[root.sg1.d1,2870]
+ [MetadataIndex:LEAF_MEASUREMENT]
+ └──────[s1,2657]
+---------------------------------- TsFile Sketch End ----------------------------------
+`````````````````````````
+
+解释:
+
+- 以"|"为分隔,左边是在TsFile文件中的实际位置,右边是梗概内容。
+- "|||||||||||||||||||||"是为增强可读性而添加的导引信息,不是TsFile中实际存储的数据。
+- 最后打印的"IndexOfTimerseriesIndex Tree"是对TsFile文件末尾的元数据索引树的重新整理打印,便于直观理解,不是TsFile中存储的实际数据。
+
+## TsFile Resource概览工具
+
+TsFile resource概览工具用于打印出TsFile resource文件的内容,工具位置为 tools/tsfile/print-tsfile-resource-files。
+
+### 用法
+
+- Windows:
+
+```bash
+.\print-tsfile-resource-files.bat <TsFile resource文件所在的文件夹路径,或者单个TsFile resource文件路径>
+```
+
+- Linux or MacOs:
+
+```
+./print-tsfile-resource-files.sh <TsFile resource文件所在的文件夹路径,或者单个TsFile resource文件路径>
+```
+
+### 示例
+
+以Windows系统为例:
+
+`````````````````````````bash
+.\print-tsfile-resource-files.bat D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0
+````````````````````````
+Starting Printing the TsFileResources
+````````````````````````
+147 [main] WARN o.a.i.t.c.conf.TSFileDescriptor - not found iotdb-common.properties, use the default configs.
+230 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Cannot find IOTDB_HOME or IOTDB_CONF environment variable when loading config file iotdb-common.properties, use default configuration
+231 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Couldn't load the configuration iotdb-common.properties from any of the known sources.
+233 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Cannot find IOTDB_HOME or IOTDB_CONF environment variable when loading config file iotdb-datanode.properties, use default configuration
+237 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Couldn't load the configuration iotdb-datanode.properties from any of the known sources.
+Analyzing D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0\1669359533489-1-0-0.tsfile ...
+
+Resource plan index range [9223372036854775807, -9223372036854775808]
+device root.sg1.d1, start time 0 (1970-01-01T08:00+08:00[GMT+08:00]), end time 99 (1970-01-01T08:00:00.099+08:00[GMT+08:00])
+
+Analyzing the resource file folder D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0 finished.
+`````````````````````````
+
+`````````````````````````bash
+.\print-tsfile-resource-files.bat D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0\1669359533489-1-0-0.tsfile.resource
+````````````````````````
+Starting Printing the TsFileResources
+````````````````````````
+178 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Cannot find IOTDB_HOME or IOTDB_CONF environment variable when loading config file iotdb-common.properties, use default configuration
+186 [main] WARN o.a.i.t.c.conf.TSFileDescriptor - not found iotdb-common.properties, use the default configs.
+187 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Couldn't load the configuration iotdb-common.properties from any of the known sources.
+188 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Cannot find IOTDB_HOME or IOTDB_CONF environment variable when loading config file iotdb-datanode.properties, use default configuration
+192 [main] WARN o.a.iotdb.db.conf.IoTDBDescriptor - Couldn't load the configuration iotdb-datanode.properties from any of the known sources.
+Analyzing D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0\1669359533489-1-0-0.tsfile ...
+
+Resource plan index range [9223372036854775807, -9223372036854775808]
+device root.sg1.d1, start time 0 (1970-01-01T08:00+08:00[GMT+08:00]), end time 99 (1970-01-01T08:00:00.099+08:00[GMT+08:00])
+
+Analyzing the resource file D:\github\master\iotdb\data\datanode\data\sequence\root.sg1\0\0\1669359533489-1-0-0.tsfile.resource finished.
+`````````````````````````
diff --git a/docs/zh/UserGuide/Tools-System/Monitor-Tool.md b/docs/zh/UserGuide/Tools-System/Monitor-Tool.md
new file mode 100644
index 00000000000..73f2eb735a0
--- /dev/null
+++ b/docs/zh/UserGuide/Tools-System/Monitor-Tool.md
@@ -0,0 +1,109 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+
+# Prometheus
+
+## 监控指标的 Prometheus 映射关系
+
+> 对于 Metric Name 为 name, Tags 为 K1=V1, ..., Kn=Vn 的监控指标有如下映射,其中 value 为具体值
+
+| 监控指标类型 | 映射关系 [...]
+| ---------------- |---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- [...]
+| Counter | name_total{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value [...]
+| AutoGauge、Gauge | name{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value [...]
+| Histogram | name_max{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_sum{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_count{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn", quantile="0.5"} value <br> name{cluster="clusterName", nodeType="nod [...]
+| Rate | name_total{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_total{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn", rate="m1"} value <br> name_total{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn", rate="m5"} value <br> name_total{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn", rate="m15"} value <br> name_total{cl [...]
+| Timer | name_seconds_max{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_seconds_sum{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_seconds_count{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn"} value <br> name_seconds{cluster="clusterName", nodeType="nodeType", nodeId="nodeId",k1="V1" , ..., Kn="Vn", quantile="0.5"} value value <br> nam [...]
+
+## 修改配置文件
+
+1) 以 DataNode 为例,修改 iotdb-datanode.properties 配置文件如下:
+
+```properties
+dn_metric_reporter_list=PROMETHEUS
+dn_metric_level=CORE
+dn_metric_prometheus_reporter_port=9091
+```
+
+2) 启动 IoTDB DataNode
+
+3) 打开浏览器或者用```curl``` 访问 ```http://servier_ip:9091/metrics```, 就能得到如下 metric 数据:
+
+```
+...
+# HELP file_count
+# TYPE file_count gauge
+file_count{name="wal",} 0.0
+file_count{name="unseq",} 0.0
+file_count{name="seq",} 2.0
+...
+```
+
+## Prometheus + Grafana
+
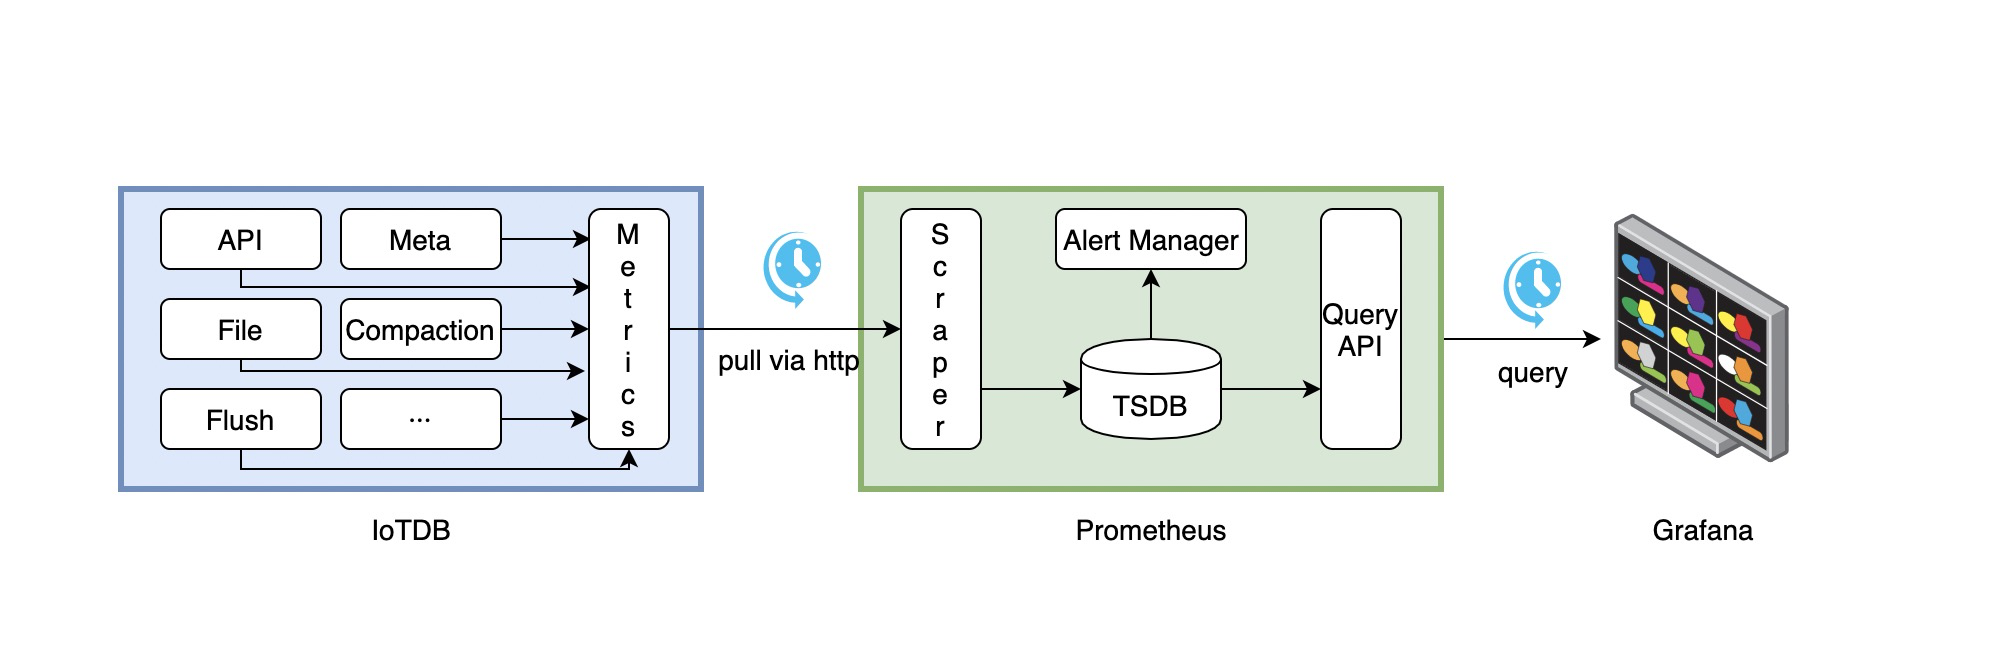
+如上所示,IoTDB 对外暴露出标准的 Prometheus 格式的监控指标数据,可以使用 Prometheus 采集并存储监控指标,使用 Grafana
+可视化监控指标。
+
+IoTDB、Prometheus、Grafana三者的关系如下图所示:
+
+
+
+1. IoTDB在运行过程中持续收集监控指标数据。
+2. Prometheus以固定的间隔(可配置)从IoTDB的HTTP接口拉取监控指标数据。
+3. Prometheus将拉取到的监控指标数据存储到自己的TSDB中。
+4. Grafana以固定的间隔(可配置)从Prometheus查询监控指标数据并绘图展示。
+
+从交互流程可以看出,我们需要做一些额外的工作来部署和配置Prometheus和Grafana。
+
+比如,你可以对Prometheus进行如下的配置(部分参数可以自行调整)来从IoTDB获取监控数据
+
+```yaml
+job_name: pull-metrics
+honor_labels: true
+honor_timestamps: true
+scrape_interval: 15s
+scrape_timeout: 10s
+metrics_path: /metrics
+scheme: http
+follow_redirects: true
+static_configs:
+ - targets:
+ - localhost:9091
+```
+
+更多细节可以参考下面的文档:
+
+[Prometheus安装使用文档](https://prometheus.io/docs/prometheus/latest/getting_started/)
+
+[Prometheus从HTTP接口拉取metrics数据的配置说明](https://prometheus.io/docs/prometheus/latest/configuration/configuration/#scrape_config)
+
+[Grafana安装使用文档](https://grafana.com/docs/grafana/latest/getting-started/getting-started/)
+
+[Grafana从Prometheus查询数据并绘图的文档](https://prometheus.io/docs/visualization/grafana/#grafana-support-for-prometheus)
+
+## Apache IoTDB Dashboard
+
+我们提供了Apache IoTDB Dashboard,在Grafana中显示的效果图如下所示:
+
+
+
+你可以在企业版中获取到 Dashboard 的 Json文件。
diff --git a/docs/zh/UserGuide/User-Manuel/Authority-Management.md b/docs/zh/UserGuide/User-Manuel/Authority-Management.md
new file mode 100644
index 00000000000..d59c8fc31f8
--- /dev/null
+++ b/docs/zh/UserGuide/User-Manuel/Authority-Management.md
@@ -0,0 +1,535 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 权限管理
+
+IoTDB 为用户提供了权限管理操作,从而为用户提供对于数据的权限管理功能,保障数据的安全。
+
+我们将通过以下几个具体的例子为您示范基本的用户权限操作,详细的 SQL 语句及使用方式详情请参见本文 [数据模式与概念章节](../Basic-Concept/Data-Model-and-Terminology.md)。同时,在 JAVA 编程环境中,您可以使用 [JDBC API](../API/Programming-JDBC.md) 单条或批量执行权限管理类语句。
+
+## 基本概念
+
+### 用户
+
+用户即数据库的合法使用者。一个用户与一个唯一的用户名相对应,并且拥有密码作为身份验证的手段。一个人在使用数据库之前,必须先提供合法的(即存于数据库中的)用户名与密码,使得自己成为用户。
+
+### 权限
+
+数据库提供多种操作,并不是所有的用户都能执行所有操作。如果一个用户可以执行某项操作,则称该用户有执行该操作的权限。权限可分为数据管理权限(如对数据进行增删改查)以及权限管理权限(用户、角色的创建与删除,权限的赋予与撤销等)。数据管理权限往往需要一个路径来限定其生效范围,可使用[路径模式](../Basic-Concept/Data-Model-and-Terminology.md)灵活管理权限。
+
+### 角色
+
+角色是若干权限的集合,并且有一个唯一的角色名作为标识符。用户通常和一个现实身份相对应(例如交通调度员),而一个现实身份可能对应着多个用户。这些具有相同现实身份的用户往往具有相同的一些权限。角色就是为了能对这样的权限进行统一的管理的抽象。
+
+### 默认用户及其具有的角色
+
+初始安装后的 IoTDB 中有一个默认用户:root,默认密码为 root。该用户为管理员用户,固定拥有所有权限,无法被赋予、撤销权限,也无法被删除。
+
+## 权限操作示例
+
+根据本文中描述的 [样例数据](https://github.com/thulab/iotdb/files/4438687/OtherMaterial-Sample.Data.txt) 内容,IoTDB 的样例数据可能同时属于 ln, sgcc 等不同发电集团,不同的发电集团不希望其他发电集团获取自己的数据库数据,因此我们需要将不同的数据在集团层进行权限隔离。
+
+### 创建用户
+
+使用 `CREATE USER <userName> <password>` 创建用户。例如,我们可以使用具有所有权限的root用户为 ln 和 sgcc 集团创建两个用户角色,名为 ln_write_user, sgcc_write_user,密码均为 write_pwd。建议使用反引号(`)包裹用户名。SQL 语句为:
+
+```
+CREATE USER `ln_write_user` 'write_pwd'
+CREATE USER `sgcc_write_user` 'write_pwd'
+```
+
+此时使用展示用户的 SQL 语句:
+
+```
+LIST USER
+```
+
+我们可以看到这两个已经被创建的用户,结果如下:
+
+```
+IoTDB> CREATE USER `ln_write_user` 'write_pwd'
+Msg: The statement is executed successfully.
+IoTDB> CREATE USER `sgcc_write_user` 'write_pwd'
+Msg: The statement is executed successfully.
+IoTDB> LIST USER
++---------------+
+| user|
++---------------+
+| ln_write_user|
+| root|
+|sgcc_write_user|
++---------------+
+Total line number = 3
+It costs 0.157s
+```
+
+### 赋予用户权限
+
+此时,虽然两个用户已经创建,但是他们不具有任何权限,因此他们并不能对数据库进行操作,例如我们使用 ln_write_user 用户对数据库中的数据进行写入,SQL 语句为:
+
+```
+INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+```
+
+此时,系统不允许用户进行此操作,会提示错误:
+
+```
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+```
+
+现在,我们用root用户分别赋予他们向对应 database 数据的写入权限.
+
+我们使用 `GRANT USER <userName> PRIVILEGES <privileges> ON <nodeName>` 语句赋予用户权限(注:其中,创建用户权限无需指定路径),例如:
+
+```
+GRANT USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+GRANT USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+GRANT USER `ln_write_user` PRIVILEGES CREATE_USER
+```
+
+执行状态如下所示:
+
+```
+IoTDB> GRANT USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+Msg: The statement is executed successfully.
+IoTDB> GRANT USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+Msg: The statement is executed successfully.
+IoTDB> GRANT USER `ln_write_user` PRIVILEGES CREATE_USER
+Msg: The statement is executed successfully.
+```
+
+接着使用ln_write_user再尝试写入数据
+
+```
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+Msg: The statement is executed successfully.
+```
+
+### 撤销用户权限
+
+授予用户权限后,我们可以使用 `REVOKE USER <userName> PRIVILEGES <privileges> ON <nodeName>` 来撤销已授予的用户权限(注:其中,撤销创建用户权限无需指定路径)。例如,用root用户撤销ln_write_user和sgcc_write_user的权限:
+
+```
+REVOKE USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+REVOKE USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+REVOKE USER `ln_write_user` PRIVILEGES CREATE_USER
+```
+
+执行状态如下所示:
+
+```
+REVOKE USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+Msg: The statement is executed successfully.
+REVOKE USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+Msg: The statement is executed successfully.
+REVOKE USER `ln_write_user` PRIVILEGES CREATE_USER
+Msg: The statement is executed successfully.
+```
+
+撤销权限后,ln_write_user就没有向root.ln.**写入数据的权限了。
+
+```
+INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+```
+
+### SQL 语句
+
+与权限相关的语句包括:
+
+* 创建用户
+
+```
+CREATE USER <userName> <password>;
+Eg: IoTDB > CREATE USER `thulab` 'passwd';
+```
+
+* 删除用户
+
+```
+DROP USER <userName>;
+Eg: IoTDB > DROP USER `xiaoming`;
+```
+
+* 创建角色
+
+```
+CREATE ROLE <roleName>;
+Eg: IoTDB > CREATE ROLE `admin`;
+```
+
+* 删除角色
+
+```
+DROP ROLE <roleName>;
+Eg: IoTDB > DROP ROLE `admin`;
+```
+
+* 赋予用户权限
+
+```
+GRANT USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES on root.ln.**, root.sgcc.**;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES CREATE_ROLE;
+```
+
+- 赋予用户全部的权限
+
+```
+GRANT USER <userName> PRIVILEGES ALL;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES ALL;
+```
+
+* 赋予角色权限
+
+```
+GRANT ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES ON root.sgcc.**, root.ln.**;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES CREATE_ROLE;
+```
+
+- 赋予角色全部的权限
+
+```
+GRANT ROLE <roleName> PRIVILEGES ALL;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES ALL;
+```
+
+* 赋予用户角色
+
+```
+GRANT <roleName> TO <userName>;
+Eg: IoTDB > GRANT `temprole` TO tempuser;
+```
+
+* 撤销用户权限
+
+```
+REVOKE USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES DELETE_TIMESERIES on root.ln.**;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES CREATE_ROLE;
+```
+
+- 移除用户所有权限
+
+```
+REVOKE USER <userName> PRIVILEGES ALL;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES ALL;
+```
+
+* 撤销角色权限
+
+```
+REVOKE ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES DELETE_TIMESERIES ON root.ln.**;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES CREATE_ROLE;
+```
+
+- 撤销角色全部的权限
+
+```
+REVOKE ROLE <roleName> PRIVILEGES ALL;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES ALL;
+```
+
+* 撤销用户角色
+
+```
+REVOKE <roleName> FROM <userName>;
+Eg: IoTDB > REVOKE `temprole` FROM tempuser;
+```
+
+* 列出所有用户
+
+```
+LIST USER
+Eg: IoTDB > LIST USER
+```
+
+* 列出指定角色下所有用户
+
+```
+LIST USER OF ROLE <roleName>;
+Eg: IoTDB > LIST USER OF ROLE `roleuser`;
+```
+
+* 列出所有角色
+
+```
+LIST ROLE
+Eg: IoTDB > LIST ROLE
+```
+
+* 列出指定用户下所有角色
+
+```
+LIST ROLE OF USER <username> ;
+Eg: IoTDB > LIST ROLE OF USER `tempuser`;
+```
+
+* 列出用户所有权限
+
+```
+LIST PRIVILEGES USER <username>;
+Eg: IoTDB > LIST PRIVILEGES USER `tempuser`;
+```
+
+* 列出用户在具体路径上相关联的权限
+
+```
+LIST PRIVILEGES USER <username> ON <paths>;
+Eg: IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.**, root.ln.wf01.**;
++--------+-----------------------------------+
+| role| privilege|
++--------+-----------------------------------+
+| | root.ln.** : ALTER_TIMESERIES|
+|temprole|root.ln.wf01.** : CREATE_TIMESERIES|
++--------+-----------------------------------+
+Total line number = 2
+It costs 0.005s
+IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.wf01.wt01.**;
++--------+-----------------------------------+
+| role| privilege|
++--------+-----------------------------------+
+| | root.ln.** : ALTER_TIMESERIES|
+|temprole|root.ln.wf01.** : CREATE_TIMESERIES|
++--------+-----------------------------------+
+Total line number = 2
+It costs 0.005s
+```
+
+* 列出角色所有权限
+
+```
+LIST PRIVILEGES ROLE <roleName>;
+Eg: IoTDB > LIST PRIVILEGES ROLE `actor`;
+```
+
+* 列出角色在具体路径上相关联的权限
+
+```
+LIST PRIVILEGES ROLE <roleName> ON <paths>;
+Eg: IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.**, root.ln.wf01.wt01.**;
++-----------------------------------+
+| privilege|
++-----------------------------------+
+|root.ln.wf01.** : CREATE_TIMESERIES|
++-----------------------------------+
+Total line number = 1
+It costs 0.005s
+IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.wf01.wt01.**;
++-----------------------------------+
+| privilege|
++-----------------------------------+
+|root.ln.wf01.** : CREATE_TIMESERIES|
++-----------------------------------+
+Total line number = 1
+It costs 0.005s
+```
+
+* 更新密码
+
+```
+ALTER USER <username> SET PASSWORD <password>;
+Eg: IoTDB > ALTER USER `tempuser` SET PASSWORD 'newpwd';
+```
+
+
+## 其他说明
+
+### 用户、权限与角色的关系
+
+角色是权限的集合,而权限和角色都是用户的一种属性。即一个角色可以拥有若干权限。一个用户可以拥有若干角色与权限(称为用户自身权限)。
+
+目前在 IoTDB 中并不存在相互冲突的权限,因此一个用户真正具有的权限是用户自身权限与其所有的角色的权限的并集。即要判定用户是否能执行某一项操作,就要看用户自身权限或用户的角色的所有权限中是否有一条允许了该操作。用户自身权限与其角色权限,他的多个角色的权限之间可能存在相同的权限,但这并不会产生影响。
+
+需要注意的是:如果一个用户自身有某种权限(对应操作 A),而他的某个角色有相同的权限。那么如果仅从该用户撤销该权限无法达到禁止该用户执行操作 A 的目的,还需要从这个角色中也撤销对应的权限,或者从这个用户将该角色撤销。同样,如果仅从上述角色将权限撤销,也不能禁止该用户执行操作 A。
+
+同时,对角色的修改会立即反映到所有拥有该角色的用户上,例如对角色增加某种权限将立即使所有拥有该角色的用户都拥有对应权限,删除某种权限也将使对应用户失去该权限(除非用户本身有该权限)。
+
+### 系统所含权限列表
+
+| 权限名称 | 说明 | 示例 |
+| :------------------------ | :----------------------------------------------------------- | ------------------------------------------------------------ |
+| CREATE\_DATABASE | 创建 database。包含设置 database 的权限和TTL。路径相关 | Eg1: `CREATE DATABASE root.ln;`<br />Eg2:`set ttl to root.ln 3600000;`<br />Eg3:`unset ttl to root.ln;` |
+| DELETE\_DATABASE | 删除 database。路径相关 | Eg: `delete database root.ln;` |
+| CREATE\_TIMESERIES | 创建时间序列。路径相关 | Eg1: 创建时间序列<br />`create timeseries root.ln.wf02.status with datatype=BOOLEAN,encoding=PLAIN;`<br />Eg2: 创建对齐时间序列<br />`create aligned timeseries root.ln.device1(latitude FLOAT encoding=PLAIN compressor=SNAPPY, longitude FLOAT encoding=PLAIN compressor=SNAPPY);` |
+| INSERT\_TIMESERIES | 插入数据。路径相关 | Eg1: `insert into root.ln.wf02(timestamp,status) values(1,true);`<br />Eg2: `insert into root.sg1.d1(time, s1, s2) aligned values(1, 1, 1)` |
+| ALTER\_TIMESERIES | 修改时间序列标签。路径相关 | Eg1: `alter timeseries root.turbine.d1.s1 ADD TAGS tag3=v3, tag4=v4;`<br />Eg2: `ALTER timeseries root.turbine.d1.s1 UPSERT ALIAS=newAlias TAGS(tag2=newV2, tag3=v3) ATTRIBUTES(attr3=v3, attr4=v4);` |
+| READ\_TIMESERIES | 查询数据。路径相关 | Eg1: `SHOW DATABASES;` <br />Eg2: `show child paths root.ln, show child nodes root.ln;`<br />Eg3: `show devices;`<br />Eg4: `show timeseries root.**;`<br />Eg5: `show schema templates;`<br />Eg6: `show all ttl`<br />Eg7: [数据查询](../Query-Data/Overview.md)(这一节之下的查询语句均使用该权限)<br />Eg8: CVS格式数据导出<br />`./export-csv.bat -h 127.0.0.1 -p 6667 -u tempuser -pw root -td ./`<br />Eg9: 查询性能追踪<br />`tracing select * fr [...]
+| DELETE\_TIMESERIES | 删除数据或时间序列。路径相关 | Eg1: 删除时间序列<br />`delete timeseries root.ln.wf01.wt01.status`<br />Eg2: 删除数据<br />`delete from root.ln.wf02.wt02.status where time < 10`<br />Eg3: 使用DROP关键字<br />`drop timeseries root.ln.wf01.wt01.status` |
+| CREATE\_USER | 创建用户。路径无关 | Eg: `create user thulab 'passwd';` |
+| DELETE\_USER | 删除用户。路径无关 | Eg: `drop user xiaoming;` |
+| MODIFY\_PASSWORD | 修改所有用户的密码。路径无关。(没有该权限者仍然能够修改自己的密码。) | Eg: `alter user tempuser SET PASSWORD 'newpwd';` |
+| LIST\_USER | 列出所有用户,列出具有某角色的所有用户,列出用户在指定路径下相关权限。路径无关 | Eg1: `list user;`<br />Eg2: `list user of role 'wirte_role';`<br />Eg3: `list privileges user admin;`<br />Eg4: `list privileges user 'admin' on root.sgcc.**;` |
+| GRANT\_USER\_PRIVILEGE | 赋予用户权限。路径无关 | Eg: `grant user tempuser privileges DELETE_TIMESERIES on root.ln.**;` |
+| REVOKE\_USER\_PRIVILEGE | 撤销用户权限。路径无关 | Eg: `revoke user tempuser privileges DELETE_TIMESERIES on root.ln.**;` |
+| GRANT\_USER\_ROLE | 赋予用户角色。路径无关 | Eg: `grant temprole to tempuser;` |
+| REVOKE\_USER\_ROLE | 撤销用户角色。路径无关 | Eg: `revoke temprole from tempuser;` |
+| CREATE\_ROLE | 创建角色。路径无关 | Eg: `create role admin;` |
+| DELETE\_ROLE | 删除角色。路径无关 | Eg: `drop role admin;` |
+| LIST\_ROLE | 列出所有角色,列出某用户下所有角色,列出角色在指定路径下相关权限。路径无关 | Eg1: `list role`<br />Eg2: `list role of user 'actor';`<br />Eg3: `list privileges role wirte_role;`<br />Eg4: `list privileges role wirte_role ON root.sgcc;` |
+| GRANT\_ROLE\_PRIVILEGE | 赋予角色权限。路径无关 | Eg: `grant role temprole privileges DELETE_TIMESERIES ON root.ln.**;` |
+| REVOKE\_ROLE\_PRIVILEGE | 撤销角色权限。路径无关 | Eg: `revoke role temprole privileges DELETE_TIMESERIES ON root.ln.**;` |
+| CREATE_FUNCTION | 注册 UDF。路径无关 | Eg: `create function example AS 'org.apache.iotdb.udf.UDTFExample';` |
+| DROP_FUNCTION | 卸载 UDF。路径无关 | Eg: `drop function example` |
+| CREATE_TRIGGER | 创建触发器。路径相关 | Eg1: `CREATE TRIGGER <TRIGGER-NAME> BEFORE INSERT ON <FULL-PATH> AS <CLASSNAME>`<br />Eg2: `CREATE TRIGGER <TRIGGER-NAME> AFTER INSERT ON <FULL-PATH> AS <CLASSNAME>` |
+| DROP_TRIGGER | 卸载触发器。路径相关 | Eg: `drop trigger 'alert-listener-sg1d1s1'` |
+| CREATE_CONTINUOUS_QUERY | 创建连续查询。路径无关 | Eg: `CREATE CONTINUOUS QUERY cq1 RESAMPLE RANGE 40s BEGIN <QUERY-BODY> END` |
+| DROP_CONTINUOUS_QUERY | 卸载连续查询。路径无关 | Eg1: `DROP CONTINUOUS QUERY cq3`<br />Eg2: `DROP CQ cq3` |
+| SHOW_CONTINUOUS_QUERIES | 展示所有连续查询。路径无关 | Eg1: `SHOW CONTINUOUS QUERIES`<br />Eg2: `SHOW cqs` |
+| UPDATE_TEMPLATE | 创建、删除模板。路径无关。 | Eg1: `create schema template t1(s1 int32)`<br />Eg2: `drop schema template t1` |
+| READ_TEMPLATE | 查看所有模板、模板内容。 路径无关 | Eg1: `show schema templates`<br/>Eg2: `show nodes in template t1` |
+| APPLY_TEMPLATE | 挂载、卸载、激活、解除模板。路径有关。 | Eg1: `set schema template t1 to root.sg.d`<br/>Eg2: `unset schema template t1 from root.sg.d`<br/>Eg3: `create timeseries of schema template on root.sg.d`<br/>Eg4: `delete timeseries of schema template on root.sg.d` |
+| READ_TEMPLATE_APPLICATION | 查看模板的挂载路径和激活路径。路径无关 | Eg1: `show paths set schema template t1`<br/>Eg2: `show paths using schema template t1` |
+
+注意: 路径无关的权限只能在路径root.**下赋予或撤销;
+
+注意: 下述sql语句需要赋予多个权限才可以使用:
+
+- 导入数据,需要赋予`READ_TIMESERIES`,`INSERT_TIMESERIES`两种权限。
+
+```
+Eg: IoTDB > ./import-csv.bat -h 127.0.0.1 -p 6667 -u renyuhua -pw root -f dump0.csv
+```
+
+- 查询写回(SELECT_INTO)
+ - 需要所有 `select` 子句中源序列的 `READ_TIMESERIES` 权限
+ - 需要所有 `into` 子句中目标序列 `INSERT_TIMESERIES` 权限
+
+
+```
+Eg: IoTDB > select s1, s1 into t1, t2 from root.sg.d1 limit 5 offset 1000
+```
+
+### 用户名限制
+
+IoTDB 规定用户名的字符长度不小于 4,其中用户名不能包含空格。
+
+### 密码限制
+
+IoTDB 规定密码的字符长度不小于 4,其中密码不能包含空格,密码默认采用 MD5 进行加密。
+
+### 角色名限制
+
+IoTDB 规定角色名的字符长度不小于 4,其中角色名不能包含空格。
+
+### 权限管理中的路径模式
+
+一个路径模式的结果集包含了它的子模式的结果集的所有元素。例如,`root.sg.d.*`是`root.sg.*.*`的子模式,而`root.sg.**`不是`root.sg.*.*`的子模式。当用户被授予对某个路径模式的权限时,在他的DDL或DML中使用的模式必须是该路径模式的子模式,这保证了用户访问时间序列时不会超出他的权限范围。
+
+### 权限缓存
+
+在分布式相关的权限操作中,在进行除了创建用户和角色之外的其他权限更改操作时,都会先清除与该用户(角色)相关的所有的`dataNode`的缓存信息,如果任何一台`dataNode`缓存信息清楚失败,这个权限更改的任务就会失败。
+
+### 非root用户限制进行的操作
+
+目前以下IoTDB支持的sql语句只有`root`用户可以进行操作,且没有对应的权限可以赋予新用户。
+
+###### TsFile管理
+
+- 加载TsFile
+
+```
+Eg: IoTDB > load '/Users/Desktop/data/1575028885956-101-0.tsfile'
+```
+
+- 删除TsFile文件
+
+```
+Eg: IoTDB > remove '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile'
+```
+
+- 卸载TsFile文件到指定目录
+
+```
+Eg: IoTDB > unload '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile' '/data/data/tmp'
+```
+
+###### 删除时间分区(实验性功能)
+
+- 删除时间分区(实验性功能)
+
+```
+Eg: IoTDB > DELETE PARTITION root.ln 0,1,2
+```
+
+###### 连续查询
+
+- 连续查询(CQ)
+
+```
+Eg: IoTDB > CREATE CONTINUOUS QUERY cq1 BEGIN SELECT max_value(temperature) INTO temperature_max FROM root.ln.*.* GROUP BY time(10s) END
+```
+
+###### 运维命令
+
+- FLUSH
+
+```
+Eg: IoTDB > flush
+```
+
+- MERGE
+
+```
+Eg: IoTDB > MERGE
+Eg: IoTDB > FULL MERGE
+```
+
+- CLEAR CACHE
+
+```sql
+Eg: IoTDB > CLEAR CACHE
+```
+
+- SET STSTEM TO READONLY / WRITABLE
+
+```
+Eg: IoTDB > SET STSTEM TO READONLY / WRITABLE
+```
+
+- SCHEMA SNAPSHOT
+
+```sql
+Eg: IoTDB > CREATE SNAPSHOT FOR SCHEMA
+```
+
+- 查询终止
+
+```
+Eg: IoTDB > KILL QUERY 1
+```
+
+###### 水印工具
+
+- 为新用户施加水印
+
+```
+Eg: IoTDB > grant watermark_embedding to Alice
+```
+
+- 撤销水印
+
+```
+Eg: IoTDB > revoke watermark_embedding from Alice
+```
\ No newline at end of file
diff --git a/docs/zh/UserGuide/User-Manuel/Database-Programming.md b/docs/zh/UserGuide/User-Manuel/Database-Programming.md
new file mode 100644
index 00000000000..6fddb26ecf7
--- /dev/null
+++ b/docs/zh/UserGuide/User-Manuel/Database-Programming.md
@@ -0,0 +1,6079 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+
+## 触发器
+### 使用说明
+
+触发器提供了一种侦听序列数据变动的机制。配合用户自定义逻辑,可完成告警、数据转发等功能。
+
+触发器基于 Java 反射机制实现。用户通过简单实现 Java 接口,即可实现数据侦听。IoTDB 允许用户动态注册、卸载触发器,在注册、卸载期间,无需启停服务器。
+
+#### 侦听模式
+
+IoTDB 的单个触发器可用于侦听符合特定模式的时间序列的数据变动,如时间序列 root.sg.a 上的数据变动,或者符合路径模式 root.**.a 的时间序列上的数据变动。您在注册触发器时可以通过 SQL 语句指定触发器侦听的路径模式。
+
+#### 触发器类型
+
+目前触发器分为两类,您在注册触发器时可以通过 SQL 语句指定类型:
+
+- 有状态的触发器。该类触发器的执行逻辑可能依赖前后的多条数据,框架会将不同节点写入的数据汇总到同一个触发器实例进行计算,来保留上下文信息,通常用于采样或者统计一段时间的数据聚合信息。集群中只有一个节点持有有状态触发器的实例。
+- 无状态的触发器。触发器的执行逻辑只和当前输入的数据有关,框架无需将不同节点的数据汇总到同一个触发器实例中,通常用于单行数据的计算和异常检测等。集群中每个节点均持有无状态触发器的实例。
+
+#### 触发时机
+
+触发器的触发时机目前有两种,后续会拓展其它触发时机。您在注册触发器时可以通过 SQL 语句指定触发时机:
+
+- BEFORE INSERT,即在数据持久化之前触发。请注意,目前触发器并不支持数据清洗,不会对要持久化的数据本身进行变动。
+- AFTER INSERT,即在数据持久化之后触发。
+
+### 编写触发器
+
+#### 触发器依赖
+
+触发器的逻辑需要您编写 Java 类进行实现。
+在编写触发器逻辑时,需要使用到下面展示的依赖。如果您使用 [Maven](http://search.maven.org/),则可以直接从 [Maven 库](http://search.maven.org/)中搜索到它们。请注意选择和目标服务器版本相同的依赖版本。
+
+``` xml
+<dependency>
+ <groupId>org.apache.iotdb</groupId>
+ <artifactId>iotdb-server</artifactId>
+ <version>1.0.0</version>
+ <scope>provided</scope>
+</dependency>
+```
+
+#### 接口说明
+
+编写一个触发器需要实现 `org.apache.iotdb.trigger.api.Trigger` 类。
+
+```java
+import org.apache.iotdb.trigger.api.enums.FailureStrategy;
+import org.apache.iotdb.tsfile.write.record.Tablet;
+
+public interface Trigger {
+
+ /**
+ * This method is mainly used to validate {@link TriggerAttributes} before calling {@link
+ * Trigger#onCreate(TriggerAttributes)}.
+ *
+ * @param attributes TriggerAttributes
+ * @throws Exception e
+ */
+ default void validate(TriggerAttributes attributes) throws Exception {}
+
+ /**
+ * This method will be called when creating a trigger after validation.
+ *
+ * @param attributes TriggerAttributes
+ * @throws Exception e
+ */
+ default void onCreate(TriggerAttributes attributes) throws Exception {}
+
+ /**
+ * This method will be called when dropping a trigger.
+ *
+ * @throws Exception e
+ */
+ default void onDrop() throws Exception {}
+
+ /**
+ * When restarting a DataNode, Triggers that have been registered will be restored and this method
+ * will be called during the process of restoring.
+ *
+ * @throws Exception e
+ */
+ default void restore() throws Exception {}
+
+ /**
+ * Overrides this method to set the expected FailureStrategy, {@link FailureStrategy#OPTIMISTIC}
+ * is the default strategy.
+ *
+ * @return {@link FailureStrategy}
+ */
+ default FailureStrategy getFailureStrategy() {
+ return FailureStrategy.OPTIMISTIC;
+ }
+
+ /**
+ * @param tablet see {@link Tablet} for detailed information of data structure. Data that is
+ * inserted will be constructed as a Tablet and you can define process logic with {@link
+ * Tablet}.
+ * @return true if successfully fired
+ * @throws Exception e
+ */
+ default boolean fire(Tablet tablet) throws Exception {
+ return true;
+ }
+}
+```
+
+该类主要提供了两类编程接口:**生命周期相关接口**和**数据变动侦听相关接口**。该类中所有的接口都不是必须实现的,当您不实现它们时,它们不会对流经的数据操作产生任何响应。您可以根据实际需要,只实现其中若干接口。
+
+下面是所有可供用户进行实现的接口的说明。
+
+##### 生命周期相关接口
+
+| 接口定义 | 描述 |
+| ------------------------------------------------------------ | ------------------------------------------------------------ |
+| *default void validate(TriggerAttributes attributes) throws Exception {}* | 用户在使用 `CREATE TRIGGER` 语句创建触发器时,可以指定触发器需要使用的参数,该接口会用于验证参数正确性。 |
+| *default void onCreate(TriggerAttributes attributes) throws Exception {}* | 当您使用`CREATE TRIGGER`语句创建触发器后,该接口会被调用一次。在每一个触发器实例的生命周期内,该接口会且仅会被调用一次。该接口主要有如下作用:帮助用户解析 SQL 语句中的自定义属性(使用`TriggerAttributes`)。 可以创建或申请资源,如建立外部链接、打开文件等。 |
+| *default void onDrop() throws Exception {}* | 当您使用`DROP TRIGGER`语句删除触发器后,该接口会被调用。在每一个触发器实例的生命周期内,该接口会且仅会被调用一次。该接口主要有如下作用:可以进行资源释放的操作。可以用于持久化触发器计算的结果。 |
+| *default void restore() throws Exception {}* | 当重启 DataNode 时,集群会恢复 DataNode 上已经注册的触发器实例,在此过程中会为该 DataNode 上的有状态触发器调用一次该接口。有状态触发器实例所在的 DataNode 宕机后,集群会在另一个可用 DataNode 上恢复该触发器的实例,在此过程中会调用一次该接口。该接口可以用于自定义恢复逻辑。 |
+
+##### 数据变动侦听相关接口
+
+###### 侦听接口
+
+```java
+ /**
+ * @param tablet see {@link Tablet} for detailed information of data structure. Data that is
+ * inserted will be constructed as a Tablet and you can define process logic with {@link
+ * Tablet}.
+ * @return true if successfully fired
+ * @throws Exception e
+ */
+ default boolean fire(Tablet tablet) throws Exception {
+ return true;
+ }
+```
+
+数据变动时,触发器以 Tablet 作为触发操作的单位。您可以通过 Tablet 获取相应序列的元数据和数据,然后进行相应的触发操作,触发成功则返回值应当为 true。该接口返回 false 或是抛出异常我们均认为触发失败。在触发失败时,我们会根据侦听策略接口进行相应的操作。
+
+进行一次 INSERT 操作时,对于其中的每条时间序列,我们会检测是否有侦听该路径模式的触发器,然后将符合同一个触发器所侦听的路径模式的时间序列数据组装成一个新的 Tablet 用于触发器的 fire 接口。可以理解成:
+
+```java
+Map<PartialPath, List<Trigger>> pathToTriggerListMap => Map<Trigger, Tablet>
+```
+
+**请注意,目前我们不对触发器的触发顺序有任何保证。**
+
+下面是示例:
+
+假设有三个触发器,触发器的触发时机均为 BEFORE INSERT
+
+- 触发器 Trigger1 侦听路径模式:root.sg.*
+- 触发器 Trigger2 侦听路径模式:root.sg.a
+- 触发器 Trigger3 侦听路径模式:root.sg.b
+
+写入语句:
+
+```sql
+insert into root.sg(time, a, b) values (1, 1, 1);
+```
+
+序列 root.sg.a 匹配 Trigger1 和 Trigger2,序列 root.sg.b 匹配 Trigger1 和 Trigger3,那么:
+
+- root.sg.a 和 root.sg.b 的数据会被组装成一个新的 tablet1,在相应的触发时机进行 Trigger1.fire(tablet1)
+- root.sg.a 的数据会被组装成一个新的 tablet2,在相应的触发时机进行 Trigger2.fire(tablet2)
+- root.sg.b 的数据会被组装成一个新的 tablet3,在相应的触发时机进行 Trigger3.fire(tablet3)
+
+###### 侦听策略接口
+
+在触发器触发失败时,我们会根据侦听策略接口设置的策略进行相应的操作,您可以通过下述接口设置 `org.apache.iotdb.trigger.api.enums.FailureStrategy`,目前有乐观和悲观两种策略:
+
+- 乐观策略:触发失败的触发器不影响后续触发器的触发,也不影响写入流程,即我们不对触发失败涉及的序列做额外处理,仅打日志记录失败,最后返回用户写入数据成功,但触发部分失败。
+- 悲观策略:失败触发器影响后续所有 Pipeline 的处理,即我们认为该 Trigger 触发失败会导致后续所有触发流程不再进行。如果该触发器的触发时机为 BEFORE INSERT,那么写入也不再进行,直接返回写入失败。
+
+```java
+ /**
+ * Overrides this method to set the expected FailureStrategy, {@link FailureStrategy#OPTIMISTIC}
+ * is the default strategy.
+ *
+ * @return {@link FailureStrategy}
+ */
+ default FailureStrategy getFailureStrategy() {
+ return FailureStrategy.OPTIMISTIC;
+ }
+```
+
+您可以参考下图辅助理解,其中 Trigger1 配置采用乐观策略,Trigger2 配置采用悲观策略。Trigger1 和 Trigger2 的触发时机是 BEFORE INSERT,Trigger3 和 Trigger4 的触发时机是 AFTER INSERT。 正常执行流程如下:
+
+<img src="https://alioss.timecho.com/docs/img/UserGuide/Process-Data/Triggers/Trigger_Process_Flow.jpg?raw=true">
+
+<img src="https://alioss.timecho.com/docs/img/UserGuide/Process-Data/Triggers/Trigger_Process_Strategy.jpg?raw=true">
+
+
+#### 示例
+
+如果您使用 [Maven](http://search.maven.org/),可以参考我们编写的示例项目 trigger-example。您可以在 [这里](https://github.com/apache/iotdb/tree/master/example/trigger) 找到它。后续我们会加入更多的示例项目供您参考。
+
+下面是其中一个示例项目的代码:
+
+```java
+/*
+ * Licensed to the Apache Software Foundation (ASF) under one
+ * or more contributor license agreements. See the NOTICE file
+ * distributed with this work for additional information
+ * regarding copyright ownership. The ASF licenses this file
+ * to you under the Apache License, Version 2.0 (the
+ * "License"); you may not use this file except in compliance
+ * with the License. You may obtain a copy of the License at
+ *
+ * http://www.apache.org/licenses/LICENSE-2.0
+ *
+ * Unless required by applicable law or agreed to in writing,
+ * software distributed under the License is distributed on an
+ * "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ * KIND, either express or implied. See the License for the
+ * specific language governing permissions and limitations
+ * under the License.
+ */
+
+package org.apache.iotdb.trigger;
+
+import org.apache.iotdb.db.engine.trigger.sink.alertmanager.AlertManagerConfiguration;
+import org.apache.iotdb.db.engine.trigger.sink.alertmanager.AlertManagerEvent;
+import org.apache.iotdb.db.engine.trigger.sink.alertmanager.AlertManagerHandler;
+import org.apache.iotdb.trigger.api.Trigger;
+import org.apache.iotdb.trigger.api.TriggerAttributes;
+import org.apache.iotdb.tsfile.file.metadata.enums.TSDataType;
+import org.apache.iotdb.tsfile.write.record.Tablet;
+import org.apache.iotdb.tsfile.write.schema.MeasurementSchema;
+
+import org.slf4j.Logger;
+import org.slf4j.LoggerFactory;
+
+import java.io.IOException;
+import java.util.HashMap;
+import java.util.List;
+
+public class ClusterAlertingExample implements Trigger {
+ private static final Logger LOGGER = LoggerFactory.getLogger(ClusterAlertingExample.class);
+
+ private final AlertManagerHandler alertManagerHandler = new AlertManagerHandler();
+
+ private final AlertManagerConfiguration alertManagerConfiguration =
+ new AlertManagerConfiguration("http://127.0.0.1:9093/api/v2/alerts");
+
+ private String alertname;
+
+ private final HashMap<String, String> labels = new HashMap<>();
+
+ private final HashMap<String, String> annotations = new HashMap<>();
+
+ @Override
+ public void onCreate(TriggerAttributes attributes) throws Exception {
+ alertname = "alert_test";
+
+ labels.put("series", "root.ln.wf01.wt01.temperature");
+ labels.put("value", "");
+ labels.put("severity", "");
+
+ annotations.put("summary", "high temperature");
+ annotations.put("description", "{{.alertname}}: {{.series}} is {{.value}}");
+
+ alertManagerHandler.open(alertManagerConfiguration);
+ }
+
+ @Override
+ public void onDrop() throws IOException {
+ alertManagerHandler.close();
+ }
+
+ @Override
+ public boolean fire(Tablet tablet) throws Exception {
+ List<MeasurementSchema> measurementSchemaList = tablet.getSchemas();
+ for (int i = 0, n = measurementSchemaList.size(); i < n; i++) {
+ if (measurementSchemaList.get(i).getType().equals(TSDataType.DOUBLE)) {
+ // for example, we only deal with the columns of Double type
+ double[] values = (double[]) tablet.values[i];
+ for (double value : values) {
+ if (value > 100.0) {
+ LOGGER.info("trigger value > 100");
+ labels.put("value", String.valueOf(value));
+ labels.put("severity", "critical");
+ AlertManagerEvent alertManagerEvent =
+ new AlertManagerEvent(alertname, labels, annotations);
+ alertManagerHandler.onEvent(alertManagerEvent);
+ } else if (value > 50.0) {
+ LOGGER.info("trigger value > 50");
+ labels.put("value", String.valueOf(value));
+ labels.put("severity", "warning");
+ AlertManagerEvent alertManagerEvent =
+ new AlertManagerEvent(alertname, labels, annotations);
+ alertManagerHandler.onEvent(alertManagerEvent);
+ }
+ }
+ }
+ }
+ return true;
+ }
+}
+```
+### 管理触发器
+
+您可以通过 SQL 语句注册和卸载一个触发器实例,您也可以通过 SQL 语句查询到所有已经注册的触发器。
+
+**我们建议您在注册触发器时停止写入。**
+
+#### 注册触发器
+
+触发器可以注册在任意路径模式上。被注册有触发器的序列将会被触发器侦听,当序列上有数据变动时,触发器中对应的触发方法将会被调用。
+
+注册一个触发器可以按如下流程进行:
+
+1. 按照编写触发器章节的说明,实现一个完整的 Trigger 类,假定这个类的全类名为 `org.apache.iotdb.trigger.ClusterAlertingExample`
+2. 将项目打成 JAR 包。
+3. 使用 SQL 语句注册该触发器。注册过程中会仅只会调用一次触发器的 `validate` 和 `onCreate` 接口,具体请参考编写触发器章节。
+
+完整 SQL 语法如下:
+
+```sql
+// Create Trigger
+createTrigger
+ : CREATE triggerType TRIGGER triggerName=identifier triggerEventClause ON pathPattern AS className=STRING_LITERAL uriClause? triggerAttributeClause?
+ ;
+
+triggerType
+ : STATELESS | STATEFUL
+ ;
+
+triggerEventClause
+ : (BEFORE | AFTER) INSERT
+ ;
+
+uriClause
+ : USING URI uri
+ ;
+
+uri
+ : STRING_LITERAL
+ ;
+
+triggerAttributeClause
+ : WITH LR_BRACKET triggerAttribute (COMMA triggerAttribute)* RR_BRACKET
+ ;
+
+triggerAttribute
+ : key=attributeKey operator_eq value=attributeValue
+ ;
+```
+
+下面对 SQL 语法进行说明,您可以结合使用说明章节进行理解:
+
+- triggerName:触发器 ID,该 ID 是全局唯一的,用于区分不同触发器,大小写敏感。
+- triggerType:触发器类型,分为无状态(STATELESS)和有状态(STATEFUL)两类。
+- triggerEventClause:触发时机,目前仅支持写入前(BEFORE INSERT)和写入后(AFTER INSERT)两种。
+- pathPattern:触发器侦听的路径模式,可以包含通配符 * 和 **。
+- className:触发器实现类的类名。
+- uriClause:可选项,当不指定该选项时,我们默认 DBA 已经在各个 DataNode 节点的 trigger_root_dir 目录(配置项,默认为 IOTDB_HOME/ext/trigger)下放置好创建该触发器需要的 JAR 包。当指定该选项时,我们会将该 URI 对应的文件资源下载并分发到各 DataNode 的 trigger_root_dir/install 目录下。
+- triggerAttributeClause:用于指定触发器实例创建时需要设置的参数,SQL 语法中该部分是可选项。
+
+下面是一个帮助您理解的 SQL 语句示例:
+
+```sql
+CREATE STATELESS TRIGGER triggerTest
+BEFORE INSERT
+ON root.sg.**
+AS 'org.apache.iotdb.trigger.ClusterAlertingExample'
+USING URI 'http://jar/ClusterAlertingExample.jar'
+WITH (
+ "name" = "trigger",
+ "limit" = "100"
+)
+```
+
+上述 SQL 语句创建了一个名为 triggerTest 的触发器:
+
+- 该触发器是无状态的(STATELESS)
+- 在写入前触发(BEFORE INSERT)
+- 该触发器侦听路径模式为 root.sg.**
+- 所编写的触发器类名为 org.apache.iotdb.trigger.ClusterAlertingExample
+- JAR 包的 URI 为 http://jar/ClusterAlertingExample.jar
+- 创建该触发器实例时会传入 name 和 limit 两个参数。
+
+#### 卸载触发器
+
+可以通过指定触发器 ID 的方式卸载触发器,卸载触发器的过程中会且仅会调用一次触发器的 `onDrop` 接口。
+
+卸载触发器的 SQL 语法如下:
+
+```sql
+// Drop Trigger
+dropTrigger
+ : DROP TRIGGER triggerName=identifier
+;
+```
+
+下面是示例语句:
+
+```sql
+DROP TRIGGER triggerTest1
+```
+
+上述语句将会卸载 ID 为 triggerTest1 的触发器。
+
+#### 查询触发器
+
+可以通过 SQL 语句查询集群中存在的触发器的信息。SQL 语法如下:
+
+```sql
+SHOW TRIGGERS
+```
+
+该语句的结果集格式如下:
+
+| TriggerName | Event | Type | State | PathPattern | ClassName | NodeId |
+| ------------ | ---------------------------- | -------------------- | ------------------------------------------- | ----------- | --------------------------------------- | --------------------------------------- |
+| triggerTest1 | BEFORE_INSERT / AFTER_INSERT | STATELESS / STATEFUL | INACTIVE / ACTIVE / DROPPING / TRANSFFERING | root.** | org.apache.iotdb.trigger.TriggerExample | ALL(STATELESS) / DATA_NODE_ID(STATEFUL) |
+
+
+#### 触发器状态说明
+
+在集群中注册以及卸载触发器的过程中,我们维护了触发器的状态,下面是对这些状态的说明:
+
+| 状态 | 描述 | 是否建议写入进行 |
+| ------------ | ------------------------------------------------------------ | ---------------- |
+| INACTIVE | 执行 `CREATE TRIGGER` 的中间状态,集群刚在 ConfigNode 上记录该触发器的信息,还未在任何 DataNode 上激活该触发器 | 否 |
+| ACTIVE | 执行 `CREATE TRIGGE` 成功后的状态,集群所有 DataNode 上的该触发器都已经可用 | 是 |
+| DROPPING | 执行 `DROP TRIGGER` 的中间状态,集群正处在卸载该触发器的过程中 | 否 |
+| TRANSFERRING | 集群正在进行该触发器实例位置的迁移 | 否 |
+
+### 重要注意事项
+
+- 触发器从注册时开始生效,不对已有的历史数据进行处理。**即只有成功注册触发器之后发生的写入请求才会被触发器侦听到。**
+- 触发器目前采用**同步触发**,所以编写时需要保证触发器效率,否则可能会大幅影响写入性能。**您需要自己保证触发器内部的并发安全性**。
+- 集群中**不能注册过多触发器**。因为触发器信息全量保存在 ConfigNode 中,并且在所有 DataNode 都有一份该信息的副本。
+- **建议注册触发器时停止写入**。注册触发器并不是一个原子操作,注册触发器时,会出现集群内部分节点已经注册了该触发器,部分节点尚未注册成功的中间状态。为了避免部分节点上的写入请求被触发器侦听到,部分节点上没有被侦听到的情况,我们建议注册触发器时不要执行写入。
+- 触发器将作为进程内程序执行,如果您的触发器编写不慎,内存占用过多,由于 IoTDB 并没有办法监控触发器所使用的内存,所以有 OOM 的风险。
+- 持有有状态触发器实例的节点宕机时,我们会尝试在另外的节点上恢复相应实例,在恢复过程中我们会调用一次触发器类的 restore 接口,您可以在该接口中实现恢复触发器所维护的状态的逻辑。
+- 触发器 JAR 包有大小限制,必须小于 min(`config_node_ratis_log_appender_buffer_size_max`, 2G),其中 `config_node_ratis_log_appender_buffer_size_max` 是一个配置项,具体含义可以参考 IOTDB 配置项说明。
+- **不同的 JAR 包中最好不要有全类名相同但功能实现不一样的类**。例如:触发器 trigger1、trigger2 分别对应资源 trigger1.jar、trigger2.jar。如果两个 JAR 包里都包含一个 `org.apache.iotdb.trigger.example.AlertListener` 类,当 `CREATE TRIGGER` 使用到这个类时,系统会随机加载其中一个 JAR 包中的类,最终导致触发器执行行为不一致以及其他的问题。
+
+### 配置参数
+
+| 配置项 | 含义 |
+| ------------------------------------------------- | ---------------------------------------------- |
+| *trigger_lib_dir* | 保存触发器 jar 包的目录位置 |
+| *stateful\_trigger\_retry\_num\_when\_not\_found* | 有状态触发器触发无法找到触发器实例时的重试次数 |
+
+## 连续查询(Continuous Query, CQ)
+
+### 简介
+连续查询(Continuous queries, aka CQ) 是对实时数据周期性地自动执行的查询,并将查询结果写入指定的时间序列中。
+
+### 语法
+
+```sql
+CREATE (CONTINUOUS QUERY | CQ) <cq_id>
+[RESAMPLE
+ [EVERY <every_interval>]
+ [BOUNDARY <execution_boundary_time>]
+ [RANGE <start_time_offset>[, end_time_offset]]
+]
+[TIMEOUT POLICY BLOCKED|DISCARD]
+BEGIN
+ SELECT CLAUSE
+ INTO CLAUSE
+ FROM CLAUSE
+ [WHERE CLAUSE]
+ [GROUP BY(<group_by_interval>[, <sliding_step>]) [, level = <level>]]
+ [HAVING CLAUSE]
+ [FILL {PREVIOUS | LINEAR | constant}]
+ [LIMIT rowLimit OFFSET rowOffset]
+ [ALIGN BY DEVICE]
+END
+```
+
+> 注意:
+> 1. 如果where子句中出现任何时间过滤条件,IoTDB将会抛出异常,因为IoTDB会自动为每次查询执行指定时间范围。
+> 2. GROUP BY TIME CLAUSE在连续查询中的语法稍有不同,它不能包含原来的第一个参数,即 [start_time, end_time),IoTDB会自动填充这个缺失的参数。如果指定,IoTDB将会抛出异常。
+> 3. 如果连续查询中既没有GROUP BY TIME子句,也没有指定EVERY子句,IoTDB将会抛出异常。
+
+#### 连续查询语法中参数含义的描述
+
+- `<cq_id>` 为连续查询指定一个全局唯一的标识。
+- `<every_interval>` 指定了连续查询周期性执行的间隔。现在支持的时间单位有:ns, us, ms, s, m, h, d, w, 并且它的值不能小于用户在`iotdb-confignode.properties`配置文件中指定的`continuous_query_min_every_interval`。这是一个可选参数,默认等于group by子句中的`group_by_interval`。
+- `<start_time_offset>` 指定了每次查询执行窗口的开始时间,即`now()-<start_time_offset>`。现在支持的时间单位有:ns, us, ms, s, m, h, d, w。这是一个可选参数,默认等于`EVERY`子句中的`every_interval`。
+- `<end_time_offset>` 指定了每次查询执行窗口的结束时间,即`now()-<end_time_offset>`。现在支持的时间单位有:ns, us, ms, s, m, h, d, w。这是一个可选参数,默认等于`0`.
+- `<execution_boundary_time>` 表示用户期待的连续查询的首个周期任务的执行时间。(因为连续查询只会对当前实时的数据流做计算,所以该连续查询实际首个周期任务的执行时间并不一定等于用户指定的时间,具体计算逻辑如下所示)
+ - `<execution_boundary_time>` 可以早于、等于或者迟于当前时间。
+ - 这个参数是可选的,默认等于`0`。
+ - 首次查询执行窗口的开始时间为`<execution_boundary_time> - <start_time_offset>`.
+ - 首次查询执行窗口的结束时间为`<execution_boundary_time> - <end_time_offset>`.
+ - 第i个查询执行窗口的时间范围是`[<execution_boundary_time> - <start_time_offset> + (i - 1) * <every_interval>, <execution_boundary_time> - <end_time_offset> + (i - 1) * <every_interval>)`。
+ - 如果当前时间早于或等于, 那连续查询的首个周期任务的执行时间就是用户指定的`execution_boundary_time`.
+ - 如果当前时间迟于用户指定的`execution_boundary_time`,那么连续查询的首个周期任务的执行时间就是`execution_boundary_time + i * <every_interval>`中第一个大于或等于当前时间的值。
+
+> - <every_interval>,<start_time_offset> 和 <group_by_interval> 都应该大于 0
+> - <group_by_interval>应该小于等于<start_time_offset>
+> - 用户应该根据实际需求,为<start_time_offset> 和 <every_interval> 指定合适的值
+> - 如果<start_time_offset>大于<every_interval>,在每一次查询执行的时间窗口上会有部分重叠
+> - 如果<start_time_offset>小于<every_interval>,在连续的两次查询执行的时间窗口中间将会有未覆盖的时间范围
+> - start_time_offset 应该大于end_time_offset
+
+##### `<start_time_offset>`等于`<every_interval>`
+
+
+
+##### `<start_time_offset>`大于`<every_interval>`
+
+
+
+##### `<start_time_offset>`小于`<every_interval>`
+
+
+
+##### `<every_interval>`不为0
+
+
+
+- `TIMEOUT POLICY` 指定了我们如何处理“前一个时间窗口还未执行完时,下一个窗口的执行时间已经到达的场景,默认值是`BLOCKED`.
+ - `BLOCKED`意味着即使下一个窗口的执行时间已经到达,我们依旧需要阻塞等待前一个时间窗口的查询执行完再开始执行下一个窗口。如果使用`BLOCKED`策略,所有的时间窗口都将会被依此执行,但是如果遇到执行查询的时间长于周期性间隔时,连续查询的结果会迟于最新的时间窗口范围。
+ - `DISCARD`意味着如果前一个时间窗口还未执行完,我们会直接丢弃下一个窗口的执行时间。如果使用`DISCARD`策略,可能会有部分时间窗口得不到执行。但是一旦前一个查询执行完后,它将会使用最新的时间窗口,所以它的执行结果总能赶上最新的时间窗口范围,当然是以部分时间窗口得不到执行为代价。
+
+
+### 连续查询的用例
+
+下面是用例数据,这是一个实时的数据流,我们假设数据都按时到达。
+
+````
++-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+| Time|root.ln.wf02.wt02.temperature|root.ln.wf02.wt01.temperature|root.ln.wf01.wt02.temperature|root.ln.wf01.wt01.temperature|
++-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+|2021-05-11T22:18:14.598+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:19.941+08:00| 0.0| 68.0| 68.0| 103.0|
+|2021-05-11T22:18:24.949+08:00| 122.0| 45.0| 11.0| 14.0|
+|2021-05-11T22:18:29.967+08:00| 47.0| 14.0| 59.0| 181.0|
+|2021-05-11T22:18:34.979+08:00| 182.0| 113.0| 29.0| 180.0|
+|2021-05-11T22:18:39.990+08:00| 42.0| 11.0| 52.0| 19.0|
+|2021-05-11T22:18:44.995+08:00| 78.0| 38.0| 123.0| 52.0|
+|2021-05-11T22:18:49.999+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:55.003+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+````
+
+#### 配置连续查询执行的周期性间隔
+
+在`RESAMPLE`子句中使用`EVERY`参数指定连续查询的执行间隔,如果没有指定,默认等于`group_by_interval`。
+
+```sql
+CREATE CONTINUOUS QUERY cq1
+RESAMPLE EVERY 20s
+BEGIN
+ SELECT max_value(temperature)
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+ FROM root.ln.*.*
+ GROUP BY(10s)
+END
+```
+
+`cq1`计算出`temperature`传感器每10秒的平均值,并且将查询结果存储在`temperature_max`传感器下,传感器路径前缀使用跟原来一样的前缀。
+
+`cq1`每20秒执行一次,每次执行的查询的时间窗口范围是从过去20秒到当前时间。
+
+假设当前时间是`2021-05-11T22:18:40.000+08:00`,如果把日志等级设置为DEBUG,我们可以在`cq1`执行的DataNode上看到如下的输出:
+
+````
+At **2021-05-11T22:18:40.000+08:00**, `cq1` executes a query within the time range `[2021-05-11T22:18:20, 2021-05-11T22:18:40)`.
+`cq1` generate 2 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+At **2021-05-11T22:19:00.000+08:00**, `cq1` executes a query within the time range `[2021-05-11T22:18:40, 2021-05-11T22:19:00)`.
+`cq1` generate 2 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+````
+
+`cq1`并不会处理当前时间窗口以外的数据,即`2021-05-11T22:18:20.000+08:00`以前的数据,所以我们会得到如下结果:
+
+````
+> SELECT temperature_max from root.ln.*.*;
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+````
+
+#### 配置连续查询的时间窗口大小
+
+使用`RANGE`子句中的`start_time_offset`参数指定连续查询每次执行的时间窗口的开始时间偏移,如果没有指定,默认值等于`EVERY`参数。
+
+```sql
+CREATE CONTINUOUS QUERY cq2
+RESAMPLE RANGE 40s
+BEGIN
+ SELECT max_value(temperature)
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+ FROM root.ln.*.*
+ GROUP BY(10s)
+END
+```
+
+`cq2`计算出`temperature`传感器每10秒的平均值,并且将查询结果存储在`temperature_max`传感器下,传感器路径前缀使用跟原来一样的前缀。
+
+`cq2`每10秒执行一次,每次执行的查询的时间窗口范围是从过去40秒到当前时间。
+
+假设当前时间是`2021-05-11T22:18:40.000+08:00`,如果把日志等级设置为DEBUG,我们可以在`cq2`执行的DataNode上看到如下的输出:
+
+````
+At **2021-05-11T22:18:40.000+08:00**, `cq2` executes a query within the time range `[2021-05-11T22:18:00, 2021-05-11T22:18:40)`.
+`cq2` generate 4 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:00.000+08:00| NULL| NULL| NULL| NULL|
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+At **2021-05-11T22:18:50.000+08:00**, `cq2` executes a query within the time range `[2021-05-11T22:18:10, 2021-05-11T22:18:50)`.
+`cq2` generate 4 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+At **2021-05-11T22:19:00.000+08:00**, `cq2` executes a query within the time range `[2021-05-11T22:18:20, 2021-05-11T22:19:00)`.
+`cq2` generate 4 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+````
+
+`cq2`并不会写入全是null值的行,值得注意的是`cq2`会多次计算某些区间的聚合值,下面是计算结果:
+
+````
+> SELECT temperature_max from root.ln.*.*;
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+````
+
+#### 同时配置连续查询执行的周期性间隔和时间窗口大小
+
+使用`RESAMPLE`子句中的`EVERY`参数和`RANGE`参数分别指定连续查询的执行间隔和窗口大小。并且使用`fill()`来填充没有值的时间区间。
+
+```sql
+CREATE CONTINUOUS QUERY cq3
+RESAMPLE EVERY 20s RANGE 40s
+BEGIN
+ SELECT max_value(temperature)
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+ FROM root.ln.*.*
+ GROUP BY(10s)
+ FILL(100.0)
+END
+```
+
+`cq3`计算出`temperature`传感器每10秒的平均值,并且将查询结果存储在`temperature_max`传感器下,传感器路径前缀使用跟原来一样的前缀。如果某些区间没有值,用`100.0`填充。
+
+`cq3`每20秒执行一次,每次执行的查询的时间窗口范围是从过去40秒到当前时间。
+
+假设当前时间是`2021-05-11T22:18:40.000+08:00`,如果把日志等级设置为DEBUG,我们可以在`cq3`执行的DataNode上看到如下的输出:
+
+````
+At **2021-05-11T22:18:40.000+08:00**, `cq3` executes a query within the time range `[2021-05-11T22:18:00, 2021-05-11T22:18:40)`.
+`cq3` generate 4 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:00.000+08:00| 100.0| 100.0| 100.0| 100.0|
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+At **2021-05-11T22:19:00.000+08:00**, `cq3` executes a query within the time range `[2021-05-11T22:18:20, 2021-05-11T22:19:00)`.
+`cq3` generate 4 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+````
+
+值得注意的是`cq3`会多次计算某些区间的聚合值,下面是计算结果:
+
+````
+> SELECT temperature_max from root.ln.*.*;
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:00.000+08:00| 100.0| 100.0| 100.0| 100.0|
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
+|2021-05-11T22:18:40.000+08:00| 137.0| 172.0| 135.0| 193.0|
+|2021-05-11T22:18:50.000+08:00| 16.0| 124.0| 183.0| 18.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+````
+
+#### 配置连续查询每次查询执行时间窗口的结束时间
+
+使用`RESAMPLE`子句中的`EVERY`参数和`RANGE`参数分别指定连续查询的执行间隔和窗口大小。并且使用`fill()`来填充没有值的时间区间。
+
+```sql
+CREATE CONTINUOUS QUERY cq4
+RESAMPLE EVERY 20s RANGE 40s, 20s
+BEGIN
+ SELECT max_value(temperature)
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+ FROM root.ln.*.*
+ GROUP BY(10s)
+ FILL(100.0)
+END
+```
+
+`cq4`计算出`temperature`传感器每10秒的平均值,并且将查询结果存储在`temperature_max`传感器下,传感器路径前缀使用跟原来一样的前缀。如果某些区间没有值,用`100.0`填充。
+
+`cq4`每20秒执行一次,每次执行的查询的时间窗口范围是从过去40秒到过去20秒。
+
+假设当前时间是`2021-05-11T22:18:40.000+08:00`,如果把日志等级设置为DEBUG,我们可以在`cq4`执行的DataNode上看到如下的输出:
+
+````
+At **2021-05-11T22:18:40.000+08:00**, `cq4` executes a query within the time range `[2021-05-11T22:18:00, 2021-05-11T22:18:20)`.
+`cq4` generate 2 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:00.000+08:00| 100.0| 100.0| 100.0| 100.0|
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+At **2021-05-11T22:19:00.000+08:00**, `cq4` executes a query within the time range `[2021-05-11T22:18:20, 2021-05-11T22:18:40)`.
+`cq4` generate 2 lines:
+>
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+>
+````
+
+值得注意的是`cq4`只会计算每个聚合区间一次,并且每次开始执行计算的时间都会比当前的时间窗口结束时间迟20s, 下面是计算结果:
+
+````
+> SELECT temperature_max from root.ln.*.*;
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+| Time|root.ln.wf02.wt02.temperature_max|root.ln.wf02.wt01.temperature_max|root.ln.wf01.wt02.temperature_max|root.ln.wf01.wt01.temperature_max|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+|2021-05-11T22:18:00.000+08:00| 100.0| 100.0| 100.0| 100.0|
+|2021-05-11T22:18:10.000+08:00| 121.0| 72.0| 183.0| 115.0|
+|2021-05-11T22:18:20.000+08:00| 122.0| 45.0| 59.0| 181.0|
+|2021-05-11T22:18:30.000+08:00| 182.0| 113.0| 52.0| 180.0|
++-----------------------------+---------------------------------+---------------------------------+---------------------------------+---------------------------------+
+````
+
+#### 没有GROUP BY TIME子句的连续查询
+
+不使用`GROUP BY TIME`子句,并在`RESAMPLE`子句中显式使用`EVERY`参数指定连续查询的执行间隔。
+
+```sql
+CREATE CONTINUOUS QUERY cq5
+RESAMPLE EVERY 20s
+BEGIN
+ SELECT temperature + 1
+ INTO root.precalculated_sg.::(temperature)
+ FROM root.ln.*.*
+ align by device
+END
+```
+
+`cq5`计算以`root.ln`为前缀的所有`temperature + 1`的值,并将结果储存在另一个 database `root.precalculated_sg`中。除 database 名称不同外,目标序列与源序列路径名均相同。
+
+`cq5`每20秒执行一次,每次执行的查询的时间窗口范围是从过去20秒到当前时间。
+
+假设当前时间是`2021-05-11T22:18:40.000+08:00`,如果把日志等级设置为DEBUG,我们可以在`cq5`执行的DataNode上看到如下的输出:
+
+````
+At **2021-05-11T22:18:40.000+08:00**, `cq5` executes a query within the time range `[2021-05-11T22:18:20, 2021-05-11T22:18:40)`.
+`cq5` generate 16 lines:
+>
++-----------------------------+-------------------------------+-----------+
+| Time| Device|temperature|
++-----------------------------+-------------------------------+-----------+
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf02.wt02| 123.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf02.wt02| 48.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf02.wt02| 183.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf02.wt02| 45.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf02.wt01| 46.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf02.wt01| 15.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf02.wt01| 114.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf02.wt01| 12.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf01.wt02| 12.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf01.wt02| 60.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf01.wt02| 30.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf01.wt02| 53.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf01.wt01| 15.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf01.wt01| 182.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf01.wt01| 181.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf01.wt01| 20.0|
++-----------------------------+-------------------------------+-----------+
+>
+At **2021-05-11T22:19:00.000+08:00**, `cq5` executes a query within the time range `[2021-05-11T22:18:40, 2021-05-11T22:19:00)`.
+`cq5` generate 12 lines:
+>
++-----------------------------+-------------------------------+-----------+
+| Time| Device|temperature|
++-----------------------------+-------------------------------+-----------+
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf02.wt02| 79.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf02.wt02| 138.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf02.wt02| 17.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf02.wt01| 39.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf02.wt01| 173.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf02.wt01| 125.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf01.wt02| 124.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf01.wt02| 136.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf01.wt02| 184.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf01.wt01| 53.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf01.wt01| 194.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf01.wt01| 19.0|
++-----------------------------+-------------------------------+-----------+
+>
+````
+
+`cq5`并不会处理当前时间窗口以外的数据,即`2021-05-11T22:18:20.000+08:00`以前的数据,所以我们会得到如下结果:
+
+````
+> SELECT temperature from root.precalculated_sg.*.* align by device;
++-----------------------------+-------------------------------+-----------+
+| Time| Device|temperature|
++-----------------------------+-------------------------------+-----------+
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf02.wt02| 123.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf02.wt02| 48.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf02.wt02| 183.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf02.wt02| 45.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf02.wt02| 79.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf02.wt02| 138.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf02.wt02| 17.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf02.wt01| 46.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf02.wt01| 15.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf02.wt01| 114.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf02.wt01| 12.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf02.wt01| 39.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf02.wt01| 173.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf02.wt01| 125.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf01.wt02| 12.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf01.wt02| 60.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf01.wt02| 30.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf01.wt02| 53.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf01.wt02| 124.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf01.wt02| 136.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf01.wt02| 184.0|
+|2021-05-11T22:18:24.949+08:00|root.precalculated_sg.wf01.wt01| 15.0|
+|2021-05-11T22:18:29.967+08:00|root.precalculated_sg.wf01.wt01| 182.0|
+|2021-05-11T22:18:34.979+08:00|root.precalculated_sg.wf01.wt01| 181.0|
+|2021-05-11T22:18:39.990+08:00|root.precalculated_sg.wf01.wt01| 20.0|
+|2021-05-11T22:18:44.995+08:00|root.precalculated_sg.wf01.wt01| 53.0|
+|2021-05-11T22:18:49.999+08:00|root.precalculated_sg.wf01.wt01| 194.0|
+|2021-05-11T22:18:55.003+08:00|root.precalculated_sg.wf01.wt01| 19.0|
++-----------------------------+-------------------------------+-----------+
+````
+
+### 连续查询的管理
+
+#### 查询系统已有的连续查询
+
+展示集群中所有的已注册的连续查询
+
+```sql
+SHOW (CONTINUOUS QUERIES | CQS)
+```
+
+`SHOW (CONTINUOUS QUERIES | CQS)`会将结果集按照`cq_id`排序。
+
+##### 例子
+
+```sql
+SHOW CONTINUOUS QUERIES;
+```
+
+执行以上sql,我们将会得到如下的查询结果:
+
+| cq_id | query | state |
+|:-------------|---------------------------------------------------------------------------------------------------------------------------------------|-------|
+| s1_count_cq | CREATE CQ s1_count_cq<br/>BEGIN<br/>SELECT count(s1)<br/>INTO root.sg_count.d.count_s1<br/>FROM root.sg.d<br/>GROUP BY(30m)<br/>END | active |
+
+
+#### 删除已有的连续查询
+
+删除指定的名为cq_id的连续查询:
+
+```sql
+DROP (CONTINUOUS QUERY | CQ) <cq_id>
+```
+
+DROP CQ并不会返回任何结果集。
+
+##### 例子
+
+删除名为s1_count_cq的连续查询:
+
+```sql
+DROP CONTINUOUS QUERY s1_count_cq;
+```
+
+#### 修改已有的连续查询
+
+目前连续查询一旦被创建就不能再被修改。如果想要修改某个连续查询,只能先用`DROP`命令删除它,然后再用`CREATE`命令重新创建。
+
+
+### 连续查询的使用场景
+
+#### 对数据进行降采样并对降采样后的数据使用不同的保留策略
+
+可以使用连续查询,定期将高频率采样的原始数据(如每秒1000个点),降采样(如每秒仅保留一个点)后保存到另一个 database 的同名序列中。高精度的原始数据所在 database 的`TTL`可能设置的比较短,比如一天,而低精度的降采样后的数据所在的 database `TTL`可以设置的比较长,比如一个月,从而达到快速释放磁盘空间的目的。
+
+#### 预计算代价昂贵的查询
+
+我们可以通过连续查询对一些重复的查询进行预计算,并将查询结果保存在某些目标序列中,这样真实查询并不需要真的再次去做计算,而是直接查询目标序列的结果,从而缩短了查询的时间。
+
+> 预计算查询结果尤其对一些可视化工具渲染时序图和工作台时有很大的加速作用。
+
+#### 作为子查询的替代品
+
+IoTDB现在不支持子查询,但是我们可以通过创建连续查询得到相似的功能。我们可以将子查询注册为一个连续查询,并将子查询的结果物化到目标序列中,外层查询再直接查询哪个目标序列。
+
+##### 例子
+
+IoTDB并不会接收如下的嵌套子查询。这个查询会计算s1序列每隔30分钟的非空值数量的平均值:
+
+```sql
+SELECT avg(count_s1) from (select count(s1) as count_s1 from root.sg.d group by([0, now()), 30m));
+```
+
+为了得到相同的结果,我们可以:
+
+**1. 创建一个连续查询**
+
+这一步执行内层子查询部分。下面创建的连续查询每隔30分钟计算一次`root.sg.d.s1`序列的非空值数量,并将结果写入目标序列`root.sg_count.d.count_s1`中。
+
+```sql
+CREATE CQ s1_count_cq
+BEGIN
+ SELECT count(s1)
+ INTO root.sg_count.d.count_s1
+ FROM root.sg.d
+ GROUP BY(30m)
+END
+```
+
+**2. 查询连续查询的结果**
+
+这一步执行外层查询的avg([...])部分。
+
+查询序列`root.sg_count.d.count_s1`的值,并计算平均值:
+
+```sql
+SELECT avg(count_s1) from root.sg_count.d;
+```
+
+
+### 连续查询相关的配置参数
+| 参数名 | 描述 | 类型 | 默认值 |
+| :---------------------------------- |----------------------|----------|---------------|
+| `continuous_query_submit_thread` | 用于周期性提交连续查询执行任务的线程数 | int32 | 2 |
+| `continuous_query_min_every_interval_in_ms` | 系统允许的连续查询最小的周期性时间间隔 | duration | 1000 |
+
+## 用户自定义函数
+
+### 数据质量函数
+#### Completeness
+
+##### 函数简介
+
+本函数用于计算时间序列的完整性。将输入序列划分为若干个连续且不重叠的窗口,分别计算每一个窗口的完整性,并输出窗口第一个数据点的时间戳和窗口的完整性。
+
+**函数名:** COMPLETENESS
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `window`:窗口大小,它是一个大于0的整数或者一个有单位的正数。前者代表每一个窗口包含的数据点数目,最后一个窗口的数据点数目可能会不足;后者代表窗口的时间跨度,目前支持五种单位,分别是'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。缺省情况下,全部输入数据都属于同一个窗口。
++ `downtime`:完整性计算是否考虑停机异常。它的取值为 'true' 或 'false',默认值为 'true'. 在考虑停机异常时,长时间的数据缺失将被视作停机,不对完整性产生影响。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,其中每一个数据点的值的范围都是 [0,1].
+
+**提示:** 只有当窗口内的数据点数目超过10时,才会进行完整性计算。否则,该窗口将被忽略,不做任何输出。
+
+
+##### 使用示例
+
+###### 参数缺省
+
+在参数缺省的情况下,本函数将会把全部输入数据都作为同一个窗口计算完整性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select completeness(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------------+
+| Time|completeness(root.test.d1.s1)|
++-----------------------------+-----------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.875|
++-----------------------------+-----------------------------+
+```
+
+###### 指定窗口大小
+
+在指定窗口大小的情况下,本函数会把输入数据划分为若干个窗口计算完整性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
+|2020-01-01T00:00:32.000+08:00| 130.0|
+|2020-01-01T00:00:34.000+08:00| 132.0|
+|2020-01-01T00:00:36.000+08:00| 134.0|
+|2020-01-01T00:00:38.000+08:00| 136.0|
+|2020-01-01T00:00:40.000+08:00| 138.0|
+|2020-01-01T00:00:42.000+08:00| 140.0|
+|2020-01-01T00:00:44.000+08:00| 142.0|
+|2020-01-01T00:00:46.000+08:00| 144.0|
+|2020-01-01T00:00:48.000+08:00| 146.0|
+|2020-01-01T00:00:50.000+08:00| 148.0|
+|2020-01-01T00:00:52.000+08:00| 150.0|
+|2020-01-01T00:00:54.000+08:00| 152.0|
+|2020-01-01T00:00:56.000+08:00| 154.0|
+|2020-01-01T00:00:58.000+08:00| 156.0|
+|2020-01-01T00:01:00.000+08:00| 158.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select completeness(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------+
+| Time|completeness(root.test.d1.s1, "window"="15")|
++-----------------------------+--------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.875|
+|2020-01-01T00:00:32.000+08:00| 1.0|
++-----------------------------+--------------------------------------------+
+```
+
+#### Consistency
+
+##### 函数简介
+
+本函数用于计算时间序列的一致性。将输入序列划分为若干个连续且不重叠的窗口,分别计算每一个窗口的一致性,并输出窗口第一个数据点的时间戳和窗口的时效性。
+
+**函数名:** CONSISTENCY
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `window`:窗口大小,它是一个大于0的整数或者一个有单位的正数。前者代表每一个窗口包含的数据点数目,最后一个窗口的数据点数目可能会不足;后者代表窗口的时间跨度,目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。缺省情况下,全部输入数据都属于同一个窗口。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,其中每一个数据点的值的范围都是 [0,1].
+
+**提示:** 只有当窗口内的数据点数目超过10时,才会进行一致性计算。否则,该窗口将被忽略,不做任何输出。
+
+
+##### 使用示例
+
+###### 参数缺省
+
+在参数缺省的情况下,本函数将会把全部输入数据都作为同一个窗口计算一致性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select consistency(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------+
+| Time|consistency(root.test.d1.s1)|
++-----------------------------+----------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.9333333333333333|
++-----------------------------+----------------------------+
+```
+
+###### 指定窗口大小
+
+在指定窗口大小的情况下,本函数会把输入数据划分为若干个窗口计算一致性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
+|2020-01-01T00:00:32.000+08:00| 130.0|
+|2020-01-01T00:00:34.000+08:00| 132.0|
+|2020-01-01T00:00:36.000+08:00| 134.0|
+|2020-01-01T00:00:38.000+08:00| 136.0|
+|2020-01-01T00:00:40.000+08:00| 138.0|
+|2020-01-01T00:00:42.000+08:00| 140.0|
+|2020-01-01T00:00:44.000+08:00| 142.0|
+|2020-01-01T00:00:46.000+08:00| 144.0|
+|2020-01-01T00:00:48.000+08:00| 146.0|
+|2020-01-01T00:00:50.000+08:00| 148.0|
+|2020-01-01T00:00:52.000+08:00| 150.0|
+|2020-01-01T00:00:54.000+08:00| 152.0|
+|2020-01-01T00:00:56.000+08:00| 154.0|
+|2020-01-01T00:00:58.000+08:00| 156.0|
+|2020-01-01T00:01:00.000+08:00| 158.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select consistency(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------------+
+| Time|consistency(root.test.d1.s1, "window"="15")|
++-----------------------------+-------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.9333333333333333|
+|2020-01-01T00:00:32.000+08:00| 1.0|
++-----------------------------+-------------------------------------------+
+```
+
+#### Timeliness
+
+##### 函数简介
+
+本函数用于计算时间序列的时效性。将输入序列划分为若干个连续且不重叠的窗口,分别计算每一个窗口的时效性,并输出窗口第一个数据点的时间戳和窗口的时效性。
+
+**函数名:** TIMELINESS
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `window`:窗口大小,它是一个大于0的整数或者一个有单位的正数。前者代表每一个窗口包含的数据点数目,最后一个窗口的数据点数目可能会不足;后者代表窗口的时间跨度,目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。缺省情况下,全部输入数据都属于同一个窗口。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,其中每一个数据点的值的范围都是 [0,1].
+
+**提示:** 只有当窗口内的数据点数目超过10时,才会进行时效性计算。否则,该窗口将被忽略,不做任何输出。
+
+
+##### 使用示例
+
+###### 参数缺省
+
+在参数缺省的情况下,本函数将会把全部输入数据都作为同一个窗口计算时效性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select timeliness(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------+
+| Time|timeliness(root.test.d1.s1)|
++-----------------------------+---------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.9333333333333333|
++-----------------------------+---------------------------+
+```
+
+###### 指定窗口大小
+
+在指定窗口大小的情况下,本函数会把输入数据划分为若干个窗口计算时效性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
+|2020-01-01T00:00:32.000+08:00| 130.0|
+|2020-01-01T00:00:34.000+08:00| 132.0|
+|2020-01-01T00:00:36.000+08:00| 134.0|
+|2020-01-01T00:00:38.000+08:00| 136.0|
+|2020-01-01T00:00:40.000+08:00| 138.0|
+|2020-01-01T00:00:42.000+08:00| 140.0|
+|2020-01-01T00:00:44.000+08:00| 142.0|
+|2020-01-01T00:00:46.000+08:00| 144.0|
+|2020-01-01T00:00:48.000+08:00| 146.0|
+|2020-01-01T00:00:50.000+08:00| 148.0|
+|2020-01-01T00:00:52.000+08:00| 150.0|
+|2020-01-01T00:00:54.000+08:00| 152.0|
+|2020-01-01T00:00:56.000+08:00| 154.0|
+|2020-01-01T00:00:58.000+08:00| 156.0|
+|2020-01-01T00:01:00.000+08:00| 158.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select timeliness(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------+
+| Time|timeliness(root.test.d1.s1, "window"="15")|
++-----------------------------+------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.9333333333333333|
+|2020-01-01T00:00:32.000+08:00| 1.0|
++-----------------------------+------------------------------------------+
+```
+
+#### Validity
+
+##### 函数简介
+
+本函数用于计算时间序列的有效性。将输入序列划分为若干个连续且不重叠的窗口,分别计算每一个窗口的有效性,并输出窗口第一个数据点的时间戳和窗口的有效性。
+
+
+**函数名:** VALIDITY
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `window`:窗口大小,它是一个大于0的整数或者一个有单位的正数。前者代表每一个窗口包含的数据点数目,最后一个窗口的数据点数目可能会不足;后者代表窗口的时间跨度,目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。缺省情况下,全部输入数据都属于同一个窗口。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,其中每一个数据点的值的范围都是 [0,1].
+
+**提示:** 只有当窗口内的数据点数目超过10时,才会进行有效性计算。否则,该窗口将被忽略,不做任何输出。
+
+
+##### 使用示例
+
+###### 参数缺省
+
+在参数缺省的情况下,本函数将会把全部输入数据都作为同一个窗口计算有效性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select validity(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------+
+| Time|validity(root.test.d1.s1)|
++-----------------------------+-------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.8833333333333333|
++-----------------------------+-------------------------+
+```
+
+###### 指定窗口大小
+
+在指定窗口大小的情况下,本函数会把输入数据划分为若干个窗口计算有效性。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
+|2020-01-01T00:00:32.000+08:00| 130.0|
+|2020-01-01T00:00:34.000+08:00| 132.0|
+|2020-01-01T00:00:36.000+08:00| 134.0|
+|2020-01-01T00:00:38.000+08:00| 136.0|
+|2020-01-01T00:00:40.000+08:00| 138.0|
+|2020-01-01T00:00:42.000+08:00| 140.0|
+|2020-01-01T00:00:44.000+08:00| 142.0|
+|2020-01-01T00:00:46.000+08:00| 144.0|
+|2020-01-01T00:00:48.000+08:00| 146.0|
+|2020-01-01T00:00:50.000+08:00| 148.0|
+|2020-01-01T00:00:52.000+08:00| 150.0|
+|2020-01-01T00:00:54.000+08:00| 152.0|
+|2020-01-01T00:00:56.000+08:00| 154.0|
+|2020-01-01T00:00:58.000+08:00| 156.0|
+|2020-01-01T00:01:00.000+08:00| 158.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select validity(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------------------+
+| Time|validity(root.test.d1.s1, "window"="15")|
++-----------------------------+----------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.8833333333333333|
+|2020-01-01T00:00:32.000+08:00| 1.0|
++-----------------------------+----------------------------------------+
+```
+
+#### Accuracy
+
+##### 函数简介
+
+本函数基于主数据计算原始时间序列的准确性。
+
+**函数名**:Accuracy
+
+**输入序列:** 支持多个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
+- `omega`:算法窗口大小,非负整数(单位为毫秒), 在缺省情况下,算法根据不同时间差下的两个元组距离自动估计该参数。
+- `eta`:算法距离阈值,正数, 在缺省情况下,算法根据窗口中元组的距离分布自动估计该参数。
+- `k`:主数据中的近邻数量,正整数, 在缺省情况下,算法根据主数据中的k个近邻的元组距离自动估计该参数。
+
+**输出序列**:输出单个值,类型为DOUBLE,值的范围为[0,1]。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+------------+------------+------------+------------+------------+------------+
+| Time|root.test.t1|root.test.t2|root.test.t3|root.test.m1|root.test.m2|root.test.m3|
++-----------------------------+------------+------------+------------+------------+------------+------------+
+|2021-07-01T12:00:01.000+08:00| 1704| 1154.55| 0.195| 1704| 1154.55| 0.195|
+|2021-07-01T12:00:02.000+08:00| 1702| 1152.30| 0.193| 1702| 1152.30| 0.193|
+|2021-07-01T12:00:03.000+08:00| 1702| 1148.65| 0.192| 1702| 1148.65| 0.192|
+|2021-07-01T12:00:04.000+08:00| 1701| 1145.20| 0.194| 1701| 1145.20| 0.194|
+|2021-07-01T12:00:07.000+08:00| 1703| 1150.55| 0.195| 1703| 1150.55| 0.195|
+|2021-07-01T12:00:08.000+08:00| 1694| 1151.55| 0.193| 1704| 1151.55| 0.193|
+|2021-07-01T12:01:09.000+08:00| 1705| 1153.55| 0.194| 1705| 1153.55| 0.194|
+|2021-07-01T12:01:10.000+08:00| 1706| 1152.30| 0.190| 1706| 1152.30| 0.190|
++-----------------------------+------------+------------+------------+------------+------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select Accuracy(t1,t2,t3,m1,m2,m3) from root.test
+```
+
+输出序列:
+
+
+```
++-----------------------------+---------------------------------------------------------------------------------------+
+| Time|Accuracy(root.test.t1,root.test.t2,root.test.t3,root.test.m1,root.test.m2,root.test.m3)|
++-----------------------------+---------------------------------------------------------------------------------------+
+|2021-07-01T12:00:01.000+08:00| 0.875|
++-----------------------------+---------------------------------------------------------------------------------------+
+```
+
+
+
+### 趋势计算函数
+
+目前 IoTDB 支持如下趋势计算函数:
+
+| 函数名 | 输入序列类型 | 输出序列类型 | 功能描述 |
+| ----------------------- | ----------------------------------------------- | ------------------------ | ------------------------------------------------------------ |
+| TIME_DIFFERENCE | INT32 / INT64 / FLOAT / DOUBLE / BOOLEAN / TEXT | INT64 | 统计序列中某数据点的时间戳与前一数据点时间戳的差。范围内第一个数据点没有对应的结果输出。 |
+| DIFFERENCE | INT32 / INT64 / FLOAT / DOUBLE | 与输入序列的实际类型一致 | 统计序列中某数据点的值与前一数据点的值的差。范围内第一个数据点没有对应的结果输出。 |
+| NON_NEGATIVE_DIFFERENCE | INT32 / INT64 / FLOAT / DOUBLE | 与输入序列的实际类型一致 | 统计序列中某数据点的值与前一数据点的值的差的绝对值。范围内第一个数据点没有对应的结果输出。 |
+| DERIVATIVE | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | 统计序列中某数据点相对于前一数据点的变化率,数量上等同于 DIFFERENCE / TIME_DIFFERENCE。范围内第一个数据点没有对应的结果输出。 |
+| NON_NEGATIVE_DERIVATIVE | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | 统计序列中某数据点相对于前一数据点的变化率的绝对值,数量上等同于 NON_NEGATIVE_DIFFERENCE / TIME_DIFFERENCE。范围内第一个数据点没有对应的结果输出。 |
+
+例如:
+
+``` sql
+select s1, time_difference(s1), difference(s1), non_negative_difference(s1), derivative(s1), non_negative_derivative(s1) from root.sg1.d1 limit 5 offset 1000;
+```
+
+结果:
+
+```
++-----------------------------+-------------------+-------------------------------+--------------------------+---------------------------------------+--------------------------+---------------------------------------+
+| Time| root.sg1.d1.s1|time_difference(root.sg1.d1.s1)|difference(root.sg1.d1.s1)|non_negative_difference(root.sg1.d1.s1)|derivative(root.sg1.d1.s1)|non_negative_derivative(root.sg1.d1.s1)|
++-----------------------------+-------------------+-------------------------------+--------------------------+---------------------------------------+--------------------------+---------------------------------------+
+|2020-12-10T17:11:49.037+08:00|7360723084922759782| 1| -8431715764844238876| 8431715764844238876| -8.4317157648442388E18| 8.4317157648442388E18|
+|2020-12-10T17:11:49.038+08:00|4377791063319964531| 1| -2982932021602795251| 2982932021602795251| -2.982932021602795E18| 2.982932021602795E18|
+|2020-12-10T17:11:49.039+08:00|7972485567734642915| 1| 3594694504414678384| 3594694504414678384| 3.5946945044146785E18| 3.5946945044146785E18|
+|2020-12-10T17:11:49.040+08:00|2508858212791964081| 1| -5463627354942678834| 5463627354942678834| -5.463627354942679E18| 5.463627354942679E18|
+|2020-12-10T17:11:49.041+08:00|2817297431185141819| 1| 308439218393177738| 308439218393177738| 3.0843921839317773E17| 3.0843921839317773E17|
++-----------------------------+-------------------+-------------------------------+--------------------------+---------------------------------------+--------------------------+---------------------------------------+
+Total line number = 5
+It costs 0.014s
+```
+
+| 函数名 | 输入序列类型 | 参数 | 输出序列类型 | 功能描述 |
+|------|--------------------------------|------------------------------------------------------------------------------------------------------------------------|--------|------------------------------------------------|
+| DIFF | INT32 / INT64 / FLOAT / DOUBLE | `ignoreNull`:可选,默认为true;为true时,前一个数据点值为null时,忽略该数据点继续向前找到第一个出现的不为null的值;为false时,如果前一个数据点为null,则不忽略,使用null进行相减,结果也为null | DOUBLE | 统计序列中某数据点的值与前一数据点的值的差。第一个数据点没有对应的结果输出,输出值为null |
+
+#### 使用示例
+
+##### 原始数据
+
+```
++-----------------------------+------------+------------+
+| Time|root.test.s1|root.test.s2|
++-----------------------------+------------+------------+
+|1970-01-01T08:00:00.001+08:00| 1| 1.0|
+|1970-01-01T08:00:00.002+08:00| 2| null|
+|1970-01-01T08:00:00.003+08:00| null| 3.0|
+|1970-01-01T08:00:00.004+08:00| 4| null|
+|1970-01-01T08:00:00.005+08:00| 5| 5.0|
+|1970-01-01T08:00:00.006+08:00| null| 6.0|
++-----------------------------+------------+------------+
+```
+
+##### 不使用ignoreNull参数(忽略null)
+
+SQL:
+```sql
+SELECT DIFF(s1), DIFF(s2) from root.test;
+```
+
+输出:
+```
++-----------------------------+------------------+------------------+
+| Time|DIFF(root.test.s1)|DIFF(root.test.s2)|
++-----------------------------+------------------+------------------+
+|1970-01-01T08:00:00.001+08:00| null| null|
+|1970-01-01T08:00:00.002+08:00| 1.0| null|
+|1970-01-01T08:00:00.003+08:00| null| 2.0|
+|1970-01-01T08:00:00.004+08:00| 2.0| null|
+|1970-01-01T08:00:00.005+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.006+08:00| null| 1.0|
++-----------------------------+------------------+------------------+
+```
+
+##### 使用ignoreNull参数
+
+SQL:
+```sql
+SELECT DIFF(s1, 'ignoreNull'='false'), DIFF(s2, 'ignoreNull'='false') from root.test;
+```
+
+输出:
+```
++-----------------------------+----------------------------------------+----------------------------------------+
+| Time|DIFF(root.test.s1, "ignoreNull"="false")|DIFF(root.test.s2, "ignoreNull"="false")|
++-----------------------------+----------------------------------------+----------------------------------------+
+|1970-01-01T08:00:00.001+08:00| null| null|
+|1970-01-01T08:00:00.002+08:00| 1.0| null|
+|1970-01-01T08:00:00.003+08:00| null| null|
+|1970-01-01T08:00:00.004+08:00| null| null|
+|1970-01-01T08:00:00.005+08:00| 1.0| null|
+|1970-01-01T08:00:00.006+08:00| null| 1.0|
++-----------------------------+----------------------------------------+----------------------------------------+
+```
+
+
+### 采样函数
+
+#### 等数量分桶降采样函数
+
+本函数对输入序列进行等数量分桶采样,即根据用户给定的降采样比例和降采样方法将输入序列按固定点数等分为若干桶。在每个桶内通过给定的采样方法进行采样。
+
+##### 等数量分桶随机采样
+
+对等数量分桶后,桶内进行随机采样。
+
+| 函数名 | 可接收的输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能类型 |
+|----------|--------------------------------|---------------------------------------|------------|--------------------------------------------------|
+| EQUAL_SIZE_BUCKET_RANDOM_SAMPLE | INT32 / INT64 / FLOAT / DOUBLE | 降采样比例 `proportion`,取值范围为`(0, 1]`,默认为`0.1` | INT32 / INT64 / FLOAT / DOUBLE | 返回符合采样比例的等分桶随机采样 |
+
+###### 使用示例
+
+输入序列:`root.ln.wf01.wt01.temperature`从`0.0-99.0`共`100`条数据。
+
+```
+IoTDB> select temperature from root.ln.wf01.wt01;
++-----------------------------+-----------------------------+
+| Time|root.ln.wf01.wt01.temperature|
++-----------------------------+-----------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.001+08:00| 1.0|
+|1970-01-01T08:00:00.002+08:00| 2.0|
+|1970-01-01T08:00:00.003+08:00| 3.0|
+|1970-01-01T08:00:00.004+08:00| 4.0|
+|1970-01-01T08:00:00.005+08:00| 5.0|
+|1970-01-01T08:00:00.006+08:00| 6.0|
+|1970-01-01T08:00:00.007+08:00| 7.0|
+|1970-01-01T08:00:00.008+08:00| 8.0|
+|1970-01-01T08:00:00.009+08:00| 9.0|
+|1970-01-01T08:00:00.010+08:00| 10.0|
+|1970-01-01T08:00:00.011+08:00| 11.0|
+|1970-01-01T08:00:00.012+08:00| 12.0|
+|.............................|.............................|
+|1970-01-01T08:00:00.089+08:00| 89.0|
+|1970-01-01T08:00:00.090+08:00| 90.0|
+|1970-01-01T08:00:00.091+08:00| 91.0|
+|1970-01-01T08:00:00.092+08:00| 92.0|
+|1970-01-01T08:00:00.093+08:00| 93.0|
+|1970-01-01T08:00:00.094+08:00| 94.0|
+|1970-01-01T08:00:00.095+08:00| 95.0|
+|1970-01-01T08:00:00.096+08:00| 96.0|
+|1970-01-01T08:00:00.097+08:00| 97.0|
+|1970-01-01T08:00:00.098+08:00| 98.0|
+|1970-01-01T08:00:00.099+08:00| 99.0|
++-----------------------------+-----------------------------+
+```
+sql:
+```sql
+select equal_size_bucket_random_sample(temperature,'proportion'='0.1') as random_sample from root.ln.wf01.wt01;
+```
+结果:
+```
++-----------------------------+-------------+
+| Time|random_sample|
++-----------------------------+-------------+
+|1970-01-01T08:00:00.007+08:00| 7.0|
+|1970-01-01T08:00:00.014+08:00| 14.0|
+|1970-01-01T08:00:00.020+08:00| 20.0|
+|1970-01-01T08:00:00.035+08:00| 35.0|
+|1970-01-01T08:00:00.047+08:00| 47.0|
+|1970-01-01T08:00:00.059+08:00| 59.0|
+|1970-01-01T08:00:00.063+08:00| 63.0|
+|1970-01-01T08:00:00.079+08:00| 79.0|
+|1970-01-01T08:00:00.086+08:00| 86.0|
+|1970-01-01T08:00:00.096+08:00| 96.0|
++-----------------------------+-------------+
+Total line number = 10
+It costs 0.024s
+```
+
+##### 等数量分桶聚合采样
+
+采用聚合采样法对输入序列进行采样,用户需要另外提供一个聚合函数参数即
+- `type`:聚合类型,取值为`avg`或`max`或`min`或`sum`或`extreme`或`variance`。在缺省情况下,采用`avg`。其中`extreme`表示等分桶中,绝对值最大的值。`variance`表示采样等分桶中的方差。
+
+每个桶采样输出的时间戳为这个桶第一个点的时间戳
+
+
+| 函数名 | 可接收的输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能类型 |
+|----------|--------------------------------|---------------------------------------|------------|--------------------------------------------------|
+| EQUAL_SIZE_BUCKET_AGG_SAMPLE | INT32 / INT64 / FLOAT / DOUBLE | `proportion`取值范围为`(0, 1]`,默认为`0.1`<br>`type`:取值类型有`avg`, `max`, `min`, `sum`, `extreme`, `variance`, 默认为`avg` | INT32 / INT64 / FLOAT / DOUBLE | 返回符合采样比例的等分桶聚合采样 |
+
+###### 使用示例
+
+输入序列:`root.ln.wf01.wt01.temperature`从`0.0-99.0`共`100`条有序数据,同等分桶随机采样的测试数据。
+
+sql:
+```sql
+select equal_size_bucket_agg_sample(temperature, 'type'='avg','proportion'='0.1') as agg_avg, equal_size_bucket_agg_sample(temperature, 'type'='max','proportion'='0.1') as agg_max, equal_size_bucket_agg_sample(temperature,'type'='min','proportion'='0.1') as agg_min, equal_size_bucket_agg_sample(temperature, 'type'='sum','proportion'='0.1') as agg_sum, equal_size_bucket_agg_sample(temperature, 'type'='extreme','proportion'='0.1') as agg_extreme, equal_size_bucket_agg_sample(temperature, ' [...]
+```
+结果:
+```
++-----------------------------+-----------------+-------+-------+-------+-----------+------------+
+| Time| agg_avg|agg_max|agg_min|agg_sum|agg_extreme|agg_variance|
++-----------------------------+-----------------+-------+-------+-------+-----------+------------+
+|1970-01-01T08:00:00.000+08:00| 4.5| 9.0| 0.0| 45.0| 9.0| 8.25|
+|1970-01-01T08:00:00.010+08:00| 14.5| 19.0| 10.0| 145.0| 19.0| 8.25|
+|1970-01-01T08:00:00.020+08:00| 24.5| 29.0| 20.0| 245.0| 29.0| 8.25|
+|1970-01-01T08:00:00.030+08:00| 34.5| 39.0| 30.0| 345.0| 39.0| 8.25|
+|1970-01-01T08:00:00.040+08:00| 44.5| 49.0| 40.0| 445.0| 49.0| 8.25|
+|1970-01-01T08:00:00.050+08:00| 54.5| 59.0| 50.0| 545.0| 59.0| 8.25|
+|1970-01-01T08:00:00.060+08:00| 64.5| 69.0| 60.0| 645.0| 69.0| 8.25|
+|1970-01-01T08:00:00.070+08:00|74.50000000000001| 79.0| 70.0| 745.0| 79.0| 8.25|
+|1970-01-01T08:00:00.080+08:00| 84.5| 89.0| 80.0| 845.0| 89.0| 8.25|
+|1970-01-01T08:00:00.090+08:00| 94.5| 99.0| 90.0| 945.0| 99.0| 8.25|
++-----------------------------+-----------------+-------+-------+-------+-----------+------------+
+Total line number = 10
+It costs 0.044s
+```
+
+##### 等数量分桶 M4 采样
+
+采用M4采样法对输入序列进行采样。即对于每个桶采样首、尾、最小和最大值。
+
+| 函数名 | 可接收的输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能类型 |
+|----------|--------------------------------|---------------------------------------|------------|--------------------------------------------------|
+| EQUAL_SIZE_BUCKET_M4_SAMPLE | INT32 / INT64 / FLOAT / DOUBLE | `proportion`取值范围为`(0, 1]`,默认为`0.1`| INT32 / INT64 / FLOAT / DOUBLE | 返回符合采样比例的等分桶M4采样 |
+
+###### 使用示例
+
+输入序列:`root.ln.wf01.wt01.temperature`从`0.0-99.0`共`100`条有序数据,同等分桶随机采样的测试数据。
+
+sql:
+```sql
+select equal_size_bucket_m4_sample(temperature, 'proportion'='0.1') as M4_sample from root.ln.wf01.wt01;
+```
+结果:
+```
++-----------------------------+---------+
+| Time|M4_sample|
++-----------------------------+---------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.001+08:00| 1.0|
+|1970-01-01T08:00:00.038+08:00| 38.0|
+|1970-01-01T08:00:00.039+08:00| 39.0|
+|1970-01-01T08:00:00.040+08:00| 40.0|
+|1970-01-01T08:00:00.041+08:00| 41.0|
+|1970-01-01T08:00:00.078+08:00| 78.0|
+|1970-01-01T08:00:00.079+08:00| 79.0|
+|1970-01-01T08:00:00.080+08:00| 80.0|
+|1970-01-01T08:00:00.081+08:00| 81.0|
+|1970-01-01T08:00:00.098+08:00| 98.0|
+|1970-01-01T08:00:00.099+08:00| 99.0|
++-----------------------------+---------+
+Total line number = 12
+It costs 0.065s
+```
+
+##### 等数量分桶离群值采样
+
+本函数对输入序列进行等数量分桶离群值采样,即根据用户给定的降采样比例和桶内采样个数将输入序列按固定点数等分为若干桶,在每个桶内通过给定的离群值采样方法进行采样。
+
+| 函数名 | 可接收的输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能类型 |
+|----------|--------------------------------|---------------------------------------|------------|--------------------------------------------------|
+| EQUAL_SIZE_BUCKET_OUTLIER_SAMPLE | INT32 / INT64 / FLOAT / DOUBLE | `proportion`取值范围为`(0, 1]`,默认为`0.1`<br>`type`取值为`avg`或`stendis`或`cos`或`prenextdis`,默认为`avg`<br>`number`取值应大于0,默认`3`| INT32 / INT64 / FLOAT / DOUBLE | 返回符合采样比例和桶内采样个数的等分桶离群值采样 |
+
+参数说明
+- `proportion`: 采样比例
+ - `number`: 每个桶内的采样个数,默认`3`
+- `type`: 离群值采样方法,取值为
+ - `avg`: 取桶内数据点的平均值,并根据采样比例,找到距离均值最远的`top number`个
+ - `stendis`: 取桶内每一个数据点距离桶的首末数据点连成直线的垂直距离,并根据采样比例,找到距离最大的`top number`个
+ - `cos`: 设桶内一个数据点为b,b左边的数据点为a,b右边的数据点为c,则取ab与bc向量的夹角的余弦值,值越小,说明形成的角度越大,越可能是异常值。找到cos值最小的`top number`个
+ - `prenextdis`: 设桶内一个数据点为b,b左边的数据点为a,b右边的数据点为c,则取ab与bc的长度之和作为衡量标准,和越大越可能是异常值,找到最大的`top number`个
+
+###### 使用示例
+
+测试数据:`root.ln.wf01.wt01.temperature`从`0.0-99.0`共`100`条数据,其中为了加入离群值,我们使得个位数为5的值自增100。
+```
+IoTDB> select temperature from root.ln.wf01.wt01;
++-----------------------------+-----------------------------+
+| Time|root.ln.wf01.wt01.temperature|
++-----------------------------+-----------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.001+08:00| 1.0|
+|1970-01-01T08:00:00.002+08:00| 2.0|
+|1970-01-01T08:00:00.003+08:00| 3.0|
+|1970-01-01T08:00:00.004+08:00| 4.0|
+|1970-01-01T08:00:00.005+08:00| 105.0|
+|1970-01-01T08:00:00.006+08:00| 6.0|
+|1970-01-01T08:00:00.007+08:00| 7.0|
+|1970-01-01T08:00:00.008+08:00| 8.0|
+|1970-01-01T08:00:00.009+08:00| 9.0|
+|1970-01-01T08:00:00.010+08:00| 10.0|
+|1970-01-01T08:00:00.011+08:00| 11.0|
+|1970-01-01T08:00:00.012+08:00| 12.0|
+|1970-01-01T08:00:00.013+08:00| 13.0|
+|1970-01-01T08:00:00.014+08:00| 14.0|
+|1970-01-01T08:00:00.015+08:00| 115.0|
+|1970-01-01T08:00:00.016+08:00| 16.0|
+|.............................|.............................|
+|1970-01-01T08:00:00.092+08:00| 92.0|
+|1970-01-01T08:00:00.093+08:00| 93.0|
+|1970-01-01T08:00:00.094+08:00| 94.0|
+|1970-01-01T08:00:00.095+08:00| 195.0|
+|1970-01-01T08:00:00.096+08:00| 96.0|
+|1970-01-01T08:00:00.097+08:00| 97.0|
+|1970-01-01T08:00:00.098+08:00| 98.0|
+|1970-01-01T08:00:00.099+08:00| 99.0|
++-----------------------------+-----------------------------+
+```
+sql:
+```sql
+select equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='avg', 'number'='2') as outlier_avg_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='stendis', 'number'='2') as outlier_stendis_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='cos', 'number'='2') as outlier_cos_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='prenextdis', 'number'='2') as outlier_prenextdis_sam [...]
+```
+结果:
+```
++-----------------------------+------------------+----------------------+------------------+-------------------------+
+| Time|outlier_avg_sample|outlier_stendis_sample|outlier_cos_sample|outlier_prenextdis_sample|
++-----------------------------+------------------+----------------------+------------------+-------------------------+
+|1970-01-01T08:00:00.005+08:00| 105.0| 105.0| 105.0| 105.0|
+|1970-01-01T08:00:00.015+08:00| 115.0| 115.0| 115.0| 115.0|
+|1970-01-01T08:00:00.025+08:00| 125.0| 125.0| 125.0| 125.0|
+|1970-01-01T08:00:00.035+08:00| 135.0| 135.0| 135.0| 135.0|
+|1970-01-01T08:00:00.045+08:00| 145.0| 145.0| 145.0| 145.0|
+|1970-01-01T08:00:00.055+08:00| 155.0| 155.0| 155.0| 155.0|
+|1970-01-01T08:00:00.065+08:00| 165.0| 165.0| 165.0| 165.0|
+|1970-01-01T08:00:00.075+08:00| 175.0| 175.0| 175.0| 175.0|
+|1970-01-01T08:00:00.085+08:00| 185.0| 185.0| 185.0| 185.0|
+|1970-01-01T08:00:00.095+08:00| 195.0| 195.0| 195.0| 195.0|
++-----------------------------+------------------+----------------------+------------------+-------------------------+
+Total line number = 10
+It costs 0.041s
+```
+
+#### M4函数
+
+##### 函数简介
+
+M4用于在窗口内采样第一个点(`first`)、最后一个点(`last`)、最小值点(`bottom`)、最大值点(`top`):
+
+- 第一个点是拥有这个窗口内最小时间戳的点;
+- 最后一个点是拥有这个窗口内最大时间戳的点;
+- 最小值点是拥有这个窗口内最小值的点(如果有多个这样的点,M4只返回其中一个);
+- 最大值点是拥有这个窗口内最大值的点(如果有多个这样的点,M4只返回其中一个)。
+
+<img src="https://alioss.timecho.com/docs/img/github/198178733-a0919d17-0663-4672-9c4f-1efad6f463c2.png" alt="image" style="zoom:50%;" />
+
+| 函数名 | 可接收的输入序列类型 | 属性参数 | 输出序列类型 | 功能类型 |
+| ------ | ------------------------------ | ------------------------------------------------------------ | ------------------------------ | ------------------------------------------------------------ |
+| M4 | INT32 / INT64 / FLOAT / DOUBLE | 包含固定点数的窗口和滑动时间窗口使用不同的属性参数。包含固定点数的窗口使用属性`windowSize`和`slidingStep`。滑动时间窗口使用属性`timeInterval`、`slidingStep`、`displayWindowBegin`和`displayWindowEnd`。更多细节见下文。 | INT32 / INT64 / FLOAT / DOUBLE | 返回每个窗口内的第一个点(`first`)、最后一个点(`last`)、最小值点(`bottom`)、最大值点(`top`)。在一个窗口内的聚合点输出之前,M4会将它们按照时间戳递增排序并且去重。 |
+
+##### 属性参数
+
+**(1) 包含固定点数的窗口(SlidingSizeWindowAccessStrategy)使用的属性参数:**
+
++ `windowSize`: 一个窗口内的点数。Int数据类型。必需的属性参数。
++ `slidingStep`: 按照设定的点数来滑动窗口。Int数据类型。可选的属性参数;如果没有设置,默认取值和`windowSize`一样。
+
+<img src="https://alioss.timecho.com/docs/img/github/198181449-00d563c8-7bce-4ecd-a031-ec120ca42c3f.png" alt="image" style="zoom: 50%;" />
+
+**(2) 滑动时间窗口(SlidingTimeWindowAccessStrategy)使用的属性参数:**
+
++ `timeInterval`: 一个窗口的时间长度。Long数据类型。必需的属性参数。
++ `slidingStep`: 按照设定的时长来滑动窗口。Long数据类型。可选的属性参数;如果没有设置,默认取值和`timeInterval`一样。
++ `displayWindowBegin`: 窗口滑动的起始时间戳位置(包含在内)。Long数据类型。可选的属性参数;如果没有设置,默认取值为Long.MIN_VALUE,意为使用输入的时间序列的第一个点的时间戳作为窗口滑动的起始时间戳位置。
++ `displayWindowEnd`: 结束时间限制(不包含在内;本质上和`WHERE time < displayWindowEnd`起的效果是一样的)。Long数据类型。可选的属性参数;如果没有设置,默认取值为Long.MAX_VALUE,意为除了输入的时间序列自身数据读取完毕之外没有增加额外的结束时间过滤条件限制。
+
+<img src="https://alioss.timecho.com/docs/img/github/198183015-93b56644-3330-4acf-ae9e-d718a02b5f4c.png" alt="groupBy window" style="zoom: 67%;" />
+
+##### 使用示例
+
+输入的时间序列:
+
+```sql
++-----------------------------+------------------+
+| Time|root.vehicle.d1.s1|
++-----------------------------+------------------+
+|1970-01-01T08:00:00.001+08:00| 5.0|
+|1970-01-01T08:00:00.002+08:00| 15.0|
+|1970-01-01T08:00:00.005+08:00| 10.0|
+|1970-01-01T08:00:00.008+08:00| 8.0|
+|1970-01-01T08:00:00.010+08:00| 30.0|
+|1970-01-01T08:00:00.020+08:00| 20.0|
+|1970-01-01T08:00:00.025+08:00| 8.0|
+|1970-01-01T08:00:00.027+08:00| 20.0|
+|1970-01-01T08:00:00.030+08:00| 40.0|
+|1970-01-01T08:00:00.033+08:00| 9.0|
+|1970-01-01T08:00:00.035+08:00| 10.0|
+|1970-01-01T08:00:00.040+08:00| 20.0|
+|1970-01-01T08:00:00.045+08:00| 30.0|
+|1970-01-01T08:00:00.052+08:00| 8.0|
+|1970-01-01T08:00:00.054+08:00| 18.0|
++-----------------------------+------------------+
+```
+
+查询语句1:
+
+```sql
+select M4(s1,'timeInterval'='25','displayWindowBegin'='0','displayWindowEnd'='100') from root.vehicle.d1
+```
+
+输出结果1:
+
+```sql
++-----------------------------+-----------------------------------------------------------------------------------------------+
+| Time|M4(root.vehicle.d1.s1, "timeInterval"="25", "displayWindowBegin"="0", "displayWindowEnd"="100")|
++-----------------------------+-----------------------------------------------------------------------------------------------+
+|1970-01-01T08:00:00.001+08:00| 5.0|
+|1970-01-01T08:00:00.010+08:00| 30.0|
+|1970-01-01T08:00:00.020+08:00| 20.0|
+|1970-01-01T08:00:00.025+08:00| 8.0|
+|1970-01-01T08:00:00.030+08:00| 40.0|
+|1970-01-01T08:00:00.045+08:00| 30.0|
+|1970-01-01T08:00:00.052+08:00| 8.0|
+|1970-01-01T08:00:00.054+08:00| 18.0|
++-----------------------------+-----------------------------------------------------------------------------------------------+
+Total line number = 8
+```
+
+查询语句2:
+
+```sql
+select M4(s1,'windowSize'='10') from root.vehicle.d1
+```
+
+输出结果2:
+
+```sql
++-----------------------------+-----------------------------------------+
+| Time|M4(root.vehicle.d1.s1, "windowSize"="10")|
++-----------------------------+-----------------------------------------+
+|1970-01-01T08:00:00.001+08:00| 5.0|
+|1970-01-01T08:00:00.030+08:00| 40.0|
+|1970-01-01T08:00:00.033+08:00| 9.0|
+|1970-01-01T08:00:00.035+08:00| 10.0|
+|1970-01-01T08:00:00.045+08:00| 30.0|
+|1970-01-01T08:00:00.052+08:00| 8.0|
+|1970-01-01T08:00:00.054+08:00| 18.0|
++-----------------------------+-----------------------------------------+
+Total line number = 7
+```
+
+##### 推荐的使用场景
+
+**(1) 使用场景:保留极端点的降采样**
+
+由于M4为每个窗口聚合其第一个点(`first`)、最后一个点(`last`)、最小值点(`bottom`)、最大值点(`top`),因此M4通常保留了极值点,因此比其他下采样方法(如分段聚合近似 (PAA))能更好地保留模式。如果你想对时间序列进行下采样并且希望保留极值点,你可以试试 M4。
+
+**(2) 使用场景:基于M4降采样的大规模时间序列的零误差双色折线图可视化**
+
+参考论文["M4: A Visualization-Oriented Time Series Data Aggregation"](http://www.vldb.org/pvldb/vol7/p797-jugel.pdf),作为大规模时间序列可视化的降采样方法,M4可以做到双色折线图的零变形。
+
+假设屏幕画布的像素宽乘高是`w*h`,假设时间序列要可视化的时间范围是`[tqs,tqe)`,并且(tqe-tqs)是w的整数倍,那么落在第i个时间跨度`Ii=[tqs+(tqe-tqs)/w*(i-1),tqs+(tqe-tqs)/w*i)` 内的点将会被画在第i个像素列中,i=1,2,...,w。于是从可视化驱动的角度出发,使用查询语句:`"select M4(s1,'timeInterval'='(tqe-tqs)/w','displayWindowBegin'='tqs','displayWindowEnd'='tqe') from root.vehicle.d1"`,来采集每个时间跨度内的第一个点(`first`)、最后一个点(`last`)、最小值点(`bottom`)、最大值点(`top`)。降采样时间序列的结果点数不会超过`4*w`个,与此同时,使用这些聚合点画出来的二色折线图与使用原始数据画出来的在像素级别上是完全一致的。
+
+为了免除参数值硬编码的麻烦,当Grafana用于可视化时,我们推荐使用Grafana的[模板变量](https://grafana.com/docs/grafana/latest/dashboards/variables/add-template-variables/#global-variables)`$ __interval_ms`,如下所示:
+
+```sql
+select M4(s1,'timeInterval'='$__interval_ms') from root.sg1.d1
+```
+
+其中`timeInterval`自动设置为`(tqe-tqs)/w`。请注意,这里的时间精度假定为毫秒。
+
+##### 和其它函数的功能比较
+
+| SQL | 是否支持M4聚合 | 滑动窗口类型 | 示例 | 相关文档 |
+| ------------------------------------------------- | ------------------------------------------------------------ | ------------------------------------------------- | ------------------------------------------------------------ | ------------------------------------------------------------ |
+| 1. 带有Group By子句的内置聚合函数 | 不支持,缺少`BOTTOM_TIME`和`TOP_TIME`,即缺少最小值点和最大值点的时间戳。 | Time Window | `select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017-11-01 00:00:00, 2017-11-07 23:00:00), 3h, 1d)` | https://iotdb.apache.org/UserGuide/Master/Query-Data/Aggregate-Query.html#built-in-aggregate-functions <br />https://iotdb.apache.org/UserGuide/Master/Query-Data/Aggregate-Query.html#downsampling-aggregate-query |
+| 2. EQUAL_SIZE_BUCKET_M4_SAMPLE (内置UDF) | 支持* | Size Window. `windowSize = 4*(int)(1/proportion)` | `select equal_size_bucket_m4_sample(temperature, 'proportion'='0.1') as M4_sample from root.ln.wf01.wt01` | https://iotdb.apache.org/UserGuide/Master/Query-Data/Select-Expression.html#time-series-generating-functions |
+| **3. M4 (内置UDF)** | 支持* | Size Window, Time Window | (1) Size Window: `select M4(s1,'windowSize'='10') from root.vehicle.d1` <br />(2) Time Window: `select M4(s1,'timeInterval'='25','displayWindowBegin'='0','displayWindowEnd'='100') from root.vehicle.d1` | 本文档 |
+| 4. 扩展带有Group By子句的内置聚合函数来支持M4聚合 | 未实施 | 未实施 | 未实施 | 未实施 |
+
+进一步比较`EQUAL_SIZE_BUCKET_M4_SAMPLE`和`M4`:
+
+**(1) 不同的M4聚合函数定义:**
+
+在每个窗口内,`EQUAL_SIZE_BUCKET_M4_SAMPLE`从排除了第一个点和最后一个点之后剩余的点中提取最小值点和最大值点。
+
+而`M4`则是从窗口内所有点中(包括第一个点和最后一个点)提取最小值点和最大值点,这个定义与元数据中保存的`max_value`和`min_value`的语义更加一致。
+
+值得注意的是,在一个窗口内的聚合点输出之前,`EQUAL_SIZE_BUCKET_M4_SAMPLE`和`M4`都会将它们按照时间戳递增排序并且去重。
+
+**(2) 不同的滑动窗口:**
+
+`EQUAL_SIZE_BUCKET_M4_SAMPLE`使用SlidingSizeWindowAccessStrategy,并且通过采样比例(`proportion`)来间接控制窗口点数(`windowSize`),转换公式是`windowSize = 4*(int)(1/proportion)`。
+
+`M4`支持两种滑动窗口:SlidingSizeWindowAccessStrategy和SlidingTimeWindowAccessStrategy,并且`M4`通过相应的参数直接控制窗口的点数或者时长。
+
+
+### 选择函数
+
+目前 IoTDB 支持如下选择函数:
+
+| 函数名 | 输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能描述 |
+| -------- | ------------------------------------- | ------------------------------------------------- | ------------------------ | ------------------------------------------------------------ |
+| TOP_K | INT32 / INT64 / FLOAT / DOUBLE / TEXT | `k`: 最多选择的数据点数,必须大于 0 小于等于 1000 | 与输入序列的实际类型一致 | 返回某时间序列中值最大的`k`个数据点。若多于`k`个数据点的值并列最大,则返回时间戳最小的数据点。 |
+| BOTTOM_K | INT32 / INT64 / FLOAT / DOUBLE / TEXT | `k`: 最多选择的数据点数,必须大于 0 小于等于 1000 | 与输入序列的实际类型一致 | 返回某时间序列中值最小的`k`个数据点。若多于`k`个数据点的值并列最小,则返回时间戳最小的数据点。 |
+
+例如:
+
+``` sql
+select s1, top_k(s1, 'k'='2'), bottom_k(s1, 'k'='2') from root.sg1.d2 where time > 2020-12-10T20:36:15.530+08:00;
+```
+
+结果:
+
+```
++-----------------------------+--------------------+------------------------------+---------------------------------+
+| Time| root.sg1.d2.s1|top_k(root.sg1.d2.s1, "k"="2")|bottom_k(root.sg1.d2.s1, "k"="2")|
++-----------------------------+--------------------+------------------------------+---------------------------------+
+|2020-12-10T20:36:15.531+08:00| 1531604122307244742| 1531604122307244742| null|
+|2020-12-10T20:36:15.532+08:00|-7426070874923281101| null| null|
+|2020-12-10T20:36:15.533+08:00|-7162825364312197604| -7162825364312197604| null|
+|2020-12-10T20:36:15.534+08:00|-8581625725655917595| null| -8581625725655917595|
+|2020-12-10T20:36:15.535+08:00|-7667364751255535391| null| -7667364751255535391|
++-----------------------------+--------------------+------------------------------+---------------------------------+
+Total line number = 5
+It costs 0.006s
+```
+
+
+### 数据画像
+
+#### ACF
+
+##### 函数简介
+
+本函数用于计算时间序列的自相关函数值,即序列与自身之间的互相关函数,详情参见[XCorr](./Data-Matching.md#XCorr)函数文档。
+
+**函数名:** ACF
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列中共包含$2N-1$个数据点,每个值的具体含义参见[XCorr](./Data-Matching.md#XCorr)函数文档。
+
+**提示:**
+
++ 序列中的`NaN`值会被忽略,在计算中表现为0。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:01.000+08:00| 1|
+|2020-01-01T00:00:02.000+08:00| NaN|
+|2020-01-01T00:00:03.000+08:00| 3|
+|2020-01-01T00:00:04.000+08:00| NaN|
+|2020-01-01T00:00:05.000+08:00| 5|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select acf(s1) from root.test.d1 where time <= 2020-01-01 00:00:05
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------+
+| Time|acf(root.test.d1.s1)|
++-----------------------------+--------------------+
+|1970-01-01T08:00:00.001+08:00| 1.0|
+|1970-01-01T08:00:00.002+08:00| 0.0|
+|1970-01-01T08:00:00.003+08:00| 3.6|
+|1970-01-01T08:00:00.004+08:00| 0.0|
+|1970-01-01T08:00:00.005+08:00| 7.0|
+|1970-01-01T08:00:00.006+08:00| 0.0|
+|1970-01-01T08:00:00.007+08:00| 3.6|
+|1970-01-01T08:00:00.008+08:00| 0.0|
+|1970-01-01T08:00:00.009+08:00| 1.0|
++-----------------------------+--------------------+
+```
+
+#### Distinct
+
+##### 函数简介
+
+本函数可以返回输入序列中出现的所有不同的元素。
+
+**函数名:** DISTINCT
+
+**输入序列:** 仅支持单个输入序列,类型可以是任意的
+
+**输出序列:** 输出单个序列,类型与输入相同。
+
+**提示:**
+
++ 输出序列的时间戳是无意义的。输出顺序是任意的。
++ 缺失值和空值将被忽略,但`NaN`不会被忽略。
++ 字符串区分大小写
+
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s2|
++-----------------------------+---------------+
+|2020-01-01T08:00:00.001+08:00| Hello|
+|2020-01-01T08:00:00.002+08:00| hello|
+|2020-01-01T08:00:00.003+08:00| Hello|
+|2020-01-01T08:00:00.004+08:00| World|
+|2020-01-01T08:00:00.005+08:00| World|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select distinct(s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------+
+| Time|distinct(root.test.d2.s2)|
++-----------------------------+-------------------------+
+|1970-01-01T08:00:00.001+08:00| Hello|
+|1970-01-01T08:00:00.002+08:00| hello|
+|1970-01-01T08:00:00.003+08:00| World|
++-----------------------------+-------------------------+
+```
+
+#### Histogram
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的分布直方图。
+
+**函数名:** HISTOGRAM
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `min`:表示所求数据范围的下限,默认值为 -Double.MAX_VALUE。
++ `max`:表示所求数据范围的上限,默认值为 Double.MAX_VALUE,`start`的值必须小于或等于`end`。
++ `count`: 表示直方图分桶的数量,默认值为 1,其值必须为正整数。
+
+**输出序列:** 直方图分桶的值,其中第 i 个桶(从 1 开始计数)表示的数据范围下界为$min+ (i-1)\cdot\frac{max-min}{count}$,数据范围上界为$min+ i \cdot \frac{max-min}{count}$。
+
+
+**提示:**
+
++ 如果某个数据点的数值小于`min`,它会被放入第 1 个桶;如果某个数据点的数值大于`max`,它会被放入最后 1 个桶。
++ 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:00.000+08:00| 1.0|
+|2020-01-01T00:00:01.000+08:00| 2.0|
+|2020-01-01T00:00:02.000+08:00| 3.0|
+|2020-01-01T00:00:03.000+08:00| 4.0|
+|2020-01-01T00:00:04.000+08:00| 5.0|
+|2020-01-01T00:00:05.000+08:00| 6.0|
+|2020-01-01T00:00:06.000+08:00| 7.0|
+|2020-01-01T00:00:07.000+08:00| 8.0|
+|2020-01-01T00:00:08.000+08:00| 9.0|
+|2020-01-01T00:00:09.000+08:00| 10.0|
+|2020-01-01T00:00:10.000+08:00| 11.0|
+|2020-01-01T00:00:11.000+08:00| 12.0|
+|2020-01-01T00:00:12.000+08:00| 13.0|
+|2020-01-01T00:00:13.000+08:00| 14.0|
+|2020-01-01T00:00:14.000+08:00| 15.0|
+|2020-01-01T00:00:15.000+08:00| 16.0|
+|2020-01-01T00:00:16.000+08:00| 17.0|
+|2020-01-01T00:00:17.000+08:00| 18.0|
+|2020-01-01T00:00:18.000+08:00| 19.0|
+|2020-01-01T00:00:19.000+08:00| 20.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select histogram(s1,"min"="1","max"="20","count"="10") from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------------------------------------------+
+| Time|histogram(root.test.d1.s1, "min"="1", "max"="20", "count"="10")|
++-----------------------------+---------------------------------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 2|
+|1970-01-01T08:00:00.001+08:00| 2|
+|1970-01-01T08:00:00.002+08:00| 2|
+|1970-01-01T08:00:00.003+08:00| 2|
+|1970-01-01T08:00:00.004+08:00| 2|
+|1970-01-01T08:00:00.005+08:00| 2|
+|1970-01-01T08:00:00.006+08:00| 2|
+|1970-01-01T08:00:00.007+08:00| 2|
+|1970-01-01T08:00:00.008+08:00| 2|
+|1970-01-01T08:00:00.009+08:00| 2|
++-----------------------------+---------------------------------------------------------------+
+```
+
+#### Integral
+
+##### 函数简介
+
+本函数用于计算时间序列的数值积分,即以时间为横坐标、数值为纵坐标绘制的折线图中折线以下的面积。
+
+**函数名:** INTEGRAL
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `unit`:积分求解所用的时间轴单位,取值为 "1S", "1s", "1m", "1H", "1d"(区分大小写),分别表示以毫秒、秒、分钟、小时、天为单位计算积分。
+ 缺省情况下取 "1s",以秒为单位。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE,序列仅包含一个时间戳为 0、值为积分结果的数据点。
+
+**提示:**
+
++ 积分值等于折线图中每相邻两个数据点和时间轴形成的直角梯形的面积之和,不同时间单位下相当于横轴进行不同倍数放缩,得到的积分值可直接按放缩倍数转换。
+
++ 数据中`NaN`将会被忽略。折线将以临近两个有值数据点为准。
+
+##### 使用示例
+
+###### 参数缺省
+
+缺省情况下积分以1s为时间单位。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:01.000+08:00| 1|
+|2020-01-01T00:00:02.000+08:00| 2|
+|2020-01-01T00:00:03.000+08:00| 5|
+|2020-01-01T00:00:04.000+08:00| 6|
+|2020-01-01T00:00:05.000+08:00| 7|
+|2020-01-01T00:00:08.000+08:00| 8|
+|2020-01-01T00:00:09.000+08:00| NaN|
+|2020-01-01T00:00:10.000+08:00| 10|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select integral(s1) from root.test.d1 where time <= 2020-01-01 00:00:10
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------+
+| Time|integral(root.test.d1.s1)|
++-----------------------------+-------------------------+
+|1970-01-01T08:00:00.000+08:00| 57.5|
++-----------------------------+-------------------------+
+```
+
+其计算公式为:
+$$\frac{1}{2}[(1+2)\times 1 + (2+5) \times 1 + (5+6) \times 1 + (6+7) \times 1 + (7+8) \times 3 + (8+10) \times 2] = 57.5$$
+
+
+##### 指定时间单位
+
+指定以分钟为时间单位。
+
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select integral(s1, "unit"="1m") from root.test.d1 where time <= 2020-01-01 00:00:10
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------+
+| Time|integral(root.test.d1.s1)|
++-----------------------------+-------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.958|
++-----------------------------+-------------------------+
+```
+
+其计算公式为:
+$$\frac{1}{2\times 60}[(1+2) \times 1 + (2+3) \times 1 + (5+6) \times 1 + (6+7) \times 1 + (7+8) \times 3 + (8+10) \times 2] = 0.958$$
+
+#### IntegralAvg
+
+##### 函数简介
+
+本函数用于计算时间序列的函数均值,即在相同时间单位下的数值积分除以序列总的时间跨度。更多关于数值积分计算的信息请参考`Integral`函数。
+
+**函数名:** INTEGRALAVG
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE,序列仅包含一个时间戳为 0、值为时间加权平均结果的数据点。
+
+**提示:**
+
++ 时间加权的平均值等于在任意时间单位`unit`下计算的数值积分(即折线图中每相邻两个数据点和时间轴形成的直角梯形的面积之和),
+ 除以相同时间单位下输入序列的时间跨度,其值与具体采用的时间单位无关,默认与 IoTDB 时间单位一致。
+
++ 数据中的`NaN`将会被忽略。折线将以临近两个有值数据点为准。
+
++ 输入序列为空时,函数输出结果为 0;仅有一个数据点时,输出结果为该点数值。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:01.000+08:00| 1|
+|2020-01-01T00:00:02.000+08:00| 2|
+|2020-01-01T00:00:03.000+08:00| 5|
+|2020-01-01T00:00:04.000+08:00| 6|
+|2020-01-01T00:00:05.000+08:00| 7|
+|2020-01-01T00:00:08.000+08:00| 8|
+|2020-01-01T00:00:09.000+08:00| NaN|
+|2020-01-01T00:00:10.000+08:00| 10|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select integralavg(s1) from root.test.d1 where time <= 2020-01-01 00:00:10
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------+
+| Time|integralavg(root.test.d1.s1)|
++-----------------------------+----------------------------+
+|1970-01-01T08:00:00.000+08:00| 5.75|
++-----------------------------+----------------------------+
+```
+
+其计算公式为:
+$$\frac{1}{2}[(1+2)\times 1 + (2+5) \times 1 + (5+6) \times 1 + (6+7) \times 1 + (7+8) \times 3 + (8+10) \times 2] / 10 = 5.75$$
+
+#### Mad
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的精确或近似绝对中位差,绝对中位差为所有数值与其中位数绝对偏移量的中位数。
+
+如有数据集$\{1,3,3,5,5,6,7,8,9\}$,其中位数为5,所有数值与中位数的偏移量的绝对值为$\{0,0,1,2,2,2,3,4,4\}$,其中位数为2,故而原数据集的绝对中位差为2。
+
+**函数名:** MAD
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `error`:近似绝对中位差的基于数值的误差百分比,取值范围为 [0,1),默认值为 0。如当`error`=0.01 时,记精确绝对中位差为a,近似绝对中位差为b,不等式 $0.99a \le b \le 1.01a$ 成立。当`error`=0 时,计算结果为精确绝对中位差。
+
+
+**输出序列:** 输出单个序列,类型为DOUBLE,序列仅包含一个时间戳为 0、值为绝对中位差的数据点。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+###### 精确查询
+
+当`error`参数缺省或为0时,本函数计算精确绝对中位差。
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|2021-03-17T10:32:17.054+08:00| 0.5319929|
+|2021-03-17T10:32:18.054+08:00| 0.9304316|
+|2021-03-17T10:32:19.054+08:00| -1.4800133|
+|2021-03-17T10:32:20.054+08:00| 0.6114087|
+|2021-03-17T10:32:21.054+08:00| 2.5163336|
+|2021-03-17T10:32:22.054+08:00| -1.0845392|
+|2021-03-17T10:32:23.054+08:00| 1.0562582|
+|2021-03-17T10:32:24.054+08:00| 1.3867859|
+|2021-03-17T10:32:25.054+08:00| -0.45429882|
+|2021-03-17T10:32:26.054+08:00| 1.0353678|
+|2021-03-17T10:32:27.054+08:00| 0.7307929|
+|2021-03-17T10:32:28.054+08:00| 2.3167255|
+|2021-03-17T10:32:29.054+08:00| 2.342443|
+|2021-03-17T10:32:30.054+08:00| 1.5809103|
+|2021-03-17T10:32:31.054+08:00| 1.4829416|
+|2021-03-17T10:32:32.054+08:00| 1.5800357|
+|2021-03-17T10:32:33.054+08:00| 0.7124368|
+|2021-03-17T10:32:34.054+08:00| -0.78597564|
+|2021-03-17T10:32:35.054+08:00| 1.2058644|
+|2021-03-17T10:32:36.054+08:00| 1.4215064|
+|2021-03-17T10:32:37.054+08:00| 1.2808295|
+|2021-03-17T10:32:38.054+08:00| -0.6173715|
+|2021-03-17T10:32:39.054+08:00| 0.06644377|
+|2021-03-17T10:32:40.054+08:00| 2.349338|
+|2021-03-17T10:32:41.054+08:00| 1.7335888|
+|2021-03-17T10:32:42.054+08:00| 1.5872132|
+............
+Total line number = 10000
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select mad(s0) from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------+
+| Time| mad(root.test.s0)|
++-----------------------------+------------------+
+|1970-01-01T08:00:00.000+08:00|0.6806197166442871|
++-----------------------------+------------------+
+```
+
+###### 近似查询
+
+当`error`参数取值不为 0 时,本函数计算近似绝对中位差。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select mad(s0, "error"="0.01") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------------+
+| Time|mad(root.test.s0, "error"="0.01")|
++-----------------------------+---------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.6806616245859518|
++-----------------------------+---------------------------------+
+```
+
+#### Median
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的精确或近似中位数。中位数是顺序排列的一组数据中居于中间位置的数;当序列有偶数个时,中位数为中间二者的平均数。
+
+**函数名:** MEDIAN
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `error`:近似中位数的基于排名的误差百分比,取值范围 [0,1),默认值为 0。如当`error`=0.01 时,计算出的中位数的真实排名百分比在 0.49~0.51 之间。当`error`=0 时,计算结果为精确中位数。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE,序列仅包含一个时间戳为 0、值为中位数的数据点。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|2021-03-17T10:32:17.054+08:00| 0.5319929|
+|2021-03-17T10:32:18.054+08:00| 0.9304316|
+|2021-03-17T10:32:19.054+08:00| -1.4800133|
+|2021-03-17T10:32:20.054+08:00| 0.6114087|
+|2021-03-17T10:32:21.054+08:00| 2.5163336|
+|2021-03-17T10:32:22.054+08:00| -1.0845392|
+|2021-03-17T10:32:23.054+08:00| 1.0562582|
+|2021-03-17T10:32:24.054+08:00| 1.3867859|
+|2021-03-17T10:32:25.054+08:00| -0.45429882|
+|2021-03-17T10:32:26.054+08:00| 1.0353678|
+|2021-03-17T10:32:27.054+08:00| 0.7307929|
+|2021-03-17T10:32:28.054+08:00| 2.3167255|
+|2021-03-17T10:32:29.054+08:00| 2.342443|
+|2021-03-17T10:32:30.054+08:00| 1.5809103|
+|2021-03-17T10:32:31.054+08:00| 1.4829416|
+|2021-03-17T10:32:32.054+08:00| 1.5800357|
+|2021-03-17T10:32:33.054+08:00| 0.7124368|
+|2021-03-17T10:32:34.054+08:00| -0.78597564|
+|2021-03-17T10:32:35.054+08:00| 1.2058644|
+|2021-03-17T10:32:36.054+08:00| 1.4215064|
+|2021-03-17T10:32:37.054+08:00| 1.2808295|
+|2021-03-17T10:32:38.054+08:00| -0.6173715|
+|2021-03-17T10:32:39.054+08:00| 0.06644377|
+|2021-03-17T10:32:40.054+08:00| 2.349338|
+|2021-03-17T10:32:41.054+08:00| 1.7335888|
+|2021-03-17T10:32:42.054+08:00| 1.5872132|
+............
+Total line number = 10000
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select median(s0, "error"="0.01") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------+
+| Time|median(root.test.s0, "error"="0.01")|
++-----------------------------+------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 1.021884560585022|
++-----------------------------+------------------------------------+
+```
+
+#### MinMax
+
+##### 函数简介
+
+本函数将输入序列使用 min-max 方法进行标准化。最小值归一至 0,最大值归一至 1.
+
+**函数名:** MINMAX
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `compute`:若设置为"batch",则将数据全部读入后转换;若设置为 "stream",则需用户提供最大值及最小值进行流式计算转换。默认为 "batch"。
++ `min`:使用流式计算时的最小值。
++ `max`:使用流式计算时的最大值。
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+##### 使用示例
+
+###### 全数据计算
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.100+08:00| 0.0|
+|1970-01-01T08:00:00.200+08:00| 0.0|
+|1970-01-01T08:00:00.300+08:00| 1.0|
+|1970-01-01T08:00:00.400+08:00| -1.0|
+|1970-01-01T08:00:00.500+08:00| 0.0|
+|1970-01-01T08:00:00.600+08:00| 0.0|
+|1970-01-01T08:00:00.700+08:00| -2.0|
+|1970-01-01T08:00:00.800+08:00| 2.0|
+|1970-01-01T08:00:00.900+08:00| 0.0|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 1.0|
+|1970-01-01T08:00:01.200+08:00| -1.0|
+|1970-01-01T08:00:01.300+08:00| -1.0|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 0.0|
+|1970-01-01T08:00:01.600+08:00| 0.0|
+|1970-01-01T08:00:01.700+08:00| 10.0|
+|1970-01-01T08:00:01.800+08:00| 2.0|
+|1970-01-01T08:00:01.900+08:00| -2.0|
+|1970-01-01T08:00:02.000+08:00| 0.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select minmax(s1) from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------+
+| Time|minmax(root.test.s1)|
++-----------------------------+--------------------+
+|1970-01-01T08:00:00.100+08:00| 0.16666666666666666|
+|1970-01-01T08:00:00.200+08:00| 0.16666666666666666|
+|1970-01-01T08:00:00.300+08:00| 0.25|
+|1970-01-01T08:00:00.400+08:00| 0.08333333333333333|
+|1970-01-01T08:00:00.500+08:00| 0.16666666666666666|
+|1970-01-01T08:00:00.600+08:00| 0.16666666666666666|
+|1970-01-01T08:00:00.700+08:00| 0.0|
+|1970-01-01T08:00:00.800+08:00| 0.3333333333333333|
+|1970-01-01T08:00:00.900+08:00| 0.16666666666666666|
+|1970-01-01T08:00:01.000+08:00| 0.16666666666666666|
+|1970-01-01T08:00:01.100+08:00| 0.25|
+|1970-01-01T08:00:01.200+08:00| 0.08333333333333333|
+|1970-01-01T08:00:01.300+08:00| 0.08333333333333333|
+|1970-01-01T08:00:01.400+08:00| 0.25|
+|1970-01-01T08:00:01.500+08:00| 0.16666666666666666|
+|1970-01-01T08:00:01.600+08:00| 0.16666666666666666|
+|1970-01-01T08:00:01.700+08:00| 1.0|
+|1970-01-01T08:00:01.800+08:00| 0.3333333333333333|
+|1970-01-01T08:00:01.900+08:00| 0.0|
+|1970-01-01T08:00:02.000+08:00| 0.16666666666666666|
++-----------------------------+--------------------+
+```
+
+#### Mode
+
+##### 函数简介
+
+本函数用于计算时间序列的众数,即出现次数最多的元素。
+
+**函数名:** MODE
+
+**输入序列:** 仅支持单个输入序列,类型可以是任意的。
+
+**输出序列:** 输出单个序列,类型与输入相同,序列仅包含一个时间戳为众数第一次出现的时间戳、值为众数的数据点。
+
+**提示:**
+
++ 如果有多个出现次数最多的元素,将会输出任意一个。
++ 数据中的空值和缺失值将会被忽略,但`NaN`不会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s2|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.001+08:00| Hello|
+|1970-01-01T08:00:00.002+08:00| hello|
+|1970-01-01T08:00:00.003+08:00| Hello|
+|1970-01-01T08:00:00.004+08:00| World|
+|1970-01-01T08:00:00.005+08:00| World|
+|1970-01-01T08:00:01.600+08:00| World|
+|1970-01-15T09:37:34.451+08:00| Hello|
+|1970-01-15T09:37:34.452+08:00| hello|
+|1970-01-15T09:37:34.453+08:00| Hello|
+|1970-01-15T09:37:34.454+08:00| World|
+|1970-01-15T09:37:34.455+08:00| World|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select mode(s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------+
+| Time|mode(root.test.d2.s2)|
++-----------------------------+---------------------+
+|1970-01-01T08:00:00.004+08:00| World|
++-----------------------------+---------------------+
+```
+
+#### MvAvg
+
+##### 函数简介
+
+本函数计算序列的移动平均。
+
+**函数名:** MVAVG
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `window`:移动窗口的长度。默认值为 10.
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+##### 使用示例
+
+###### 指定窗口长度
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.100+08:00| 0.0|
+|1970-01-01T08:00:00.200+08:00| 0.0|
+|1970-01-01T08:00:00.300+08:00| 1.0|
+|1970-01-01T08:00:00.400+08:00| -1.0|
+|1970-01-01T08:00:00.500+08:00| 0.0|
+|1970-01-01T08:00:00.600+08:00| 0.0|
+|1970-01-01T08:00:00.700+08:00| -2.0|
+|1970-01-01T08:00:00.800+08:00| 2.0|
+|1970-01-01T08:00:00.900+08:00| 0.0|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 1.0|
+|1970-01-01T08:00:01.200+08:00| -1.0|
+|1970-01-01T08:00:01.300+08:00| -1.0|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 0.0|
+|1970-01-01T08:00:01.600+08:00| 0.0|
+|1970-01-01T08:00:01.700+08:00| 10.0|
+|1970-01-01T08:00:01.800+08:00| 2.0|
+|1970-01-01T08:00:01.900+08:00| -2.0|
+|1970-01-01T08:00:02.000+08:00| 0.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select mvavg(s1, "window"="3") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------------+
+| Time|mvavg(root.test.s1, "window"="3")|
++-----------------------------+---------------------------------+
+|1970-01-01T08:00:00.300+08:00| 0.3333333333333333|
+|1970-01-01T08:00:00.400+08:00| 0.0|
+|1970-01-01T08:00:00.500+08:00| -0.3333333333333333|
+|1970-01-01T08:00:00.600+08:00| 0.0|
+|1970-01-01T08:00:00.700+08:00| -0.6666666666666666|
+|1970-01-01T08:00:00.800+08:00| 0.0|
+|1970-01-01T08:00:00.900+08:00| 0.6666666666666666|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 0.3333333333333333|
+|1970-01-01T08:00:01.200+08:00| 0.0|
+|1970-01-01T08:00:01.300+08:00| -0.6666666666666666|
+|1970-01-01T08:00:01.400+08:00| 0.0|
+|1970-01-01T08:00:01.500+08:00| 0.3333333333333333|
+|1970-01-01T08:00:01.600+08:00| 0.0|
+|1970-01-01T08:00:01.700+08:00| 3.3333333333333335|
+|1970-01-01T08:00:01.800+08:00| 4.0|
+|1970-01-01T08:00:01.900+08:00| 0.0|
+|1970-01-01T08:00:02.000+08:00| -0.6666666666666666|
++-----------------------------+---------------------------------+
+```
+
+#### PACF
+
+##### 函数简介
+
+本函数通过求解 Yule-Walker 方程,计算序列的偏自相关系数。对于特殊的输入序列,方程可能没有解,此时输出`NaN`。
+
+**函数名:** PACF
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `lag`:最大滞后阶数。默认值为$\min(10\log_{10}n,n-1)$,$n$表示数据点个数。
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+##### 使用示例
+
+###### 指定滞后阶数
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|2019-12-27T00:00:00.000+08:00| 5.0|
+|2019-12-27T00:05:00.000+08:00| 5.0|
+|2019-12-27T00:10:00.000+08:00| 5.0|
+|2019-12-27T00:15:00.000+08:00| 5.0|
+|2019-12-27T00:20:00.000+08:00| 6.0|
+|2019-12-27T00:25:00.000+08:00| 5.0|
+|2019-12-27T00:30:00.000+08:00| 6.0|
+|2019-12-27T00:35:00.000+08:00| 6.0|
+|2019-12-27T00:40:00.000+08:00| 6.0|
+|2019-12-27T00:45:00.000+08:00| 6.0|
+|2019-12-27T00:50:00.000+08:00| 6.0|
+|2019-12-27T00:55:00.000+08:00| 5.982609|
+|2019-12-27T01:00:00.000+08:00| 5.9652176|
+|2019-12-27T01:05:00.000+08:00| 5.947826|
+|2019-12-27T01:10:00.000+08:00| 5.9304347|
+|2019-12-27T01:15:00.000+08:00| 5.9130435|
+|2019-12-27T01:20:00.000+08:00| 5.8956523|
+|2019-12-27T01:25:00.000+08:00| 5.878261|
+|2019-12-27T01:30:00.000+08:00| 5.8608694|
+|2019-12-27T01:35:00.000+08:00| 5.843478|
+............
+Total line number = 18066
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select pacf(s1, "lag"="5") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------------+
+| Time|pacf(root.test.s1, "lag"="5")|
++-----------------------------+-----------------------------+
+|2019-12-27T00:00:00.000+08:00| 1.0|
+|2019-12-27T00:05:00.000+08:00| 0.3528915091942786|
+|2019-12-27T00:10:00.000+08:00| 0.1761346122516304|
+|2019-12-27T00:15:00.000+08:00| 0.1492391973294682|
+|2019-12-27T00:20:00.000+08:00| 0.03560059645868398|
+|2019-12-27T00:25:00.000+08:00| 0.0366222998995286|
++-----------------------------+-----------------------------+
+```
+
+#### Percentile
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的精确或近似分位数。
+
+**函数名:** PERCENTILE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `rank`:所求分位数在所有数据中的排名百分比,取值范围为 (0,1],默认值为 0.5。如当设为 0.5时则计算中位数。
++ `error`:近似分位数的基于排名的误差百分比,取值范围为 [0,1),默认值为0。如`rank`=0.5 且`error`=0.01,则计算出的分位数的真实排名百分比在 0.49~0.51之间。当`error`=0 时,计算结果为精确分位数。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。当`error`=0时,序列仅包含一个时间戳为分位数第一次出现的时间戳、值为分位数的数据点;否则,输出值的时间戳为0。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|2021-03-17T10:32:17.054+08:00| 0.5319929|
+|2021-03-17T10:32:18.054+08:00| 0.9304316|
+|2021-03-17T10:32:19.054+08:00| -1.4800133|
+|2021-03-17T10:32:20.054+08:00| 0.6114087|
+|2021-03-17T10:32:21.054+08:00| 2.5163336|
+|2021-03-17T10:32:22.054+08:00| -1.0845392|
+|2021-03-17T10:32:23.054+08:00| 1.0562582|
+|2021-03-17T10:32:24.054+08:00| 1.3867859|
+|2021-03-17T10:32:25.054+08:00| -0.45429882|
+|2021-03-17T10:32:26.054+08:00| 1.0353678|
+|2021-03-17T10:32:27.054+08:00| 0.7307929|
+|2021-03-17T10:32:28.054+08:00| 2.3167255|
+|2021-03-17T10:32:29.054+08:00| 2.342443|
+|2021-03-17T10:32:30.054+08:00| 1.5809103|
+|2021-03-17T10:32:31.054+08:00| 1.4829416|
+|2021-03-17T10:32:32.054+08:00| 1.5800357|
+|2021-03-17T10:32:33.054+08:00| 0.7124368|
+|2021-03-17T10:32:34.054+08:00| -0.78597564|
+|2021-03-17T10:32:35.054+08:00| 1.2058644|
+|2021-03-17T10:32:36.054+08:00| 1.4215064|
+|2021-03-17T10:32:37.054+08:00| 1.2808295|
+|2021-03-17T10:32:38.054+08:00| -0.6173715|
+|2021-03-17T10:32:39.054+08:00| 0.06644377|
+|2021-03-17T10:32:40.054+08:00| 2.349338|
+|2021-03-17T10:32:41.054+08:00| 1.7335888|
+|2021-03-17T10:32:42.054+08:00| 1.5872132|
+............
+Total line number = 10000
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select percentile(s0, "rank"="0.2", "error"="0.01") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|percentile(root.test.s0, "rank"="0.2", "error"="0.01")|
++-----------------------------+------------------------------------------------------+
+|2021-03-17T10:35:02.054+08:00| 0.1801469624042511|
++-----------------------------+------------------------------------------------------+
+```
+
+#### Quantile
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的近似分位数。本函数基于KLL sketch算法实现。
+
+**函数名:** QUANTILE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `rank`:所求分位数在所有数据中的排名比,取值范围为 (0,1],默认值为 0.5。如当设为 0.5时则计算近似中位数。
++ `K`:允许维护的KLL sketch大小,最小值为100,默认值为800。如`rank`=0.5 且`K`=800,则计算出的分位数的真实排名比有至少99%的可能性在 0.49~0.51之间。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。输出值的时间戳为0。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|2021-03-17T10:32:17.054+08:00| 0.5319929|
+|2021-03-17T10:32:18.054+08:00| 0.9304316|
+|2021-03-17T10:32:19.054+08:00| -1.4800133|
+|2021-03-17T10:32:20.054+08:00| 0.6114087|
+|2021-03-17T10:32:21.054+08:00| 2.5163336|
+|2021-03-17T10:32:22.054+08:00| -1.0845392|
+|2021-03-17T10:32:23.054+08:00| 1.0562582|
+|2021-03-17T10:32:24.054+08:00| 1.3867859|
+|2021-03-17T10:32:25.054+08:00| -0.45429882|
+|2021-03-17T10:32:26.054+08:00| 1.0353678|
+|2021-03-17T10:32:27.054+08:00| 0.7307929|
+|2021-03-17T10:32:28.054+08:00| 2.3167255|
+|2021-03-17T10:32:29.054+08:00| 2.342443|
+|2021-03-17T10:32:30.054+08:00| 1.5809103|
+|2021-03-17T10:32:31.054+08:00| 1.4829416|
+|2021-03-17T10:32:32.054+08:00| 1.5800357|
+|2021-03-17T10:32:33.054+08:00| 0.7124368|
+|2021-03-17T10:32:34.054+08:00| -0.78597564|
+|2021-03-17T10:32:35.054+08:00| 1.2058644|
+|2021-03-17T10:32:36.054+08:00| 1.4215064|
+|2021-03-17T10:32:37.054+08:00| 1.2808295|
+|2021-03-17T10:32:38.054+08:00| -0.6173715|
+|2021-03-17T10:32:39.054+08:00| 0.06644377|
+|2021-03-17T10:32:40.054+08:00| 2.349338|
+|2021-03-17T10:32:41.054+08:00| 1.7335888|
+|2021-03-17T10:32:42.054+08:00| 1.5872132|
+............
+Total line number = 10000
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select quantile(s0, "rank"="0.2", "K"="800") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|quantile(root.test.s0, "rank"="0.2", "K"="800")|
++-----------------------------+------------------------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.1801469624042511|
++-----------------------------+------------------------------------------------------+
+```
+
+#### Period
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的周期。
+
+**函数名:** PERIOD
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**输出序列:** 输出单个序列,类型为 INT32,序列仅包含一个时间戳为 0、值为周期的数据点。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d3.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.001+08:00| 1.0|
+|1970-01-01T08:00:00.002+08:00| 2.0|
+|1970-01-01T08:00:00.003+08:00| 3.0|
+|1970-01-01T08:00:00.004+08:00| 1.0|
+|1970-01-01T08:00:00.005+08:00| 2.0|
+|1970-01-01T08:00:00.006+08:00| 3.0|
+|1970-01-01T08:00:00.007+08:00| 1.0|
+|1970-01-01T08:00:00.008+08:00| 2.0|
+|1970-01-01T08:00:00.009+08:00| 3.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select period(s1) from root.test.d3
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------+
+| Time|period(root.test.d3.s1)|
++-----------------------------+-----------------------+
+|1970-01-01T08:00:00.000+08:00| 3|
++-----------------------------+-----------------------+
+```
+
+#### QLB
+
+##### 函数简介
+
+本函数对输入序列计算$Q_{LB} $统计量,并计算对应的p值。p值越小表明序列越有可能为非平稳序列。
+
+**函数名:** QLB
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `lag`:计算时用到的最大延迟阶数,取值应为 1 至 n-2 之间的整数,n 为序列采样总数。默认取 n-2。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。该序列是$Q_{LB} $统计量对应的 p 值,时间标签代表偏移阶数。
+
+**提示:** $Q_{LB} $统计量由自相关系数求得,如需得到统计量而非 p 值,可以使用 ACF 函数。
+
+##### 使用示例
+
+###### 使用默认参数
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T00:00:00.100+08:00| 1.22|
+|1970-01-01T00:00:00.200+08:00| -2.78|
+|1970-01-01T00:00:00.300+08:00| 1.53|
+|1970-01-01T00:00:00.400+08:00| 0.70|
+|1970-01-01T00:00:00.500+08:00| 0.75|
+|1970-01-01T00:00:00.600+08:00| -0.72|
+|1970-01-01T00:00:00.700+08:00| -0.22|
+|1970-01-01T00:00:00.800+08:00| 0.28|
+|1970-01-01T00:00:00.900+08:00| 0.57|
+|1970-01-01T00:00:01.000+08:00| -0.22|
+|1970-01-01T00:00:01.100+08:00| -0.72|
+|1970-01-01T00:00:01.200+08:00| 1.34|
+|1970-01-01T00:00:01.300+08:00| -0.25|
+|1970-01-01T00:00:01.400+08:00| 0.17|
+|1970-01-01T00:00:01.500+08:00| 2.51|
+|1970-01-01T00:00:01.600+08:00| 1.42|
+|1970-01-01T00:00:01.700+08:00| -1.34|
+|1970-01-01T00:00:01.800+08:00| -0.01|
+|1970-01-01T00:00:01.900+08:00| -0.49|
+|1970-01-01T00:00:02.000+08:00| 1.63|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select QLB(s1) from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------+
+| Time|QLB(root.test.d1.s1)|
++-----------------------------+--------------------+
+|1970-01-01T00:00:00.001+08:00| 0.2168702295315677|
+|1970-01-01T00:00:00.002+08:00| 0.3068948509261751|
+|1970-01-01T00:00:00.003+08:00| 0.4217859150918444|
+|1970-01-01T00:00:00.004+08:00| 0.5114539874276656|
+|1970-01-01T00:00:00.005+08:00| 0.6560619525616759|
+|1970-01-01T00:00:00.006+08:00| 0.7722398654053280|
+|1970-01-01T00:00:00.007+08:00| 0.8532491661465290|
+|1970-01-01T00:00:00.008+08:00| 0.9028575017542528|
+|1970-01-01T00:00:00.009+08:00| 0.9434989988192729|
+|1970-01-01T00:00:00.010+08:00| 0.8950280161464689|
+|1970-01-01T00:00:00.011+08:00| 0.7701048398839656|
+|1970-01-01T00:00:00.012+08:00| 0.7845536060001281|
+|1970-01-01T00:00:00.013+08:00| 0.5943030981705825|
+|1970-01-01T00:00:00.014+08:00| 0.4618413512531093|
+|1970-01-01T00:00:00.015+08:00| 0.2645948244673964|
+|1970-01-01T00:00:00.016+08:00| 0.3167530476666645|
+|1970-01-01T00:00:00.017+08:00| 0.2330010780351453|
+|1970-01-01T00:00:00.018+08:00| 0.0666611237622325|
++-----------------------------+--------------------+
+```
+
+#### Resample
+
+##### 函数简介
+
+本函数对输入序列按照指定的频率进行重采样,包括上采样和下采样。目前,本函数支持的上采样方法包括`NaN`填充法 (NaN)、前值填充法 (FFill)、后值填充法 (BFill) 以及线性插值法 (Linear);本函数支持的下采样方法为分组聚合,聚合方法包括最大值 (Max)、最小值 (Min)、首值 (First)、末值 (Last)、平均值 (Mean)和中位数 (Median)。
+
+**函数名:** RESAMPLE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `every`:重采样频率,是一个有单位的正数。目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。该参数不允许缺省。
++ `interp`:上采样的插值方法,取值为 'NaN'、'FFill'、'BFill' 或 'Linear'。在缺省情况下,使用`NaN`填充法。
++ `aggr`:下采样的聚合方法,取值为 'Max'、'Min'、'First'、'Last'、'Mean' 或 'Median'。在缺省情况下,使用平均数聚合。
++ `start`:重采样的起始时间(包含),是一个格式为 'yyyy-MM-dd HH:mm:ss' 的时间字符串。在缺省情况下,使用第一个有效数据点的时间戳。
++ `end`:重采样的结束时间(不包含),是一个格式为 'yyyy-MM-dd HH:mm:ss' 的时间字符串。在缺省情况下,使用最后一个有效数据点的时间戳。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。该序列按照重采样频率严格等间隔分布。
+
+**提示:** 数据中的`NaN`将会被忽略。
+
+##### 使用示例
+
+###### 上采样
+
+当重采样频率高于数据原始频率时,将会进行上采样。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2021-03-06T16:00:00.000+08:00| 3.09|
+|2021-03-06T16:15:00.000+08:00| 3.53|
+|2021-03-06T16:30:00.000+08:00| 3.5|
+|2021-03-06T16:45:00.000+08:00| 3.51|
+|2021-03-06T17:00:00.000+08:00| 3.41|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select resample(s1,'every'='5m','interp'='linear') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------------------------------------+
+| Time|resample(root.test.d1.s1, "every"="5m", "interp"="linear")|
++-----------------------------+----------------------------------------------------------+
+|2021-03-06T16:00:00.000+08:00| 3.0899999141693115|
+|2021-03-06T16:05:00.000+08:00| 3.2366665999094644|
+|2021-03-06T16:10:00.000+08:00| 3.3833332856496177|
+|2021-03-06T16:15:00.000+08:00| 3.5299999713897705|
+|2021-03-06T16:20:00.000+08:00| 3.5199999809265137|
+|2021-03-06T16:25:00.000+08:00| 3.509999990463257|
+|2021-03-06T16:30:00.000+08:00| 3.5|
+|2021-03-06T16:35:00.000+08:00| 3.503333330154419|
+|2021-03-06T16:40:00.000+08:00| 3.506666660308838|
+|2021-03-06T16:45:00.000+08:00| 3.509999990463257|
+|2021-03-06T16:50:00.000+08:00| 3.4766666889190674|
+|2021-03-06T16:55:00.000+08:00| 3.443333387374878|
+|2021-03-06T17:00:00.000+08:00| 3.4100000858306885|
++-----------------------------+----------------------------------------------------------+
+```
+
+###### 下采样
+
+当重采样频率低于数据原始频率时,将会进行下采样。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select resample(s1,'every'='30m','aggr'='first') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------------------+
+| Time|resample(root.test.d1.s1, "every"="30m", "aggr"="first")|
++-----------------------------+--------------------------------------------------------+
+|2021-03-06T16:00:00.000+08:00| 3.0899999141693115|
+|2021-03-06T16:30:00.000+08:00| 3.5|
+|2021-03-06T17:00:00.000+08:00| 3.4100000858306885|
++-----------------------------+--------------------------------------------------------+
+```
+
+
+###### 指定重采样时间段
+
+可以使用`start`和`end`两个参数指定重采样的时间段,超出实际时间范围的部分会被插值填补。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select resample(s1,'every'='30m','start'='2021-03-06 15:00:00') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------------------------------------------------------+
+| Time|resample(root.test.d1.s1, "every"="30m", "start"="2021-03-06 15:00:00")|
++-----------------------------+-----------------------------------------------------------------------+
+|2021-03-06T15:00:00.000+08:00| NaN|
+|2021-03-06T15:30:00.000+08:00| NaN|
+|2021-03-06T16:00:00.000+08:00| 3.309999942779541|
+|2021-03-06T16:30:00.000+08:00| 3.5049999952316284|
+|2021-03-06T17:00:00.000+08:00| 3.4100000858306885|
++-----------------------------+-----------------------------------------------------------------------+
+```
+
+#### Sample
+
+##### 函数简介
+
+本函数对输入序列进行采样,即从输入序列中选取指定数量的数据点并输出。目前,本函数支持三种采样方法:**蓄水池采样法 (reservoir sampling)** 对数据进行随机采样,所有数据点被采样的概率相同;**等距采样法 (isometric sampling)** 按照相等的索引间隔对数据进行采样,**最大三角采样法 (triangle sampling)** 对所有数据会按采样率分桶,每个桶内会计算数据点间三角形面积,并保留面积最大的点,该算法通常用于数据的可视化展示中,采用过程可以保证一些关键的突变点在采用中得到保留,更多抽样算法细节可以阅读论文 [here](http://skemman.is/stream/get/1946/15343/37285/3/SS_MSthesis.pdf)。
+
+**函数名:** SAMPLE
+
+**输入序列:** 仅支持单个输入序列,类型可以是任意的。
+
+**参数:**
+
++ `method`:采样方法,取值为 'reservoir','isometric' 或 'triangle' 。在缺省情况下,采用蓄水池采样法。
++ `k`:采样数,它是一个正整数,在缺省情况下为 1。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。该序列的长度为采样数,序列中的每一个数据点都来自于输入序列。
+
+**提示:** 如果采样数大于序列长度,那么输入序列中所有的数据点都会被输出。
+
+##### 使用示例
+
+
+###### 蓄水池采样
+
+当`method`参数为 'reservoir' 或缺省时,采用蓄水池采样法对输入序列进行采样。由于该采样方法具有随机性,下面展示的输出序列只是一种可能的结果。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:01.000+08:00| 1.0|
+|2020-01-01T00:00:02.000+08:00| 2.0|
+|2020-01-01T00:00:03.000+08:00| 3.0|
+|2020-01-01T00:00:04.000+08:00| 4.0|
+|2020-01-01T00:00:05.000+08:00| 5.0|
+|2020-01-01T00:00:06.000+08:00| 6.0|
+|2020-01-01T00:00:07.000+08:00| 7.0|
+|2020-01-01T00:00:08.000+08:00| 8.0|
+|2020-01-01T00:00:09.000+08:00| 9.0|
+|2020-01-01T00:00:10.000+08:00| 10.0|
++-----------------------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select sample(s1,'method'='reservoir','k'='5') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|sample(root.test.d1.s1, "method"="reservoir", "k"="5")|
++-----------------------------+------------------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 2.0|
+|2020-01-01T00:00:03.000+08:00| 3.0|
+|2020-01-01T00:00:05.000+08:00| 5.0|
+|2020-01-01T00:00:08.000+08:00| 8.0|
+|2020-01-01T00:00:10.000+08:00| 10.0|
++-----------------------------+------------------------------------------------------+
+```
+
+
+###### 等距采样
+
+当`method`参数为 'isometric' 时,采用等距采样法对输入序列进行采样。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select sample(s1,'method'='isometric','k'='5') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|sample(root.test.d1.s1, "method"="isometric", "k"="5")|
++-----------------------------+------------------------------------------------------+
+|2020-01-01T00:00:01.000+08:00| 1.0|
+|2020-01-01T00:00:03.000+08:00| 3.0|
+|2020-01-01T00:00:05.000+08:00| 5.0|
+|2020-01-01T00:00:07.000+08:00| 7.0|
+|2020-01-01T00:00:09.000+08:00| 9.0|
++-----------------------------+------------------------------------------------------+
+```
+
+#### Segment
+
+##### 函数简介
+
+本函数按照数据的线性变化趋势将数据划分为多个子序列,返回分段直线拟合后的子序列首值或所有拟合值。
+
+**函数名:** SEGMENT
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `output`:"all" 输出所有拟合值;"first" 输出子序列起点拟合值。默认为 "first"。
+
++ `error`:判定存在线性趋势的误差允许阈值。误差的定义为子序列进行线性拟合的误差的绝对值的均值。默认为 0.1.
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。
+
+**提示:** 函数默认所有数据等时间间隔分布。函数读取所有数据,若原始数据过多,请先进行降采样处理。拟合采用自底向上方法,子序列的尾值可能会被认作子序列首值输出。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.000+08:00| 5.0|
+|1970-01-01T08:00:00.100+08:00| 0.0|
+|1970-01-01T08:00:00.200+08:00| 1.0|
+|1970-01-01T08:00:00.300+08:00| 2.0|
+|1970-01-01T08:00:00.400+08:00| 3.0|
+|1970-01-01T08:00:00.500+08:00| 4.0|
+|1970-01-01T08:00:00.600+08:00| 5.0|
+|1970-01-01T08:00:00.700+08:00| 6.0|
+|1970-01-01T08:00:00.800+08:00| 7.0|
+|1970-01-01T08:00:00.900+08:00| 8.0|
+|1970-01-01T08:00:01.000+08:00| 9.0|
+|1970-01-01T08:00:01.100+08:00| 9.1|
+|1970-01-01T08:00:01.200+08:00| 9.2|
+|1970-01-01T08:00:01.300+08:00| 9.3|
+|1970-01-01T08:00:01.400+08:00| 9.4|
+|1970-01-01T08:00:01.500+08:00| 9.5|
+|1970-01-01T08:00:01.600+08:00| 9.6|
+|1970-01-01T08:00:01.700+08:00| 9.7|
+|1970-01-01T08:00:01.800+08:00| 9.8|
+|1970-01-01T08:00:01.900+08:00| 9.9|
+|1970-01-01T08:00:02.000+08:00| 10.0|
+|1970-01-01T08:00:02.100+08:00| 8.0|
+|1970-01-01T08:00:02.200+08:00| 6.0|
+|1970-01-01T08:00:02.300+08:00| 4.0|
+|1970-01-01T08:00:02.400+08:00| 2.0|
+|1970-01-01T08:00:02.500+08:00| 0.0|
+|1970-01-01T08:00:02.600+08:00| -2.0|
+|1970-01-01T08:00:02.700+08:00| -4.0|
+|1970-01-01T08:00:02.800+08:00| -6.0|
+|1970-01-01T08:00:02.900+08:00| -8.0|
+|1970-01-01T08:00:03.000+08:00| -10.0|
+|1970-01-01T08:00:03.100+08:00| 10.0|
+|1970-01-01T08:00:03.200+08:00| 10.0|
+|1970-01-01T08:00:03.300+08:00| 10.0|
+|1970-01-01T08:00:03.400+08:00| 10.0|
+|1970-01-01T08:00:03.500+08:00| 10.0|
+|1970-01-01T08:00:03.600+08:00| 10.0|
+|1970-01-01T08:00:03.700+08:00| 10.0|
+|1970-01-01T08:00:03.800+08:00| 10.0|
+|1970-01-01T08:00:03.900+08:00| 10.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select segment(s1,"error"="0.1") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------+
+| Time|segment(root.test.s1, "error"="0.1")|
++-----------------------------+------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 5.0|
+|1970-01-01T08:00:00.200+08:00| 1.0|
+|1970-01-01T08:00:01.000+08:00| 9.0|
+|1970-01-01T08:00:02.000+08:00| 10.0|
+|1970-01-01T08:00:03.000+08:00| -10.0|
+|1970-01-01T08:00:03.200+08:00| 10.0|
++-----------------------------+------------------------------------+
+```
+
+#### Skew
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的总体偏度
+
+**函数名:** SKEW
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**输出序列:** 输出单个序列,类型为 DOUBLE,序列仅包含一个时间戳为 0、值为总体偏度的数据点。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:00.000+08:00| 1.0|
+|2020-01-01T00:00:01.000+08:00| 2.0|
+|2020-01-01T00:00:02.000+08:00| 3.0|
+|2020-01-01T00:00:03.000+08:00| 4.0|
+|2020-01-01T00:00:04.000+08:00| 5.0|
+|2020-01-01T00:00:05.000+08:00| 6.0|
+|2020-01-01T00:00:06.000+08:00| 7.0|
+|2020-01-01T00:00:07.000+08:00| 8.0|
+|2020-01-01T00:00:08.000+08:00| 9.0|
+|2020-01-01T00:00:09.000+08:00| 10.0|
+|2020-01-01T00:00:10.000+08:00| 10.0|
+|2020-01-01T00:00:11.000+08:00| 10.0|
+|2020-01-01T00:00:12.000+08:00| 10.0|
+|2020-01-01T00:00:13.000+08:00| 10.0|
+|2020-01-01T00:00:14.000+08:00| 10.0|
+|2020-01-01T00:00:15.000+08:00| 10.0|
+|2020-01-01T00:00:16.000+08:00| 10.0|
+|2020-01-01T00:00:17.000+08:00| 10.0|
+|2020-01-01T00:00:18.000+08:00| 10.0|
+|2020-01-01T00:00:19.000+08:00| 10.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select skew(s1) from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------+
+| Time| skew(root.test.d1.s1)|
++-----------------------------+-----------------------+
+|1970-01-01T08:00:00.000+08:00| -0.9998427402292644|
++-----------------------------+-----------------------+
+```
+
+#### Spline
+
+##### 函数简介
+
+本函数提供对原始序列进行三次样条曲线拟合后的插值重采样。
+
+**函数名:** SPLINE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `points`:重采样个数。
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+**提示**:输出序列保留输入序列的首尾值,等时间间隔采样。仅当输入点个数不少于 4 个时才计算插值。
+
+##### 使用示例
+
+###### 指定插值个数
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.300+08:00| 1.2|
+|1970-01-01T08:00:00.500+08:00| 1.7|
+|1970-01-01T08:00:00.700+08:00| 2.0|
+|1970-01-01T08:00:00.900+08:00| 2.1|
+|1970-01-01T08:00:01.100+08:00| 2.0|
+|1970-01-01T08:00:01.200+08:00| 1.8|
+|1970-01-01T08:00:01.300+08:00| 1.2|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 1.6|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select spline(s1, "points"="151") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------+
+| Time|spline(root.test.s1, "points"="151")|
++-----------------------------+------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.010+08:00| 0.04870000251134237|
+|1970-01-01T08:00:00.020+08:00| 0.09680000495910646|
+|1970-01-01T08:00:00.030+08:00| 0.14430000734329226|
+|1970-01-01T08:00:00.040+08:00| 0.19120000966389972|
+|1970-01-01T08:00:00.050+08:00| 0.23750001192092896|
+|1970-01-01T08:00:00.060+08:00| 0.2832000141143799|
+|1970-01-01T08:00:00.070+08:00| 0.32830001624425253|
+|1970-01-01T08:00:00.080+08:00| 0.3728000183105469|
+|1970-01-01T08:00:00.090+08:00| 0.416700020313263|
+|1970-01-01T08:00:00.100+08:00| 0.4600000222524008|
+|1970-01-01T08:00:00.110+08:00| 0.5027000241279602|
+|1970-01-01T08:00:00.120+08:00| 0.5448000259399414|
+|1970-01-01T08:00:00.130+08:00| 0.5863000276883443|
+|1970-01-01T08:00:00.140+08:00| 0.627200029373169|
+|1970-01-01T08:00:00.150+08:00| 0.6675000309944153|
+|1970-01-01T08:00:00.160+08:00| 0.7072000325520833|
+|1970-01-01T08:00:00.170+08:00| 0.7463000340461731|
+|1970-01-01T08:00:00.180+08:00| 0.7848000354766846|
+|1970-01-01T08:00:00.190+08:00| 0.8227000368436178|
+|1970-01-01T08:00:00.200+08:00| 0.8600000381469728|
+|1970-01-01T08:00:00.210+08:00| 0.8967000393867494|
+|1970-01-01T08:00:00.220+08:00| 0.9328000405629477|
+|1970-01-01T08:00:00.230+08:00| 0.9683000416755676|
+|1970-01-01T08:00:00.240+08:00| 1.0032000427246095|
+|1970-01-01T08:00:00.250+08:00| 1.037500043710073|
+|1970-01-01T08:00:00.260+08:00| 1.071200044631958|
+|1970-01-01T08:00:00.270+08:00| 1.1043000454902647|
+|1970-01-01T08:00:00.280+08:00| 1.1368000462849934|
+|1970-01-01T08:00:00.290+08:00| 1.1687000470161437|
+|1970-01-01T08:00:00.300+08:00| 1.2000000476837158|
+|1970-01-01T08:00:00.310+08:00| 1.2307000483103594|
+|1970-01-01T08:00:00.320+08:00| 1.2608000489139557|
+|1970-01-01T08:00:00.330+08:00| 1.2903000494873524|
+|1970-01-01T08:00:00.340+08:00| 1.3192000500233967|
+|1970-01-01T08:00:00.350+08:00| 1.3475000505149364|
+|1970-01-01T08:00:00.360+08:00| 1.3752000509548186|
+|1970-01-01T08:00:00.370+08:00| 1.402300051335891|
+|1970-01-01T08:00:00.380+08:00| 1.4288000516510009|
+|1970-01-01T08:00:00.390+08:00| 1.4547000518929958|
+|1970-01-01T08:00:00.400+08:00| 1.480000052054723|
+|1970-01-01T08:00:00.410+08:00| 1.5047000521290301|
+|1970-01-01T08:00:00.420+08:00| 1.5288000521087646|
+|1970-01-01T08:00:00.430+08:00| 1.5523000519867738|
+|1970-01-01T08:00:00.440+08:00| 1.575200051755905|
+|1970-01-01T08:00:00.450+08:00| 1.597500051409006|
+|1970-01-01T08:00:00.460+08:00| 1.619200050938924|
+|1970-01-01T08:00:00.470+08:00| 1.6403000503385066|
+|1970-01-01T08:00:00.480+08:00| 1.660800049600601|
+|1970-01-01T08:00:00.490+08:00| 1.680700048718055|
+|1970-01-01T08:00:00.500+08:00| 1.7000000476837158|
+|1970-01-01T08:00:00.510+08:00| 1.7188475466453037|
+|1970-01-01T08:00:00.520+08:00| 1.7373800457262996|
+|1970-01-01T08:00:00.530+08:00| 1.7555825448831923|
+|1970-01-01T08:00:00.540+08:00| 1.7734400440724702|
+|1970-01-01T08:00:00.550+08:00| 1.790937543250622|
+|1970-01-01T08:00:00.560+08:00| 1.8080600423741364|
+|1970-01-01T08:00:00.570+08:00| 1.8247925413995016|
+|1970-01-01T08:00:00.580+08:00| 1.8411200402832066|
+|1970-01-01T08:00:00.590+08:00| 1.8570275389817397|
+|1970-01-01T08:00:00.600+08:00| 1.8725000374515897|
+|1970-01-01T08:00:00.610+08:00| 1.8875225356492449|
+|1970-01-01T08:00:00.620+08:00| 1.902080033531194|
+|1970-01-01T08:00:00.630+08:00| 1.9161575310539258|
+|1970-01-01T08:00:00.640+08:00| 1.9297400281739288|
+|1970-01-01T08:00:00.650+08:00| 1.9428125248476913|
+|1970-01-01T08:00:00.660+08:00| 1.9553600210317021|
+|1970-01-01T08:00:00.670+08:00| 1.96736751668245|
+|1970-01-01T08:00:00.680+08:00| 1.9788200117564232|
+|1970-01-01T08:00:00.690+08:00| 1.9897025062101101|
+|1970-01-01T08:00:00.700+08:00| 2.0|
+|1970-01-01T08:00:00.710+08:00| 2.0097024933913334|
+|1970-01-01T08:00:00.720+08:00| 2.0188199867081615|
+|1970-01-01T08:00:00.730+08:00| 2.027367479995188|
+|1970-01-01T08:00:00.740+08:00| 2.0353599732971155|
+|1970-01-01T08:00:00.750+08:00| 2.0428124666586482|
+|1970-01-01T08:00:00.760+08:00| 2.049739960124489|
+|1970-01-01T08:00:00.770+08:00| 2.056157453739342|
+|1970-01-01T08:00:00.780+08:00| 2.06207994754791|
+|1970-01-01T08:00:00.790+08:00| 2.067522441594897|
+|1970-01-01T08:00:00.800+08:00| 2.072499935925006|
+|1970-01-01T08:00:00.810+08:00| 2.07702743058294|
+|1970-01-01T08:00:00.820+08:00| 2.081119925613404|
+|1970-01-01T08:00:00.830+08:00| 2.0847924210611|
+|1970-01-01T08:00:00.840+08:00| 2.0880599169707317|
+|1970-01-01T08:00:00.850+08:00| 2.0909374133870027|
+|1970-01-01T08:00:00.860+08:00| 2.0934399103546166|
+|1970-01-01T08:00:00.870+08:00| 2.0955824079182768|
+|1970-01-01T08:00:00.880+08:00| 2.0973799061226863|
+|1970-01-01T08:00:00.890+08:00| 2.098847405012549|
+|1970-01-01T08:00:00.900+08:00| 2.0999999046325684|
+|1970-01-01T08:00:00.910+08:00| 2.1005574051201332|
+|1970-01-01T08:00:00.920+08:00| 2.1002599065303778|
+|1970-01-01T08:00:00.930+08:00| 2.0991524087846245|
+|1970-01-01T08:00:00.940+08:00| 2.0972799118041947|
+|1970-01-01T08:00:00.950+08:00| 2.0946874155104105|
+|1970-01-01T08:00:00.960+08:00| 2.0914199198245944|
+|1970-01-01T08:00:00.970+08:00| 2.0875224246680673|
+|1970-01-01T08:00:00.980+08:00| 2.083039929962151|
+|1970-01-01T08:00:00.990+08:00| 2.0780174356281687|
+|1970-01-01T08:00:01.000+08:00| 2.0724999415874406|
+|1970-01-01T08:00:01.010+08:00| 2.06653244776129|
+|1970-01-01T08:00:01.020+08:00| 2.060159954071038|
+|1970-01-01T08:00:01.030+08:00| 2.053427460438006|
+|1970-01-01T08:00:01.040+08:00| 2.046379966783517|
+|1970-01-01T08:00:01.050+08:00| 2.0390624730288924|
+|1970-01-01T08:00:01.060+08:00| 2.031519979095454|
+|1970-01-01T08:00:01.070+08:00| 2.0237974849045237|
+|1970-01-01T08:00:01.080+08:00| 2.015939990377423|
+|1970-01-01T08:00:01.090+08:00| 2.0079924954354746|
+|1970-01-01T08:00:01.100+08:00| 2.0|
+|1970-01-01T08:00:01.110+08:00| 1.9907018211101906|
+|1970-01-01T08:00:01.120+08:00| 1.9788509124245144|
+|1970-01-01T08:00:01.130+08:00| 1.9645127287932083|
+|1970-01-01T08:00:01.140+08:00| 1.9477527250665083|
+|1970-01-01T08:00:01.150+08:00| 1.9286363560946513|
+|1970-01-01T08:00:01.160+08:00| 1.9072290767278735|
+|1970-01-01T08:00:01.170+08:00| 1.8835963418164114|
+|1970-01-01T08:00:01.180+08:00| 1.8578036062105014|
+|1970-01-01T08:00:01.190+08:00| 1.8299163247603802|
+|1970-01-01T08:00:01.200+08:00| 1.7999999523162842|
+|1970-01-01T08:00:01.210+08:00| 1.7623635841923329|
+|1970-01-01T08:00:01.220+08:00| 1.7129696477516976|
+|1970-01-01T08:00:01.230+08:00| 1.6543635959181928|
+|1970-01-01T08:00:01.240+08:00| 1.5890908816156328|
+|1970-01-01T08:00:01.250+08:00| 1.5196969577678319|
+|1970-01-01T08:00:01.260+08:00| 1.4487272772986044|
+|1970-01-01T08:00:01.270+08:00| 1.3787272931317647|
+|1970-01-01T08:00:01.280+08:00| 1.3122424581911272|
+|1970-01-01T08:00:01.290+08:00| 1.251818225400506|
+|1970-01-01T08:00:01.300+08:00| 1.2000000476837158|
+|1970-01-01T08:00:01.310+08:00| 1.1548000470995912|
+|1970-01-01T08:00:01.320+08:00| 1.1130667107899999|
+|1970-01-01T08:00:01.330+08:00| 1.0756000393033045|
+|1970-01-01T08:00:01.340+08:00| 1.043200033187868|
+|1970-01-01T08:00:01.350+08:00| 1.016666692992053|
+|1970-01-01T08:00:01.360+08:00| 0.9968000192642223|
+|1970-01-01T08:00:01.370+08:00| 0.9844000125527389|
+|1970-01-01T08:00:01.380+08:00| 0.9802666734059655|
+|1970-01-01T08:00:01.390+08:00| 0.9852000023722649|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.410+08:00| 1.023999999165535|
+|1970-01-01T08:00:01.420+08:00| 1.0559999990463256|
+|1970-01-01T08:00:01.430+08:00| 1.0959999996423722|
+|1970-01-01T08:00:01.440+08:00| 1.1440000009536744|
+|1970-01-01T08:00:01.450+08:00| 1.2000000029802322|
+|1970-01-01T08:00:01.460+08:00| 1.264000005722046|
+|1970-01-01T08:00:01.470+08:00| 1.3360000091791153|
+|1970-01-01T08:00:01.480+08:00| 1.4160000133514405|
+|1970-01-01T08:00:01.490+08:00| 1.5040000182390214|
+|1970-01-01T08:00:01.500+08:00| 1.600000023841858|
++-----------------------------+------------------------------------+
+```
+
+#### Spread
+
+##### 函数简介
+
+本函数用于计算时间序列的极差,即最大值减去最小值的结果。
+
+**函数名:** SPREAD
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型与输入相同,序列仅包含一个时间戳为 0 、值为极差的数据点。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select spread(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------+
+| Time|spread(root.test.d1.s1)|
++-----------------------------+-----------------------+
+|1970-01-01T08:00:00.000+08:00| 26.0|
++-----------------------------+-----------------------+
+```
+
+#### Stddev
+
+##### 函数简介
+
+本函数用于计算单列数值型数据的总体标准差。
+
+**函数名:** STDDEV
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列仅包含一个时间戳为 0、值为总体标准差的数据点。
+
+**提示:** 数据中的空值、缺失值和`NaN`将会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:00.000+08:00| 1.0|
+|2020-01-01T00:00:01.000+08:00| 2.0|
+|2020-01-01T00:00:02.000+08:00| 3.0|
+|2020-01-01T00:00:03.000+08:00| 4.0|
+|2020-01-01T00:00:04.000+08:00| 5.0|
+|2020-01-01T00:00:05.000+08:00| 6.0|
+|2020-01-01T00:00:06.000+08:00| 7.0|
+|2020-01-01T00:00:07.000+08:00| 8.0|
+|2020-01-01T00:00:08.000+08:00| 9.0|
+|2020-01-01T00:00:09.000+08:00| 10.0|
+|2020-01-01T00:00:10.000+08:00| 11.0|
+|2020-01-01T00:00:11.000+08:00| 12.0|
+|2020-01-01T00:00:12.000+08:00| 13.0|
+|2020-01-01T00:00:13.000+08:00| 14.0|
+|2020-01-01T00:00:14.000+08:00| 15.0|
+|2020-01-01T00:00:15.000+08:00| 16.0|
+|2020-01-01T00:00:16.000+08:00| 17.0|
+|2020-01-01T00:00:17.000+08:00| 18.0|
+|2020-01-01T00:00:18.000+08:00| 19.0|
+|2020-01-01T00:00:19.000+08:00| 20.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select stddev(s1) from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------+
+| Time|stddev(root.test.d1.s1)|
++-----------------------------+-----------------------+
+|1970-01-01T08:00:00.000+08:00| 5.7662812973353965|
++-----------------------------+-----------------------+
+```
+
+#### ZScore
+
+##### 函数简介
+
+本函数将输入序列使用z-score方法进行归一化。
+
+**函数名:** ZSCORE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `compute`:若设置为 "batch",则将数据全部读入后转换;若设置为 "stream",则需用户提供均值及方差进行流式计算转换。默认为 "batch"。
++ `avg`:使用流式计算时的均值。
++ `sd`:使用流式计算时的标准差。
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+##### 使用示例
+
+###### 全数据计算
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.100+08:00| 0.0|
+|1970-01-01T08:00:00.200+08:00| 0.0|
+|1970-01-01T08:00:00.300+08:00| 1.0|
+|1970-01-01T08:00:00.400+08:00| -1.0|
+|1970-01-01T08:00:00.500+08:00| 0.0|
+|1970-01-01T08:00:00.600+08:00| 0.0|
+|1970-01-01T08:00:00.700+08:00| -2.0|
+|1970-01-01T08:00:00.800+08:00| 2.0|
+|1970-01-01T08:00:00.900+08:00| 0.0|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 1.0|
+|1970-01-01T08:00:01.200+08:00| -1.0|
+|1970-01-01T08:00:01.300+08:00| -1.0|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 0.0|
+|1970-01-01T08:00:01.600+08:00| 0.0|
+|1970-01-01T08:00:01.700+08:00| 10.0|
+|1970-01-01T08:00:01.800+08:00| 2.0|
+|1970-01-01T08:00:01.900+08:00| -2.0|
+|1970-01-01T08:00:02.000+08:00| 0.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select zscore(s1) from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------+
+| Time|zscore(root.test.s1)|
++-----------------------------+--------------------+
+|1970-01-01T08:00:00.100+08:00|-0.20672455764868078|
+|1970-01-01T08:00:00.200+08:00|-0.20672455764868078|
+|1970-01-01T08:00:00.300+08:00| 0.20672455764868078|
+|1970-01-01T08:00:00.400+08:00| -0.6201736729460423|
+|1970-01-01T08:00:00.500+08:00|-0.20672455764868078|
+|1970-01-01T08:00:00.600+08:00|-0.20672455764868078|
+|1970-01-01T08:00:00.700+08:00| -1.033622788243404|
+|1970-01-01T08:00:00.800+08:00| 0.6201736729460423|
+|1970-01-01T08:00:00.900+08:00|-0.20672455764868078|
+|1970-01-01T08:00:01.000+08:00|-0.20672455764868078|
+|1970-01-01T08:00:01.100+08:00| 0.20672455764868078|
+|1970-01-01T08:00:01.200+08:00| -0.6201736729460423|
+|1970-01-01T08:00:01.300+08:00| -0.6201736729460423|
+|1970-01-01T08:00:01.400+08:00| 0.20672455764868078|
+|1970-01-01T08:00:01.500+08:00|-0.20672455764868078|
+|1970-01-01T08:00:01.600+08:00|-0.20672455764868078|
+|1970-01-01T08:00:01.700+08:00| 3.9277665953249348|
+|1970-01-01T08:00:01.800+08:00| 0.6201736729460423|
+|1970-01-01T08:00:01.900+08:00| -1.033622788243404|
+|1970-01-01T08:00:02.000+08:00|-0.20672455764868078|
++-----------------------------+--------------------+
+```
+
+### 异常检测
+
+#### IQR
+
+##### 函数简介
+
+本函数用于检验超出上下四分位数1.5倍IQR的数据分布异常。
+
+**函数名:** IQR
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `method`:若设置为 "batch",则将数据全部读入后检测;若设置为 "stream",则需用户提供上下四分位数进行流式检测。默认为 "batch"。
++ `q1`:使用流式计算时的下四分位数。
++ `q3`:使用流式计算时的上四分位数。
+
+**输出序列**:输出单个序列,类型为 DOUBLE。
+
+**说明**:$IQR=Q_3-Q_1$
+
+##### 使用示例
+
+###### 全数据计算
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|1970-01-01T08:00:00.100+08:00| 0.0|
+|1970-01-01T08:00:00.200+08:00| 0.0|
+|1970-01-01T08:00:00.300+08:00| 1.0|
+|1970-01-01T08:00:00.400+08:00| -1.0|
+|1970-01-01T08:00:00.500+08:00| 0.0|
+|1970-01-01T08:00:00.600+08:00| 0.0|
+|1970-01-01T08:00:00.700+08:00| -2.0|
+|1970-01-01T08:00:00.800+08:00| 2.0|
+|1970-01-01T08:00:00.900+08:00| 0.0|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 1.0|
+|1970-01-01T08:00:01.200+08:00| -1.0|
+|1970-01-01T08:00:01.300+08:00| -1.0|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 0.0|
+|1970-01-01T08:00:01.600+08:00| 0.0|
+|1970-01-01T08:00:01.700+08:00| 10.0|
+|1970-01-01T08:00:01.800+08:00| 2.0|
+|1970-01-01T08:00:01.900+08:00| -2.0|
+|1970-01-01T08:00:02.000+08:00| 0.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select iqr(s1) from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------+
+| Time|iqr(root.test.s1)|
++-----------------------------+-----------------+
+|1970-01-01T08:00:01.700+08:00| 10.0|
++-----------------------------+-----------------+
+```
+
+#### KSigma
+
+##### 函数简介
+
+本函数利用动态 K-Sigma 算法进行异常检测。在一个窗口内,与平均值的差距超过k倍标准差的数据将被视作异常并输出。
+
+**函数名:** KSIGMA
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `k`:在动态 K-Sigma 算法中,分布异常的标准差倍数阈值,默认值为 3。
++ `window`:动态 K-Sigma 算法的滑动窗口大小,默认值为 10000。
+
+
+**输出序列:** 输出单个序列,类型与输入序列相同。
+
+**提示:** k 应大于 0,否则将不做输出。
+
+##### 使用示例
+
+###### 指定k
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 0.0|
+|2020-01-01T00:00:03.000+08:00| 50.0|
+|2020-01-01T00:00:04.000+08:00| 100.0|
+|2020-01-01T00:00:06.000+08:00| 150.0|
+|2020-01-01T00:00:08.000+08:00| 200.0|
+|2020-01-01T00:00:10.000+08:00| 200.0|
+|2020-01-01T00:00:14.000+08:00| 200.0|
+|2020-01-01T00:00:15.000+08:00| 200.0|
+|2020-01-01T00:00:16.000+08:00| 200.0|
+|2020-01-01T00:00:18.000+08:00| 200.0|
+|2020-01-01T00:00:20.000+08:00| 150.0|
+|2020-01-01T00:00:22.000+08:00| 100.0|
+|2020-01-01T00:00:26.000+08:00| 50.0|
+|2020-01-01T00:00:28.000+08:00| 0.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select ksigma(s1,"k"="1.0") from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------------+
+|Time |ksigma(root.test.d1.s1,"k"="3.0")|
++-----------------------------+---------------------------------+
+|2020-01-01T00:00:02.000+08:00| 0.0|
+|2020-01-01T00:00:03.000+08:00| 50.0|
+|2020-01-01T00:00:26.000+08:00| 50.0|
+|2020-01-01T00:00:28.000+08:00| 0.0|
++-----------------------------+---------------------------------+
+```
+
+#### LOF
+
+##### 函数简介
+
+本函数使用局部离群点检测方法用于查找序列的密度异常。将根据提供的第k距离数及局部离群点因子(lof)阈值,判断输入数据是否为离群点,即异常,并输出各点的 LOF 值。
+
+**函数名:** LOF
+
+**输入序列:** 多个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `method`:使用的检测方法。默认为 default,以高维数据计算。设置为 series,将一维时间序列转换为高维数据计算。
++ `k`:使用第k距离计算局部离群点因子.默认为 3。
++ `window`:每次读取数据的窗口长度。默认为 10000.
++ `windowsize`:使用series方法时,转化高维数据的维数,即单个窗口的大小。默认为 5。
+
+**输出序列:** 输出单时间序列,类型为DOUBLE。
+
+**提示:** 不完整的数据行会被忽略,不参与计算,也不标记为离群点。
+
+
+##### 使用示例
+
+###### 默认参数
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d1.s1|root.test.d1.s2|
++-----------------------------+---------------+---------------+
+|1970-01-01T08:00:00.100+08:00| 0.0| 0.0|
+|1970-01-01T08:00:00.200+08:00| 0.0| 1.0|
+|1970-01-01T08:00:00.300+08:00| 1.0| 1.0|
+|1970-01-01T08:00:00.400+08:00| 1.0| 0.0|
+|1970-01-01T08:00:00.500+08:00| 0.0| -1.0|
+|1970-01-01T08:00:00.600+08:00| -1.0| -1.0|
+|1970-01-01T08:00:00.700+08:00| -1.0| 0.0|
+|1970-01-01T08:00:00.800+08:00| 2.0| 2.0|
+|1970-01-01T08:00:00.900+08:00| 0.0| null|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select lof(s1,s2) from root.test.d1 where time<1000
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------+
+| Time|lof(root.test.d1.s1, root.test.d1.s2)|
++-----------------------------+-------------------------------------+
+|1970-01-01T08:00:00.100+08:00| 3.8274824267668244|
+|1970-01-01T08:00:00.200+08:00| 3.0117631741126156|
+|1970-01-01T08:00:00.300+08:00| 2.838155437762879|
+|1970-01-01T08:00:00.400+08:00| 3.0117631741126156|
+|1970-01-01T08:00:00.500+08:00| 2.73518261244453|
+|1970-01-01T08:00:00.600+08:00| 2.371440975708148|
+|1970-01-01T08:00:00.700+08:00| 2.73518261244453|
+|1970-01-01T08:00:00.800+08:00| 1.7561416374270742|
++-----------------------------+-------------------------------------+
+```
+
+###### 诊断一维时间序列
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.100+08:00| 1.0|
+|1970-01-01T08:00:00.200+08:00| 2.0|
+|1970-01-01T08:00:00.300+08:00| 3.0|
+|1970-01-01T08:00:00.400+08:00| 4.0|
+|1970-01-01T08:00:00.500+08:00| 5.0|
+|1970-01-01T08:00:00.600+08:00| 6.0|
+|1970-01-01T08:00:00.700+08:00| 7.0|
+|1970-01-01T08:00:00.800+08:00| 8.0|
+|1970-01-01T08:00:00.900+08:00| 9.0|
+|1970-01-01T08:00:01.000+08:00| 10.0|
+|1970-01-01T08:00:01.100+08:00| 11.0|
+|1970-01-01T08:00:01.200+08:00| 12.0|
+|1970-01-01T08:00:01.300+08:00| 13.0|
+|1970-01-01T08:00:01.400+08:00| 14.0|
+|1970-01-01T08:00:01.500+08:00| 15.0|
+|1970-01-01T08:00:01.600+08:00| 16.0|
+|1970-01-01T08:00:01.700+08:00| 17.0|
+|1970-01-01T08:00:01.800+08:00| 18.0|
+|1970-01-01T08:00:01.900+08:00| 19.0|
+|1970-01-01T08:00:02.000+08:00| 20.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select lof(s1, "method"="series") from root.test.d1 where time<1000
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------+
+| Time|lof(root.test.d1.s1)|
++-----------------------------+--------------------+
+|1970-01-01T08:00:00.100+08:00| 3.77777777777778|
+|1970-01-01T08:00:00.200+08:00| 4.32727272727273|
+|1970-01-01T08:00:00.300+08:00| 4.85714285714286|
+|1970-01-01T08:00:00.400+08:00| 5.40909090909091|
+|1970-01-01T08:00:00.500+08:00| 5.94999999999999|
+|1970-01-01T08:00:00.600+08:00| 6.43243243243243|
+|1970-01-01T08:00:00.700+08:00| 6.79999999999999|
+|1970-01-01T08:00:00.800+08:00| 7.0|
+|1970-01-01T08:00:00.900+08:00| 7.0|
+|1970-01-01T08:00:01.000+08:00| 6.79999999999999|
+|1970-01-01T08:00:01.100+08:00| 6.43243243243243|
+|1970-01-01T08:00:01.200+08:00| 5.94999999999999|
+|1970-01-01T08:00:01.300+08:00| 5.40909090909091|
+|1970-01-01T08:00:01.400+08:00| 4.85714285714286|
+|1970-01-01T08:00:01.500+08:00| 4.32727272727273|
+|1970-01-01T08:00:01.600+08:00| 3.77777777777778|
++-----------------------------+--------------------+
+```
+
+#### MissDetect
+
+##### 函数简介
+
+本函数用于检测数据中的缺失异常。在一些数据中,缺失数据会被线性插值填补,在数据中出现完美的线性片段,且这些片段往往长度较大。本函数通过在数据中发现这些完美线性片段来检测缺失异常。
+
+**函数名:** MISSDETECT
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `minlen`:被标记为异常的完美线性片段的最小长度,是一个大于等于 10 的整数,默认值为 10。
+
+**输出序列:** 输出单个序列,类型为 BOOLEAN,即该数据点是否为缺失异常。
+
+**提示:** 数据中的`NaN`将会被忽略。
+
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s2|
++-----------------------------+---------------+
+|2021-07-01T12:00:00.000+08:00| 0.0|
+|2021-07-01T12:00:01.000+08:00| 1.0|
+|2021-07-01T12:00:02.000+08:00| 0.0|
+|2021-07-01T12:00:03.000+08:00| 1.0|
+|2021-07-01T12:00:04.000+08:00| 0.0|
+|2021-07-01T12:00:05.000+08:00| 0.0|
+|2021-07-01T12:00:06.000+08:00| 0.0|
+|2021-07-01T12:00:07.000+08:00| 0.0|
+|2021-07-01T12:00:08.000+08:00| 0.0|
+|2021-07-01T12:00:09.000+08:00| 0.0|
+|2021-07-01T12:00:10.000+08:00| 0.0|
+|2021-07-01T12:00:11.000+08:00| 0.0|
+|2021-07-01T12:00:12.000+08:00| 0.0|
+|2021-07-01T12:00:13.000+08:00| 0.0|
+|2021-07-01T12:00:14.000+08:00| 0.0|
+|2021-07-01T12:00:15.000+08:00| 0.0|
+|2021-07-01T12:00:16.000+08:00| 1.0|
+|2021-07-01T12:00:17.000+08:00| 0.0|
+|2021-07-01T12:00:18.000+08:00| 1.0|
+|2021-07-01T12:00:19.000+08:00| 0.0|
+|2021-07-01T12:00:20.000+08:00| 1.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select missdetect(s2,'minlen'='10') from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------+
+| Time|missdetect(root.test.d2.s2, "minlen"="10")|
++-----------------------------+------------------------------------------+
+|2021-07-01T12:00:00.000+08:00| false|
+|2021-07-01T12:00:01.000+08:00| false|
+|2021-07-01T12:00:02.000+08:00| false|
+|2021-07-01T12:00:03.000+08:00| false|
+|2021-07-01T12:00:04.000+08:00| true|
+|2021-07-01T12:00:05.000+08:00| true|
+|2021-07-01T12:00:06.000+08:00| true|
+|2021-07-01T12:00:07.000+08:00| true|
+|2021-07-01T12:00:08.000+08:00| true|
+|2021-07-01T12:00:09.000+08:00| true|
+|2021-07-01T12:00:10.000+08:00| true|
+|2021-07-01T12:00:11.000+08:00| true|
+|2021-07-01T12:00:12.000+08:00| true|
+|2021-07-01T12:00:13.000+08:00| true|
+|2021-07-01T12:00:14.000+08:00| true|
+|2021-07-01T12:00:15.000+08:00| true|
+|2021-07-01T12:00:16.000+08:00| false|
+|2021-07-01T12:00:17.000+08:00| false|
+|2021-07-01T12:00:18.000+08:00| false|
+|2021-07-01T12:00:19.000+08:00| false|
+|2021-07-01T12:00:20.000+08:00| false|
++-----------------------------+------------------------------------------+
+```
+
+#### Range
+
+##### 函数简介
+
+本函数用于查找时间序列的范围异常。将根据提供的上界与下界,判断输入数据是否越界,即异常,并输出所有异常点为新的时间序列。
+
+**函数名:** RANGE
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `lower_bound`:范围异常检测的下界。
++ `upper_bound`:范围异常检测的上界。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。
+
+**提示:** 应满足`upper_bound`大于`lower_bound`,否则将不做输出。
+
+
+##### 使用示例
+
+###### 指定上界与下界
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select range(s1,"lower_bound"="101.0","upper_bound"="125.0") from root.test.d1 where time <= 2020-01-01 00:00:30
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------------------+
+|Time |range(root.test.d1.s1,"lower_bound"="101.0","upper_bound"="125.0")|
++-----------------------------+------------------------------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
++-----------------------------+------------------------------------------------------------------+
+```
+
+#### TwoSidedFilter
+
+##### 函数简介
+
+本函数基于双边窗口检测法对输入序列中的异常点进行过滤。
+
+**函数名:** TWOSIDEDFILTER
+
+**输出序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**输出序列:** 输出单个序列,类型与输入相同,是输入序列去除异常点后的结果。
+
+**参数:**
+
+- `len`:双边窗口检测法中的窗口大小,取值范围为正整数,默认值为 5.如当`len`=3 时,算法向前、向后各取长度为3的窗口,在窗口中计算异常度。
+- `threshold`:异常度的阈值,取值范围为(0,1),默认值为 0.3。阈值越高,函数对于异常度的判定标准越严格。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|1970-01-01T08:00:00.000+08:00| 2002.0|
+|1970-01-01T08:00:01.000+08:00| 1946.0|
+|1970-01-01T08:00:02.000+08:00| 1958.0|
+|1970-01-01T08:00:03.000+08:00| 2012.0|
+|1970-01-01T08:00:04.000+08:00| 2051.0|
+|1970-01-01T08:00:05.000+08:00| 1898.0|
+|1970-01-01T08:00:06.000+08:00| 2014.0|
+|1970-01-01T08:00:07.000+08:00| 2052.0|
+|1970-01-01T08:00:08.000+08:00| 1935.0|
+|1970-01-01T08:00:09.000+08:00| 1901.0|
+|1970-01-01T08:00:10.000+08:00| 1972.0|
+|1970-01-01T08:00:11.000+08:00| 1969.0|
+|1970-01-01T08:00:12.000+08:00| 1984.0|
+|1970-01-01T08:00:13.000+08:00| 2018.0|
+|1970-01-01T08:00:37.000+08:00| 1484.0|
+|1970-01-01T08:00:38.000+08:00| 1055.0|
+|1970-01-01T08:00:39.000+08:00| 1050.0|
+|1970-01-01T08:01:05.000+08:00| 1023.0|
+|1970-01-01T08:01:06.000+08:00| 1056.0|
+|1970-01-01T08:01:07.000+08:00| 978.0|
+|1970-01-01T08:01:08.000+08:00| 1050.0|
+|1970-01-01T08:01:09.000+08:00| 1123.0|
+|1970-01-01T08:01:10.000+08:00| 1150.0|
+|1970-01-01T08:01:11.000+08:00| 1034.0|
+|1970-01-01T08:01:12.000+08:00| 950.0|
+|1970-01-01T08:01:13.000+08:00| 1059.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select TwoSidedFilter(s0, 'len'='5', 'threshold'='0.3') from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s0|
++-----------------------------+------------+
+|1970-01-01T08:00:00.000+08:00| 2002.0|
+|1970-01-01T08:00:01.000+08:00| 1946.0|
+|1970-01-01T08:00:02.000+08:00| 1958.0|
+|1970-01-01T08:00:03.000+08:00| 2012.0|
+|1970-01-01T08:00:04.000+08:00| 2051.0|
+|1970-01-01T08:00:05.000+08:00| 1898.0|
+|1970-01-01T08:00:06.000+08:00| 2014.0|
+|1970-01-01T08:00:07.000+08:00| 2052.0|
+|1970-01-01T08:00:08.000+08:00| 1935.0|
+|1970-01-01T08:00:09.000+08:00| 1901.0|
+|1970-01-01T08:00:10.000+08:00| 1972.0|
+|1970-01-01T08:00:11.000+08:00| 1969.0|
+|1970-01-01T08:00:12.000+08:00| 1984.0|
+|1970-01-01T08:00:13.000+08:00| 2018.0|
+|1970-01-01T08:01:05.000+08:00| 1023.0|
+|1970-01-01T08:01:06.000+08:00| 1056.0|
+|1970-01-01T08:01:07.000+08:00| 978.0|
+|1970-01-01T08:01:08.000+08:00| 1050.0|
+|1970-01-01T08:01:09.000+08:00| 1123.0|
+|1970-01-01T08:01:10.000+08:00| 1150.0|
+|1970-01-01T08:01:11.000+08:00| 1034.0|
+|1970-01-01T08:01:12.000+08:00| 950.0|
+|1970-01-01T08:01:13.000+08:00| 1059.0|
++-----------------------------+------------+
+```
+
+#### Outlier
+
+##### 函数简介
+
+本函数用于检测基于距离的异常点。在当前窗口中,如果一个点距离阈值范围内的邻居数量(包括它自己)少于密度阈值,则该点是异常点。
+
+**函数名:** OUTLIER
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `r`:基于距离异常检测中的距离阈值。
++ `k`:基于距离异常检测中的密度阈值。
++ `w`:用于指定滑动窗口的大小。
++ `s`:用于指定滑动窗口的步长。
+
+**输出序列**:输出单个序列,类型与输入序列相同。
+
+##### 使用示例
+
+###### 指定查询参数
+
+输入序列:
+
+```
++-----------------------------+------------+
+| Time|root.test.s1|
++-----------------------------+------------+
+|2020-01-04T23:59:55.000+08:00| 56.0|
+|2020-01-04T23:59:56.000+08:00| 55.1|
+|2020-01-04T23:59:57.000+08:00| 54.2|
+|2020-01-04T23:59:58.000+08:00| 56.3|
+|2020-01-04T23:59:59.000+08:00| 59.0|
+|2020-01-05T00:00:00.000+08:00| 60.0|
+|2020-01-05T00:00:01.000+08:00| 60.5|
+|2020-01-05T00:00:02.000+08:00| 64.5|
+|2020-01-05T00:00:03.000+08:00| 69.0|
+|2020-01-05T00:00:04.000+08:00| 64.2|
+|2020-01-05T00:00:05.000+08:00| 62.3|
+|2020-01-05T00:00:06.000+08:00| 58.0|
+|2020-01-05T00:00:07.000+08:00| 58.9|
+|2020-01-05T00:00:08.000+08:00| 52.0|
+|2020-01-05T00:00:09.000+08:00| 62.3|
+|2020-01-05T00:00:10.000+08:00| 61.0|
+|2020-01-05T00:00:11.000+08:00| 64.2|
+|2020-01-05T00:00:12.000+08:00| 61.8|
+|2020-01-05T00:00:13.000+08:00| 64.0|
+|2020-01-05T00:00:14.000+08:00| 63.0|
++-----------------------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select outlier(s1,"r"="5.0","k"="4","w"="10","s"="5") from root.test
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------------------+
+| Time|outlier(root.test.s1,"r"="5.0","k"="4","w"="10","s"="5")|
++-----------------------------+--------------------------------------------------------+
+|2020-01-05T00:00:03.000+08:00| 69.0|
++-----------------------------+--------------------------------------------------------+
+|2020-01-05T00:00:08.000+08:00| 52.0|
++-----------------------------+--------------------------------------------------------+
+```
+
+### 频域分析
+
+#### Conv
+
+##### 函数简介
+
+本函数对两个输入序列进行卷积,即多项式乘法。
+
+
+**函数名:** CONV
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE
+
+**输出序列:** 输出单个序列,类型为DOUBLE,它是两个序列卷积的结果。序列的时间戳从0开始,仅用于表示顺序。
+
+**提示:** 输入序列中的`NaN`将被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d2.s1|root.test.d2.s2|
++-----------------------------+---------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 1.0| 7.0|
+|1970-01-01T08:00:00.001+08:00| 0.0| 2.0|
+|1970-01-01T08:00:00.002+08:00| 1.0| null|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select conv(s1,s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------+
+| Time|conv(root.test.d2.s1, root.test.d2.s2)|
++-----------------------------+--------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 7.0|
+|1970-01-01T08:00:00.001+08:00| 2.0|
+|1970-01-01T08:00:00.002+08:00| 7.0|
+|1970-01-01T08:00:00.003+08:00| 2.0|
++-----------------------------+--------------------------------------+
+```
+
+#### Deconv
+
+##### 函数简介
+
+本函数对两个输入序列进行去卷积,即多项式除法运算。
+
+**函数名:** DECONV
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `result`:去卷积的结果,取值为'quotient'或'remainder',分别对应于去卷积的商和余数。在缺省情况下,输出去卷积的商。
+
+**输出序列:** 输出单个序列,类型为DOUBLE。它是将第二个序列从第一个序列中去卷积(第一个序列除以第二个序列)的结果。序列的时间戳从0开始,仅用于表示顺序。
+
+**提示:** 输入序列中的`NaN`将被忽略。
+
+##### 使用示例
+
+###### 计算去卷积的商
+
+当`result`参数缺省或为'quotient'时,本函数计算去卷积的商。
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d2.s3|root.test.d2.s2|
++-----------------------------+---------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 8.0| 7.0|
+|1970-01-01T08:00:00.001+08:00| 2.0| 2.0|
+|1970-01-01T08:00:00.002+08:00| 7.0| null|
+|1970-01-01T08:00:00.003+08:00| 2.0| null|
++-----------------------------+---------------+---------------+
+```
+
+
+用于查询的SQL语句:
+
+```sql
+select deconv(s3,s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------------------+
+| Time|deconv(root.test.d2.s3, root.test.d2.s2)|
++-----------------------------+----------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 1.0|
+|1970-01-01T08:00:00.001+08:00| 0.0|
+|1970-01-01T08:00:00.002+08:00| 1.0|
++-----------------------------+----------------------------------------+
+```
+
+###### 计算去卷积的余数
+
+当`result`参数为'remainder'时,本函数计算去卷积的余数。输入序列同上,用于查询的SQL语句如下:
+
+```sql
+select deconv(s3,s2,'result'='remainder') from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------------------------+
+| Time|deconv(root.test.d2.s3, root.test.d2.s2, "result"="remainder")|
++-----------------------------+--------------------------------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 1.0|
+|1970-01-01T08:00:00.001+08:00| 0.0|
+|1970-01-01T08:00:00.002+08:00| 0.0|
+|1970-01-01T08:00:00.003+08:00| 0.0|
++-----------------------------+--------------------------------------------------------------+
+```
+
+#### DWT
+
+##### 函数简介
+
+本函数对输入序列进行一维离散小波变换。
+
+**函数名:** DWT
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `method`:小波滤波的类型,提供'Haar', 'DB4', 'DB6', 'DB8',其中DB指代Daubechies。若不设置该参数,则用户需提供小波滤波的系数。不区分大小写。
++ `coef`:小波滤波的系数。若提供该参数,请使用英文逗号','分割各项,不添加空格或其它符号。
++ `layer`:进行变换的次数,最终输出的向量个数等同于$layer+1$.默认取1。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,长度与输入相等。
+
+**提示:** 输入序列长度必须为2的整数次幂。
+
+##### 使用示例
+
+###### Haar变换
+
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.100+08:00| 0.2|
+|1970-01-01T08:00:00.200+08:00| 1.5|
+|1970-01-01T08:00:00.300+08:00| 1.2|
+|1970-01-01T08:00:00.400+08:00| 0.6|
+|1970-01-01T08:00:00.500+08:00| 1.7|
+|1970-01-01T08:00:00.600+08:00| 0.8|
+|1970-01-01T08:00:00.700+08:00| 2.0|
+|1970-01-01T08:00:00.800+08:00| 2.5|
+|1970-01-01T08:00:00.900+08:00| 2.1|
+|1970-01-01T08:00:01.000+08:00| 0.0|
+|1970-01-01T08:00:01.100+08:00| 2.0|
+|1970-01-01T08:00:01.200+08:00| 1.8|
+|1970-01-01T08:00:01.300+08:00| 1.2|
+|1970-01-01T08:00:01.400+08:00| 1.0|
+|1970-01-01T08:00:01.500+08:00| 1.6|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select dwt(s1,"method"="haar") from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------+
+| Time|dwt(root.test.d1.s1, "method"="haar")|
++-----------------------------+-------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.14142135834465192|
+|1970-01-01T08:00:00.100+08:00| 1.909188342921157|
+|1970-01-01T08:00:00.200+08:00| 1.6263456473052773|
+|1970-01-01T08:00:00.300+08:00| 1.9798989957517026|
+|1970-01-01T08:00:00.400+08:00| 3.252691126023161|
+|1970-01-01T08:00:00.500+08:00| 1.414213562373095|
+|1970-01-01T08:00:00.600+08:00| 2.1213203435596424|
+|1970-01-01T08:00:00.700+08:00| 1.8384776479437628|
+|1970-01-01T08:00:00.800+08:00| -0.14142135834465192|
+|1970-01-01T08:00:00.900+08:00| 0.21213200063848547|
+|1970-01-01T08:00:01.000+08:00| -0.7778174761639416|
+|1970-01-01T08:00:01.100+08:00| -0.8485281289944873|
+|1970-01-01T08:00:01.200+08:00| 0.2828427799095765|
+|1970-01-01T08:00:01.300+08:00| -1.414213562373095|
+|1970-01-01T08:00:01.400+08:00| 0.42426400127697095|
+|1970-01-01T08:00:01.500+08:00| -0.42426408557066786|
++-----------------------------+-------------------------------------+
+```
+
+#### FFT
+
+##### 函数简介
+
+本函数对输入序列进行快速傅里叶变换。
+
+**函数名:** FFT
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `method`:傅里叶变换的类型,取值为'uniform'或'nonuniform',缺省情况下为'uniform'。当取值为'uniform'时,时间戳将被忽略,所有数据点都将被视作等距的,并应用等距快速傅里叶算法;当取值为'nonuniform'时,将根据时间戳应用非等距快速傅里叶算法(未实现)。
++ `result`:傅里叶变换的结果,取值为'real'、'imag'、'abs'或'angle',分别对应于变换结果的实部、虚部、模和幅角。在缺省情况下,输出变换的模。
++ `compress`:压缩参数,取值范围(0,1],是有损压缩时保留的能量比例。在缺省情况下,不进行压缩。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,长度与输入相等。序列的时间戳从0开始,仅用于表示顺序。
+
+**提示:** 输入序列中的`NaN`将被忽略。
+
+##### 使用示例
+
+###### 等距傅里叶变换
+
+当`type`参数缺省或为'uniform'时,本函数进行等距傅里叶变换。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 2.902113|
+|1970-01-01T08:00:01.000+08:00| 1.1755705|
+|1970-01-01T08:00:02.000+08:00| -2.1755705|
+|1970-01-01T08:00:03.000+08:00| -1.9021131|
+|1970-01-01T08:00:04.000+08:00| 1.0|
+|1970-01-01T08:00:05.000+08:00| 1.9021131|
+|1970-01-01T08:00:06.000+08:00| 0.1755705|
+|1970-01-01T08:00:07.000+08:00| -1.1755705|
+|1970-01-01T08:00:08.000+08:00| -0.902113|
+|1970-01-01T08:00:09.000+08:00| 0.0|
+|1970-01-01T08:00:10.000+08:00| 0.902113|
+|1970-01-01T08:00:11.000+08:00| 1.1755705|
+|1970-01-01T08:00:12.000+08:00| -0.1755705|
+|1970-01-01T08:00:13.000+08:00| -1.9021131|
+|1970-01-01T08:00:14.000+08:00| -1.0|
+|1970-01-01T08:00:15.000+08:00| 1.9021131|
+|1970-01-01T08:00:16.000+08:00| 2.1755705|
+|1970-01-01T08:00:17.000+08:00| -1.1755705|
+|1970-01-01T08:00:18.000+08:00| -2.902113|
+|1970-01-01T08:00:19.000+08:00| 0.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select fft(s1) from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------+
+| Time| fft(root.test.d1.s1)|
++-----------------------------+----------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0|
+|1970-01-01T08:00:00.001+08:00| 1.2727111142703152E-8|
+|1970-01-01T08:00:00.002+08:00| 2.385520799101839E-7|
+|1970-01-01T08:00:00.003+08:00| 8.723291723972645E-8|
+|1970-01-01T08:00:00.004+08:00| 19.999999960195904|
+|1970-01-01T08:00:00.005+08:00| 9.999999850988388|
+|1970-01-01T08:00:00.006+08:00| 3.2260694930700566E-7|
+|1970-01-01T08:00:00.007+08:00| 8.723291605373329E-8|
+|1970-01-01T08:00:00.008+08:00| 1.108657103979944E-7|
+|1970-01-01T08:00:00.009+08:00| 1.2727110997246171E-8|
+|1970-01-01T08:00:00.010+08:00|1.9852334701272664E-23|
+|1970-01-01T08:00:00.011+08:00| 1.2727111194499847E-8|
+|1970-01-01T08:00:00.012+08:00| 1.108657103979944E-7|
+|1970-01-01T08:00:00.013+08:00| 8.723291785769131E-8|
+|1970-01-01T08:00:00.014+08:00| 3.226069493070057E-7|
+|1970-01-01T08:00:00.015+08:00| 9.999999850988388|
+|1970-01-01T08:00:00.016+08:00| 19.999999960195904|
+|1970-01-01T08:00:00.017+08:00| 8.723291747109068E-8|
+|1970-01-01T08:00:00.018+08:00| 2.3855207991018386E-7|
+|1970-01-01T08:00:00.019+08:00| 1.2727112069910878E-8|
++-----------------------------+----------------------+
+```
+
+注:输入序列服从$y=sin(2\pi t/4)+2sin(2\pi t/5)$,长度为20,因此在输出序列中$k=4$和$k=5$处有尖峰。
+
+###### 等距傅里叶变换并压缩
+
+输入序列同上,用于查询的SQL语句如下:
+
+```sql
+select fft(s1, 'result'='real', 'compress'='0.99'), fft(s1, 'result'='imag','compress'='0.99') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------+----------------------+
+| Time| fft(root.test.d1.s1,| fft(root.test.d1.s1,|
+| | "result"="real",| "result"="imag",|
+| | "compress"="0.99")| "compress"="0.99")|
++-----------------------------+----------------------+----------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0| 0.0|
+|1970-01-01T08:00:00.001+08:00| -3.932894010461041E-9| 1.2104201863039066E-8|
+|1970-01-01T08:00:00.002+08:00|-1.4021739447490164E-7| 1.9299268669082926E-7|
+|1970-01-01T08:00:00.003+08:00| -7.057291240286645E-8| 5.127422242345858E-8|
+|1970-01-01T08:00:00.004+08:00| 19.021130288047125| -6.180339875198807|
+|1970-01-01T08:00:00.005+08:00| 9.999999850988388| 3.501852745067114E-16|
+|1970-01-01T08:00:00.019+08:00| -3.932894898639461E-9|-1.2104202549376264E-8|
++-----------------------------+----------------------+----------------------+
+```
+
+注:基于傅里叶变换结果的共轭性质,压缩结果只保留前一半;根据给定的压缩参数,从低频到高频保留数据点,直到保留的能量比例超过该值;保留最后一个数据点以表示序列长度。
+
+#### HighPass
+
+##### 函数简介
+
+本函数对输入序列进行高通滤波,提取高于截止频率的分量。输入序列的时间戳将被忽略,所有数据点都将被视作等距的。
+
+**函数名:** HIGHPASS
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `wpass`:归一化后的截止频率,取值为(0,1),不可缺省。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,它是滤波后的序列,长度与时间戳均与输入一致。
+
+**提示:** 输入序列中的`NaN`将被忽略。
+
+##### 使用示例
+
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 2.902113|
+|1970-01-01T08:00:01.000+08:00| 1.1755705|
+|1970-01-01T08:00:02.000+08:00| -2.1755705|
+|1970-01-01T08:00:03.000+08:00| -1.9021131|
+|1970-01-01T08:00:04.000+08:00| 1.0|
+|1970-01-01T08:00:05.000+08:00| 1.9021131|
+|1970-01-01T08:00:06.000+08:00| 0.1755705|
+|1970-01-01T08:00:07.000+08:00| -1.1755705|
+|1970-01-01T08:00:08.000+08:00| -0.902113|
+|1970-01-01T08:00:09.000+08:00| 0.0|
+|1970-01-01T08:00:10.000+08:00| 0.902113|
+|1970-01-01T08:00:11.000+08:00| 1.1755705|
+|1970-01-01T08:00:12.000+08:00| -0.1755705|
+|1970-01-01T08:00:13.000+08:00| -1.9021131|
+|1970-01-01T08:00:14.000+08:00| -1.0|
+|1970-01-01T08:00:15.000+08:00| 1.9021131|
+|1970-01-01T08:00:16.000+08:00| 2.1755705|
+|1970-01-01T08:00:17.000+08:00| -1.1755705|
+|1970-01-01T08:00:18.000+08:00| -2.902113|
+|1970-01-01T08:00:19.000+08:00| 0.0|
++-----------------------------+---------------+
+```
+
+
+用于查询的SQL语句:
+
+```sql
+select highpass(s1,'wpass'='0.45') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------------------------+
+| Time|highpass(root.test.d1.s1, "wpass"="0.45")|
++-----------------------------+-----------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.9999999534830373|
+|1970-01-01T08:00:01.000+08:00| 1.7462829277628608E-8|
+|1970-01-01T08:00:02.000+08:00| -0.9999999593178128|
+|1970-01-01T08:00:03.000+08:00| -4.1115269056426626E-8|
+|1970-01-01T08:00:04.000+08:00| 0.9999999925494194|
+|1970-01-01T08:00:05.000+08:00| 3.328126513330016E-8|
+|1970-01-01T08:00:06.000+08:00| -1.0000000183304454|
+|1970-01-01T08:00:07.000+08:00| 6.260191433311374E-10|
+|1970-01-01T08:00:08.000+08:00| 1.0000000018134796|
+|1970-01-01T08:00:09.000+08:00| -3.097210911744423E-17|
+|1970-01-01T08:00:10.000+08:00| -1.0000000018134794|
+|1970-01-01T08:00:11.000+08:00| -6.260191627862097E-10|
+|1970-01-01T08:00:12.000+08:00| 1.0000000183304454|
+|1970-01-01T08:00:13.000+08:00| -3.328126501424346E-8|
+|1970-01-01T08:00:14.000+08:00| -0.9999999925494196|
+|1970-01-01T08:00:15.000+08:00| 4.111526915498874E-8|
+|1970-01-01T08:00:16.000+08:00| 0.9999999593178128|
+|1970-01-01T08:00:17.000+08:00| -1.7462829341296528E-8|
+|1970-01-01T08:00:18.000+08:00| -0.9999999534830369|
+|1970-01-01T08:00:19.000+08:00| -1.035237222742873E-16|
++-----------------------------+-----------------------------------------+
+```
+
+注:输入序列服从$y=sin(2\pi t/4)+2sin(2\pi t/5)$,长度为20,因此高通滤波之后的输出序列服从$y=sin(2\pi t/4)$。
+
+#### IFFT
+
+##### 函数简介
+
+本函数将输入的两个序列作为实部和虚部视作一个复数,进行逆快速傅里叶变换,并输出结果的实部。输入数据的格式参见`FFT`函数的输出,并支持以`FFT`函数压缩后的输出作为本函数的输入。
+
+**函数名:** IFFT
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `start`:输出序列的起始时刻,是一个格式为'yyyy-MM-dd HH:mm:ss'的时间字符串。在缺省情况下,为'1970-01-01 08:00:00'。
++ `interval`:输出序列的时间间隔,是一个有单位的正数。目前支持五种单位,分别是'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。在缺省情况下,为1s。
+
+
+**输出序列:** 输出单个序列,类型为DOUBLE。该序列是一个等距时间序列,它的值是将两个输入序列依次作为实部和虚部进行逆快速傅里叶变换的结果。
+
+**提示:** 如果某行数据中包含空值或`NaN`,该行数据将会被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+----------------------+----------------------+
+| Time| root.test.d1.re| root.test.d1.im|
++-----------------------------+----------------------+----------------------+
+|1970-01-01T08:00:00.000+08:00| 0.0| 0.0|
+|1970-01-01T08:00:00.001+08:00| -3.932894010461041E-9| 1.2104201863039066E-8|
+|1970-01-01T08:00:00.002+08:00|-1.4021739447490164E-7| 1.9299268669082926E-7|
+|1970-01-01T08:00:00.003+08:00| -7.057291240286645E-8| 5.127422242345858E-8|
+|1970-01-01T08:00:00.004+08:00| 19.021130288047125| -6.180339875198807|
+|1970-01-01T08:00:00.005+08:00| 9.999999850988388| 3.501852745067114E-16|
+|1970-01-01T08:00:00.019+08:00| -3.932894898639461E-9|-1.2104202549376264E-8|
++-----------------------------+----------------------+----------------------+
+```
+
+
+用于查询的SQL语句:
+
+```sql
+select ifft(re, im, 'interval'='1m', 'start'='2021-01-01 00:00:00') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------------------------+
+| Time|ifft(root.test.d1.re, root.test.d1.im, "interval"="1m",|
+| | "start"="2021-01-01 00:00:00")|
++-----------------------------+-------------------------------------------------------+
+|2021-01-01T00:00:00.000+08:00| 2.902112992431231|
+|2021-01-01T00:01:00.000+08:00| 1.1755704705132448|
+|2021-01-01T00:02:00.000+08:00| -2.175570513757101|
+|2021-01-01T00:03:00.000+08:00| -1.9021130389094498|
+|2021-01-01T00:04:00.000+08:00| 0.9999999925494194|
+|2021-01-01T00:05:00.000+08:00| 1.902113046743454|
+|2021-01-01T00:06:00.000+08:00| 0.17557053610884188|
+|2021-01-01T00:07:00.000+08:00| -1.1755704886020932|
+|2021-01-01T00:08:00.000+08:00| -0.9021130371347148|
+|2021-01-01T00:09:00.000+08:00| 3.552713678800501E-16|
+|2021-01-01T00:10:00.000+08:00| 0.9021130371347154|
+|2021-01-01T00:11:00.000+08:00| 1.1755704886020932|
+|2021-01-01T00:12:00.000+08:00| -0.17557053610884144|
+|2021-01-01T00:13:00.000+08:00| -1.902113046743454|
+|2021-01-01T00:14:00.000+08:00| -0.9999999925494196|
+|2021-01-01T00:15:00.000+08:00| 1.9021130389094498|
+|2021-01-01T00:16:00.000+08:00| 2.1755705137571004|
+|2021-01-01T00:17:00.000+08:00| -1.1755704705132448|
+|2021-01-01T00:18:00.000+08:00| -2.902112992431231|
+|2021-01-01T00:19:00.000+08:00| -3.552713678800501E-16|
++-----------------------------+-------------------------------------------------------+
+```
+
+#### LowPass
+
+##### 函数简介
+
+本函数对输入序列进行低通滤波,提取低于截止频率的分量。输入序列的时间戳将被忽略,所有数据点都将被视作等距的。
+
+**函数名:** LOWPASS
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `wpass`:归一化后的截止频率,取值为(0,1),不可缺省。
+
+**输出序列:** 输出单个序列,类型为DOUBLE,它是滤波后的序列,长度与时间戳均与输入一致。
+
+**提示:** 输入序列中的`NaN`将被忽略。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s1|
++-----------------------------+---------------+
+|1970-01-01T08:00:00.000+08:00| 2.902113|
+|1970-01-01T08:00:01.000+08:00| 1.1755705|
+|1970-01-01T08:00:02.000+08:00| -2.1755705|
+|1970-01-01T08:00:03.000+08:00| -1.9021131|
+|1970-01-01T08:00:04.000+08:00| 1.0|
+|1970-01-01T08:00:05.000+08:00| 1.9021131|
+|1970-01-01T08:00:06.000+08:00| 0.1755705|
+|1970-01-01T08:00:07.000+08:00| -1.1755705|
+|1970-01-01T08:00:08.000+08:00| -0.902113|
+|1970-01-01T08:00:09.000+08:00| 0.0|
+|1970-01-01T08:00:10.000+08:00| 0.902113|
+|1970-01-01T08:00:11.000+08:00| 1.1755705|
+|1970-01-01T08:00:12.000+08:00| -0.1755705|
+|1970-01-01T08:00:13.000+08:00| -1.9021131|
+|1970-01-01T08:00:14.000+08:00| -1.0|
+|1970-01-01T08:00:15.000+08:00| 1.9021131|
+|1970-01-01T08:00:16.000+08:00| 2.1755705|
+|1970-01-01T08:00:17.000+08:00| -1.1755705|
+|1970-01-01T08:00:18.000+08:00| -2.902113|
+|1970-01-01T08:00:19.000+08:00| 0.0|
++-----------------------------+---------------+
+```
+
+
+用于查询的SQL语句:
+
+```sql
+select lowpass(s1,'wpass'='0.45') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------------------+
+| Time|lowpass(root.test.d1.s1, "wpass"="0.45")|
++-----------------------------+----------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 1.9021130073323922|
+|1970-01-01T08:00:01.000+08:00| 1.1755704705132448|
+|1970-01-01T08:00:02.000+08:00| -1.1755705286582614|
+|1970-01-01T08:00:03.000+08:00| -1.9021130389094498|
+|1970-01-01T08:00:04.000+08:00| 7.450580419288145E-9|
+|1970-01-01T08:00:05.000+08:00| 1.902113046743454|
+|1970-01-01T08:00:06.000+08:00| 1.1755705212076808|
+|1970-01-01T08:00:07.000+08:00| -1.1755704886020932|
+|1970-01-01T08:00:08.000+08:00| -1.9021130222335536|
+|1970-01-01T08:00:09.000+08:00| 3.552713678800501E-16|
+|1970-01-01T08:00:10.000+08:00| 1.9021130222335536|
+|1970-01-01T08:00:11.000+08:00| 1.1755704886020932|
+|1970-01-01T08:00:12.000+08:00| -1.1755705212076801|
+|1970-01-01T08:00:13.000+08:00| -1.902113046743454|
+|1970-01-01T08:00:14.000+08:00| -7.45058112983088E-9|
+|1970-01-01T08:00:15.000+08:00| 1.9021130389094498|
+|1970-01-01T08:00:16.000+08:00| 1.1755705286582616|
+|1970-01-01T08:00:17.000+08:00| -1.1755704705132448|
+|1970-01-01T08:00:18.000+08:00| -1.9021130073323924|
+|1970-01-01T08:00:19.000+08:00| -2.664535259100376E-16|
++-----------------------------+----------------------------------------+
+```
+
+注:输入序列服从$y=sin(2\pi t/4)+2sin(2\pi t/5)$,长度为20,因此低通滤波之后的输出序列服从$y=2sin(2\pi t/5)$。
+
+### 数据匹配
+
+#### Cov
+
+##### 函数简介
+
+本函数用于计算两列数值型数据的总体协方差。
+
+**函数名:** COV
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列仅包含一个时间戳为 0、值为总体协方差的数据点。
+
+**提示:**
+
++ 如果某行数据中包含空值、缺失值或`NaN`,该行数据将会被忽略;
++ 如果数据中所有的行都被忽略,函数将会输出`NaN`。
+
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d2.s1|root.test.d2.s2|
++-----------------------------+---------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0| 101.0|
+|2020-01-01T00:00:03.000+08:00| 101.0| null|
+|2020-01-01T00:00:04.000+08:00| 102.0| 101.0|
+|2020-01-01T00:00:06.000+08:00| 104.0| 102.0|
+|2020-01-01T00:00:08.000+08:00| 126.0| 102.0|
+|2020-01-01T00:00:10.000+08:00| 108.0| 103.0|
+|2020-01-01T00:00:12.000+08:00| null| 103.0|
+|2020-01-01T00:00:14.000+08:00| 112.0| 104.0|
+|2020-01-01T00:00:15.000+08:00| 113.0| null|
+|2020-01-01T00:00:16.000+08:00| 114.0| 104.0|
+|2020-01-01T00:00:18.000+08:00| 116.0| 105.0|
+|2020-01-01T00:00:20.000+08:00| 118.0| 105.0|
+|2020-01-01T00:00:22.000+08:00| 100.0| 106.0|
+|2020-01-01T00:00:26.000+08:00| 124.0| 108.0|
+|2020-01-01T00:00:28.000+08:00| 126.0| 108.0|
+|2020-01-01T00:00:30.000+08:00| NaN| 108.0|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select cov(s1,s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------+
+| Time|cov(root.test.d2.s1, root.test.d2.s2)|
++-----------------------------+-------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 12.291666666666666|
++-----------------------------+-------------------------------------+
+```
+
+#### Dtw
+
+##### 函数简介
+
+本函数用于计算两列数值型数据的 DTW 距离。
+
+**函数名:** DTW
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列仅包含一个时间戳为 0、值为两个时间序列的 DTW 距离值。
+
+**提示:**
+
++ 如果某行数据中包含空值、缺失值或`NaN`,该行数据将会被忽略;
++ 如果数据中所有的行都被忽略,函数将会输出 0。
+
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d2.s1|root.test.d2.s2|
++-----------------------------+---------------+---------------+
+|1970-01-01T08:00:00.001+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.002+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.003+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.004+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.005+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.006+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.007+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.008+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.009+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.010+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.011+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.012+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.013+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.014+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.015+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.016+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.017+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.018+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.019+08:00| 1.0| 2.0|
+|1970-01-01T08:00:00.020+08:00| 1.0| 2.0|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select dtw(s1,s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------+
+| Time|dtw(root.test.d2.s1, root.test.d2.s2)|
++-----------------------------+-------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 20.0|
++-----------------------------+-------------------------------------+
+```
+
+#### Pearson
+
+##### 函数简介
+
+本函数用于计算两列数值型数据的皮尔森相关系数。
+
+**函数名:** PEARSON
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列仅包含一个时间戳为 0、值为皮尔森相关系数的数据点。
+
+**提示:**
+
++ 如果某行数据中包含空值、缺失值或`NaN`,该行数据将会被忽略;
++ 如果数据中所有的行都被忽略,函数将会输出`NaN`。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d2.s1|root.test.d2.s2|
++-----------------------------+---------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0| 101.0|
+|2020-01-01T00:00:03.000+08:00| 101.0| null|
+|2020-01-01T00:00:04.000+08:00| 102.0| 101.0|
+|2020-01-01T00:00:06.000+08:00| 104.0| 102.0|
+|2020-01-01T00:00:08.000+08:00| 126.0| 102.0|
+|2020-01-01T00:00:10.000+08:00| 108.0| 103.0|
+|2020-01-01T00:00:12.000+08:00| null| 103.0|
+|2020-01-01T00:00:14.000+08:00| 112.0| 104.0|
+|2020-01-01T00:00:15.000+08:00| 113.0| null|
+|2020-01-01T00:00:16.000+08:00| 114.0| 104.0|
+|2020-01-01T00:00:18.000+08:00| 116.0| 105.0|
+|2020-01-01T00:00:20.000+08:00| 118.0| 105.0|
+|2020-01-01T00:00:22.000+08:00| 100.0| 106.0|
+|2020-01-01T00:00:26.000+08:00| 124.0| 108.0|
+|2020-01-01T00:00:28.000+08:00| 126.0| 108.0|
+|2020-01-01T00:00:30.000+08:00| NaN| 108.0|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select pearson(s1,s2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-----------------------------------------+
+| Time|pearson(root.test.d2.s1, root.test.d2.s2)|
++-----------------------------+-----------------------------------------+
+|1970-01-01T08:00:00.000+08:00| 0.5630881927754872|
++-----------------------------+-----------------------------------------+
+```
+
+#### PtnSym
+
+##### 函数简介
+
+本函数用于寻找序列中所有对称度小于阈值的对称子序列。对称度通过 DTW 计算,值越小代表序列对称性越高。
+
+**函数名:** PTNSYM
+
+**输入序列:** 仅支持一个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `window`:对称子序列的长度,是一个正整数,默认值为 10。
++ `threshold`:对称度阈值,是一个非负数,只有对称度小于等于该值的对称子序列才会被输出。在缺省情况下,所有的子序列都会被输出。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列中的每一个数据点对应于一个对称子序列,时间戳为子序列的起始时刻,值为对称度。
+
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d1.s4|
++-----------------------------+---------------+
+|2021-01-01T12:00:00.000+08:00| 1.0|
+|2021-01-01T12:00:01.000+08:00| 2.0|
+|2021-01-01T12:00:02.000+08:00| 3.0|
+|2021-01-01T12:00:03.000+08:00| 2.0|
+|2021-01-01T12:00:04.000+08:00| 1.0|
+|2021-01-01T12:00:05.000+08:00| 1.0|
+|2021-01-01T12:00:06.000+08:00| 1.0|
+|2021-01-01T12:00:07.000+08:00| 1.0|
+|2021-01-01T12:00:08.000+08:00| 2.0|
+|2021-01-01T12:00:09.000+08:00| 3.0|
+|2021-01-01T12:00:10.000+08:00| 2.0|
+|2021-01-01T12:00:11.000+08:00| 1.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select ptnsym(s4, 'window'='5', 'threshold'='0') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|ptnsym(root.test.d1.s4, "window"="5", "threshold"="0")|
++-----------------------------+------------------------------------------------------+
+|2021-01-01T12:00:00.000+08:00| 0.0|
+|2021-01-01T12:00:07.000+08:00| 0.0|
++-----------------------------+------------------------------------------------------+
+```
+
+#### XCorr
+
+##### 函数简介
+
+本函数用于计算两条时间序列的互相关函数值,
+对离散序列而言,互相关函数可以表示为
+$$CR(n) = \frac{1}{N} \sum_{m=1}^N S_1[m]S_2[m+n]$$
+常用于表征两条序列在不同对齐条件下的相似度。
+
+**函数名:** XCORR
+
+**输入序列:** 仅支持两个输入序列,类型均为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**输出序列:** 输出单个序列,类型为 DOUBLE。序列中共包含$2N-1$个数据点,
+其中正中心的值为两条序列按照预先对齐的结果计算的互相关系数(即等于以上公式的$CR(0)$),
+前半部分的值表示将后一条输入序列向前平移时计算的互相关系数,
+直至两条序列没有重合的数据点(不包含完全分离时的结果$CR(-N)=0.0$),
+后半部分类似。
+用公式可表示为(所有序列的索引从1开始计数):
+$$OS[i] = CR(-N+i) = \frac{1}{N} \sum_{m=1}^{i} S_1[m]S_2[N-i+m],\ if\ i <= N$$
+$$OS[i] = CR(i-N) = \frac{1}{N} \sum_{m=1}^{2N-i} S_1[i-N+m]S_2[m],\ if\ i > N$$
+
+**提示:**
+
++ 两条序列中的`null` 和`NaN` 值会被忽略,在计算中表现为 0。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d1.s1|root.test.d1.s2|
++-----------------------------+---------------+---------------+
+|2020-01-01T00:00:01.000+08:00| null| 6|
+|2020-01-01T00:00:02.000+08:00| 2| 7|
+|2020-01-01T00:00:03.000+08:00| 3| NaN|
+|2020-01-01T00:00:04.000+08:00| 4| 9|
+|2020-01-01T00:00:05.000+08:00| 5| 10|
++-----------------------------+---------------+---------------+
+```
+
+
+用于查询的 SQL 语句:
+
+```sql
+select xcorr(s1, s2) from root.test.d1 where time <= 2020-01-01 00:00:05
+```
+
+输出序列:
+
+```
++-----------------------------+---------------------------------------+
+| Time|xcorr(root.test.d1.s1, root.test.d1.s2)|
++-----------------------------+---------------------------------------+
+|1970-01-01T08:00:00.001+08:00| 0.0|
+|1970-01-01T08:00:00.002+08:00| 4.0|
+|1970-01-01T08:00:00.003+08:00| 9.6|
+|1970-01-01T08:00:00.004+08:00| 13.4|
+|1970-01-01T08:00:00.005+08:00| 20.0|
+|1970-01-01T08:00:00.006+08:00| 15.6|
+|1970-01-01T08:00:00.007+08:00| 9.2|
+|1970-01-01T08:00:00.008+08:00| 11.8|
+|1970-01-01T08:00:00.009+08:00| 6.0|
++-----------------------------+---------------------------------------+
+```
+
+### 数据修复
+
+#### TimestampRepair
+
+##### 函数简介
+
+本函数用于时间戳修复。根据给定的标准时间间隔,采用最小化修复代价的方法,通过对数据时间戳的微调,将原本时间戳间隔不稳定的数据修复为严格等间隔的数据。在未给定标准时间间隔的情况下,本函数将使用时间间隔的中位数 (median)、众数 (mode) 或聚类中心 (cluster) 来推算标准时间间隔。
+
+
+**函数名:** TIMESTAMPREPAIR
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `interval`: 标准时间间隔(单位是毫秒),是一个正整数。在缺省情况下,将根据指定的方法推算。
++ `method`:推算标准时间间隔的方法,取值为 'median', 'mode' 或 'cluster',仅在`interval`缺省时有效。在缺省情况下,将使用中位数方法进行推算。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。该序列是修复后的输入序列。
+
+##### 使用示例
+
+###### 指定标准时间间隔
+
+在给定`interval`参数的情况下,本函数将按照指定的标准时间间隔进行修复。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s1|
++-----------------------------+---------------+
+|2021-07-01T12:00:00.000+08:00| 1.0|
+|2021-07-01T12:00:10.000+08:00| 2.0|
+|2021-07-01T12:00:19.000+08:00| 3.0|
+|2021-07-01T12:00:30.000+08:00| 4.0|
+|2021-07-01T12:00:40.000+08:00| 5.0|
+|2021-07-01T12:00:50.000+08:00| 6.0|
+|2021-07-01T12:01:01.000+08:00| 7.0|
+|2021-07-01T12:01:11.000+08:00| 8.0|
+|2021-07-01T12:01:21.000+08:00| 9.0|
+|2021-07-01T12:01:31.000+08:00| 10.0|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select timestamprepair(s1,'interval'='10000') from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------------------------------+
+| Time|timestamprepair(root.test.d2.s1, "interval"="10000")|
++-----------------------------+----------------------------------------------------+
+|2021-07-01T12:00:00.000+08:00| 1.0|
+|2021-07-01T12:00:10.000+08:00| 2.0|
+|2021-07-01T12:00:20.000+08:00| 3.0|
+|2021-07-01T12:00:30.000+08:00| 4.0|
+|2021-07-01T12:00:40.000+08:00| 5.0|
+|2021-07-01T12:00:50.000+08:00| 6.0|
+|2021-07-01T12:01:00.000+08:00| 7.0|
+|2021-07-01T12:01:10.000+08:00| 8.0|
+|2021-07-01T12:01:20.000+08:00| 9.0|
+|2021-07-01T12:01:30.000+08:00| 10.0|
++-----------------------------+----------------------------------------------------+
+```
+
+###### 自动推算标准时间间隔
+
+如果`interval`参数没有给定,本函数将按照推算的标准时间间隔进行修复。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select timestamprepair(s1) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------+
+| Time|timestamprepair(root.test.d2.s1)|
++-----------------------------+--------------------------------+
+|2021-07-01T12:00:00.000+08:00| 1.0|
+|2021-07-01T12:00:10.000+08:00| 2.0|
+|2021-07-01T12:00:20.000+08:00| 3.0|
+|2021-07-01T12:00:30.000+08:00| 4.0|
+|2021-07-01T12:00:40.000+08:00| 5.0|
+|2021-07-01T12:00:50.000+08:00| 6.0|
+|2021-07-01T12:01:00.000+08:00| 7.0|
+|2021-07-01T12:01:10.000+08:00| 8.0|
+|2021-07-01T12:01:20.000+08:00| 9.0|
+|2021-07-01T12:01:30.000+08:00| 10.0|
++-----------------------------+--------------------------------+
+```
+
+#### ValueFill
+
+##### 函数简介
+
+**函数名:** ValueFill
+
+**输入序列:** 单列时序数据,类型为INT32 / INT64 / FLOAT / DOUBLE
+
+**参数:**
+
++ `method`: {"mean", "previous", "linear", "likelihood", "AR", "MA", "SCREEN"}, 默认为 "linear"。其中,“mean” 指使用均值填补的方法; “previous" 指使用前值填补方法;“linear" 指使用线性插值填补方法;“likelihood” 为基于速度的正态分布的极大似然估计方法;“AR” 指自回归的填补方法;“MA” 指滑动平均的填补方法;"SCREEN" 指约束填补方法;缺省情况下使用 “linear”。
+
+**输出序列:** 填补后的单维序列。
+
+**备注:** AR 模型采用 AR(1),时序列需满足自相关条件,否则将输出单个数据点 (0, 0.0).
+
+##### 使用示例
+###### 使用 linear 方法进行填补
+
+当`method`缺省或取值为 'linear' 时,本函数将使用线性插值方法进行填补。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| NaN|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| NaN|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| NaN|
+|2020-01-01T00:00:22.000+08:00| NaN|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| 128.0|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select valuefill(s1) from root.test.d2
+```
+
+输出序列:
+
+
+
+```
++-----------------------------+-----------------------+
+| Time|valuefill(root.test.d2)|
++-----------------------------+-----------------------+
+|2020-01-01T00:00:02.000+08:00| NaN|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 108.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.7|
+|2020-01-01T00:00:22.000+08:00| 121.3|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| 128.0|
++-----------------------------+-----------------------+
+```
+
+###### 使用 previous 方法进行填补
+
+当`method`取值为 'previous' 时,本函数将使前值填补方法进行数值填补。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select valuefill(s1,"method"="previous") from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------------+
+| Time|valuefill(root.test.d2,"method"="previous")|
++-----------------------------+-------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| NaN|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 110.5|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 116.0|
+|2020-01-01T00:00:22.000+08:00| 116.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| 128.0|
++-----------------------------+-------------------------------------------+
+```
+
+#### ValueRepair
+
+##### 函数简介
+
+本函数用于对时间序列的数值进行修复。目前,本函数支持两种修复方法:**Screen** 是一种基于速度阈值的方法,在最小改动的前提下使得所有的速度符合阈值要求;**LsGreedy** 是一种基于速度变化似然的方法,将速度变化建模为高斯分布,并采用贪心算法极大化似然函数。
+
+**函数名:** VALUEREPAIR
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `method`:修复时采用的方法,取值为 'Screen' 或 'LsGreedy'. 在缺省情况下,使用 Screen 方法进行修复。
++ `minSpeed`:该参数仅在使用 Screen 方法时有效。当速度小于该值时会被视作数值异常点加以修复。在缺省情况下为中位数减去三倍绝对中位差。
++ `maxSpeed`:该参数仅在使用 Screen 方法时有效。当速度大于该值时会被视作数值异常点加以修复。在缺省情况下为中位数加上三倍绝对中位差。
++ `center`:该参数仅在使用 LsGreedy 方法时有效。对速度变化分布建立的高斯模型的中心。在缺省情况下为 0。
++ `sigma` :该参数仅在使用 LsGreedy 方法时有效。对速度变化分布建立的高斯模型的标准差。在缺省情况下为绝对中位差。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。该序列是修复后的输入序列。
+
+**提示:** 输入序列中的`NaN`在修复之前会先进行线性插值填补。
+
+##### 使用示例
+
+###### 使用 Screen 方法进行修复
+
+当`method`缺省或取值为 'Screen' 时,本函数将使用 Screen 方法进行数值修复。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 126.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 100.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| NaN|
++-----------------------------+---------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select valuerepair(s1) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+----------------------------+
+| Time|valuerepair(root.test.d2.s1)|
++-----------------------------+----------------------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 106.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| 128.0|
++-----------------------------+----------------------------+
+```
+
+###### 使用 LsGreedy 方法进行修复
+
+当`method`取值为 'LsGreedy' 时,本函数将使用 LsGreedy 方法进行数值修复。
+
+输入序列同上,用于查询的 SQL 语句如下:
+
+```sql
+select valuerepair(s1,'method'='LsGreedy') from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------------------+
+| Time|valuerepair(root.test.d2.s1, "method"="LsGreedy")|
++-----------------------------+-------------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:03.000+08:00| 101.0|
+|2020-01-01T00:00:04.000+08:00| 102.0|
+|2020-01-01T00:00:06.000+08:00| 104.0|
+|2020-01-01T00:00:08.000+08:00| 106.0|
+|2020-01-01T00:00:10.000+08:00| 108.0|
+|2020-01-01T00:00:14.000+08:00| 112.0|
+|2020-01-01T00:00:15.000+08:00| 113.0|
+|2020-01-01T00:00:16.000+08:00| 114.0|
+|2020-01-01T00:00:18.000+08:00| 116.0|
+|2020-01-01T00:00:20.000+08:00| 118.0|
+|2020-01-01T00:00:22.000+08:00| 120.0|
+|2020-01-01T00:00:26.000+08:00| 124.0|
+|2020-01-01T00:00:28.000+08:00| 126.0|
+|2020-01-01T00:00:30.000+08:00| 128.0|
++-----------------------------+-------------------------------------------------+
+```
+
+#### MasterRepair
+
+##### 函数简介
+
+本函数实现基于主数据的时间序列数据修复。
+
+**函数名:**MasterRepair
+
+**输入序列:** 支持多个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
+- `omega`:算法窗口大小,非负整数(单位为毫秒), 在缺省情况下,算法根据不同时间差下的两个元组距离自动估计该参数。
+- `eta`:算法距离阈值,正数, 在缺省情况下,算法根据窗口中元组的距离分布自动估计该参数。
+- `k`:主数据中的近邻数量,正整数, 在缺省情况下,算法根据主数据中的k个近邻的元组距离自动估计该参数。
+- `output_column`:输出列的序号,默认输出第一列的修复结果。
+
+**输出序列:**输出单个序列,类型与输入数据中对应列的类型相同,序列为输入列修复后的结果。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+------------+------------+------------+------------+------------+------------+
+| Time|root.test.t1|root.test.t2|root.test.t3|root.test.m1|root.test.m2|root.test.m3|
++-----------------------------+------------+------------+------------+------------+------------+------------+
+|2021-07-01T12:00:01.000+08:00| 1704| 1154.55| 0.195| 1704| 1154.55| 0.195|
+|2021-07-01T12:00:02.000+08:00| 1702| 1152.30| 0.193| 1702| 1152.30| 0.193|
+|2021-07-01T12:00:03.000+08:00| 1702| 1148.65| 0.192| 1702| 1148.65| 0.192|
+|2021-07-01T12:00:04.000+08:00| 1701| 1145.20| 0.194| 1701| 1145.20| 0.194|
+|2021-07-01T12:00:07.000+08:00| 1703| 1150.55| 0.195| 1703| 1150.55| 0.195|
+|2021-07-01T12:00:08.000+08:00| 1694| 1151.55| 0.193| 1704| 1151.55| 0.193|
+|2021-07-01T12:01:09.000+08:00| 1705| 1153.55| 0.194| 1705| 1153.55| 0.194|
+|2021-07-01T12:01:10.000+08:00| 1706| 1152.30| 0.190| 1706| 1152.30| 0.190|
++-----------------------------+------------+------------+------------+------------+------------+------------+
+```
+
+用于查询的 SQL 语句:
+
+```sql
+select MasterRepair(t1,t2,t3,m1,m2,m3) from root.test
+```
+
+输出序列:
+
+
+```
++-----------------------------+-------------------------------------------------------------------------------------------+
+| Time|MasterRepair(root.test.t1,root.test.t2,root.test.t3,root.test.m1,root.test.m2,root.test.m3)|
++-----------------------------+-------------------------------------------------------------------------------------------+
+|2021-07-01T12:00:01.000+08:00| 1704|
+|2021-07-01T12:00:02.000+08:00| 1702|
+|2021-07-01T12:00:03.000+08:00| 1702|
+|2021-07-01T12:00:04.000+08:00| 1701|
+|2021-07-01T12:00:07.000+08:00| 1703|
+|2021-07-01T12:00:08.000+08:00| 1704|
+|2021-07-01T12:01:09.000+08:00| 1705|
+|2021-07-01T12:01:10.000+08:00| 1706|
++-----------------------------+-------------------------------------------------------------------------------------------+
+```
+
+#### SeasonalRepair
+
+##### 函数简介
+本函数用于对周期性时间序列的数值进行基于分解的修复。目前,本函数支持两种方法:**Classical**使用经典分解方法得到的残差项检测数值的异常波动,并使用滑动平均修复序列;**Improved**使用改进的分解方法得到的残差项检测数值的异常波动,并使用滑动中值修复序列。
+
+**函数名:** SEASONALREPAIR
+
+**输入序列:** 仅支持单个输入序列,类型为 INT32 / INT64 / FLOAT / DOUBLE。
+
+**参数:**
+
++ `method`:修复时采用的分解方法,取值为'Classical'或'Improved'。在缺省情况下,使用经典分解方法进行修复。
++ `period`:序列的周期。
++ `k`:残差项的范围阈值,用来限制残差项偏离中心的程度。在缺省情况下为9。
++ `max_iter`:算法的最大迭代次数。在缺省情况下为10。
+
+**输出序列:** 输出单个序列,类型与输入序列相同。该序列是修复后的输入序列。
+
+**提示:** 输入序列中的`NaN`在修复之前会先进行线性插值填补。
+
+##### 使用示例
+###### 使用经典分解方法进行修复
+当`method`缺省或取值为'Classical'时,本函数将使用经典分解方法进行数值修复。
+
+输入序列:
+
+```
++-----------------------------+---------------+
+| Time|root.test.d2.s1|
++-----------------------------+---------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:04.000+08:00| 120.0|
+|2020-01-01T00:00:06.000+08:00| 80.0|
+|2020-01-01T00:00:08.000+08:00| 100.5|
+|2020-01-01T00:00:10.000+08:00| 119.5|
+|2020-01-01T00:00:12.000+08:00| 101.0|
+|2020-01-01T00:00:14.000+08:00| 99.5|
+|2020-01-01T00:00:16.000+08:00| 119.0|
+|2020-01-01T00:00:18.000+08:00| 80.5|
+|2020-01-01T00:00:20.000+08:00| 99.0|
+|2020-01-01T00:00:22.000+08:00| 121.0|
+|2020-01-01T00:00:24.000+08:00| 79.5|
++-----------------------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select seasonalrepair(s1,'period'=3,'k'=2) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------------+
+| Time|seasonalrepair(root.test.d2.s1, 'period'=4, 'k'=2)|
++-----------------------------+--------------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:04.000+08:00| 120.0|
+|2020-01-01T00:00:06.000+08:00| 80.0|
+|2020-01-01T00:00:08.000+08:00| 100.5|
+|2020-01-01T00:00:10.000+08:00| 119.5|
+|2020-01-01T00:00:12.000+08:00| 87.0|
+|2020-01-01T00:00:14.000+08:00| 99.5|
+|2020-01-01T00:00:16.000+08:00| 119.0|
+|2020-01-01T00:00:18.000+08:00| 80.5|
+|2020-01-01T00:00:20.000+08:00| 99.0|
+|2020-01-01T00:00:22.000+08:00| 121.0|
+|2020-01-01T00:00:24.000+08:00| 79.5|
++-----------------------------+--------------------------------------------------+
+```
+
+###### 使用改进的分解方法进行修复
+当`method`取值为'Improved'时,本函数将使用改进的分解方法进行数值修复。
+
+输入序列同上,用于查询的SQL语句如下:
+
+```sql
+select seasonalrepair(s1,'method'='improved','period'=3) from root.test.d2
+```
+
+输出序列:
+
+```
++-----------------------------+-------------------------------------------------------------+
+| Time|valuerepair(root.test.d2.s1, 'method'='improved', 'period'=3)|
++-----------------------------+-------------------------------------------------------------+
+|2020-01-01T00:00:02.000+08:00| 100.0|
+|2020-01-01T00:00:04.000+08:00| 120.0|
+|2020-01-01T00:00:06.000+08:00| 80.0|
+|2020-01-01T00:00:08.000+08:00| 100.5|
+|2020-01-01T00:00:10.000+08:00| 119.5|
+|2020-01-01T00:00:12.000+08:00| 81.5|
+|2020-01-01T00:00:14.000+08:00| 99.5|
+|2020-01-01T00:00:16.000+08:00| 119.0|
+|2020-01-01T00:00:18.000+08:00| 80.5|
+|2020-01-01T00:00:20.000+08:00| 99.0|
+|2020-01-01T00:00:22.000+08:00| 121.0|
+|2020-01-01T00:00:24.000+08:00| 79.5|
++-----------------------------+-------------------------------------------------------------+
+```
+
+### 序列发现
+
+#### ConsecutiveSequences
+
+##### 函数简介
+
+本函数用于在多维严格等间隔数据中发现局部最长连续子序列。
+
+严格等间隔数据是指数据的时间间隔是严格相等的,允许存在数据缺失(包括行缺失和值缺失),但不允许存在数据冗余和时间戳偏移。
+
+连续子序列是指严格按照标准时间间隔等距排布,不存在任何数据缺失的子序列。如果某个连续子序列不是任何连续子序列的真子序列,那么它是局部最长的。
+
+
+**函数名:** CONSECUTIVESEQUENCES
+
+**输入序列:** 支持多个输入序列,类型可以是任意的,但要满足严格等间隔的要求。
+
+**参数:**
+
++ `gap`:标准时间间隔,是一个有单位的正数。目前支持五种单位,分别是'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。在缺省情况下,函数会利用众数估计标准时间间隔。
+
+**输出序列:** 输出单个序列,类型为 INT32。输出序列中的每一个数据点对应一个局部最长连续子序列,时间戳为子序列的起始时刻,值为子序列包含的数据点个数。
+
+**提示:** 对于不符合要求的输入,本函数不对输出做任何保证。
+
+##### 使用示例
+
+###### 手动指定标准时间间隔
+
+本函数可以通过`gap`参数手动指定标准时间间隔。需要注意的是,错误的参数设置会导致输出产生严重错误。
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d1.s1|root.test.d1.s2|
++-----------------------------+---------------+---------------+
+|2020-01-01T00:00:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:05:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:10:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:20:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:25:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:30:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:35:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:40:00.000+08:00| 1.0| null|
+|2020-01-01T00:45:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:50:00.000+08:00| 1.0| 1.0|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select consecutivesequences(s1,s2,'gap'='5m') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------------------+
+| Time|consecutivesequences(root.test.d1.s1, root.test.d1.s2, "gap"="5m")|
++-----------------------------+------------------------------------------------------------------+
+|2020-01-01T00:00:00.000+08:00| 3|
+|2020-01-01T00:20:00.000+08:00| 4|
+|2020-01-01T00:45:00.000+08:00| 2|
++-----------------------------+------------------------------------------------------------------+
+```
+
+###### 自动估计标准时间间隔
+
+当`gap`参数缺省时,本函数可以利用众数估计标准时间间隔,得到同样的结果。因此,这种用法更受推荐。
+
+输入序列同上,用于查询的SQL语句如下:
+
+```sql
+select consecutivesequences(s1,s2) from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+------------------------------------------------------+
+| Time|consecutivesequences(root.test.d1.s1, root.test.d1.s2)|
++-----------------------------+------------------------------------------------------+
+|2020-01-01T00:00:00.000+08:00| 3|
+|2020-01-01T00:20:00.000+08:00| 4|
+|2020-01-01T00:45:00.000+08:00| 2|
++-----------------------------+------------------------------------------------------+
+```
+
+#### ConsecutiveWindows
+
+##### 函数简介
+
+本函数用于在多维严格等间隔数据中发现指定长度的连续窗口。
+
+严格等间隔数据是指数据的时间间隔是严格相等的,允许存在数据缺失(包括行缺失和值缺失),但不允许存在数据冗余和时间戳偏移。
+
+连续窗口是指严格按照标准时间间隔等距排布,不存在任何数据缺失的子序列。
+
+
+**函数名:** CONSECUTIVEWINDOWS
+
+**输入序列:** 支持多个输入序列,类型可以是任意的,但要满足严格等间隔的要求。
+
+**参数:**
+
++ `gap`:标准时间间隔,是一个有单位的正数。目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。在缺省情况下,函数会利用众数估计标准时间间隔。
++ `length`:序列长度,是一个有单位的正数。目前支持五种单位,分别是 'ms'(毫秒)、's'(秒)、'm'(分钟)、'h'(小时)和'd'(天)。该参数不允许缺省。
+
+**输出序列:** 输出单个序列,类型为 INT32。输出序列中的每一个数据点对应一个指定长度连续子序列,时间戳为子序列的起始时刻,值为子序列包含的数据点个数。
+
+**提示:** 对于不符合要求的输入,本函数不对输出做任何保证。
+
+##### 使用示例
+
+输入序列:
+
+```
++-----------------------------+---------------+---------------+
+| Time|root.test.d1.s1|root.test.d1.s2|
++-----------------------------+---------------+---------------+
+|2020-01-01T00:00:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:05:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:10:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:20:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:25:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:30:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:35:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:40:00.000+08:00| 1.0| null|
+|2020-01-01T00:45:00.000+08:00| 1.0| 1.0|
+|2020-01-01T00:50:00.000+08:00| 1.0| 1.0|
++-----------------------------+---------------+---------------+
+```
+
+用于查询的SQL语句:
+
+```sql
+select consecutivewindows(s1,s2,'length'='10m') from root.test.d1
+```
+
+输出序列:
+
+```
++-----------------------------+--------------------------------------------------------------------+
+| Time|consecutivewindows(root.test.d1.s1, root.test.d1.s2, "length"="10m")|
++-----------------------------+--------------------------------------------------------------------+
+|2020-01-01T00:00:00.000+08:00| 3|
+|2020-01-01T00:20:00.000+08:00| 3|
+|2020-01-01T00:25:00.000+08:00| 3|
++-----------------------------+--------------------------------------------------------------------+
+```
\ No newline at end of file
diff --git a/docs/zh/UserGuide/User-Manuel/Delete-Data.md b/docs/zh/UserGuide/User-Manuel/Delete-Data.md
new file mode 100644
index 00000000000..672b9885cb1
--- /dev/null
+++ b/docs/zh/UserGuide/User-Manuel/Delete-Data.md
@@ -0,0 +1,160 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 删除数据
+
+用户使用 [DELETE 语句](../Reference/SQL-Reference.md) 可以删除指定的时间序列中符合时间删除条件的数据。在删除数据时,用户可以选择需要删除的一个或多个时间序列、时间序列的前缀、时间序列带、*路径对某一个时间区间内的数据进行删除。
+
+在 JAVA 编程环境中,您可以使用 JDBC API 单条或批量执行 DELETE 语句。
+
+## 单传感器时间序列值删除
+
+以测控 ln 集团为例,存在这样的使用场景:
+
+wf02 子站的 wt02 设备在 2017-11-01 16:26:00 之前的供电状态出现多段错误,且无法分析其正确数据,错误数据影响了与其他设备的关联分析。此时,需要将此时间段前的数据删除。进行此操作的 SQL 语句为:
+
+```sql
+delete from root.ln.wf02.wt02.status where time<=2017-11-01T16:26:00;
+```
+
+如果我们仅仅想要删除 2017 年内的在 2017-11-01 16:26:00 之前的数据,可以使用以下 SQL:
+```sql
+delete from root.ln.wf02.wt02.status where time>=2017-01-01T00:00:00 and time<=2017-11-01T16:26:00;
+```
+
+IoTDB 支持删除一个时间序列任何一个时间范围内的所有时序点,用户可以使用以下 SQL 语句指定需要删除的时间范围:
+```sql
+delete from root.ln.wf02.wt02.status where time < 10
+delete from root.ln.wf02.wt02.status where time <= 10
+delete from root.ln.wf02.wt02.status where time < 20 and time > 10
+delete from root.ln.wf02.wt02.status where time <= 20 and time >= 10
+delete from root.ln.wf02.wt02.status where time > 20
+delete from root.ln.wf02.wt02.status where time >= 20
+delete from root.ln.wf02.wt02.status where time = 20
+```
+
+需要注意,当前的删除语句不支持 where 子句后的时间范围为多个由 OR 连接成的时间区间。如下删除语句将会解析出错:
+```
+delete from root.ln.wf02.wt02.status where time > 4 or time < 0
+Msg: 303: Check metadata error: For delete statement, where clause can only contain atomic
+expressions like : time > XXX, time <= XXX, or two atomic expressions connected by 'AND'
+```
+
+如果 delete 语句中未指定 where 子句,则会删除时间序列中的所有数据。
+```sql
+delete from root.ln.wf02.wt02.status
+```
+
+## 多传感器时间序列值删除
+
+当 ln 集团 wf02 子站的 wt02 设备在 2017-11-01 16:26:00 之前的供电状态和设备硬件版本都需要删除,此时可以使用含义更广的 [路径模式(Path Pattern)](../Basic-Concept/Data-Model-and-Terminology.md) 进行删除操作,进行此操作的 SQL 语句为:
+
+
+```sql
+delete from root.ln.wf02.wt02.* where time <= 2017-11-01T16:26:00;
+```
+
+需要注意的是,当删除的路径不存在时,IoTDB 不会提示路径不存在,而是显示执行成功,因为 SQL 是一种声明式的编程方式,除非是语法错误、权限不足等,否则都不认为是错误,如下所示。
+
+```sql
+IoTDB> delete from root.ln.wf03.wt02.status where time < now()
+Msg: The statement is executed successfully.
+```
+
+## 删除时间分区 (实验性功能)
+您可以通过如下语句来删除某一个 database 下的指定时间分区:
+
+```sql
+DELETE PARTITION root.ln 0,1,2
+```
+
+上例中的 0,1,2 为待删除时间分区的 id,您可以通过查看 IoTDB 的数据文件夹找到它,或者可以通过计算`timestamp / partitionInterval`(向下取整),
+手动地将一个时间戳转换为对应的 id,其中的`partitionInterval`可以在 IoTDB 的配置文件中找到(如果您使用的版本支持时间分区)。
+
+请注意该功能目前只是实验性的,如果您不是开发者,使用时请务必谨慎。
+
+## 数据存活时间(TTL)
+
+IoTDB 支持对 database 级别设置数据存活时间(TTL),这使得 IoTDB 可以定期、自动地删除一定时间之前的数据。合理使用 TTL
+可以帮助您控制 IoTDB 占用的总磁盘空间以避免出现磁盘写满等异常。并且,随着文件数量的增多,查询性能往往随之下降,
+内存占用也会有所提高。及时地删除一些较老的文件有助于使查询性能维持在一个较高的水平和减少内存资源的占用。
+
+TTL的默认单位为毫秒,如果配置文件中的时间精度修改为其他单位,设置ttl时仍然使用毫秒单位。
+
+### 设置 TTL
+
+设置 TTL 的 SQL 语句如下所示:
+```
+IoTDB> set ttl to root.ln 3600000
+```
+这个例子表示在`root.ln`数据库中,只有3600000毫秒,即最近一个小时的数据将会保存,旧数据会被移除或不可见。
+```
+IoTDB> set ttl to root.sgcc.** 3600000
+```
+支持给某一路径下的 database 设置TTL,这个例子表示`root.sgcc`路径下的所有 database 设置TTL。
+```
+IoTDB> set ttl to root.** 3600000
+```
+表示给所有 database 设置TTL。
+
+### 取消 TTL
+
+取消 TTL 的 SQL 语句如下所示:
+
+```
+IoTDB> unset ttl to root.ln
+```
+
+取消设置 TTL 后, database `root.ln`中所有的数据都会被保存。
+```
+IoTDB> unset ttl to root.sgcc.**
+```
+
+取消设置`root.sgcc`路径下的所有 database 的 TTL 。
+```
+IoTDB> unset ttl to root.**
+```
+
+取消设置所有 database 的 TTL 。
+
+### 显示 TTL
+
+显示 TTL 的 SQL 语句如下所示:
+
+```
+IoTDB> SHOW ALL TTL
+IoTDB> SHOW TTL ON StorageGroupNames
+```
+
+SHOW ALL TTL 这个例子会给出所有 database 的 TTL。
+SHOW TTL ON root.ln,root.sgcc,root.DB 这个例子会显示指定的三个 database 的 TTL。
+注意:没有设置 TTL 的 database 的 TTL 将显示为 null。
+
+```
+IoTDB> show all ttl
++-------------+-------+
+| database|ttl(ms)|
++-------------+-------+
+| root.ln|3600000|
+| root.sgcc| null|
+| root.DB|3600000|
++-------------+-------+
+```
\ No newline at end of file
diff --git a/docs/zh/UserGuide/User-Manuel/Operate-Metadata.md b/docs/zh/UserGuide/User-Manuel/Operate-Metadata.md
new file mode 100644
index 00000000000..a52126125c6
--- /dev/null
+++ b/docs/zh/UserGuide/User-Manuel/Operate-Metadata.md
@@ -0,0 +1,1182 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 元数据操作
+## 数据库管理
+
+数据库(Database)可以被视为关系数据库中的Database。
+
+### 创建数据库
+
+我们可以根据存储模型建立相应的数据库。如下所示:
+
+```
+IoTDB > CREATE DATABASE root.ln
+```
+
+需要注意的是,database 的父子节点都不能再设置 database。例如在已经有`root.ln`和`root.sgcc`这两个 database 的情况下,创建`root.ln.wf01` database 是不可行的。系统将给出相应的错误提示,如下所示:
+
+```
+IoTDB> CREATE DATABASE root.ln.wf01
+Msg: 300: root.ln has already been created as database.
+```
+Database 节点名只支持中英文字符、数字、下划线的组合,如果想设置为纯数字或者包含其他字符,需要用反引号(``)把 database 名称引起来。
+
+还需注意,如果在 Windows 系统上部署,database 名是大小写不敏感的。例如同时创建`root.ln` 和 `root.LN` 是不被允许的。
+
+### 查看数据库
+
+在 database 创建后,我们可以使用 [SHOW DATABASES](../Reference/SQL-Reference.md) 语句和 [SHOW DATABASES \<PathPattern>](../Reference/SQL-Reference.md) 来查看 database,SQL 语句如下所示:
+
+```
+IoTDB> show databases
+IoTDB> show databases root.*
+IoTDB> show databases root.**
+```
+
+执行结果为:
+
+```
++-------------+----+-------------------------+-----------------------+-----------------------+
+| database| ttl|schema_replication_factor|data_replication_factor|time_partition_interval|
++-------------+----+-------------------------+-----------------------+-----------------------+
+| root.sgcc|null| 2| 2| 604800|
+| root.ln|null| 2| 2| 604800|
++-------------+----+-------------------------+-----------------------+-----------------------+
+Total line number = 2
+It costs 0.060s
+```
+
+### 删除数据库
+
+用户可以使用`DELETE DATABASE <PathPattern>`语句删除该路径模式匹配的所有的数据库。在删除的过程中,需要注意的是数据库的数据也会被删除。
+
+```
+IoTDB > DELETE DATABASE root.ln
+IoTDB > DELETE DATABASE root.sgcc
+// 删除所有数据,时间序列以及数据库
+IoTDB > DELETE DATABASE root.**
+```
+
+### 统计数据库数量
+
+用户可以使用`COUNT DATABASES <PathPattern>`语句统计数据库的数量,允许指定`PathPattern` 用来统计匹配该`PathPattern` 的数据库的数量
+
+SQL 语句如下所示:
+
+```
+IoTDB> show databases
+IoTDB> count databases
+IoTDB> count databases root.*
+IoTDB> count databases root.sgcc.*
+IoTDB> count databases root.sgcc
+```
+
+执行结果为:
+
+```
++-------------+
+| database|
++-------------+
+| root.sgcc|
+| root.turbine|
+| root.ln|
++-------------+
+Total line number = 3
+It costs 0.003s
+
++-------------+
+| Database|
++-------------+
+| 3|
++-------------+
+Total line number = 1
+It costs 0.003s
+
++-------------+
+| Database|
++-------------+
+| 3|
++-------------+
+Total line number = 1
+It costs 0.002s
+
++-------------+
+| Database|
++-------------+
+| 0|
++-------------+
+Total line number = 1
+It costs 0.002s
+
++-------------+
+| database|
++-------------+
+| 1|
++-------------+
+Total line number = 1
+It costs 0.002s
+```
+
+### TTL
+
+IoTDB 支持对 database 级别设置数据存活时间(TTL),这使得 IoTDB 可以定期、自动地删除一定时间之前的数据。合理使用 TTL
+可以帮助您控制 IoTDB 占用的总磁盘空间以避免出现磁盘写满等异常。并且,随着文件数量的增多,查询性能往往随之下降,
+内存占用也会有所提高。及时地删除一些较老的文件有助于使查询性能维持在一个较高的水平和减少内存资源的占用。
+
+TTL的默认单位为毫秒,如果配置文件中的时间精度修改为其他单位,设置ttl时仍然使用毫秒单位。
+
+#### 设置 TTL
+
+设置 TTL 的 SQL 语句如下所示:
+```
+IoTDB> set ttl to root.ln 3600000
+```
+这个例子表示在`root.ln`数据库中,只有3600000毫秒,即最近一个小时的数据将会保存,旧数据会被移除或不可见。
+```
+IoTDB> set ttl to root.sgcc.** 3600000
+```
+支持给某一路径下的 database 设置TTL,这个例子表示`root.sgcc`路径下的所有 database 设置TTL。
+```
+IoTDB> set ttl to root.** 3600000
+```
+表示给所有 database 设置TTL。
+
+#### 取消 TTL
+
+取消 TTL 的 SQL 语句如下所示:
+
+```
+IoTDB> unset ttl to root.ln
+```
+
+取消设置 TTL 后, database `root.ln`中所有的数据都会被保存。
+```
+IoTDB> unset ttl to root.sgcc.**
+```
+
+取消设置`root.sgcc`路径下的所有 database 的 TTL 。
+```
+IoTDB> unset ttl to root.**
+```
+
+取消设置所有 database 的 TTL 。
+
+#### 显示 TTL
+
+显示 TTL 的 SQL 语句如下所示:
+
+```
+IoTDB> SHOW ALL TTL
+IoTDB> SHOW TTL ON StorageGroupNames
+```
+
+SHOW ALL TTL 这个例子会给出所有 database 的 TTL。
+SHOW TTL ON root.ln,root.sgcc,root.DB 这个例子会显示指定的三个 database 的 TTL。
+注意:没有设置 TTL 的 database 的 TTL 将显示为 null。
+
+```
+IoTDB> show all ttl
++-------------+-------+
+| database|ttl(ms)|
++-------------+-------+
+| root.ln|3600000|
+| root.sgcc| null|
+| root.DB|3600000|
++-------------+-------+
+```
+
+
+
+### 设置异构数据库(进阶操作)
+
+在熟悉 IoTDB 元数据建模的前提下,用户可以在 IoTDB 中设置异构的数据库,以便应对不同的生产需求。
+
+目前支持的数据库异构参数有:
+
+| 参数名 | 参数类型 | 参数描述 |
+|---------------------------|---------|---------------------------|
+| TTL | Long | 数据库的 TTL |
+| SCHEMA_REPLICATION_FACTOR | Integer | 数据库的元数据副本数 |
+| DATA_REPLICATION_FACTOR | Integer | 数据库的数据副本数 |
+| SCHEMA_REGION_GROUP_NUM | Integer | 数据库的 SchemaRegionGroup 数量 |
+| DATA_REGION_GROUP_NUM | Integer | 数据库的 DataRegionGroup 数量 |
+
+用户在配置异构参数时需要注意以下三点:
++ TTL 和 TIME_PARTITION_INTERVAL 必须为正整数。
++ SCHEMA_REPLICATION_FACTOR 和 DATA_REPLICATION_FACTOR 必须小于等于已部署的 DataNode 数量。
++ SCHEMA_REGION_GROUP_NUM 和 DATA_REGION_GROUP_NUM 的功能与 iotdb-common.properties 配置文件中的
+`schema_region_group_extension_policy` 和 `data_region_group_extension_policy` 参数相关,以 DATA_REGION_GROUP_NUM 为例:
+若设置 `data_region_group_extension_policy=CUSTOM`,则 DATA_REGION_GROUP_NUM 将作为 Database 拥有的 DataRegionGroup 的数量;
+若设置 `data_region_group_extension_policy=AUTO`,则 DATA_REGION_GROUP_NUM 将作为 Database 拥有的 DataRegionGroup 的配额下界,即当该 Database 开始写入数据时,将至少拥有此数量的 DataRegionGroup。
+
+用户可以在创建 Database 时设置任意异构参数,或在单机/分布式 IoTDB 运行时调整部分异构参数。
+
+#### 创建 Database 时设置异构参数
+
+用户可以在创建 Database 时设置上述任意异构参数,SQL 语句如下所示:
+
+```
+CREATE DATABASE prefixPath (WITH databaseAttributeClause (COMMA? databaseAttributeClause)*)?
+```
+
+例如:
+```
+CREATE DATABASE root.db WITH SCHEMA_REPLICATION_FACTOR=1, DATA_REPLICATION_FACTOR=3, SCHEMA_REGION_GROUP_NUM=1, DATA_REGION_GROUP_NUM=2;
+```
+
+#### 运行时调整异构参数
+
+用户可以在 IoTDB 运行时调整部分异构参数,SQL 语句如下所示:
+
+```
+ALTER DATABASE prefixPath WITH databaseAttributeClause (COMMA? databaseAttributeClause)*
+```
+
+例如:
+```
+ALTER DATABASE root.db WITH SCHEMA_REGION_GROUP_NUM=1, DATA_REGION_GROUP_NUM=2;
+```
+
+注意,运行时只能调整下列异构参数:
++ SCHEMA_REGION_GROUP_NUM
++ DATA_REGION_GROUP_NUM
+
+#### 查看异构数据库
+
+用户可以查询每个 Database 的具体异构配置,SQL 语句如下所示:
+
+```
+SHOW DATABASES DETAILS prefixPath?
+```
+
+例如:
+
+```
+IoTDB> SHOW DATABASES DETAILS
++--------+--------+-----------------------+---------------------+---------------------+--------------------+-----------------------+-----------------------+------------------+---------------------+---------------------+
+|Database| TTL|SchemaReplicationFactor|DataReplicationFactor|TimePartitionInterval|SchemaRegionGroupNum|MinSchemaRegionGroupNum|MaxSchemaRegionGroupNum|DataRegionGroupNum|MinDataRegionGroupNum|MaxDataRegionGroupNum|
++--------+--------+-----------------------+---------------------+---------------------+--------------------+-----------------------+-----------------------+------------------+---------------------+---------------------+
+|root.db1| null| 1| 3| 604800000| 0| 1| 1| 0| 2| 2|
+|root.db2|86400000| 1| 1| 604800000| 0| 1| 1| 0| 2| 2|
+|root.db3| null| 1| 1| 604800000| 0| 1| 1| 0| 2| 2|
++--------+--------+-----------------------+---------------------+---------------------+--------------------+-----------------------+-----------------------+------------------+---------------------+---------------------+
+Total line number = 3
+It costs 0.058s
+```
+
+各列查询结果依次为:
++ 数据库名称
++ 数据库的 TTL
++ 数据库的元数据副本数
++ 数据库的数据副本数
++ 数据库的时间分区间隔
++ 数据库当前拥有的 SchemaRegionGroup 数量
++ 数据库需要拥有的最小 SchemaRegionGroup 数量
++ 数据库允许拥有的最大 SchemaRegionGroup 数量
++ 数据库当前拥有的 DataRegionGroup 数量
++ 数据库需要拥有的最小 DataRegionGroup 数量
++ 数据库允许拥有的最大 DataRegionGroup 数量
+
+
+## 元数据模板管理
+
+IoTDB 支持元数据模板功能,实现同类型不同实体的物理量元数据共享,减少元数据内存占用,同时简化同类型实体的管理。
+
+注:以下语句中的 `schema` 关键字可以省略。
+
+### 创建元数据模板
+
+创建元数据模板的 SQL 语法如下:
+
+```sql
+CREATE SCHEMA TEMPLATE <templateName> ALIGNED? '(' <measurementId> <attributeClauses> [',' <measurementId> <attributeClauses>]+ ')'
+```
+
+**示例1:** 创建包含两个非对齐序列的元数据模板
+
+```shell
+IoTDB> create schema template t1 (temperature FLOAT encoding=RLE, status BOOLEAN encoding=PLAIN compression=SNAPPY)
+```
+
+**示例2:** 创建包含一组对齐序列的元数据模板
+
+```shell
+IoTDB> create schema template t2 aligned (lat FLOAT encoding=Gorilla, lon FLOAT encoding=Gorilla)
+```
+
+其中,物理量 `lat` 和 `lon` 是对齐的。
+
+### 挂载元数据模板
+
+元数据模板在创建后,需执行挂载操作,方可用于相应路径下的序列创建与数据写入。
+
+**挂载模板前,需确保相关数据库已经创建。**
+
+**推荐将模板挂载在 database 节点上,不建议将模板挂载到 database 上层的节点上。**
+
+**模板挂载路径下禁止创建普通序列,已创建了普通序列的前缀路径上不允许挂载模板。**
+
+挂载元数据模板的 SQL 语句如下所示:
+
+```shell
+IoTDB> set schema template t1 to root.sg1.d1
+```
+
+### 激活元数据模板
+
+挂载好元数据模板后,且系统开启自动注册序列功能的情况下,即可直接进行数据的写入。例如 database 为 root.sg1,模板 t1 被挂载到了节点 root.sg1.d1,那么可直接向时间序列(如 root.sg1.d1.temperature 和 root.sg1.d1.status)写入时间序列数据,该时间序列已可被当作正常创建的序列使用。
+
+**注意**:在插入数据之前或系统未开启自动注册序列功能,模板定义的时间序列不会被创建。可以使用如下SQL语句在插入数据前创建时间序列即激活模板:
+
+```shell
+IoTDB> create timeseries using schema template on root.sg1.d1
+```
+
+**示例:** 执行以下语句
+```shell
+IoTDB> set schema template t1 to root.sg1.d1
+IoTDB> set schema template t2 to root.sg1.d2
+IoTDB> create timeseries using schema template on root.sg1.d1
+IoTDB> create timeseries using schema template on root.sg1.d2
+```
+
+查看此时的时间序列:
+```sql
+show timeseries root.sg1.**
+```
+
+```shell
++-----------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression|tags|attributes|deadband|deadband parameters|
++-----------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+|root.sg1.d1.temperature| null| root.sg1| FLOAT| RLE| SNAPPY|null| null| null| null|
+| root.sg1.d1.status| null| root.sg1| BOOLEAN| PLAIN| SNAPPY|null| null| null| null|
+| root.sg1.d2.lon| null| root.sg1| FLOAT| GORILLA| SNAPPY|null| null| null| null|
+| root.sg1.d2.lat| null| root.sg1| FLOAT| GORILLA| SNAPPY|null| null| null| null|
++-----------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+```
+
+查看此时的设备:
+```sql
+show devices root.sg1.**
+```
+
+```shell
++---------------+---------+
+| devices|isAligned|
++---------------+---------+
+| root.sg1.d1| false|
+| root.sg1.d2| true|
++---------------+---------+
+```
+
+### 查看元数据模板
+
+- 查看所有元数据模板
+
+SQL 语句如下所示:
+
+```shell
+IoTDB> show schema templates
+```
+
+执行结果如下:
+```shell
++-------------+
+|template name|
++-------------+
+| t2|
+| t1|
++-------------+
+```
+
+- 查看某个元数据模板下的物理量
+
+SQL 语句如下所示:
+
+```shell
+IoTDB> show nodes in schema template t1
+```
+
+执行结果如下:
+```shell
++-----------+--------+--------+-----------+
+|child nodes|dataType|encoding|compression|
++-----------+--------+--------+-----------+
+|temperature| FLOAT| RLE| SNAPPY|
+| status| BOOLEAN| PLAIN| SNAPPY|
++-----------+--------+--------+-----------+
+```
+
+- 查看挂载了某个元数据模板的路径
+
+```shell
+IoTDB> show paths set schema template t1
+```
+
+执行结果如下:
+```shell
++-----------+
+|child paths|
++-----------+
+|root.sg1.d1|
++-----------+
+```
+
+- 查看使用了某个元数据模板的路径(即模板在该路径上已激活,序列已创建)
+
+```shell
+IoTDB> show paths using schema template t1
+```
+
+执行结果如下:
+```shell
++-----------+
+|child paths|
++-----------+
+|root.sg1.d1|
++-----------+
+```
+
+### 解除元数据模板
+
+若需删除模板表示的某一组时间序列,可采用解除模板操作,SQL语句如下所示:
+
+```shell
+IoTDB> delete timeseries of schema template t1 from root.sg1.d1
+```
+
+或
+
+```shell
+IoTDB> deactivate schema template t1 from root.sg1.d1
+```
+
+解除操作支持批量处理,SQL语句如下所示:
+
+```shell
+IoTDB> delete timeseries of schema template t1 from root.sg1.*, root.sg2.*
+```
+
+或
+
+```shell
+IoTDB> deactivate schema template t1 from root.sg1.*, root.sg2.*
+```
+
+若解除命令不指定模板名称,则会将给定路径涉及的所有模板使用情况均解除。
+
+### 卸载元数据模板
+
+卸载元数据模板的 SQL 语句如下所示:
+
+```shell
+IoTDB> unset schema template t1 from root.sg1.d1
+```
+
+**注意**:不支持卸载仍处于激活状态的模板,需保证执行卸载操作前解除对该模板的所有使用,即删除所有该模板表示的序列。
+
+### 删除元数据模板
+
+删除元数据模板的 SQL 语句如下所示:
+
+```shell
+IoTDB> drop schema template t1
+```
+
+**注意**:不支持删除已经挂载的模板,需在删除操作前保证该模板卸载成功。
+
+### 修改元数据模板
+
+在需要新增物理量的场景中,可以通过修改元数据模板来给所有已激活该模板的设备新增物理量。
+
+修改元数据模板的 SQL 语句如下所示:
+
+```shell
+IoTDB> alter schema template t1 add (speed FLOAT encoding=RLE, FLOAT TEXT encoding=PLAIN compression=SNAPPY)
+```
+
+**向已挂载模板的路径下的设备中写入数据,若写入请求中的物理量不在模板中,将自动扩展模板。**
+
+
+## 时间序列管理
+
+### 创建时间序列
+
+根据建立的数据模型,我们可以分别在两个存储组中创建相应的时间序列。创建时间序列的 SQL 语句如下所示:
+
+```
+IoTDB > create timeseries root.ln.wf01.wt01.status with datatype=BOOLEAN,encoding=PLAIN
+IoTDB > create timeseries root.ln.wf01.wt01.temperature with datatype=FLOAT,encoding=RLE
+IoTDB > create timeseries root.ln.wf02.wt02.hardware with datatype=TEXT,encoding=PLAIN
+IoTDB > create timeseries root.ln.wf02.wt02.status with datatype=BOOLEAN,encoding=PLAIN
+IoTDB > create timeseries root.sgcc.wf03.wt01.status with datatype=BOOLEAN,encoding=PLAIN
+IoTDB > create timeseries root.sgcc.wf03.wt01.temperature with datatype=FLOAT,encoding=RLE
+```
+
+从 v0.13 起,可以使用简化版的 SQL 语句创建时间序列:
+
+```
+IoTDB > create timeseries root.ln.wf01.wt01.status BOOLEAN encoding=PLAIN
+IoTDB > create timeseries root.ln.wf01.wt01.temperature FLOAT encoding=RLE
+IoTDB > create timeseries root.ln.wf02.wt02.hardware TEXT encoding=PLAIN
+IoTDB > create timeseries root.ln.wf02.wt02.status BOOLEAN encoding=PLAIN
+IoTDB > create timeseries root.sgcc.wf03.wt01.status BOOLEAN encoding=PLAIN
+IoTDB > create timeseries root.sgcc.wf03.wt01.temperature FLOAT encoding=RLE
+```
+
+需要注意的是,当创建时间序列时指定的编码方式与数据类型不对应时,系统会给出相应的错误提示,如下所示:
+```
+IoTDB> create timeseries root.ln.wf02.wt02.status WITH DATATYPE=BOOLEAN, ENCODING=TS_2DIFF
+error: encoding TS_2DIFF does not support BOOLEAN
+```
+
+详细的数据类型与编码方式的对应列表请参见 [编码方式](../Basic-Concept/Encoding.md)。
+
+### 创建对齐时间序列
+
+创建一组对齐时间序列的SQL语句如下所示:
+
+```
+IoTDB> CREATE ALIGNED TIMESERIES root.ln.wf01.GPS(latitude FLOAT encoding=PLAIN compressor=SNAPPY, longitude FLOAT encoding=PLAIN compressor=SNAPPY)
+```
+
+一组对齐序列中的序列可以有不同的数据类型、编码方式以及压缩方式。
+
+对齐的时间序列也支持设置别名、标签、属性。
+
+### 删除时间序列
+
+我们可以使用`(DELETE | DROP) TimeSeries <PathPattern>`语句来删除我们之前创建的时间序列。SQL 语句如下所示:
+
+```
+IoTDB> delete timeseries root.ln.wf01.wt01.status
+IoTDB> delete timeseries root.ln.wf01.wt01.temperature, root.ln.wf02.wt02.hardware
+IoTDB> delete timeseries root.ln.wf02.*
+IoTDB> drop timeseries root.ln.wf02.*
+```
+
+### 查看时间序列
+
+* SHOW LATEST? TIMESERIES pathPattern? timeseriesWhereClause? limitClause?
+
+ SHOW TIMESERIES 中可以有四种可选的子句,查询结果为这些时间序列的所有信息
+
+时间序列信息具体包括:时间序列路径名,database,Measurement 别名,数据类型,编码方式,压缩方式,属性和标签。
+
+示例:
+
+* SHOW TIMESERIES
+
+ 展示系统中所有的时间序列信息
+
+* SHOW TIMESERIES <`Path`>
+
+ 返回给定路径的下的所有时间序列信息。其中 `Path` 需要为一个时间序列路径或路径模式。例如,分别查看`root`路径和`root.ln`路径下的时间序列,SQL 语句如下所示:
+
+```
+IoTDB> show timeseries root.**
+IoTDB> show timeseries root.ln.**
+```
+
+执行结果分别为:
+
+```
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+| timeseries| alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+|root.sgcc.wf03.wt01.temperature| null| root.sgcc| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.sgcc.wf03.wt01.status| null| root.sgcc| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
+| root.turbine.d1.s1|newAlias| root.turbine| FLOAT| RLE| SNAPPY|{"newTag1":"newV1","tag4":"v4","tag3":"v3"}|{"attr2":"v2","attr1":"newV1","attr4":"v4","attr3":"v3"}| null| null|
+| root.ln.wf02.wt02.hardware| null| root.ln| TEXT| PLAIN| SNAPPY| null| null| null| null|
+| root.ln.wf02.wt02.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
+| root.ln.wf01.wt01.temperature| null| root.ln| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.ln.wf01.wt01.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+Total line number = 7
+It costs 0.016s
+
++-----------------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression|tags|attributes|deadband|deadband parameters|
++-----------------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+| root.ln.wf02.wt02.hardware| null| root.ln| TEXT| PLAIN| SNAPPY|null| null| null| null|
+| root.ln.wf02.wt02.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY|null| null| null| null|
+|root.ln.wf01.wt01.temperature| null| root.ln| FLOAT| RLE| SNAPPY|null| null| null| null|
+| root.ln.wf01.wt01.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY|null| null| null| null|
++-----------------------------+-----+-------------+--------+--------+-----------+----+----------+--------+-------------------+
+Total line number = 4
+It costs 0.004s
+```
+
+* SHOW TIMESERIES LIMIT INT OFFSET INT
+
+ 只返回从指定下标开始的结果,最大返回条数被 LIMIT 限制,用于分页查询。例如:
+
+```
+show timeseries root.ln.** limit 10 offset 10
+```
+
+* SHOW TIMESERIES WHERE TIMESERIES contains 'containStr'
+
+ 对查询结果集根据 timeseries 名称进行字符串模糊匹配过滤。例如:
+
+```
+show timeseries root.ln.** where timeseries contains 'wf01.wt'
+```
+
+执行结果为:
+
+```
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+| timeseries| alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+| root.ln.wf01.wt01.temperature| null| root.ln| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.ln.wf01.wt01.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+Total line number = 2
+It costs 0.016s
+```
+
+* SHOW TIMESERIES WHERE DataType=type
+
+ 对查询结果集根据时间序列数据类型进行过滤。例如:
+
+```
+show timeseries root.ln.** where dataType=FLOAT
+```
+
+执行结果为:
+
+```
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+| timeseries| alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+|root.sgcc.wf03.wt01.temperature| null| root.sgcc| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.turbine.d1.s1|newAlias| root.turbine| FLOAT| RLE| SNAPPY|{"newTag1":"newV1","tag4":"v4","tag3":"v3"}|{"attr2":"v2","attr1":"newV1","attr4":"v4","attr3":"v3"}| null| null|
+| root.ln.wf01.wt01.temperature| null| root.ln| FLOAT| RLE| SNAPPY| null| null| null| null|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+Total line number = 3
+It costs 0.016s
+
+```
+
+
+* SHOW LATEST TIMESERIES
+
+ 表示查询出的时间序列需要按照最近插入时间戳降序排列
+
+
+需要注意的是,当查询路径不存在时,系统会返回 0 条时间序列。
+
+### 统计时间序列总数
+
+IoTDB 支持使用`COUNT TIMESERIES<Path>`来统计一条路径中的时间序列个数。SQL 语句如下所示:
+
+* 可以通过 `WHERE` 条件对时间序列名称进行字符串模糊匹配,语法为: `COUNT TIMESERIES <Path> WHERE TIMESERIES contains 'containStr'` 。
+* 可以通过 `WHERE` 条件对时间序列数据类型进行过滤,语法为: `COUNT TIMESERIES <Path> WHERE DataType=<DataType>'`。
+* 可以通过 `WHERE` 条件对标签点进行过滤,语法为: `COUNT TIMESERIES <Path> WHERE TAGS(key)='value'` 或 `COUNT TIMESERIES <Path> WHERE TAGS(key) contains 'value'`。
+* 可以通过定义`LEVEL`来统计指定层级下的时间序列个数。这条语句可以用来统计每一个设备下的传感器数量,语法为:`COUNT TIMESERIES <Path> GROUP BY LEVEL=<INTEGER>`。
+
+```
+IoTDB > COUNT TIMESERIES root.**
+IoTDB > COUNT TIMESERIES root.ln.**
+IoTDB > COUNT TIMESERIES root.ln.*.*.status
+IoTDB > COUNT TIMESERIES root.ln.wf01.wt01.status
+IoTDB > COUNT TIMESERIES root.** WHERE TIMESERIES contains 'sgcc'
+IoTDB > COUNT TIMESERIES root.** WHERE DATATYPE = INT64
+IoTDB > COUNT TIMESERIES root.** WHERE TAGS(unit) contains 'c'
+IoTDB > COUNT TIMESERIES root.** WHERE TAGS(unit) = 'c'
+IoTDB > COUNT TIMESERIES root.** WHERE TIMESERIES contains 'sgcc' group by level = 1
+```
+
+例如有如下时间序列(可以使用`show timeseries`展示所有时间序列):
+
+```
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+| timeseries| alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+|root.sgcc.wf03.wt01.temperature| null| root.sgcc| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.sgcc.wf03.wt01.status| null| root.sgcc| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
+| root.turbine.d1.s1|newAlias| root.turbine| FLOAT| RLE| SNAPPY|{"newTag1":"newV1","tag4":"v4","tag3":"v3"}|{"attr2":"v2","attr1":"newV1","attr4":"v4","attr3":"v3"}| null| null|
+| root.ln.wf02.wt02.hardware| null| root.ln| TEXT| PLAIN| SNAPPY| {"unit":"c"}| null| null| null|
+| root.ln.wf02.wt02.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY| {"description":"test1"}| null| null| null|
+| root.ln.wf01.wt01.temperature| null| root.ln| FLOAT| RLE| SNAPPY| null| null| null| null|
+| root.ln.wf01.wt01.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY| null| null| null| null|
++-------------------------------+--------+-------------+--------+--------+-----------+-------------------------------------------+--------------------------------------------------------+--------+-------------------+
+Total line number = 7
+It costs 0.004s
+```
+
+那么 Metadata Tree 如下所示:
+
+<img style="width:100%; max-width:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/69792176-1718f400-1201-11ea-861a-1a83c07ca144.jpg">
+
+可以看到,`root`被定义为`LEVEL=0`。那么当你输入如下语句时:
+
+```
+IoTDB > COUNT TIMESERIES root.** GROUP BY LEVEL=1
+IoTDB > COUNT TIMESERIES root.ln.** GROUP BY LEVEL=2
+IoTDB > COUNT TIMESERIES root.ln.wf01.* GROUP BY LEVEL=2
+```
+
+你将得到以下结果:
+
+```
+IoTDB> COUNT TIMESERIES root.** GROUP BY LEVEL=1
++------------+-----------------+
+| column|count(timeseries)|
++------------+-----------------+
+| root.sgcc| 2|
+|root.turbine| 1|
+| root.ln| 4|
++------------+-----------------+
+Total line number = 3
+It costs 0.002s
+
+IoTDB > COUNT TIMESERIES root.ln.** GROUP BY LEVEL=2
++------------+-----------------+
+| column|count(timeseries)|
++------------+-----------------+
+|root.ln.wf02| 2|
+|root.ln.wf01| 2|
++------------+-----------------+
+Total line number = 2
+It costs 0.002s
+
+IoTDB > COUNT TIMESERIES root.ln.wf01.* GROUP BY LEVEL=2
++------------+-----------------+
+| column|count(timeseries)|
++------------+-----------------+
+|root.ln.wf01| 2|
++------------+-----------------+
+Total line number = 1
+It costs 0.002s
+```
+
+> 注意:时间序列的路径只是过滤条件,与 level 的定义无关。
+
+### 标签点管理
+
+我们可以在创建时间序列的时候,为它添加别名和额外的标签和属性信息。
+
+标签和属性的区别在于:
+
+* 标签可以用来查询时间序列路径,会在内存中维护标点到时间序列路径的倒排索引:标签 -> 时间序列路径
+* 属性只能用时间序列路径来查询:时间序列路径 -> 属性
+
+所用到的扩展的创建时间序列的 SQL 语句如下所示:
+```
+create timeseries root.turbine.d1.s1(temprature) with datatype=FLOAT, encoding=RLE, compression=SNAPPY tags(tag1=v1, tag2=v2) attributes(attr1=v1, attr2=v2)
+```
+
+括号里的`temprature`是`s1`这个传感器的别名。
+我们可以在任何用到`s1`的地方,将其用`temprature`代替,这两者是等价的。
+
+> IoTDB 同时支持在查询语句中 [使用 AS 函数](../Reference/SQL-Reference.md#数据管理语句) 设置别名。二者的区别在于:AS 函数设置的别名用于替代整条时间序列名,且是临时的,不与时间序列绑定;而上文中的别名只作为传感器的别名,与其绑定且可与原传感器名等价使用。
+
+> 注意:额外的标签和属性信息总的大小不能超过`tag_attribute_total_size`.
+
+ * 标签点属性更新
+创建时间序列后,我们也可以对其原有的标签点属性进行更新,主要有以下六种更新方式:
+* 重命名标签或属性
+```
+ALTER timeseries root.turbine.d1.s1 RENAME tag1 TO newTag1
+```
+* 重新设置标签或属性的值
+```
+ALTER timeseries root.turbine.d1.s1 SET newTag1=newV1, attr1=newV1
+```
+* 删除已经存在的标签或属性
+```
+ALTER timeseries root.turbine.d1.s1 DROP tag1, tag2
+```
+* 添加新的标签
+```
+ALTER timeseries root.turbine.d1.s1 ADD TAGS tag3=v3, tag4=v4
+```
+* 添加新的属性
+```
+ALTER timeseries root.turbine.d1.s1 ADD ATTRIBUTES attr3=v3, attr4=v4
+```
+* 更新插入别名,标签和属性
+> 如果该别名,标签或属性原来不存在,则插入,否则,用新值更新原来的旧值
+```
+ALTER timeseries root.turbine.d1.s1 UPSERT ALIAS=newAlias TAGS(tag2=newV2, tag3=v3) ATTRIBUTES(attr3=v3, attr4=v4)
+```
+
+* 使用标签作为过滤条件查询时间序列,使用 TAGS(tagKey) 来标识作为过滤条件的标签
+```
+SHOW TIMESERIES (<`PathPattern`>)? timeseriesWhereClause
+```
+
+返回给定路径的下的所有满足条件的时间序列信息,SQL 语句如下所示:
+
+```
+ALTER timeseries root.ln.wf02.wt02.hardware ADD TAGS unit=c
+ALTER timeseries root.ln.wf02.wt02.status ADD TAGS description=test1
+show timeseries root.ln.** where TAGS(unit)='c'
+show timeseries root.ln.** where TAGS(description) contains 'test1'
+```
+
+执行结果分别为:
+
+```
++--------------------------+-----+-------------+--------+--------+-----------+------------+----------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression| tags|attributes|deadband|deadband parameters|
++--------------------------+-----+-------------+--------+--------+-----------+------------+----------+--------+-------------------+
+|root.ln.wf02.wt02.hardware| null| root.ln| TEXT| PLAIN| SNAPPY|{"unit":"c"}| null| null| null|
++--------------------------+-----+-------------+--------+--------+-----------+------------+----------+--------+-------------------+
+Total line number = 1
+It costs 0.005s
+
++------------------------+-----+-------------+--------+--------+-----------+-----------------------+----------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression| tags|attributes|deadband|deadband parameters|
++------------------------+-----+-------------+--------+--------+-----------+-----------------------+----------+--------+-------------------+
+|root.ln.wf02.wt02.status| null| root.ln| BOOLEAN| PLAIN| SNAPPY|{"description":"test1"}| null| null| null|
++------------------------+-----+-------------+--------+--------+-----------+-----------------------+----------+--------+-------------------+
+Total line number = 1
+It costs 0.004s
+```
+
+- 使用标签作为过滤条件统计时间序列数量
+
+```
+COUNT TIMESERIES (<`PathPattern`>)? timeseriesWhereClause
+COUNT TIMESERIES (<`PathPattern`>)? timeseriesWhereClause GROUP BY LEVEL=<INTEGER>
+```
+
+返回给定路径的下的所有满足条件的时间序列的数量,SQL 语句如下所示:
+
+```
+count timeseries
+count timeseries root.** where TAGS(unit)='c'
+count timeseries root.** where TAGS(unit)='c' group by level = 2
+```
+
+执行结果分别为:
+
+```
+IoTDB> count timeseries
++-----------------+
+|count(timeseries)|
++-----------------+
+| 6|
++-----------------+
+Total line number = 1
+It costs 0.019s
+IoTDB> count timeseries root.** where TAGS(unit)='c'
++-----------------+
+|count(timeseries)|
++-----------------+
+| 2|
++-----------------+
+Total line number = 1
+It costs 0.020s
+IoTDB> count timeseries root.** where TAGS(unit)='c' group by level = 2
++--------------+-----------------+
+| column|count(timeseries)|
++--------------+-----------------+
+| root.ln.wf02| 2|
+| root.ln.wf01| 0|
+|root.sgcc.wf03| 0|
++--------------+-----------------+
+Total line number = 3
+It costs 0.011s
+```
+
+> 注意,现在我们只支持一个查询条件,要么是等值条件查询,要么是包含条件查询。当然 where 子句中涉及的必须是标签值,而不能是属性值。
+
+创建对齐时间序列
+
+```
+create aligned timeseries root.sg1.d1(s1 INT32 tags(tag1=v1, tag2=v2) attributes(attr1=v1, attr2=v2), s2 DOUBLE tags(tag3=v3, tag4=v4) attributes(attr3=v3, attr4=v4))
+```
+
+执行结果如下:
+
+```
+IoTDB> show timeseries
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+|root.sg1.d1.s1| null| root.sg1| INT32| RLE| SNAPPY|{"tag1":"v1","tag2":"v2"}|{"attr2":"v2","attr1":"v1"}| null| null|
+|root.sg1.d1.s2| null| root.sg1| DOUBLE| GORILLA| SNAPPY|{"tag4":"v4","tag3":"v3"}|{"attr4":"v4","attr3":"v3"}| null| null|
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+```
+
+支持查询:
+
+```
+IoTDB> show timeseries where TAGS(tag1)='v1'
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+| timeseries|alias| database|dataType|encoding|compression| tags| attributes|deadband|deadband parameters|
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+|root.sg1.d1.s1| null| root.sg1| INT32| RLE| SNAPPY|{"tag1":"v1","tag2":"v2"}|{"attr2":"v2","attr1":"v1"}| null| null|
++--------------+-----+-------------+--------+--------+-----------+-------------------------+---------------------------+--------+-------------------+
+```
+
+上述对时间序列标签、属性的更新等操作都支持。
+
+
+## 路径查询
+
+### 查看路径的所有子路径
+
+```
+SHOW CHILD PATHS pathPattern
+```
+
+可以查看此路径模式所匹配的所有路径的下一层的所有路径和它对应的节点类型,即pathPattern.*所匹配的路径及其节点类型。
+
+节点类型:ROOT -> SG INTERNAL -> DATABASE -> INTERNAL -> DEVICE -> TIMESERIES
+
+示例:
+
+* 查询 root.ln 的下一层:show child paths root.ln
+
+```
++------------+----------+
+| child paths|node types|
++------------+----------+
+|root.ln.wf01| INTERNAL|
+|root.ln.wf02| INTERNAL|
++------------+----------+
+Total line number = 2
+It costs 0.002s
+```
+
+* 查询形如 root.xx.xx.xx 的路径:show child paths root.\*.\*
+
+```
++---------------+
+| child paths|
++---------------+
+|root.ln.wf01.s1|
+|root.ln.wf02.s2|
++---------------+
+```
+
+### 查看路径的下一级节点
+
+```
+SHOW CHILD NODES pathPattern
+```
+
+可以查看此路径模式所匹配的节点的下一层的所有节点。
+
+示例:
+
+* 查询 root 的下一层:show child nodes root
+
+```
++------------+
+| child nodes|
++------------+
+| ln|
++------------+
+```
+
+* 查询 root.ln 的下一层 :show child nodes root.ln
+
+```
++------------+
+| child nodes|
++------------+
+| wf01|
+| wf02|
++------------+
+```
+
+### 统计节点数
+
+IoTDB 支持使用`COUNT NODES <PathPattern> LEVEL=<INTEGER>`来统计当前 Metadata
+ 树下满足某路径模式的路径中指定层级的节点个数。这条语句可以用来统计带有特定采样点的设备数。例如:
+
+```
+IoTDB > COUNT NODES root.** LEVEL=2
+IoTDB > COUNT NODES root.ln.** LEVEL=2
+IoTDB > COUNT NODES root.ln.wf01.* LEVEL=3
+IoTDB > COUNT NODES root.**.temperature LEVEL=3
+```
+
+对于上面提到的例子和 Metadata Tree,你可以获得如下结果:
+
+```
++------------+
+|count(nodes)|
++------------+
+| 4|
++------------+
+Total line number = 1
+It costs 0.003s
+
++------------+
+|count(nodes)|
++------------+
+| 2|
++------------+
+Total line number = 1
+It costs 0.002s
+
++------------+
+|count(nodes)|
++------------+
+| 1|
++------------+
+Total line number = 1
+It costs 0.002s
+
++------------+
+|count(nodes)|
++------------+
+| 2|
++------------+
+Total line number = 1
+It costs 0.002s
+```
+
+> 注意:时间序列的路径只是过滤条件,与 level 的定义无关。
+
+### 查看设备
+
+* SHOW DEVICES pathPattern? (WITH DATABASE)? devicesWhereClause? limitClause?
+
+与 `Show Timeseries` 相似,IoTDB 目前也支持两种方式查看设备。
+
+* `SHOW DEVICES` 语句显示当前所有的设备信息,等价于 `SHOW DEVICES root.**`。
+* `SHOW DEVICES <PathPattern>` 语句规定了 `PathPattern`,返回给定的路径模式所匹配的设备信息。
+* `WHERE` 条件中可以使用 `DEVICE contains 'xxx'`,根据 device 名称进行模糊查询。
+
+SQL 语句如下所示:
+
+```
+IoTDB> show devices
+IoTDB> show devices root.ln.**
+IoTDB> show devices root.ln.** where device contains 't'
+```
+
+你可以获得如下数据:
+
+```
++-------------------+---------+
+| devices|isAligned|
++-------------------+---------+
+| root.ln.wf01.wt01| false|
+| root.ln.wf02.wt02| false|
+|root.sgcc.wf03.wt01| false|
+| root.turbine.d1| false|
++-------------------+---------+
+Total line number = 4
+It costs 0.002s
+
++-----------------+---------+
+| devices|isAligned|
++-----------------+---------+
+|root.ln.wf01.wt01| false|
+|root.ln.wf02.wt02| false|
++-----------------+---------+
+Total line number = 2
+It costs 0.001s
+```
+
+其中,`isAligned`表示该设备下的时间序列是否对齐。
+
+查看设备及其 database 信息,可以使用 `SHOW DEVICES WITH DATABASE` 语句。
+
+* `SHOW DEVICES WITH DATABASE` 语句显示当前所有的设备信息和其所在的 database,等价于 `SHOW DEVICES root.**`。
+* `SHOW DEVICES <PathPattern> WITH DATABASE` 语句规定了 `PathPattern`,返回给定的路径模式所匹配的设备信息和其所在的 database。
+
+SQL 语句如下所示:
+
+```
+IoTDB> show devices with database
+IoTDB> show devices root.ln.** with database
+```
+
+你可以获得如下数据:
+
+```
++-------------------+-------------+---------+
+| devices| database|isAligned|
++-------------------+-------------+---------+
+| root.ln.wf01.wt01| root.ln| false|
+| root.ln.wf02.wt02| root.ln| false|
+|root.sgcc.wf03.wt01| root.sgcc| false|
+| root.turbine.d1| root.turbine| false|
++-------------------+-------------+---------+
+Total line number = 4
+It costs 0.003s
+
++-----------------+-------------+---------+
+| devices| database|isAligned|
++-----------------+-------------+---------+
+|root.ln.wf01.wt01| root.ln| false|
+|root.ln.wf02.wt02| root.ln| false|
++-----------------+-------------+---------+
+Total line number = 2
+It costs 0.001s
+```
+
+### 统计设备数量
+
+* COUNT DEVICES \<PathPattern\>
+
+上述语句用于统计设备的数量,同时允许指定`PathPattern` 用于统计匹配该`PathPattern` 的设备数量
+
+SQL 语句如下所示:
+
+```
+IoTDB> show devices
+IoTDB> count devices
+IoTDB> count devices root.ln.**
+```
+
+你可以获得如下数据:
+
+```
++-------------------+---------+
+| devices|isAligned|
++-------------------+---------+
+|root.sgcc.wf03.wt03| false|
+| root.turbine.d1| false|
+| root.ln.wf02.wt02| false|
+| root.ln.wf01.wt01| false|
++-------------------+---------+
+Total line number = 4
+It costs 0.024s
+
++--------------+
+|count(devices)|
++--------------+
+| 4|
++--------------+
+Total line number = 1
+It costs 0.004s
+
++--------------+
+|count(devices)|
++--------------+
+| 2|
++--------------+
+Total line number = 1
+It costs 0.004s
+```
diff --git a/docs/zh/UserGuide/User-Manuel/Operator-and-Expression.md b/docs/zh/UserGuide/User-Manuel/Operator-and-Expression.md
new file mode 100644
index 00000000000..ed278dfdd5c
--- /dev/null
+++ b/docs/zh/UserGuide/User-Manuel/Operator-and-Expression.md
@@ -0,0 +1,849 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+## 运算符
+### 算数运算符
+
+#### 一元算数运算符
+
+支持的运算符:`+`, `-`
+
+输入数据类型要求:`INT32`, `INT64`, `FLOAT`, `DOUBLE`
+
+输出数据类型:与输入数据类型一致
+
+#### 二元算数运算符
+
+支持的运算符:`+`, `-`, `*`, `/`, `%`
+
+输入数据类型要求:`INT32`, `INT64`, `FLOAT`和`DOUBLE`
+
+输出数据类型:`DOUBLE`
+
+注意:当某个时间戳下左操作数和右操作数都不为空(`null`)时,二元运算操作才会有输出结果
+
+#### 使用示例
+
+例如:
+
+```sql
+select s1, - s1, s2, + s2, s1 + s2, s1 - s2, s1 * s2, s1 / s2, s1 % s2 from root.sg.d1
+```
+
+结果:
+
+```
++-----------------------------+-------------+--------------+-------------+-------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+| Time|root.sg.d1.s1|-root.sg.d1.s1|root.sg.d1.s2|root.sg.d1.s2|root.sg.d1.s1 + root.sg.d1.s2|root.sg.d1.s1 - root.sg.d1.s2|root.sg.d1.s1 * root.sg.d1.s2|root.sg.d1.s1 / root.sg.d1.s2|root.sg.d1.s1 % root.sg.d1.s2|
++-----------------------------+-------------+--------------+-------------+-------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+|1970-01-01T08:00:00.001+08:00| 1.0| -1.0| 1.0| 1.0| 2.0| 0.0| 1.0| 1.0| 0.0|
+|1970-01-01T08:00:00.002+08:00| 2.0| -2.0| 2.0| 2.0| 4.0| 0.0| 4.0| 1.0| 0.0|
+|1970-01-01T08:00:00.003+08:00| 3.0| -3.0| 3.0| 3.0| 6.0| 0.0| 9.0| 1.0| 0.0|
+|1970-01-01T08:00:00.004+08:00| 4.0| -4.0| 4.0| 4.0| 8.0| 0.0| 16.0| 1.0| 0.0|
+|1970-01-01T08:00:00.005+08:00| 5.0| -5.0| 5.0| 5.0| 10.0| 0.0| 25.0| 1.0| 0.0|
++-----------------------------+-------------+--------------+-------------+-------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+-----------------------------+
+Total line number = 5
+It costs 0.014s
+```
+
+### 数学函数
+
+目前 IoTDB 支持下列数学函数,这些数学函数的行为与这些函数在 Java Math 标准库中对应实现的行为一致。
+
+| 函数名 | 输入序列类型 | 输出序列类型 | 必要属性参数 | Java 标准库中的对应实现 |
+| ------- | ------------------------------ | ------------------------ |-----------| ------------------------------------------------------------ |
+| SIN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#sin(double) |
+| COS | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#cos(double) |
+| TAN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#tan(double) |
+| ASIN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#asin(double) |
+| ACOS | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#acos(double) |
+| ATAN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#atan(double) |
+| SINH | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#sinh(double) |
+| COSH | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#cosh(double) |
+| TANH | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#tanh(double) |
+| DEGREES | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#toDegrees(double) |
+| RADIANS | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#toRadians(double) |
+| ABS | INT32 / INT64 / FLOAT / DOUBLE | 与输入序列的实际类型一致 | | Math#abs(int) / Math#abs(long) /Math#abs(float) /Math#abs(double) |
+| SIGN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#signum(double) |
+| CEIL | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#ceil(double) |
+| FLOOR | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#floor(double) |
+| ROUND | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE |`places`:四舍五入有效位数,正数为小数点后面的有效位数,负数为整数位的有效位数 | Math#rint(Math#pow(10,places))/Math#pow(10,places)|
+| EXP | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#exp(double) |
+| LN | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#log(double) |
+| LOG10 | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#log10(double) |
+| SQRT | INT32 / INT64 / FLOAT / DOUBLE | DOUBLE | | Math#sqrt(double) |
+
+例如:
+
+``` sql
+select s1, sin(s1), cos(s1), tan(s1) from root.sg1.d1 limit 5 offset 1000;
+```
+
+结果:
+
+```
++-----------------------------+-------------------+-------------------+--------------------+-------------------+
+| Time| root.sg1.d1.s1|sin(root.sg1.d1.s1)| cos(root.sg1.d1.s1)|tan(root.sg1.d1.s1)|
++-----------------------------+-------------------+-------------------+--------------------+-------------------+
+|2020-12-10T17:11:49.037+08:00|7360723084922759782| 0.8133527237573284| 0.5817708713544664| 1.3980636773094157|
+|2020-12-10T17:11:49.038+08:00|4377791063319964531|-0.8938962705202537| 0.4482738644511651| -1.994085181866842|
+|2020-12-10T17:11:49.039+08:00|7972485567734642915| 0.9627757585308978|-0.27030138509681073|-3.5618602479083545|
+|2020-12-10T17:11:49.040+08:00|2508858212791964081|-0.6073417341629443| -0.7944406950452296| 0.7644897069734913|
+|2020-12-10T17:11:49.041+08:00|2817297431185141819|-0.8419358900502509| -0.5395775727782725| 1.5603611649667768|
++-----------------------------+-------------------+-------------------+--------------------+-------------------+
+Total line number = 5
+It costs 0.008s
+```
+#### ROUND
+例如:
+```sql
+select s4,round(s4),round(s4,2),round(s4,-1) from root.sg1.d1
+```
+
+```sql
++-----------------------------+-------------+--------------------+----------------------+-----------------------+
+| Time|root.db.d1.s4|ROUND(root.db.d1.s4)|ROUND(root.db.d1.s4,2)|ROUND(root.db.d1.s4,-1)|
++-----------------------------+-------------+--------------------+----------------------+-----------------------+
+|1970-01-01T08:00:00.001+08:00| 101.14345| 101.0| 101.14| 100.0|
+|1970-01-01T08:00:00.002+08:00| 20.144346| 20.0| 20.14| 20.0|
+|1970-01-01T08:00:00.003+08:00| 20.614372| 21.0| 20.61| 20.0|
+|1970-01-01T08:00:00.005+08:00| 20.814346| 21.0| 20.81| 20.0|
+|1970-01-01T08:00:00.006+08:00| 60.71443| 61.0| 60.71| 60.0|
+|2023-03-13T16:16:19.764+08:00| 10.143425| 10.0| 10.14| 10.0|
++-----------------------------+-------------+--------------------+----------------------+-----------------------+
+Total line number = 6
+It costs 0.059s
+```
+
+### 比较运算符
+
+#### 基本比较运算符
+
+- 输入数据类型: `INT32`, `INT64`, `FLOAT`, `DOUBLE`。
+- 注意:会将所有数据转换为`DOUBLE`类型后进行比较。`==`和`!=`可以直接比较两个`BOOLEAN`。
+- 返回类型:`BOOLEAN`。
+
+|运算符 |含义|
+|----------------------------|-----------|
+|`>` |大于|
+|`>=` |大于等于|
+|`<` |小于|
+|`<=` |小于等于|
+|`==` |等于|
+|`!=` / `<>` |不等于|
+
+**示例:**
+
+```sql
+select a, b, a > 10, a <= b, !(a <= b), a > 10 && a > b from root.test;
+```
+
+运行结果
+```
+IoTDB> select a, b, a > 10, a <= b, !(a <= b), a > 10 && a > b from root.test;
++-----------------------------+-----------+-----------+----------------+--------------------------+---------------------------+------------------------------------------------+
+| Time|root.test.a|root.test.b|root.test.a > 10|root.test.a <= root.test.b|!root.test.a <= root.test.b|(root.test.a > 10) & (root.test.a > root.test.b)|
++-----------------------------+-----------+-----------+----------------+--------------------------+---------------------------+------------------------------------------------+
+|1970-01-01T08:00:00.001+08:00| 23| 10.0| true| false| true| true|
+|1970-01-01T08:00:00.002+08:00| 33| 21.0| true| false| true| true|
+|1970-01-01T08:00:00.004+08:00| 13| 15.0| true| true| false| false|
+|1970-01-01T08:00:00.005+08:00| 26| 0.0| true| false| true| true|
+|1970-01-01T08:00:00.008+08:00| 1| 22.0| false| true| false| false|
+|1970-01-01T08:00:00.010+08:00| 23| 12.0| true| false| true| true|
++-----------------------------+-----------+-----------+----------------+--------------------------+---------------------------+------------------------------------------------+
+```
+
+#### `BETWEEN ... AND ...` 运算符
+
+|运算符 |含义|
+|----------------------------|-----------|
+|`BETWEEN ... AND ...` |在指定范围内|
+|`NOT BETWEEN ... AND ...` |不在指定范围内|
+
+**示例:** 选择区间 [36.5,40] 内或之外的数据:
+
+```sql
+select temperature from root.sg1.d1 where temperature between 36.5 and 40;
+```
+
+```sql
+select temperature from root.sg1.d1 where temperature not between 36.5 and 40;
+```
+
+#### 模糊匹配运算符
+
+对于 TEXT 类型的数据,支持使用 `Like` 和 `Regexp` 运算符对数据进行模糊匹配
+
+|运算符 |含义|
+|----------------------------|-----------|
+|`LIKE` |匹配简单模式|
+|`NOT LIKE` |无法匹配简单模式|
+|`REGEXP` |匹配正则表达式|
+|`NOT REGEXP` |无法匹配正则表达式|
+
+输入数据类型:`TEXT`
+
+返回类型:`BOOLEAN`
+
+##### 使用 `Like` 进行模糊匹配
+
+**匹配规则:**
+
+- `%` 表示任意0个或多个字符。
+- `_` 表示任意单个字符。
+
+**示例 1:** 查询 `root.sg.d1` 下 `value` 含有`'cc'`的数据。
+
+```shell
+IoTDB> select * from root.sg.d1 where value like '%cc%'
++-----------------------------+----------------+
+| Time|root.sg.d1.value|
++-----------------------------+----------------+
+|2017-11-01T00:00:00.000+08:00| aabbccdd|
+|2017-11-01T00:00:01.000+08:00| cc|
++-----------------------------+----------------+
+Total line number = 2
+It costs 0.002s
+```
+
+**示例 2:** 查询 `root.sg.d1` 下 `value` 中间为 `'b'`、前后为任意单个字符的数据。
+
+```shell
+IoTDB> select * from root.sg.device where value like '_b_'
++-----------------------------+----------------+
+| Time|root.sg.d1.value|
++-----------------------------+----------------+
+|2017-11-01T00:00:02.000+08:00| abc|
++-----------------------------+----------------+
+Total line number = 1
+It costs 0.002s
+```
+
+##### 使用 `Regexp` 进行模糊匹配
+
+需要传入的过滤条件为 **Java 标准库风格的正则表达式**。
+
+**常见的正则匹配举例:**
+
+```
+长度为3-20的所有字符:^.{3,20}$
+大写英文字符:^[A-Z]+$
+数字和英文字符:^[A-Za-z0-9]+$
+以a开头的:^a.*
+```
+
+**示例 1:** 查询 root.sg.d1 下 value 值为26个英文字符组成的字符串。
+
+```shell
+IoTDB> select * from root.sg.d1 where value regexp '^[A-Za-z]+$'
++-----------------------------+----------------+
+| Time|root.sg.d1.value|
++-----------------------------+----------------+
+|2017-11-01T00:00:00.000+08:00| aabbccdd|
+|2017-11-01T00:00:01.000+08:00| cc|
++-----------------------------+----------------+
+Total line number = 2
+It costs 0.002s
+```
+
+**示例 2:** 查询 root.sg.d1 下 value 值为26个小写英文字符组成的字符串且时间大于100的。
+
+```shell
+IoTDB> select * from root.sg.d1 where value regexp '^[a-z]+$' and time > 100
++-----------------------------+----------------+
+| Time|root.sg.d1.value|
++-----------------------------+----------------+
+|2017-11-01T00:00:00.000+08:00| aabbccdd|
+|2017-11-01T00:00:01.000+08:00| cc|
++-----------------------------+----------------+
+Total line number = 2
+It costs 0.002s
+```
+
+**示例 3:**
+
+```sql
+select b, b like '1%', b regexp '[0-2]' from root.test;
+```
+
+运行结果
+```
++-----------------------------+-----------+-------------------------+--------------------------+
+| Time|root.test.b|root.test.b LIKE '^1.*?$'|root.test.b REGEXP '[0-2]'|
++-----------------------------+-----------+-------------------------+--------------------------+
+|1970-01-01T08:00:00.001+08:00| 111test111| true| true|
+|1970-01-01T08:00:00.003+08:00| 333test333| false| false|
++-----------------------------+-----------+-------------------------+--------------------------+
+```
+
+#### `IS NULL` 运算符
+
+|运算符 |含义|
+|----------------------------|-----------|
+|`IS NULL` |是空值|
+|`IS NOT NULL` |不是空值|
+
+**示例 1:** 选择值为空的数据:
+
+```sql
+select code from root.sg1.d1 where temperature is null;
+```
+
+**示例 2:** 选择值为非空的数据:
+
+```sql
+select code from root.sg1.d1 where temperature is not null;
+```
+
+#### `IN` 运算符
+
+|运算符 |含义|
+|----------------------------|-----------|
+|`IN` / `CONTAINS` |是指定列表中的值|
+|`NOT IN` / `NOT CONTAINS` |不是指定列表中的值|
+
+输入数据类型:`All Types`
+
+返回类型 `BOOLEAN`
+
+**注意:请确保集合中的值可以被转为输入数据的类型。**
+> 例如:
+>
+>`s1 in (1, 2, 3, 'test')`,`s1`的数据类型是`INT32`
+>
+> 我们将会抛出异常,因为`'test'`不能被转为`INT32`类型
+
+**示例 1:** 选择值在特定范围内的数据:
+
+```sql
+select code from root.sg1.d1 where code in ('200', '300', '400', '500');
+```
+
+**示例 2:** 选择值在特定范围外的数据:
+
+```sql
+select code from root.sg1.d1 where code not in ('200', '300', '400', '500');
+```
+
+**示例 3:**
+
+```sql
+select a, a in (1, 2) from root.test;
+```
+
+输出2:
+```
++-----------------------------+-----------+--------------------+
+| Time|root.test.a|root.test.a IN (1,2)|
++-----------------------------+-----------+--------------------+
+|1970-01-01T08:00:00.001+08:00| 1| true|
+|1970-01-01T08:00:00.003+08:00| 3| false|
++-----------------------------+-----------+--------------------+
+```
+
+### 条件函数
+
+条件函数针对每个数据点进行条件判断,返回布尔值。
+
+| 函数名 | 可接收的输入序列类型 | 必要的属性参数 | 输出序列类型 | 功能类型 |
+|----------|--------------------------------|---------------------------------------|------------|--------------------------------------------------|
+| ON_OFF | INT32 / INT64 / FLOAT / DOUBLE | `threshold`:DOUBLE类型 | BOOLEAN 类型 | 返回`ts_value >= threshold`的bool值 |
+| IN_RANGE | INT32 / INT64 / FLOAT / DOUBLE | `lower`:DOUBLE类型<br/>`upper`:DOUBLE类型 | BOOLEAN类型 | 返回`ts_value >= lower && ts_value <= upper`的bool值 | |
+
+测试数据:
... 4359 lines suppressed ...