You are viewing a plain text version of this content. The canonical link for it is here.
Posted to notifications@shardingsphere.apache.org by GitBox <gi...@apache.org> on 2022/03/18 23:52:47 UTC
[GitHub] [shardingsphere] strongduanmu commented on a change in pull request #16200: Added space between Chinese and English words
strongduanmu commented on a change in pull request #16200:
URL: https://github.com/apache/shardingsphere/pull/16200#discussion_r830407445
##########
File path: docs/blog/content/material/proxy.cn.md
##########
@@ -35,44 +35,44 @@ Sharding-Proxy定位为透明化的数据库代理端,提供封装了数据库
它们既可以独立使用,也可以相互配合,以不同的架构模型、不同的切入点,实现相同的功能目标。而其核心功能,如数据分片、读写分离、柔性事务等,都是同一套实现代码。
-举个例子,对于仅使用Java为开发技术栈的场景,Sharding-JDBC对各种Java的ORM框架支持度非常高,开发人员可以非常便利地将数据分片能力引入到现有的系统中,并将其部署至线上环境运行,而DBA就可以通过部署一个Sharding-Proxy实例,对数据进行查询和管理。
+举个例子,对于仅使用Java为开发技术栈的场景,Sharding-JDBC 对各种Java的ORM框架支持度非常高,开发人员可以非常便利地将数据分片能力引入到现有的系统中,并将其部署至线上环境运行,而 DBA 就可以通过部署一个 Sharding-Proxy 实例,对数据进行查询和管理。
Review comment:
@abhijeetjejurkar Please add space for ORM.
##########
File path: docs/blog/content/material/proxy.cn.md
##########
@@ -99,76 +99,76 @@ useServerPrepStmts=true&cachePrepStmts=true
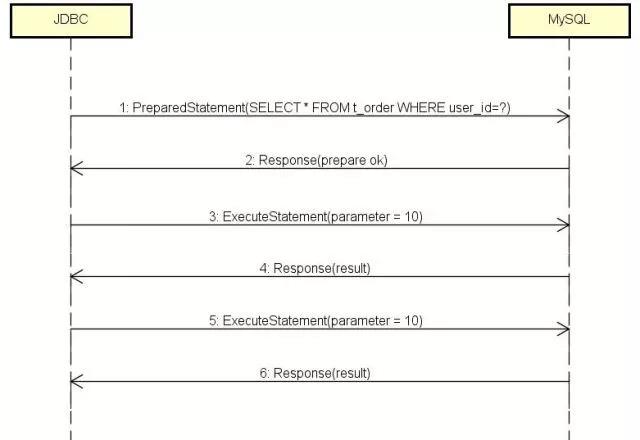
-从第5条消息开始,每次查询只传参数值就可以了,终于达到了一次编译多次运行的效果,MySQL的效率得到了提高。而且由于ExecuteStatement只传了参数的值,消息长度上比完整的SQL短了很多,网络IO的效率也得到了提升。
+从第 5 条消息开始,每次查询只传参数值就可以了,终于达到了一次编译多次运行的效果,MySQL 的效率得到了提高。而且由于 ExecuteStatement 只传了参数的值,消息长度上比完整的 SQL 短了很多,网络 IO 的效率也得到了提升。
-原来cachePrepStmts=true这个参数的意思是告诉JDBC缓存需要prepare的SQL,比如“SELECT * FROM t_order WHERE user_id=?”,运行过一次后,下次再运行就跳过PreparedStatement,直接用ExecuteStatement设置参数值。
+原来 cachePrepStmts=true 这个参数的意思是告诉 JDBC 缓存需要 prepare 的 SQL,比如 “SELECT * FROM t_order WHERE user_id=?”,运行过一次后,下次再运行就跳过 PreparedStatement,直接用 ExecuteStatement 设置参数值。
-明白原理后,就知道该怎么优化Proxy了。Proxy采用的是Hikari数据库连接池,在初始化的时候为其设置上面的两个参数:
+明白原理后,就知道该怎么优化 Proxy 了。Proxy 采用的是 Hikari 数据库连接池,在初始化的时候为其设置上面的两个参数:
```
config.addDataSourceProperty("useServerPrepStmts","true");
config.addDataSourceProperty("cachePrepStmts","true");
```
-这样就保证了Proxy和MySQL服务之间的性能。那么Proxy和Client之间的性能如何保证呢?
+这样就保证了 Proxy 和 MySQL 服务之间的性能。那么 Proxy 和 Client 之间的性能如何保证呢?
-Proxy在收到Client的PreparedStatement的时候,并不会把这条消息转发给MySQL,因为SQL里的分片键是问号,Proxy不知道该路由到哪个真实数据库。Proxy收到这条消息后只是缓存了SQL,存储在一个StatementId到SQL的Map里面,等收到ExecuteStatement的时候才真正请求数据库。
+Proxy 在收到 Client 的 PreparedStatement 的时候,并不会把这条消息转发给 MySQL,因为 SQL 里的分片键是问号,Proxy 不知道该路由到哪个真实数据库。Proxy 收到这条消息后只是缓存了SQL,存储在一个 StatementId 到 SQL 的 Map 里面,等收到 ExecuteStatement 的时候才真正请求数据库。
-这个逻辑在优化前是没问题的,因为每一次查询都是一个新的PreparedStatement流程,ExecuteStatement会把参数类型和参数值告诉客户端。
+这个逻辑在优化前是没问题的,因为每一次查询都是一个新的 PreparedStatement 流程,ExecuteStatement 会把参数类型和参数值告诉客户端。
-加上两个参数后,消息内容发生了变化,ExecuteStatement在发送第二次的时候,消息体里只有参数值而没有参数类型,Proxy不知道类型就不能正确的取出值。所以Proxy需要做的优化就是在PreparedStatement开始的时候缓存参数类型。
+加上两个参数后,消息内容发生了变化,ExecuteStatement 在发送第二次的时候,消息体里只有参数值而没有参数类型,Proxy 不知道类型就不能正确的取出值。所以 Proxy 需要做的优化就是在PreparedStatement 开始的时候缓存参数类型。
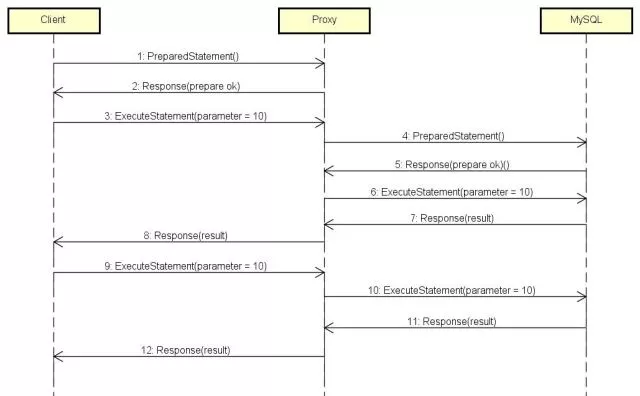
-完成以上优化后,Client-Proxy和Proxy-MySQL两侧的消息交互都变成了最后这张图的流程,从第9步开始高效查询。
+完成以上优化后,Client-Proxy 和 Proxy-MySQL 两侧的消息交互都变成了最后这张图的流程,从第9步开始高效查询。
-#### 2. Hikari连接池配置优化
+#### 2. Hikari 连接池配置优化
-Proxy在初始化的时候,会为每一个真实数据库配置一个Hikari连接池。根据分片规则,SQL被路由到某些真实库,通过Hikari连接得到执行结果,最后Proxy对结果进行归并返回给客户端。那么,数据库连接池到底该设置多大?对于这个众说纷纭的话题,今天该有一个定论了。
+Proxy 在初始化的时候,会为每一个真实数据库配置一个 Hikari 连接池。根据分片规则,SQL 被路由到某些真实库,通过 Hikari 连接得到执行结果,最后 Proxy 对结果进行归并返回给客户端。那么,数据库连接池到底该设置多大?对于这个众说纷纭的话题,今天该有一个定论了。
你会惊喜的发现,这个问题不是设置“多大”,反而是应该设置“多小”!如果我说执行一个任务,串行比并行更快,是不是有点反直觉?
-即使是单核CPU的计算机也能“同时”支持数百个线程。但我们都应该知道这只不过是操作系统用“时间片”玩的一个小花招。事实上,一个CPU核心同一时刻只能执行一个线程,然后操作系统切换上下文,CPU执行另一个线程,如此往复。
+即使是单核 CPU 的计算机也能“同时”支持数百个线程。但我们都应该知道这只不过是操作系统用“时间片”玩的一个小花招。事实上,一个CPU核心同一时刻只能执行一个线程,然后操作系统切换上下文,CPU 执行另一个线程,如此往复。
-一个CPU进行计算的基本规律是,顺序执行任务A和任务B永远比通过时间片“同时”执行A和B要快。一旦线程的数量超过了CPU核心的数量,再增加线程数就只会更慢,而不是更快。一个对Oracle的测试验证了这个观点。
+一个 CPU 进行计算的基本规律是,顺序执行任务 A 和任务 B 永远比通过时间片“同时”执行 A 和B要快。一旦线程的数量超过了 CPU 核心的数量,再增加线程数就只会更慢,而不是更快。一个对 Oracle 的测试验证了这个观点。
参考链接:
http://www.dailymotion.com/video/x2s8uec
-测试者把连接池的大小从2048逐渐降低到96,TPS从16163上升到20702,平响从110ms下降到3ms。
+测试者把连接池的大小从 2048 逐渐降低到 96,TPS 从 16163 上升到 20702,平响从 110ms 下降到 3ms。
-当然,也不是那么简单地让连接数等于CPU数就行了,还要考虑网络IO和磁盘IO的影响。当发生IO时,线程被阻塞,此时操作系统可以将那个空闲的CPU核心用于服务其他线程。所以,由于线程总是在I/O上阻塞,我们可以让线程(连接)数比CPU核心多一些,这样能够在同样的时间内完成更多的工作。到底应该多多少呢?PostgreSQL进行了一个benchmark测试:
+当然,也不是那么简单地让连接数等于 CPU 数就行了,还要考虑网络 IO 和磁盘 IO 的影响。当发生 IO 时,线程被阻塞,此时操作系统可以将那个空闲的 CPU 核心用于服务其他线程。所以,由于线程总是在 I/O 上阻塞,我们可以让线程(连接)数比 CPU 核心多一些,这样能够在同样的时间内完成更多的工作。到底应该多多少呢?PostgreSQL 进行了一个 benchmark 测试:
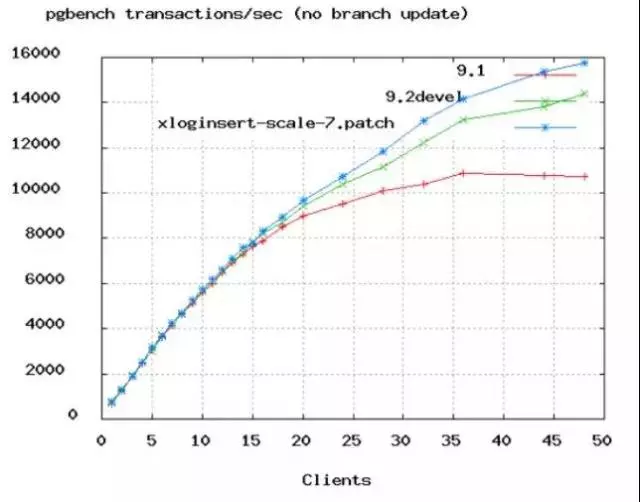
-TPS的增长速度从50个连接的时候开始变慢。根据这个结果,PostgreSQL给出了如下公式:
+TPS 的增长速度从 50 个连接的时候开始变慢。根据这个结果,PostgreSQL 给出了如下公式:
```
connections=((core_count*2)+effective_spindle_count)
-```
+```
Review comment:
Please remove this space after ```
##########
File path: docs/blog/content/material/proxy.cn.md
##########
@@ -257,37 +257,37 @@ Sharding-Sphere自2016年开源以来不断精进和发展,被越来越多企
### Q&A
-Q1:Sidecar是干什么的?
+Q1:Sidecar 是干什么的?
-A1:Sharding-Sidecar是Sharding-Sphere的第三个产品,目前仍在规划中。定位为Kubernetes或Mesos的云原生数据库代理,以DaemonSet的形式代理所有对数据库的访问。
+A1:Sharding-Sidecar 是 Sharding-Sphere 的第三个产品,目前仍在规划中。定位为 Kubernetes 或 Mesos 的云原生数据库代理,以 DaemonSet 的形式代理所有对数据库的访问。
-Q2:“问如果你对这个配置还感到迷惑,那么记住一句话,只有当max_user_connections小于该库可能被路由到的最大表数量时,才使用CONNECTION_STRICTLY。”这句话是不是说反了?
+Q2:“问如果你对这个配置还感到迷惑,那么记住一句话,只有当 max_user_connections 小于该库可能被路由到的最大表数量时,才使用 CONNECTION_STRICTLY。”这句话是不是说反了?
-A2:CONNECTION_STRICTLY就是为了省连接的。max_user_connections小,所以用CONNECTION_STRICTLY模式。
+A2:CONNECTION_STRICTLY 就是为了省连接的。max_user_connections 小,所以用 CONNECTION_STRICTLY 模式。
-Q3:stmt.setFetchSize(custom_size);设置的场景使用类似Mybatis之类的框架查询大量数据到内存,一般就是放到一个list中,然后处理。内存还是会占用。
+Q3:stmt.setFetchSize(custom_size);设置的场景使用类似 Mybatis 之类的框架查询大量数据到内存,一般就是放到一个 list 中,然后处理。内存还是会占用。
-A3:这种情况占的是客户端的内存,不会影响Proxy。
+A3:这种情况占的是客户端的内存,不会影响 Proxy。
-Q4:问出现查询大数据量到内存的场景,是不是只能使用原生JDBC,查一批处理一批,不放内存?
+Q4:问出现查询大数据量到内存的场景,是不是只能使用原生 JDBC,查一批处理一批,不放内存?
-A4:Mybatis是在客户端控制的,不影响Proxy。
+A4:Mybatis 是在客户端控制的,不影响 Proxy。
### 直播回放链接
https://m.qlchat.com/topic/details?topicId=2000001395952730&minimal=1
-想了解关于Sharding-Sphere的更多细节?
+想了解关于 Sharding-Sphere 的更多细节?
-**不妨来“2018 DAMS中国数据资产管理峰会”**
+**不妨来“ 2018 DAMS 中国数据资产管理峰会”**
Review comment:
Please remove space before 2018.
##########
File path: docs/blog/content/material/proxy.cn.md
##########
@@ -99,76 +99,76 @@ useServerPrepStmts=true&cachePrepStmts=true

-从第5条消息开始,每次查询只传参数值就可以了,终于达到了一次编译多次运行的效果,MySQL的效率得到了提高。而且由于ExecuteStatement只传了参数的值,消息长度上比完整的SQL短了很多,网络IO的效率也得到了提升。
+从第 5 条消息开始,每次查询只传参数值就可以了,终于达到了一次编译多次运行的效果,MySQL 的效率得到了提高。而且由于 ExecuteStatement 只传了参数的值,消息长度上比完整的 SQL 短了很多,网络 IO 的效率也得到了提升。
-原来cachePrepStmts=true这个参数的意思是告诉JDBC缓存需要prepare的SQL,比如“SELECT * FROM t_order WHERE user_id=?”,运行过一次后,下次再运行就跳过PreparedStatement,直接用ExecuteStatement设置参数值。
+原来 cachePrepStmts=true 这个参数的意思是告诉 JDBC 缓存需要 prepare 的 SQL,比如 “SELECT * FROM t_order WHERE user_id=?”,运行过一次后,下次再运行就跳过 PreparedStatement,直接用 ExecuteStatement 设置参数值。
-明白原理后,就知道该怎么优化Proxy了。Proxy采用的是Hikari数据库连接池,在初始化的时候为其设置上面的两个参数:
+明白原理后,就知道该怎么优化 Proxy 了。Proxy 采用的是 Hikari 数据库连接池,在初始化的时候为其设置上面的两个参数:
```
config.addDataSourceProperty("useServerPrepStmts","true");
config.addDataSourceProperty("cachePrepStmts","true");
```
-这样就保证了Proxy和MySQL服务之间的性能。那么Proxy和Client之间的性能如何保证呢?
+这样就保证了 Proxy 和 MySQL 服务之间的性能。那么 Proxy 和 Client 之间的性能如何保证呢?
-Proxy在收到Client的PreparedStatement的时候,并不会把这条消息转发给MySQL,因为SQL里的分片键是问号,Proxy不知道该路由到哪个真实数据库。Proxy收到这条消息后只是缓存了SQL,存储在一个StatementId到SQL的Map里面,等收到ExecuteStatement的时候才真正请求数据库。
+Proxy 在收到 Client 的 PreparedStatement 的时候,并不会把这条消息转发给 MySQL,因为 SQL 里的分片键是问号,Proxy 不知道该路由到哪个真实数据库。Proxy 收到这条消息后只是缓存了SQL,存储在一个 StatementId 到 SQL 的 Map 里面,等收到 ExecuteStatement 的时候才真正请求数据库。
-这个逻辑在优化前是没问题的,因为每一次查询都是一个新的PreparedStatement流程,ExecuteStatement会把参数类型和参数值告诉客户端。
+这个逻辑在优化前是没问题的,因为每一次查询都是一个新的 PreparedStatement 流程,ExecuteStatement 会把参数类型和参数值告诉客户端。
-加上两个参数后,消息内容发生了变化,ExecuteStatement在发送第二次的时候,消息体里只有参数值而没有参数类型,Proxy不知道类型就不能正确的取出值。所以Proxy需要做的优化就是在PreparedStatement开始的时候缓存参数类型。
+加上两个参数后,消息内容发生了变化,ExecuteStatement 在发送第二次的时候,消息体里只有参数值而没有参数类型,Proxy 不知道类型就不能正确的取出值。所以 Proxy 需要做的优化就是在PreparedStatement 开始的时候缓存参数类型。

-完成以上优化后,Client-Proxy和Proxy-MySQL两侧的消息交互都变成了最后这张图的流程,从第9步开始高效查询。
+完成以上优化后,Client-Proxy 和 Proxy-MySQL 两侧的消息交互都变成了最后这张图的流程,从第9步开始高效查询。
-#### 2. Hikari连接池配置优化
+#### 2. Hikari 连接池配置优化
-Proxy在初始化的时候,会为每一个真实数据库配置一个Hikari连接池。根据分片规则,SQL被路由到某些真实库,通过Hikari连接得到执行结果,最后Proxy对结果进行归并返回给客户端。那么,数据库连接池到底该设置多大?对于这个众说纷纭的话题,今天该有一个定论了。
+Proxy 在初始化的时候,会为每一个真实数据库配置一个 Hikari 连接池。根据分片规则,SQL 被路由到某些真实库,通过 Hikari 连接得到执行结果,最后 Proxy 对结果进行归并返回给客户端。那么,数据库连接池到底该设置多大?对于这个众说纷纭的话题,今天该有一个定论了。
你会惊喜的发现,这个问题不是设置“多大”,反而是应该设置“多小”!如果我说执行一个任务,串行比并行更快,是不是有点反直觉?
-即使是单核CPU的计算机也能“同时”支持数百个线程。但我们都应该知道这只不过是操作系统用“时间片”玩的一个小花招。事实上,一个CPU核心同一时刻只能执行一个线程,然后操作系统切换上下文,CPU执行另一个线程,如此往复。
+即使是单核 CPU 的计算机也能“同时”支持数百个线程。但我们都应该知道这只不过是操作系统用“时间片”玩的一个小花招。事实上,一个CPU核心同一时刻只能执行一个线程,然后操作系统切换上下文,CPU 执行另一个线程,如此往复。
-一个CPU进行计算的基本规律是,顺序执行任务A和任务B永远比通过时间片“同时”执行A和B要快。一旦线程的数量超过了CPU核心的数量,再增加线程数就只会更慢,而不是更快。一个对Oracle的测试验证了这个观点。
+一个 CPU 进行计算的基本规律是,顺序执行任务 A 和任务 B 永远比通过时间片“同时”执行 A 和B要快。一旦线程的数量超过了 CPU 核心的数量,再增加线程数就只会更慢,而不是更快。一个对 Oracle 的测试验证了这个观点。
参考链接:
http://www.dailymotion.com/video/x2s8uec
-测试者把连接池的大小从2048逐渐降低到96,TPS从16163上升到20702,平响从110ms下降到3ms。
+测试者把连接池的大小从 2048 逐渐降低到 96,TPS 从 16163 上升到 20702,平响从 110ms 下降到 3ms。
-当然,也不是那么简单地让连接数等于CPU数就行了,还要考虑网络IO和磁盘IO的影响。当发生IO时,线程被阻塞,此时操作系统可以将那个空闲的CPU核心用于服务其他线程。所以,由于线程总是在I/O上阻塞,我们可以让线程(连接)数比CPU核心多一些,这样能够在同样的时间内完成更多的工作。到底应该多多少呢?PostgreSQL进行了一个benchmark测试:
+当然,也不是那么简单地让连接数等于 CPU 数就行了,还要考虑网络 IO 和磁盘 IO 的影响。当发生 IO 时,线程被阻塞,此时操作系统可以将那个空闲的 CPU 核心用于服务其他线程。所以,由于线程总是在 I/O 上阻塞,我们可以让线程(连接)数比 CPU 核心多一些,这样能够在同样的时间内完成更多的工作。到底应该多多少呢?PostgreSQL 进行了一个 benchmark 测试:

-TPS的增长速度从50个连接的时候开始变慢。根据这个结果,PostgreSQL给出了如下公式:
+TPS 的增长速度从 50 个连接的时候开始变慢。根据这个结果,PostgreSQL 给出了如下公式:
```
connections=((core_count*2)+effective_spindle_count)
-```
+```
-连接数=((核心数\*2)+磁盘数)。即使是32核的机器,60多个连接也就够用了。所以,小伙伴们在配置Proxy数据源的时候,不要动不动就写上几百个连接,不仅浪费资源,还会拖慢速度。
+连接数=((核心数\* 2 )+磁盘数)。即使是 32 核的机器,60 多个连接也就够用了。所以,小伙伴们在配置 Proxy 数据源的时候,不要动不动就写上几百个连接,不仅浪费资源,还会拖慢速度。
#### 3. 结果归并优化
-目前Proxy访问真实数据库使用的是JDBC,很快Netty+MySQLProtocol异步访问方式也会上线,两者会并存,由用户选择用哪种方法访问。
+目前 Proxy 访问真实数据库使用的是 JDBC,很快 Netty+MySQLProtocol 异步访问方式也会上线,两者会并存,由用户选择用哪种方法访问。
-在Proxy中使用JDBC的ResultSet会对内存造成非常大的压力。Proxy前端对应m个client,后端又对应n个真实数据库,后端把数据传递给前端client的过程中,数据都需要经过Proxy的内存。如果数据在Proxy内存中呆的时间长了,那么内存就可能被打满,造成服务不可用的后果。所以,ResultSet内存效率可以从两个方向优化,一个是减少数据在Proxy中的停留时间,另一个是限流。
+在Proxy中使用 JDBC 的 ResultSet 会对内存造成非常大的压力。Proxy 前端对应m个 client,后端又对应n个真实数据库,后端把数据传递给前端 client 的过程中,数据都需要经过 Proxy 的内存。如果数据在 Proxy 内存中呆的时间长了,那么内存就可能被打满,造成服务不可用的后果。所以,ResultSet 内存效率可以从两个方向优化,一个是减少数据在 Proxy 中的停留时间,另一个是限流。
Review comment:
Please add space for m.
--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.
To unsubscribe, e-mail: notifications-unsubscribe@shardingsphere.apache.org
For queries about this service, please contact Infrastructure at:
users@infra.apache.org