You are viewing a plain text version of this content. The canonical link for it is here.
Posted to commits@iotdb.apache.org by le...@apache.org on 2023/06/27 11:16:13 UTC
[iotdb] 01/01: SQL Manual is tooooooo large
This is an automated email from the ASF dual-hosted git repository.
leirui pushed a commit to branch docccccc
in repository https://gitbox.apache.org/repos/asf/iotdb.git
commit 80b885ce0e6f83c92800c222fe1d109a5299b8b5
Author: Lei Rui <10...@qq.com>
AuthorDate: Tue Jun 27 19:15:25 2023 +0800
SQL Manual is tooooooo large
---
docs/zh/UserGuide/API/InfluxDB-Protocol.md | 347 +++
.../UserGuide/API/Programming-Java-Native-API.md | 93 +
.../Administration-Management/Administration.md | 4 +-
.../{Data-Concept => Basic-Concept}/Compression.md | 0
.../Data-Model-and-Terminology.md | 96 +-
.../{Data-Concept => Basic-Concept}/Data-Type.md | 0
.../Deadband-Process.md | 0
.../Encoding-and-Compression.md} | 42 +-
.../{Data-Concept => Basic-Concept}/Encoding.md | 0
.../Schema-Template.md | 0
.../Time-Partition.md | 0
.../{Data-Concept => Basic-Concept}/Time-zone.md | 0
docs/zh/UserGuide/Delete-Data/Delete-Data.md | 2 +-
.../Deployment-and-Maintenance/Deployment-Guide.md | 655 +++++
.../Deployment-and-Maintenance/Docker-Install.md | 156 ++
.../Environmental-Requirement.md | 36 +
.../Get-Installation-Package.md | 84 +
.../Security-Management.md | 537 +++++
.../Ecosystem-Integration/Grafana-Plugin.md | 2 +-
.../UserGuide/Ecosystem-Integration/NiFi-IoTDB.md | 6 +-
.../Edge-Cloud-Collaboration/Sync-Tool.md | 362 +++
.../zh/UserGuide/FAQ/Frequently-asked-questions.md | 102 +-
docs/zh/UserGuide/IoTDB-Introduction/Scenario.md | 75 +-
.../UserGuide/Maintenance-Tools/Watermark-Tool.md | 196 ++
.../Operate-Metadata/Auto-Create-MetaData.md | 2 +-
docs/zh/UserGuide/Operate-Metadata/Timeseries.md | 2 +-
docs/zh/UserGuide/Query-Data/Select-Into.md | 2 +-
docs/zh/UserGuide/Query-Data/Where-Condition.md | 2 +-
docs/zh/UserGuide/QuickStart/ClusterQuickStart.md | 23 +-
.../UserGuide/QuickStart/General-SQL-Statements.md | 159 ++
docs/zh/UserGuide/SQL-Manual/SQL-Manual.md | 2511 ++++++++++++++++++++
31 files changed, 5379 insertions(+), 117 deletions(-)
diff --git a/docs/zh/UserGuide/API/InfluxDB-Protocol.md b/docs/zh/UserGuide/API/InfluxDB-Protocol.md
new file mode 100644
index 00000000000..989ddd4379d
--- /dev/null
+++ b/docs/zh/UserGuide/API/InfluxDB-Protocol.md
@@ -0,0 +1,347 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+## 0.引入依赖
+
+```xml
+ <dependency>
+ <groupId>org.apache.iotdb</groupId>
+ <artifactId>influxdb-protocol</artifactId>
+ <version>1.0.0</version>
+ </dependency>
+```
+
+这里是一些使用 InfluxDB-Protocol 适配器连接 IoTDB 的[示例](https://github.com/apache/iotdb/blob/master/example/influxdb-protocol-example/src/main/java/org/apache/iotdb/influxdb/InfluxDBExample.java)
+
+
+## 1.切换方案
+
+假如您原先接入 InfluxDB 的业务代码如下:
+
+```java
+InfluxDB influxDB = InfluxDBFactory.connect(openurl, username, password);
+```
+
+您只需要将 InfluxDBFactory 替换为 **IoTDBInfluxDBFactory** 即可实现业务向 IoTDB 的切换:
+
+```java
+InfluxDB influxDB = IoTDBInfluxDBFactory.connect(openurl, username, password);
+```
+
+## 2.方案设计
+
+### 2.1 InfluxDB-Protocol适配器
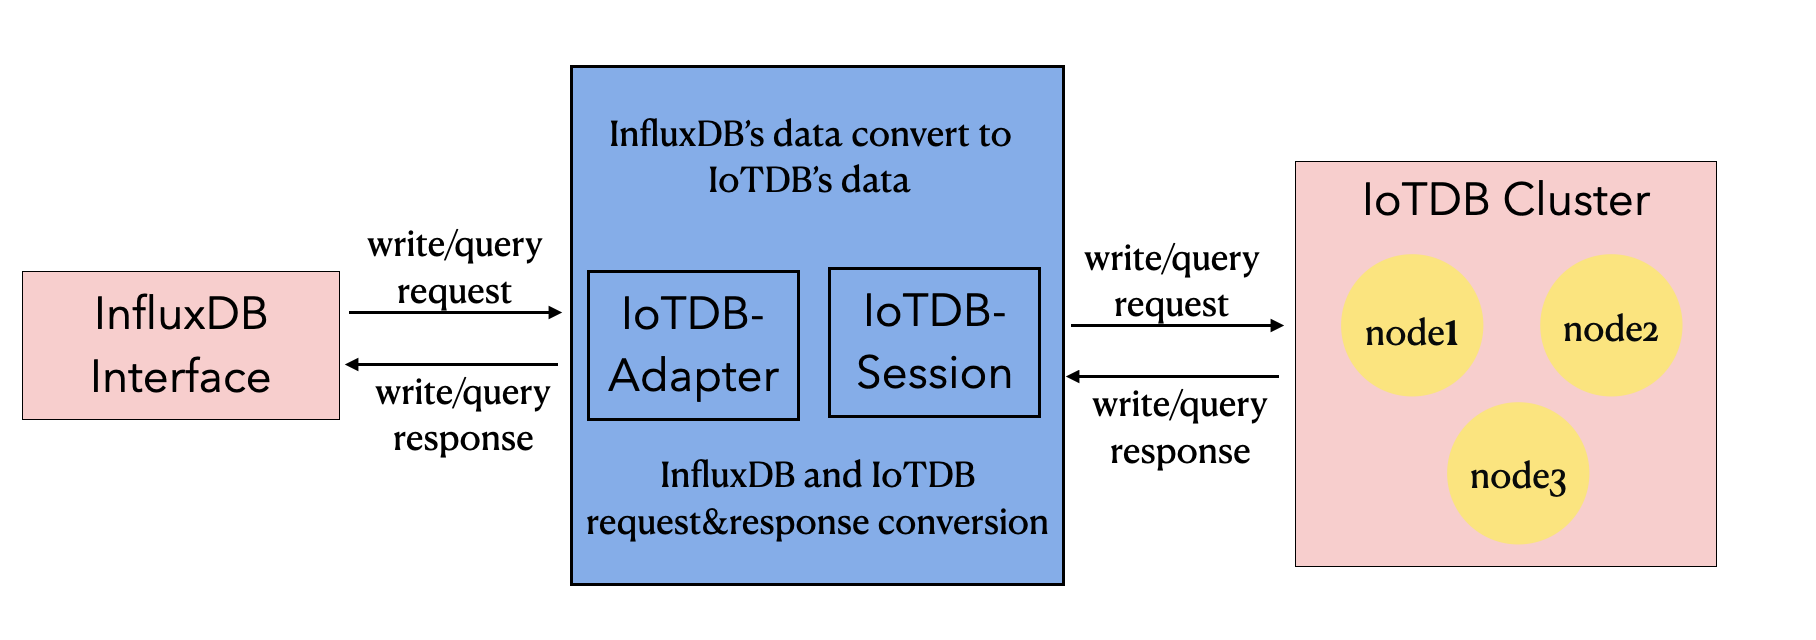
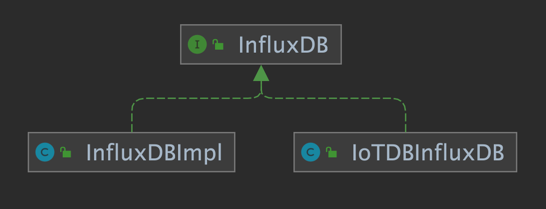
+
+该适配器以 IoTDB Java ServiceProvider 接口为底层基础,实现了 InfluxDB 的 Java 接口 `interface InfluxDB`,对用户提供了所有 InfluxDB 的接口方法,最终用户可以无感知地使用 InfluxDB 协议向 IoTDB 发起写入和读取请求。
+
+
+
+
+
+
+### 2.2 元数据格式转换
+
+InfluxDB 的元数据是 tag-field 模型,IoTDB 的元数据是树形模型。为了使适配器能够兼容 InfluxDB 协议,需要把 InfluxDB 的元数据模型转换成 IoTDB 的元数据模型。
+
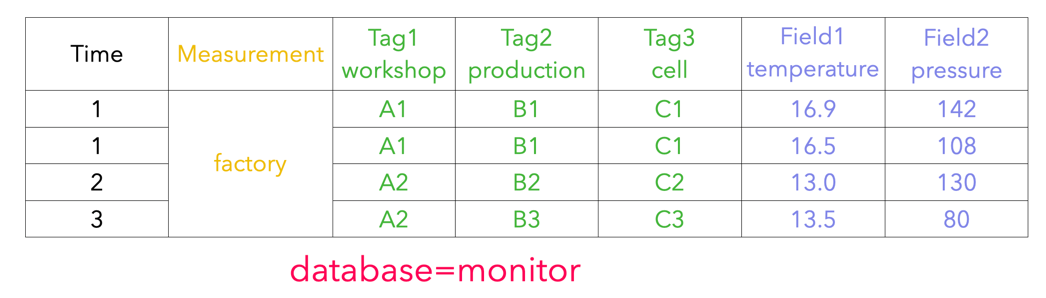
+#### 2.2.1 InfluxDB 元数据
+
+1. database: 数据库名。
+2. measurement: 测量指标名。
+3. tags : 各种有索引的属性。
+4. fields : 各种记录值(没有索引的属性)。
+
+
+
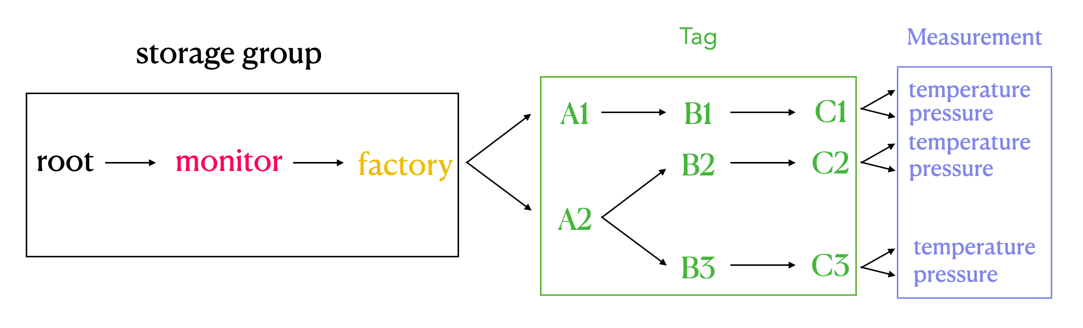
+#### 2.2.2 IoTDB 元数据
+
+1. database: 数据库。
+2. path(time series ID):存储路径。
+3. measurement: 物理量。
+
+
+
+#### 2.2.3 两者映射关系
+
+InfluxDB 元数据和 IoTDB 元数据有着如下的映射关系:
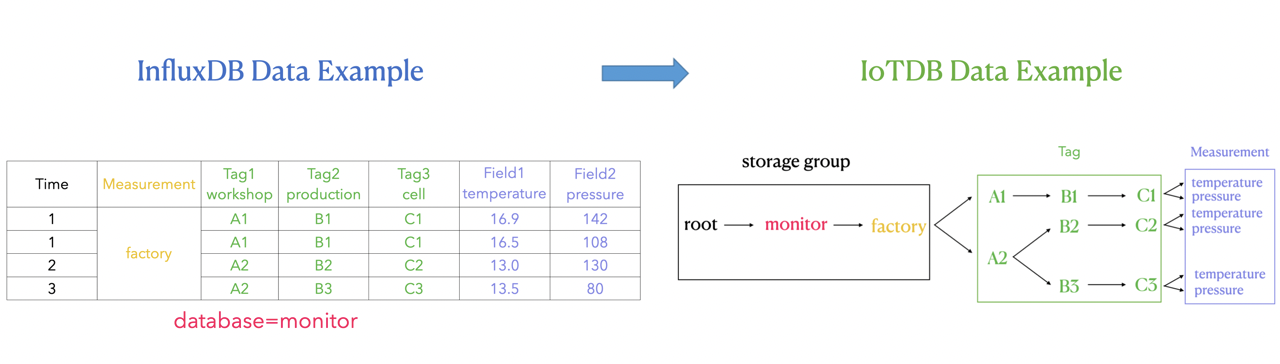
+1. InfluxDB 中的 database 和 measurement 组合起来作为 IoTDB 中的 database。
+2. InfluxDB 中的 field key 作为 IoTDB 中 measurement 路径,InfluxDB 中的 field value 即是该路径下记录的测点值。
+3. InfluxDB 中的 tag 在 IoTDB 中使用 database 和 measurement 之间的路径表达。InfluxDB 的 tag key 由 database 和 measurement 之间路径的顺序隐式表达,tag value 记录为对应顺序的路径的名称。
+
+InfluxDB 元数据向 IoTDB 元数据的转换关系可以由下面的公示表示:
+
+`root.{database}.{measurement}.{tag value 1}.{tag value 2}...{tag value N-1}.{tag value N}.{field key}`
+
+
+
+如上图所示,可以看出:
+
+我们在 IoTDB 中使用 database 和 measurement 之间的路径来表达 InfluxDB tag 的概念,也就是图中右侧绿色方框的部分。
+
+database 和 measurement 之间的每一层都代表一个 tag。如果 tag key 的数量为 N,那么 database 和 measurement 之间的路径的层数就是 N。我们对 database 和 measurement 之间的每一层进行顺序编号,每一个序号都和一个 tag key 一一对应。同时,我们使用 database 和 measurement 之间每一层 **路径的名字** 来记 tag value,tag key 可以通过自身的序号找到对应路径层级下的 tag value.
+
+#### 2.2.4 关键问题
+
+在 InfluxDB 的 SQL 语句中,tag 出现的顺序的不同并不会影响实际的执行结果。
+
+例如:`insert factory, workshop=A1, production=B1 temperature=16.9` 和 `insert factory, production=B1, workshop=A1 temperature=16.9` 两条 InfluxDB SQL 的含义(以及执行结果)相等。
+
+但在 IoTDB 中,上述插入的数据点可以存储在 `root.monitor.factory.A1.B1.temperature` 下,也可以存储在 `root.monitor.factory.B1.A1.temperature` 下。因此,IoTDB 路径中储存的 InfluxDB 的 tag 的顺序是需要被特别考虑的,因为 `root.monitor.factory.A1.B1.temperature` 和
+`root.monitor.factory.B1.A1.temperature` 是两条不同的序列。我们可以认为,IoTDB 元数据模型对 tag 顺序的处理是“敏感”的。
+
+基于上述的考虑,我们还需要在 IoTDB 中记录 InfluxDB 每个 tag 对应在 IoTDB 路径中的层级顺序,以确保在执行 InfluxDB SQL 时,不论 InfluxDB SQL 中 tag 出现的顺序如何,只要该 SQL 表达的是对同一个时间序列上的操作,那么适配器都可以唯一对应到 IoTDB 中的一条时间序列上进行操作。
+
+这里还需要考虑的另一个问题是:InfluxDB 的 tag key 及对应顺序关系应该如何持久化到 IoTDB 数据库中,以确保不会丢失相关信息。
+
+**解决方案:**
+
+**tag key 对应顺序关系在内存中的形式**
+
+通过利用内存中的`Map<Measurement, Map<Tag Key, Order>>` 这样一个 Map 结构,来维护 tag 在 IoTDB 路径层级上的顺序。
+
+``` java
+ Map<String, Map<String, Integer>> measurementTagOrder
+```
+
+可以看出 Map 是一个两层的结构。
+
+第一层的 Key 是 String 类型的 InfluxDB measurement,第一层的 Value 是一个 <String, Integer> 结构的 Map。
+
+第二层的 Key 是 String 类型的 InfluxDB tag key,第二层的 Value 是 Integer 类型的 tag order,也就是 tag 在 IoTDB 路径层级上的顺序。
+
+使用时,就可以先通过 InfluxDB measurement 定位,再通过 InfluxDB tag key 定位,最后就可以获得 tag 在 IoTDB 路径层级上的顺序了。
+
+**tag key 对应顺序关系的持久化方案**
+
+Database 为`root.TAG_INFO`,分别用 database 下的 `database_name`, `measurement_name`, `tag_name` 和 `tag_order` 测点来存储 tag key及其对应的顺序关系。
+
+```
++-----------------------------+---------------------------+------------------------------+----------------------+-----------------------+
+| Time|root.TAG_INFO.database_name|root.TAG_INFO.measurement_name|root.TAG_INFO.tag_name|root.TAG_INFO.tag_order|
++-----------------------------+---------------------------+------------------------------+----------------------+-----------------------+
+|2021-10-12T01:21:26.907+08:00| monitor| factory| workshop| 1|
+|2021-10-12T01:21:27.310+08:00| monitor| factory| production| 2|
+|2021-10-12T01:21:27.313+08:00| monitor| factory| cell| 3|
+|2021-10-12T01:21:47.314+08:00| building| cpu| tempture| 1|
++-----------------------------+---------------------------+------------------------------+----------------------+-----------------------+
+```
+
+
+
+### 2.3 实例
+
+#### 2.3.1 插入数据
+
+1. 假定按照以下的顺序插入三条数据到 InfluxDB 中 (database=monitor):
+
+ (1)`insert student,name=A,phone=B,sex=C score=99`
+
+ (2)`insert student,address=D score=98`
+
+ (3)`insert student,name=A,phone=B,sex=C,address=D score=97`
+
+2. 简单对上述 InfluxDB 的时序进行解释,database 是 monitor; measurement 是student;tag 分别是 name,phone、sex 和 address;field 是 score。
+
+对应的InfluxDB的实际存储为:
+
+```
+time address name phone sex socre
+---- ------- ---- ----- --- -----
+1633971920128182000 A B C 99
+1633971947112684000 D 98
+1633971963011262000 D A B C 97
+```
+
+
+3. IoTDB顺序插入三条数据的过程如下:
+
+ (1)插入第一条数据时,需要将新出现的三个 tag key 更新到 table 中,IoTDB 对应的记录 tag 顺序的 table 为:
+
+ | database | measurement | tag_key | Order |
+ | -------- | ----------- | ------- | ----- |
+ | monitor | student | name | 0 |
+ | monitor | student | phone | 1 |
+ | monitor | student | sex | 2 |
+
+ (2)插入第二条数据时,由于此时记录 tag 顺序的 table 中已经有了三个 tag key,因此需要将出现的第四个 tag key=address 更新记录。IoTDB 对应的记录 tag 顺序的 table 为:
+
+ | database | measurement | tag_key | order |
+ | -------- | ----------- | ------- | ----- |
+ | monitor | student | name | 0 |
+ | monitor | student | phone | 1 |
+ | monitor | student | sex | 2 |
+ | monitor | student | address | 3 |
+
+ (3)插入第三条数据时,此时四个 tag key 都已经记录过,所以不需要更新记录,IoTDB 对应的记录 tag 顺序的 table 为:
+
+ | database | measurement | tag_key | order |
+ | -------- | ----------- | ------- | ----- |
+ | monitor | student | name | 0 |
+ | monitor | student | phone | 1 |
+ | monitor | student | sex | 2 |
+ | monitor | student | address | 3 |
+
+4. (1)第一条插入数据对应 IoTDB 时序为 root.monitor.student.A.B.C
+
+ (2)第二条插入数据对应 IoTDB 时序为 root.monitor.student.PH.PH.PH.D (其中PH表示占位符)。
+
+ 需要注意的是,由于该条数据的 tag key=address 是第四个出现的,但是自身却没有对应的前三个 tag 值,因此需要用 PH 占位符来代替。这样做的目的是保证每条数据中的 tag 顺序不会乱,是符合当前顺序表中的顺序,从而查询数据的时候可以进行指定 tag 过滤。
+
+ (3)第三条插入数据对应 IoTDB 时序为 root.monitor.student.A.B.C.D
+
+ 对应的 IoTDB 的实际存储为:
+
+```
++-----------------------------+--------------------------------+-------------------------------------+----------------------------------+
+| Time|root.monitor.student.A.B.C.score|root.monitor.student.PH.PH.PH.D.score|root.monitor.student.A.B.C.D.score|
++-----------------------------+--------------------------------+-------------------------------------+----------------------------------+
+|2021-10-12T01:21:26.907+08:00| 99| NULL| NULL|
+|2021-10-12T01:21:27.310+08:00| NULL| 98| NULL|
+|2021-10-12T01:21:27.313+08:00| NULL| NULL| 97|
++-----------------------------+--------------------------------+-------------------------------------+----------------------------------+
+```
+
+5. 如果上面三条数据插入的顺序不一样,我们可以看到对应的实际path路径也就发生了改变,因为InfluxDB数据中的Tag出现顺序发生了变化,所对应的到IoTDB中的path节点顺序也就发生了变化。
+
+ 但是这样实际并不会影响查询的正确性,因为一旦Influxdb的Tag顺序确定之后,查询也会按照这个顺序表记录的顺序进行Tag值过滤。所以并不会影响查询的正确性。
+
+#### 2.3.2 查询数据
+
+1. 查询student中phone=B的数据。在database=monitor,measurement=student中tag=phone的顺序为1,order最大值是3,对应到IoTDB的查询为:
+
+ ```sql
+ select * from root.monitor.student.*.B
+ ```
+
+2. 查询student中phone=B且score>97的数据,对应到IoTDB的查询为:
+
+ ```sql
+ select * from root.monitor.student.*.B where score>97
+ ```
+
+3. 查询student中phone=B且score>97且时间在最近七天内的的数据,对应到IoTDB的查询为:
+
+ ```sql
+ select * from root.monitor.student.*.B where score>97 and time > now()-7d
+ ```
+
+
+4. 查询student中name=A或score>97,由于tag存储在路径中,因此没有办法用一次查询同时完成tag和field的**或**语义查询,因此需要多次查询进行或运算求并集,对应到IoTDB的查询为:
+
+ ```sql
+ select * from root.monitor.student.A
+ select * from root.monitor.student where score>97
+ ```
+ 最后手动对上面两次查询结果求并集。
+
+5. 查询student中(name=A或phone=B或sex=C)且score>97,由于tag存储在路径中,因此没有办法用一次查询完成tag的**或**语义, 因此需要多次查询进行或运算求并集,对应到IoTDB的查询为:
+
+ ```sql
+ select * from root.monitor.student.A where score>97
+ select * from root.monitor.student.*.B where score>97
+ select * from root.monitor.student.*.*.C where score>97
+ ```
+ 最后手动对上面三次查询结果求并集。
+
+## 3 支持情况
+
+### 3.1 InfluxDB版本支持情况
+
+目前支持InfluxDB 1.x 版本,暂不支持InfluxDB 2.x 版本。
+
+`influxdb-java`的maven依赖支持2.21+,低版本未进行测试。
+
+### 3.2 函数接口支持情况
+
+目前支持的接口函数如下:
+
+```java
+public Pong ping();
+
+public String version();
+
+public void flush();
+
+public void close();
+
+public InfluxDB setDatabase(final String database);
+
+public QueryResult query(final Query query);
+
+public void write(final Point point);
+
+public void write(final String records);
+
+public void write(final List<String> records);
+
+public void write(final String database,final String retentionPolicy,final Point point);
+
+public void write(final int udpPort,final Point point);
+
+public void write(final BatchPoints batchPoints);
+
+public void write(final String database,final String retentionPolicy,
+final ConsistencyLevel consistency,final String records);
+
+public void write(final String database,final String retentionPolicy,
+final ConsistencyLevel consistency,final TimeUnit precision,final String records);
+
+public void write(final String database,final String retentionPolicy,
+final ConsistencyLevel consistency,final List<String> records);
+
+public void write(final String database,final String retentionPolicy,
+final ConsistencyLevel consistency,final TimeUnit precision,final List<String> records);
+
+public void write(final int udpPort,final String records);
+
+public void write(final int udpPort,final List<String> records);
+```
+
+### 3.3 查询语法支持情况
+
+目前支持的查询sql语法为
+
+```sql
+SELECT <field_key>[, <field_key>, <tag_key>]
+FROM <measurement_name>
+WHERE <conditional_expression > [( AND | OR) <conditional_expression > [...]]
+```
+
+WHERE子句在`field`,`tag`和`timestamp`上支持`conditional_expressions`.
+
+#### field
+
+```sql
+field_key <operator> ['string' | boolean | float | integer]
+```
+
+#### tag
+
+```sql
+tag_key <operator> ['tag_value']
+```
+
+#### timestamp
+
+```sql
+timestamp <operator> ['time']
+```
+
+目前timestamp的过滤条件只支持now()有关表达式,如:now()-7D,具体的时间戳暂不支持。
diff --git a/docs/zh/UserGuide/API/Programming-Java-Native-API.md b/docs/zh/UserGuide/API/Programming-Java-Native-API.md
index 80bd76bf04c..e3469590de7 100644
--- a/docs/zh/UserGuide/API/Programming-Java-Native-API.md
+++ b/docs/zh/UserGuide/API/Programming-Java-Native-API.md
@@ -502,3 +502,96 @@ void testInsertTablets(Map<String, Tablet> tablets)
或 `example/session/src/main/java/org/apache/iotdb/SessionPoolExample.java`
+### 集群信息相关的接口 (仅在集群模式下可用)
+
+集群信息相关的接口允许用户获取如数据分区情况、节点是否当机等信息。
+要使用该 API,需要增加依赖:
+
+```xml
+<dependencies>
+ <dependency>
+ <groupId>org.apache.iotdb</groupId>
+ <artifactId>iotdb-thrift-cluster</artifactId>
+ <version>1.0.0</version>
+ </dependency>
+</dependencies>
+```
+
+建立连接与关闭连接的示例:
+
+```java
+import org.apache.thrift.protocol.TBinaryProtocol;
+import org.apache.thrift.transport.TSocket;
+import org.apache.thrift.transport.TTransport;
+import org.apache.thrift.transport.TTransportException;
+import org.apache.iotdb.rpc.RpcTransportFactory;
+
+public class CluserInfoClient {
+ TTransport transport;
+ ClusterInfoService.Client client;
+ public void connect() {
+ transport =
+ RpcTransportFactory.INSTANCE.getTransport(
+ new TSocket(
+ // the RPC address
+ IoTDBDescriptor.getInstance().getConfig().getRpcAddress(),
+ // the RPC port
+ ClusterDescriptor.getInstance().getConfig().getClusterRpcPort()));
+ try {
+ transport.open();
+ } catch (TTransportException e) {
+ Assert.fail(e.getMessage());
+ }
+ //get the client
+ client = new ClusterInfoService.Client(new TBinaryProtocol(transport));
+ }
+ public void close() {
+ transport.close();
+ }
+}
+```
+
+API 列表:
+
+* 获取集群中的各个节点的信息(构成哈希环)
+
+``` java
+list<Node> getRing();
+```
+
+* 给定一个路径(应包括一个 SG 作为前缀)和起止时间,获取其覆盖的数据分区情况:
+
+```java
+/**
+ * @param path input path (should contains a database name as its prefix)
+ * @return the data partition info. If the time range only covers one data partition, the the size
+ * of the list is one.
+ */
+list<DataPartitionEntry> getDataPartition(1:string path, 2:long startTime, 3:long endTime);
+```
+
+* 给定一个路径(应包括一个 SG 作为前缀),获取其被分到了哪个节点上:
+```java
+/**
+ * @param path input path (should contains a database name as its prefix)
+ * @return metadata partition information
+ */
+list<Node> getMetaPartition(1:string path);
+```
+
+* 获取所有节点的死活状态:
+``` java
+/**
+ * @return key: node, value: live or not
+ */
+map<Node, bool> getAllNodeStatus();
+```
+
+* 获取当前连接节点的 Raft 组信息(投票编号等)(一般用户无需使用该接口):
+```java
+/**
+ * @return A multi-line string with each line representing the total time consumption, invocation
+ * number, and average time consumption.
+ */
+string getInstrumentingInfo();
+```
diff --git a/docs/zh/UserGuide/Administration-Management/Administration.md b/docs/zh/UserGuide/Administration-Management/Administration.md
index 3f1efa9663b..e171f7513c9 100644
--- a/docs/zh/UserGuide/Administration-Management/Administration.md
+++ b/docs/zh/UserGuide/Administration-Management/Administration.md
@@ -23,7 +23,7 @@
IoTDB 为用户提供了权限管理操作,从而为用户提供对于数据的权限管理功能,保障数据的安全。
-我们将通过以下几个具体的例子为您示范基本的用户权限操作,详细的 SQL 语句及使用方式详情请参见本文 [数据模式与概念章节](../Data-Concept/Data-Model-and-Terminology.md)。同时,在 JAVA 编程环境中,您可以使用 [JDBC API](../API/Programming-JDBC.md) 单条或批量执行权限管理类语句。
+我们将通过以下几个具体的例子为您示范基本的用户权限操作,详细的 SQL 语句及使用方式详情请参见本文 [数据模式与概念章节](../Basic-Concept/Data-Model-and-Terminology.md)。同时,在 JAVA 编程环境中,您可以使用 [JDBC API](../API/Programming-JDBC.md) 单条或批量执行权限管理类语句。
## 基本概念
@@ -33,7 +33,7 @@ IoTDB 为用户提供了权限管理操作,从而为用户提供对于数据
### 权限
-数据库提供多种操作,并不是所有的用户都能执行所有操作。如果一个用户可以执行某项操作,则称该用户有执行该操作的权限。权限可分为数据管理权限(如对数据进行增删改查)以及权限管理权限(用户、角色的创建与删除,权限的赋予与撤销等)。数据管理权限往往需要一个路径来限定其生效范围,可使用[路径模式](../Data-Concept/Data-Model-and-Terminology.md)灵活管理权限。
+数据库提供多种操作,并不是所有的用户都能执行所有操作。如果一个用户可以执行某项操作,则称该用户有执行该操作的权限。权限可分为数据管理权限(如对数据进行增删改查)以及权限管理权限(用户、角色的创建与删除,权限的赋予与撤销等)。数据管理权限往往需要一个路径来限定其生效范围,可使用[路径模式](../Basic-Concept/Data-Model-and-Terminology.md)灵活管理权限。
### 角色
diff --git a/docs/zh/UserGuide/Data-Concept/Compression.md b/docs/zh/UserGuide/Basic-Concept/Compression.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Compression.md
rename to docs/zh/UserGuide/Basic-Concept/Compression.md
diff --git a/docs/zh/UserGuide/Data-Concept/Data-Model-and-Terminology.md b/docs/zh/UserGuide/Basic-Concept/Data-Model-and-Terminology.md
similarity index 94%
rename from docs/zh/UserGuide/Data-Concept/Data-Model-and-Terminology.md
rename to docs/zh/UserGuide/Basic-Concept/Data-Model-and-Terminology.md
index 63e38265947..d2958f438be 100644
--- a/docs/zh/UserGuide/Data-Concept/Data-Model-and-Terminology.md
+++ b/docs/zh/UserGuide/Basic-Concept/Data-Model-and-Terminology.md
@@ -31,17 +31,7 @@
IoTDB 模型结构涉及的基本概念在下文将做详细叙述。
-## 物理量、实体、数据库、路径
-
-### 物理量(Measurement)
-
-**物理量**,也称工况或字段(field),是在实际场景中检测装置所记录的测量信息,且可以按一定规律变换成为电信号或其他所需形式的信息输出并发送给 IoTDB。在 IoTDB 当中,存储的所有数据及路径,都是以物理量为单位进行组织。
-
-### 实体(Entity)
-
-**一个物理实体**,也称设备(device),是在实际场景中拥有物理量的设备或装置。在 IoTDB 当中,所有的物理量都有其对应的归属实体。
-
-### 数据库(Database)
+## 数据库(Database)
用户可以将任意前缀路径设置成数据库。如有 4 条时间序列`root.ln.wf01.wt01.status`, `root.ln.wf01.wt01.temperature`, `root.ln.wf02.wt02.hardware`, `root.ln.wf02.wt02.status`,路径`root.ln`下的两个实体 `wt01`, `wt02`可能属于同一个业主,或者同一个制造商,这时候就可以将前缀路径`root.ln`指定为一个数据库。未来`root.ln`下增加了新的实体,也将属于该数据库。
@@ -50,7 +40,7 @@ IoTDB 模型结构涉及的基本概念在下文将做详细叙述。
> 注意 1:不允许将一个完整路径(如上例的`root.ln.wf01.wt01.status`) 设置成 database。
>
> 注意 2:一个时间序列其前缀必须属于某个 database。在创建时间序列之前,用户必须设定该序列属于哪个database。只有设置了 database 的时间序列才可以被持久化在磁盘上。
->
+>
> 注意 3:被设置为数据库的路径总字符数不能超过64,包括路径开头的`root.`这5个字符。
一个前缀路径一旦被设定成 database 后就不可以再更改这个 database 的设定。
@@ -59,47 +49,14 @@ IoTDB 模型结构涉及的基本概念在下文将做详细叙述。
Database 节点名只支持中英文字符、数字和下划线的组合。例如`root.数据库_1` 。
-### 路径(Path)
+## 设备(Device)
-路径(`path`)是指符合以下约束的表达式:
+**一个物理设备**,也称实体(Entity),是在实际场景中拥有物理量的设备或装置。在 IoTDB 当中,所有的物理量都有其对应的归属实体。实体是管理的一组时间序列的组合,可以是一个物理设备、测量装置、传感器集合等。
-```sql
-path
- : nodeName ('.' nodeName)*
- ;
-
-nodeName
- : wildcard? identifier wildcard?
- | wildcard
- ;
-
-wildcard
- : '*'
- | '**'
- ;
-```
-
-我们称一个路径中由 `'.'` 分割的部分叫做路径结点名(`nodeName`)。例如:`root.a.b.c`为一个层级为 4 的路径。
-
-下面是对路径结点名(`nodeName`)的约束:
-
-* `root` 作为一个保留字符,它只允许出现在下文提到的时间序列的开头,若其他层级出现 `root`,则无法解析,提示报错。
-* 除了时间序列的开头的层级(`root`)外,其他的层级支持的字符如下:
- * [ 0-9 a-z A-Z _ ] (字母,数字,下划线)
- * ['\u2E80'..'\u9FFF'] (UNICODE 中文字符)
-* 特别地,如果系统在 Windows 系统上部署,那么 database 路径结点名是大小写不敏感的。例如,同时创建`root.ln` 和 `root.LN` 是不被允许的。
-* 如果需要在路径结点名中用特殊字符,可以用反引号引用路径结点名,具体使用方法可以参考[语法约定](../Syntax-Conventions/Literal-Values.md)。
-
-### 路径模式(Path Pattern)
-
-为了使得在表达多个时间序列的时候更加方便快捷,IoTDB 为用户提供带通配符`*`或`**`的路径。用户可以利用两种通配符构造出期望的路径模式。通配符可以出现在路径中的任何层。
-
-`*`在路径中表示一层。例如`root.vehicle.*.sensor1`代表的是以`root.vehicle`为前缀,以`sensor1`为后缀,层次等于 4 层的路径。
-
-`**`在路径中表示是(`*`)+,即为一层或多层`*`。例如`root.vehicle.device1.**`代表的是`root.vehicle.device1.*`, `root.vehicle.device1.*.*`, `root.vehicle.device1.*.*.*`等所有以`root.vehicle.device1`为前缀路径的大于等于 4 层的路径;`root.vehicle.**.sensor1`代表的是以`root.vehicle`为前缀,以`sensor1`为后缀,层次大于等于 4 层的路径。
-> 注意:`*`和`**`不能放在路径开头。
+## 物理量(Measurement)
+**物理量**,也称工况或字段(field),是在实际场景中检测装置所记录的测量信息,且可以按一定规律变换成为电信号或其他所需形式的信息输出并发送给 IoTDB。在 IoTDB 当中,存储的所有数据及路径,都是以物理量为单位进行组织。
## 时间序列
@@ -138,3 +95,44 @@ wildcard
<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/114125919-f4850800-9929-11eb-8211-81d4c04af1ec.png">
在后续数据定义语言、数据操作语言和 Java 原生接口章节,将对涉及到对齐时间序列的各种操作进行逐一介绍。
+
+## 路径(Path)
+
+路径(`path`)是指符合以下约束的表达式:
+
+```sql
+path
+ : nodeName ('.' nodeName)*
+ ;
+
+nodeName
+ : wildcard? identifier wildcard?
+ | wildcard
+ ;
+
+wildcard
+ : '*'
+ | '**'
+ ;
+```
+
+我们称一个路径中由 `'.'` 分割的部分叫做路径结点名(`nodeName`)。例如:`root.a.b.c`为一个层级为 4 的路径。
+
+下面是对路径结点名(`nodeName`)的约束:
+
+* `root` 作为一个保留字符,它只允许出现在下文提到的时间序列的开头,若其他层级出现 `root`,则无法解析,提示报错。
+* 除了时间序列的开头的层级(`root`)外,其他的层级支持的字符如下:
+ * [ 0-9 a-z A-Z _ ] (字母,数字,下划线)
+ * ['\u2E80'..'\u9FFF'] (UNICODE 中文字符)
+* 特别地,如果系统在 Windows 系统上部署,那么 database 路径结点名是大小写不敏感的。例如,同时创建`root.ln` 和 `root.LN` 是不被允许的。
+* 如果需要在路径结点名中用特殊字符,可以用反引号引用路径结点名,具体使用方法可以参考[语法约定](../Syntax-Conventions/Literal-Values.md)。
+
+## 路径模式(Path Pattern)
+
+为了使得在表达多个时间序列的时候更加方便快捷,IoTDB 为用户提供带通配符`*`或`**`的路径。用户可以利用两种通配符构造出期望的路径模式。通配符可以出现在路径中的任何层。
+
+`*`在路径中表示一层。例如`root.vehicle.*.sensor1`代表的是以`root.vehicle`为前缀,以`sensor1`为后缀,层次等于 4 层的路径。
+
+`**`在路径中表示是(`*`)+,即为一层或多层`*`。例如`root.vehicle.device1.**`代表的是`root.vehicle.device1.*`, `root.vehicle.device1.*.*`, `root.vehicle.device1.*.*.*`等所有以`root.vehicle.device1`为前缀路径的大于等于 4 层的路径;`root.vehicle.**.sensor1`代表的是以`root.vehicle`为前缀,以`sensor1`为后缀,层次大于等于 4 层的路径。
+
+> 注意:`*`和`**`不能放在路径开头。
diff --git a/docs/zh/UserGuide/Data-Concept/Data-Type.md b/docs/zh/UserGuide/Basic-Concept/Data-Type.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Data-Type.md
rename to docs/zh/UserGuide/Basic-Concept/Data-Type.md
diff --git a/docs/zh/UserGuide/Data-Concept/Deadband-Process.md b/docs/zh/UserGuide/Basic-Concept/Deadband-Process.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Deadband-Process.md
rename to docs/zh/UserGuide/Basic-Concept/Deadband-Process.md
diff --git a/docs/zh/UserGuide/Data-Concept/Encoding.md b/docs/zh/UserGuide/Basic-Concept/Encoding-and-Compression.md
similarity index 71%
copy from docs/zh/UserGuide/Data-Concept/Encoding.md
copy to docs/zh/UserGuide/Basic-Concept/Encoding-and-Compression.md
index 5da4a73fe92..a3da260c7f7 100644
--- a/docs/zh/UserGuide/Data-Concept/Encoding.md
+++ b/docs/zh/UserGuide/Basic-Concept/Encoding-and-Compression.md
@@ -78,14 +78,14 @@ RLBE编码是一种无损编码,将差分编码,位填充编码,游程长
前文介绍的五种编码适用于不同的数据类型,若对应关系错误,则无法正确创建时间序列。数据类型与支持其编码的编码方式对应关系总结如下表所示。
-| 数据类型 | 支持的编码 |
-|:---------:|:-----------------------------------------------------------:|
-| BOOLEAN | PLAIN, RLE |
-| INT32 | PLAIN, RLE, TS_2DIFF, GORILLA, ZIGZAG, CHIMP, SPRINTZ, RLBE |
-| INT64 | PLAIN, RLE, TS_2DIFF, GORILLA, ZIGZAG, CHIMP, SPRINTZ, RLBE |
-| FLOAT | PLAIN, RLE, TS_2DIFF, GORILLA, CHIMP, SPRINTZ, RLBE |
-| DOUBLE | PLAIN, RLE, TS_2DIFF, GORILLA, CHIMP, SPRINTZ, RLBE |
-| TEXT | PLAIN, DICTIONARY |
+| 数据类型 | 支持的编码 |
+| :------: | :---------------------------------------------------------: |
+| BOOLEAN | PLAIN, RLE |
+| INT32 | PLAIN, RLE, TS_2DIFF, GORILLA, ZIGZAG, CHIMP, SPRINTZ, RLBE |
+| INT64 | PLAIN, RLE, TS_2DIFF, GORILLA, ZIGZAG, CHIMP, SPRINTZ, RLBE |
+| FLOAT | PLAIN, RLE, TS_2DIFF, GORILLA, CHIMP, SPRINTZ, RLBE |
+| DOUBLE | PLAIN, RLE, TS_2DIFF, GORILLA, CHIMP, SPRINTZ, RLBE |
+| TEXT | PLAIN, DICTIONARY |
当用户输入的数据类型与编码方式不对应时,系统会提示错误。如下所示,二阶差分编码不支持布尔类型:
@@ -93,3 +93,29 @@ RLBE编码是一种无损编码,将差分编码,位填充编码,游程长
IoTDB> create timeseries root.ln.wf02.wt02.status WITH DATATYPE=BOOLEAN, ENCODING=TS_2DIFF
Msg: 507: encoding TS_2DIFF does not support BOOLEAN
```
+
+## 压缩方式
+
+当时间序列写入并按照指定的类型编码为二进制数据后,IoTDB 会使用压缩技术对该数据进行压缩,进一步提升空间存储效率。虽然编码和压缩都旨在提升存储效率,但编码技术通常只适合特定的数据类型(如二阶差分编码只适合与 INT32 或者 INT64 编码,存储浮点数需要先将他们乘以 10m 以转换为整数),然后将它们转换为二进制流。压缩方式(SNAPPY)针对二进制流进行压缩,因此压缩方式的使用不再受数据类型的限制。
+
+### 基本压缩方式
+
+IoTDB 允许在创建一个时间序列的时候指定该列的压缩方式。现阶段 IoTDB 支持以下几种压缩方式:
+
+* UNCOMPRESSED(不压缩)
+* SNAPPY 压缩
+* LZ4 压缩
+* GZIP 压缩
+* ZSTD 压缩
+* LZMA2 压缩
+
+压缩方式的指定语法详见本文 [SQL 参考文档](../Reference/SQL-Reference.md)。
+
+### 压缩比统计信息
+
+压缩比统计信息文件:data/system/compression_ratio/Ratio-{ratio_sum}-{memtable_flush_time}
+
+* ratio_sum: memtable压缩比的总和
+* memtable_flush_time: memtable刷盘的总次数
+
+通过 `ratio_sum / memtable_flush_time` 可以计算出平均压缩比
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Data-Concept/Encoding.md b/docs/zh/UserGuide/Basic-Concept/Encoding.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Encoding.md
rename to docs/zh/UserGuide/Basic-Concept/Encoding.md
diff --git a/docs/zh/UserGuide/Data-Concept/Schema-Template.md b/docs/zh/UserGuide/Basic-Concept/Schema-Template.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Schema-Template.md
rename to docs/zh/UserGuide/Basic-Concept/Schema-Template.md
diff --git a/docs/zh/UserGuide/Data-Concept/Time-Partition.md b/docs/zh/UserGuide/Basic-Concept/Time-Partition.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Time-Partition.md
rename to docs/zh/UserGuide/Basic-Concept/Time-Partition.md
diff --git a/docs/zh/UserGuide/Data-Concept/Time-zone.md b/docs/zh/UserGuide/Basic-Concept/Time-zone.md
similarity index 100%
rename from docs/zh/UserGuide/Data-Concept/Time-zone.md
rename to docs/zh/UserGuide/Basic-Concept/Time-zone.md
diff --git a/docs/zh/UserGuide/Delete-Data/Delete-Data.md b/docs/zh/UserGuide/Delete-Data/Delete-Data.md
index 562027f3fb8..9a708308359 100644
--- a/docs/zh/UserGuide/Delete-Data/Delete-Data.md
+++ b/docs/zh/UserGuide/Delete-Data/Delete-Data.md
@@ -65,7 +65,7 @@ delete from root.ln.wf02.wt02.status
## 多传感器时间序列值删除
-当 ln 集团 wf02 子站的 wt02 设备在 2017-11-01 16:26:00 之前的供电状态和设备硬件版本都需要删除,此时可以使用含义更广的 [路径模式(Path Pattern)](../Data-Concept/Data-Model-and-Terminology.md) 进行删除操作,进行此操作的 SQL 语句为:
+当 ln 集团 wf02 子站的 wt02 设备在 2017-11-01 16:26:00 之前的供电状态和设备硬件版本都需要删除,此时可以使用含义更广的 [路径模式(Path Pattern)](../Basic-Concept/Data-Model-and-Terminology.md) 进行删除操作,进行此操作的 SQL 语句为:
```sql
diff --git a/docs/zh/UserGuide/Deployment-and-Maintenance/Deployment-Guide.md b/docs/zh/UserGuide/Deployment-and-Maintenance/Deployment-Guide.md
new file mode 100644
index 00000000000..f7bc34df1c0
--- /dev/null
+++ b/docs/zh/UserGuide/Deployment-and-Maintenance/Deployment-Guide.md
@@ -0,0 +1,655 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 部署指导
+
+## 单机版部署
+
+本文将介绍关于 IoTDB 使用的基本流程,如果需要更多信息,请浏览我们官网的 [指引](../IoTDB-Introduction/What-is-IoTDB.md).
+
+### 安装环境
+
+安装前需要保证设备上配有 JDK>=1.8 的运行环境,并配置好 JAVA_HOME 环境变量。
+
+设置最大文件打开数为 65535。
+
+### 安装步骤
+
+IoTDB 支持多种安装途径。用户可以使用三种方式对 IoTDB 进行安装——下载二进制可运行程序、使用源码、使用 docker 镜像。
+
+* 使用源码:您可以从代码仓库下载源码并编译,具体编译方法见下方。
+
+* 二进制可运行程序:请从 [下载](https://iotdb.apache.org/Download/) 页面下载最新的安装包,解压后即完成安装。
+
+* 使用 Docker 镜像:dockerfile 文件位于[github](https://github.com/apache/iotdb/blob/master/docker/src/main)
+
+### 软件目录结构
+
+* sbin 启动和停止脚本目录
+* conf 配置文件目录
+* tools 系统工具目录
+* lib 依赖包目录
+
+### IoTDB 试用
+
+用户可以根据以下操作对 IoTDB 进行简单的试用,若以下操作均无误,则说明 IoTDB 安装成功。
+
+#### 启动 IoTDB
+
+IoTDB 是一个基于分布式系统的数据库。要启动 IoTDB ,你可以先启动单机版(一个 ConfigNode 和一个 DataNode)来检查安装。
+
+用户可以使用 sbin 文件夹下的 start-standalone 脚本启动 IoTDB。
+
+Linux 系统与 MacOS 系统启动命令如下:
+
+```
+> bash sbin/start-standalone.sh
+```
+
+Windows 系统启动命令如下:
+
+```
+> sbin\start-standalone.bat
+```
+
+注意:目前,要使用单机模式,你需要保证所有的地址设置为 127.0.0.1,如果需要从非 IoTDB 所在的机器访问此IoTDB,请将配置项 `dn_rpc_address` 修改为 IoTDB 所在的机器 IP。副本数设置为1。并且,推荐使用 SimpleConsensus,因为这会带来额外的效率。这些现在都是默认配置。
+
+## 集群版部署
+以本地环境为例,演示 IoTDB 集群的启动、扩容与缩容。
+
+**注意:本文档为使用本地不同端口,进行伪分布式环境部署的教程,仅用于练习。在真实环境部署时,一般不需要修改节点端口,仅需配置节点 IPV4 地址或域名即可。**
+
+### 1. 准备启动环境
+
+解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster0 目录。
+
+### 2. 启动最小集群
+
+在 Linux 环境中,部署 1 个 ConfigNode 和 1 个 DataNode(1C1D)集群版,默认 1 副本:
+
+```
+./cluster0/sbin/start-confignode.sh
+./cluster0/sbin/start-datanode.sh
+```
+
+### 3. 验证最小集群
+
++ 最小集群启动成功,启动 Cli 进行验证:
+
+```
+./cluster0/sbin/start-cli.sh
+```
+
++ 在 Cli 执行 [show cluster details](https://iotdb.apache.org/zh/UserGuide/Master/Maintenance-Tools/Maintenance-Command.html#%E6%9F%A5%E7%9C%8B%E5%85%A8%E9%83%A8%E8%8A%82%E7%82%B9%E4%BF%A1%E6%81%AF)
+ 指令,结果如下所示:
+
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort |SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
++------+----------+-------+---------------+------------+-------------------+----------+-------+--------+-------------------+-----------------+
+Total line number = 2
+It costs 0.242s
+```
+
+### 4. 准备扩容环境
+
+解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster1 目录和 cluster2 目录
+
+### 5. 修改节点配置文件
+
+对于 cluster1 目录:
+
++ 修改 ConfigNode 配置:
+
+| **配置项** | **值** |
+| ------------------------------ | --------------- |
+| cn\_internal\_address | 127.0.0.1 |
+| cn\_internal\_port | 10711 |
+| cn\_consensus\_port | 10721 |
+| cn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
++ 修改 DataNode 配置:
+
+| **配置项** | **值** |
+| ----------------------------------- | --------------- |
+| dn\_rpc\_address | 127.0.0.1 |
+| dn\_rpc\_port | 6668 |
+| dn\_internal\_address | 127.0.0.1 |
+| dn\_internal\_port | 10731 |
+| dn\_mpp\_data\_exchange\_port | 10741 |
+| dn\_schema\_region\_consensus\_port | 10751 |
+| dn\_data\_region\_consensus\_port | 10761 |
+| dn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
+对于 cluster2 目录:
+
++ 修改 ConfigNode 配置:
+
+| **配置项** | **值** |
+| ------------------------------ | --------------- |
+| cn\_internal\_address | 127.0.0.1 |
+| cn\_internal\_port | 10712 |
+| cn\_consensus\_port | 10722 |
+| cn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
++ 修改 DataNode 配置:
+
+| **配置项** | **值** |
+| ----------------------------------- | --------------- |
+| dn\_rpc\_address | 127.0.0.1 |
+| dn\_rpc\_port | 6669 |
+| dn\_internal\_address | 127.0.0.1 |
+| dn\_internal\_port | 10732 |
+| dn\_mpp\_data\_exchange\_port | 10742 |
+| dn\_schema\_region\_consensus\_port | 10752 |
+| dn\_data\_region\_consensus\_port | 10762 |
+| dn\_target\_config\_node\_list | 127.0.0.1:10710 |
+
+### 6. 集群扩容
+
+将集群扩容至 3 个 ConfigNode 和 3 个 DataNode(3C3D)集群版,
+指令执行顺序为先启动 ConfigNode,再启动 DataNode:
+
+```
+./cluster1/sbin/start-confignode.sh
+./cluster2/sbin/start-confignode.sh
+./cluster1/sbin/start-datanode.sh
+./cluster2/sbin/start-datanode.sh
+```
+
+### 7. 验证扩容结果
+
+在 Cli 执行 `show cluster details`,结果如下:
+
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort|SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 2|ConfigNode|Running| 127.0.0.1| 10711| 10721| | | | | |
+| 3|ConfigNode|Running| 127.0.0.1| 10712| 10722| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
+| 4| DataNode|Running| 127.0.0.1| 10731| | 127.0.0.1| 6668| 10741| 10751| 10761|
+| 5| DataNode|Running| 127.0.0.1| 10732| | 127.0.0.1| 6669| 10742| 10752| 10762|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+Total line number = 6
+It costs 0.012s
+```
+
+### 8. 集群缩容
+
++ 缩容一个 ConfigNode:
+
+```
+# 使用 ip:port 移除
+./cluster0/sbin/remove-confignode.sh 127.0.0.1:10711
+
+# 使用节点编号移除
+./cluster0/sbin/remove-confignode.sh 2
+```
+
++ 缩容一个 DataNode:
+
+```
+# 使用 ip:port 移除
+./cluster0/sbin/remove-datanode.sh 127.0.0.1:6668
+
+# 使用节点编号移除
+./cluster0/sbin/remove-confignode.sh 4
+```
+
+### 9. 验证缩容结果
+
+在 Cli 执行 `show cluster details`,结果如下:
+
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort|RpcAddress|RpcPort|MppPort|SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+| 0|ConfigNode|Running| 127.0.0.1| 10710| 10720| | | | | |
+| 3|ConfigNode|Running| 127.0.0.1| 10712| 10722| | | | | |
+| 1| DataNode|Running| 127.0.0.1| 10730| | 127.0.0.1| 6667| 10740| 10750| 10760|
+| 5| DataNode|Running| 127.0.0.1| 10732| | 127.0.0.1| 6669| 10742| 10752| 10762|
++------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
+Total line number = 4
+It costs 0.005s
+```
+
+## 手动部署
+
+### 前置检查
+
+1. JDK>=1.8 的运行环境,并配置好 JAVA_HOME 环境变量。
+2. 设置最大文件打开数为 65535。
+3. 关闭交换内存。
+4. 首次启动ConfigNode节点时,确保已清空ConfigNode节点的data/confignode目录;首次启动DataNode节点时,确保已清空DataNode节点的data/datanode目录。
+5. 如果整个集群处在可信环境下,可以关闭机器上的防火墙选项。
+6. 在集群默认配置中,ConfigNode 会占用端口 10710 和 10720,DataNode 会占用端口 6667、10730、10740、10750 和 10760,
+ 请确保这些端口未被占用,或者手动修改配置文件中的端口配置。
+
+### 安装包获取
+
+你可以选择下载二进制文件(见 3.1)或从源代码编译(见 3.2)。
+
+#### 下载二进制文件
+
+1. 打开官网[Download Page](https://iotdb.apache.org/Download/)。
+2. 下载 IoTDB 1.0.0 版本的二进制文件。
+3. 解压得到 apache-iotdb-1.0.0-all-bin 目录。
+
+#### 使用源码编译
+
+##### 下载源码
+
+**Git**
+
+```
+git clone https://github.com/apache/iotdb.git
+git checkout v1.0.0
+```
+
+**官网下载**
+
+1. 打开官网[Download Page](https://iotdb.apache.org/Download/)。
+2. 下载 IoTDB 1.0.0 版本的源码。
+3. 解压得到 apache-iotdb-1.0.0 目录。
+
+##### 编译源码
+
+在 IoTDB 源码根目录下:
+
+```
+mvn clean package -pl distribution -am -DskipTests
+```
+
+编译成功后,可在目录
+**distribution/target/apache-iotdb-1.0.0-SNAPSHOT-all-bin/apache-iotdb-1.0.0-SNAPSHOT-all-bin**
+找到集群版本的二进制文件。
+
+### 安装包说明
+
+打开 apache-iotdb-1.0.0-SNAPSHOT-all-bin,可见以下目录:
+
+| **目录** | **说明** |
+| -------- | ------------------------------------------------------------ |
+| conf | 配置文件目录,包含 ConfigNode、DataNode、JMX 和 logback 等配置文件 |
+| data | 数据文件目录,包含 ConfigNode 和 DataNode 的数据文件 |
+| lib | 库文件目录 |
+| licenses | 证书文件目录 |
+| logs | 日志文件目录,包含 ConfigNode 和 DataNode 的日志文件 |
+| sbin | 脚本目录,包含 ConfigNode 和 DataNode 的启停移除脚本,以及 Cli 的启动脚本等 |
+| tools | 系统工具目录 |
+
+### 集群安装配置
+
+#### 集群安装
+
+`apache-iotdb-1.0.0-SNAPSHOT-all-bin` 包含 ConfigNode 和 DataNode,
+请将安装包部署于你目标集群的所有机器上,推荐将安装包部署于所有服务器的相同目录下。
+
+如果你希望先在一台服务器上尝试部署 IoTDB 集群,请参考
+[Cluster Quick Start](https://iotdb.apache.org/zh/UserGuide/Master/QuickStart/ClusterQuickStart.html)。
+
+#### 集群配置
+
+接下来需要修改每个服务器上的配置文件,登录服务器,
+并将工作路径切换至 `apache-iotdb-1.0.0-SNAPSHOT-all-bin`,
+配置文件在 `./conf` 目录内。
+
+对于所有部署 ConfigNode 的服务器,需要修改通用配置(见 5.2.1)和 ConfigNode 配置(见 5.2.2)。
+
+对于所有部署 DataNode 的服务器,需要修改通用配置(见 5.2.1)和 DataNode 配置(见 5.2.3)。
+
+##### 通用配置
+
+打开通用配置文件 ./conf/iotdb-common.properties,
+可根据 [部署推荐](https://iotdb.apache.org/zh/UserGuide/Master/Cluster/Deployment-Recommendation.html)
+设置以下参数:
+
+| **配置项** | **说明** | **默认** |
+| ------------------------------------------ | ------------------------------------------------------------ | ----------------------------------------------- |
+| cluster\_name | 节点希望加入的集群的名称 | defaultCluster |
+| config\_node\_consensus\_protocol\_class | ConfigNode 使用的共识协议 | org.apache.iotdb.consensus.ratis.RatisConsensus |
+| schema\_replication\_factor | 元数据副本数,DataNode 数量不应少于此数目 | 1 |
+| schema\_region\_consensus\_protocol\_class | 元数据副本组的共识协议 | org.apache.iotdb.consensus.ratis.RatisConsensus |
+| data\_replication\_factor | 数据副本数,DataNode 数量不应少于此数目 | 1 |
+| data\_region\_consensus\_protocol\_class | 数据副本组的共识协议。注:RatisConsensus 目前不支持多数据目录 | org.apache.iotdb.consensus.iot.IoTConsensus |
+
+**注意:上述配置项在集群启动后即不可更改,且务必保证所有节点的通用配置完全一致,否则节点无法启动。**
+
+##### ConfigNode 配置
+
+打开 ConfigNode 配置文件 ./conf/iotdb-confignode.properties,根据服务器/虚拟机的 IP 地址和可用端口,设置以下参数:
+
+| **配置项** | **说明** | **默认** | **用法** |
+| ------------------------------ | ------------------------------------------------------------ | --------------- | ------------------------------------------------------------ |
+| cn\_internal\_address | ConfigNode 在集群内部通讯使用的地址 | 127.0.0.1 | 设置为服务器的 IPV4 地址或域名 |
+| cn\_internal\_port | ConfigNode 在集群内部通讯使用的端口 | 10710 | 设置为任意未占用端口 |
+| cn\_consensus\_port | ConfigNode 副本组共识协议通信使用的端口 | 10720 | 设置为任意未占用端口 |
+| cn\_target\_config\_node\_list | 节点注册加入集群时连接的 ConfigNode 的地址。注:只能配置一个 | 127.0.0.1:10710 | 对于 Seed-ConfigNode,设置为自己的 cn\_internal\_address:cn\_internal\_port;对于其它 ConfigNode,设置为另一个正在运行的 ConfigNode 的 cn\_internal\_address:cn\_internal\_port |
+
+**注意:上述配置项在节点启动后即不可更改,且务必保证所有端口均未被占用,否则节点无法启动。**
+
+##### DataNode 配置
+
+打开 DataNode 配置文件 ./conf/iotdb-datanode.properties,根据服务器/虚拟机的 IP 地址和可用端口,设置以下参数:
+
+| **配置项** | **说明** | **默认** | **用法** |
+| ----------------------------------- | ----------------------------------------- | --------------- | ------------------------------------------------------------ |
+| dn\_rpc\_address | 客户端 RPC 服务的地址 | 127.0.0.1 | 设置为服务器的 IPV4 地址或域名 |
+| dn\_rpc\_port | 客户端 RPC 服务的端口 | 6667 | 设置为任意未占用端口 |
+| dn\_internal\_address | DataNode 在集群内部接收控制流使用的地址 | 127.0.0.1 | 设置为服务器的 IPV4 地址或域名 |
+| dn\_internal\_port | DataNode 在集群内部接收控制流使用的端口 | 10730 | 设置为任意未占用端口 |
+| dn\_mpp\_data\_exchange\_port | DataNode 在集群内部接收数据流使用的端口 | 10740 | 设置为任意未占用端口 |
+| dn\_data\_region\_consensus\_port | DataNode 的数据副本间共识协议通信的端口 | 10750 | 设置为任意未占用端口 |
+| dn\_schema\_region\_consensus\_port | DataNode 的元数据副本间共识协议通信的端口 | 10760 | 设置为任意未占用端口 |
+| dn\_target\_config\_node\_list | 集群中正在运行的 ConfigNode 地址 | 127.0.0.1:10710 | 设置为任意正在运行的 ConfigNode 的 cn\_internal\_address:cn\_internal\_port,可设置多个,用逗号(",")隔开 |
+
+**注意:上述配置项在节点启动后即不可更改,且务必保证所有端口均未被占用,否则节点无法启动。**
+
+### 集群操作
+
+#### 启动集群
+
+本小节描述如何启动包括若干 ConfigNode 和 DataNode 的集群。
+集群可以提供服务的标准是至少启动一个 ConfigNode 且启动 不小于(数据/元数据)副本个数 的 DataNode。
+
+总体启动流程分为三步:
+
+1. 启动种子 ConfigNode
+2. 增加 ConfigNode(可选)
+3. 增加 DataNode
+
+##### 启动 Seed-ConfigNode
+
+**集群第一个启动的节点必须是 ConfigNode,第一个启动的 ConfigNode 必须遵循本小节教程。**
+
+第一个启动的 ConfigNode 是 Seed-ConfigNode,标志着新集群的创建。
+在启动 Seed-ConfigNode 前,请打开通用配置文件 ./conf/iotdb-common.properties,并检查如下参数:
+
+| **配置项** | **检查** |
+| ------------------------------------------ | -------------------------- |
+| cluster\_name | 已设置为期望的集群名称 |
+| config\_node\_consensus\_protocol\_class | 已设置为期望的共识协议 |
+| schema\_replication\_factor | 已设置为期望的元数据副本数 |
+| schema\_region\_consensus\_protocol\_class | 已设置为期望的共识协议 |
+| data\_replication\_factor | 已设置为期望的数据副本数 |
+| data\_region\_consensus\_protocol\_class | 已设置为期望的共识协议 |
+
+**注意:** 请根据[部署推荐](https://iotdb.apache.org/zh/UserGuide/Master/Cluster/Deployment-Recommendation.html)配置合适的通用参数,这些参数在首次配置后即不可修改。
+
+接着请打开它的配置文件 ./conf/iotdb-confignode.properties,并检查如下参数:
+
+| **配置项** | **检查** |
+| ------------------------------ | ------------------------------------------------------------ |
+| cn\_internal\_address | 已设置为服务器的 IPV4 地址或域名 |
+| cn\_internal\_port | 该端口未被占用 |
+| cn\_consensus\_port | 该端口未被占用 |
+| cn\_target\_config\_node\_list | 已设置为自己的内部通讯地址,即 cn\_internal\_address:cn\_internal\_port |
+
+检查完毕后,即可在服务器上运行启动脚本:
+
+```
+# Linux 前台启动
+bash ./sbin/start-confignode.sh
+
+# Linux 后台启动
+nohup bash ./sbin/start-confignode.sh >/dev/null 2>&1 &
+
+# Windows
+.\sbin\start-confignode.bat
+```
+
+ConfigNode 的其它配置参数可参考
+[ConfigNode 配置参数](https://iotdb.apache.org/zh/UserGuide/Master/Reference/ConfigNode-Config-Manual.html)。
+
+##### 增加更多 ConfigNode(可选)
+
+**只要不是第一个启动的 ConfigNode 就必须遵循本小节教程。**
+
+可向集群添加更多 ConfigNode,以保证 ConfigNode 的高可用。常用的配置为额外增加两个 ConfigNode,使集群共有三个 ConfigNode。
+
+新增的 ConfigNode 需要保证 ./conf/iotdb-common.properites 中的所有配置参数与 Seed-ConfigNode 完全一致,否则可能启动失败或产生运行时错误。
+因此,请着重检查通用配置文件中的以下参数:
+
+| **配置项** | **检查** |
+| ------------------------------------------ | --------------------------- |
+| cluster\_name | 与 Seed-ConfigNode 保持一致 |
+| config\_node\_consensus\_protocol\_class | 与 Seed-ConfigNode 保持一致 |
+| schema\_replication\_factor | 与 Seed-ConfigNode 保持一致 |
+| schema\_region\_consensus\_protocol\_class | 与 Seed-ConfigNode 保持一致 |
+| data\_replication\_factor | 与 Seed-ConfigNode 保持一致 |
+| data\_region\_consensus\_protocol\_class | 与 Seed-ConfigNode 保持一致 |
+
+接着请打开它的配置文件 ./conf/iotdb-confignode.properties,并检查以下参数:
+
+| **配置项** | **检查** |
+| ------------------------------ | ------------------------------------------------------------ |
+| cn\_internal\_address | 已设置为服务器的 IPV4 地址或域名 |
+| cn\_internal\_port | 该端口未被占用 |
+| cn\_consensus\_port | 该端口未被占用 |
+| cn\_target\_config\_node\_list | 已设置为另一个正在运行的 ConfigNode 的内部通讯地址,推荐使用 Seed-ConfigNode 的内部通讯地址 |
+
+检查完毕后,即可在服务器上运行启动脚本:
+
+```
+# Linux 前台启动
+bash ./sbin/start-confignode.sh
+
+# Linux 后台启动
+nohup bash ./sbin/start-confignode.sh >/dev/null 2>&1 &
+
+# Windows
+.\sbin\start-confignode.bat
+```
+
+ConfigNode 的其它配置参数可参考
+[ConfigNode配置参数](https://iotdb.apache.org/zh/UserGuide/Master/Reference/ConfigNode-Config-Manual.html)。
+
+##### 增加 DataNode
+
+**确保集群已有正在运行的 ConfigNode 后,才能开始增加 DataNode。**
+
+可以向集群中添加任意个 DataNode。
+在添加新的 DataNode 前,请先打开通用配置文件 ./conf/iotdb-common.properties 并检查以下参数:
+
+| **配置项** | **检查** |
+| ------------- | --------------------------- |
+| cluster\_name | 与 Seed-ConfigNode 保持一致 |
+
+接着打开它的配置文件 ./conf/iotdb-datanode.properties 并检查以下参数:
+
+| **配置项** | **检查** |
+| ----------------------------------- | ------------------------------------------------------------ |
+| dn\_rpc\_address | 已设置为服务器的 IPV4 地址或域名 |
+| dn\_rpc\_port | 该端口未被占用 |
+| dn\_internal\_address | 已设置为服务器的 IPV4 地址或域名 |
+| dn\_internal\_port | 该端口未被占用 |
+| dn\_mpp\_data\_exchange\_port | 该端口未被占用 |
+| dn\_data\_region\_consensus\_port | 该端口未被占用 |
+| dn\_schema\_region\_consensus\_port | 该端口未被占用 |
+| dn\_target\_config\_node\_list | 已设置为正在运行的 ConfigNode 的内部通讯地址,推荐使用 Seed-ConfigNode 的内部通讯地址 |
+
+检查完毕后,即可在服务器上运行启动脚本:
+
+```
+# Linux 前台启动
+bash ./sbin/start-datanode.sh
+
+# Linux 后台启动
+nohup bash ./sbin/start-datanode.sh >/dev/null 2>&1 &
+
+# Windows
+.\sbin\start-datanode.bat
+```
+
+DataNode 的其它配置参数可参考
+[DataNode配置参数](https://iotdb.apache.org/zh/UserGuide/Master/Reference/DataNode-Config-Manual.html)。
+
+**注意:当且仅当集群拥有不少于副本个数(max{schema\_replication\_factor, data\_replication\_factor})的 DataNode 后,集群才可以提供服务**
+
+#### 启动 Cli
+
+若搭建的集群仅用于本地调试,可直接执行 ./sbin 目录下的 Cli 启动脚本:
+
+```
+# Linux
+./sbin/start-cli.sh
+
+# Windows
+.\sbin\start-cli.bat
+```
+
+若希望通过 Cli 连接生产环境的集群,
+请阅读 [Cli 使用手册](https://iotdb.apache.org/zh/UserGuide/Master/QuickStart/Command-Line-Interface.html)。
+
+#### 验证集群
+
+以在6台服务器上启动的3C3D(3个ConfigNode 和 3个DataNode)集群为例,
+这里假设3个ConfigNode的IP地址依次为192.168.1.10、192.168.1.11、192.168.1.12,且3个ConfigNode启动时均使用了默认的端口10710与10720;
+3个DataNode的IP地址依次为192.168.1.20、192.168.1.21、192.168.1.22,且3个DataNode启动时均使用了默认的端口6667、10730、10740、10750与10760。
+
+当按照6.1步骤成功启动集群后,在 Cli 执行 `show cluster details`,看到的结果应当如下:
+
+```
+IoTDB> show cluster details
++------+----------+-------+---------------+------------+-------------------+------------+-------+-------+-------------------+-----------------+
+|NodeID| NodeType| Status|InternalAddress|InternalPort|ConfigConsensusPort| RpcAddress|RpcPort|MppPort|SchemaConsensusPort|DataConsensusPort|
++------+----------+-------+---------------+------------+-------------------+------------+-------+-------+-------------------+-----------------+
+| 0|ConfigNode|Running| 192.168.1.10| 10710| 10720| | | | | |
+| 2|ConfigNode|Running| 192.168.1.11| 10710| 10720| | | | | |
+| 3|ConfigNode|Running| 192.168.1.12| 10710| 10720| | | | | |
+| 1| DataNode|Running| 192.168.1.20| 10730| |192.168.1.20| 6667| 10740| 10750| 10760|
+| 4| DataNode|Running| 192.168.1.21| 10730| |192.168.1.21| 6667| 10740| 10750| 10760|
+| 5| DataNode|Running| 192.168.1.22| 10730| |192.168.1.22| 6667| 10740| 10750| 10760|
++------+----------+-------+---------------+------------+-------------------+------------+-------+-------+-------------------+-----------------+
+Total line number = 6
+It costs 0.012s
+```
+
+若所有节点的状态均为 **Running**,则说明集群部署成功;
+否则,请阅读启动失败节点的运行日志,并检查对应的配置参数。
+
+#### 停止 IoTDB 进程
+
+本小节描述如何手动关闭 IoTDB 的 ConfigNode 或 DataNode 进程。
+
+##### 使用脚本停止 ConfigNode
+
+执行停止 ConfigNode 脚本:
+
+```
+# Linux
+./sbin/stop-confignode.sh
+
+# Windows
+.\sbin\stop-confignode.bat
+```
+
+##### 使用脚本停止 DataNode
+
+执行停止 DataNode 脚本:
+
+```
+# Linux
+./sbin/stop-datanode.sh
+
+# Windows
+.\sbin\stop-datanode.bat
+```
+
+##### 停止节点进程
+
+首先获取节点的进程号:
+
+```
+jps
+
+# 或
+
+ps aux | grep iotdb
+```
+
+结束进程:
+
+```
+kill -9 <pid>
+```
+
+**注意:有些端口的信息需要 root 权限才能获取,在此情况下请使用 sudo**
+
+#### 集群缩容
+
+本小节描述如何将 ConfigNode 或 DataNode 移出集群。
+
+##### 移除 ConfigNode
+
+在移除 ConfigNode 前,请确保移除后集群至少还有一个活跃的 ConfigNode。
+在活跃的 ConfigNode 上执行 remove-confignode 脚本:
+
+```
+# Linux
+## 根据 confignode_id 移除节点
+./sbin/remove-confignode.sh <confignode_id>
+
+## 根据 ConfigNode 内部通讯地址和端口移除节点
+./sbin/remove-confignode.sh <cn_internal_address>:<cn_internal_port>
+
+
+# Windows
+## 根据 confignode_id 移除节点
+.\sbin\remove-confignode.bat <confignode_id>
+
+## 根据 ConfigNode 内部通讯地址和端口移除节点
+.\sbin\remove-confignode.bat <cn_internal_address>:<cn_internal_port>
+```
+
+##### 移除 DataNode
+
+在移除 DataNode 前,请确保移除后集群至少还有不少于(数据/元数据)副本个数的 DataNode。
+在活跃的 DataNode 上执行 remove-datanode 脚本:
+
+```
+# Linux
+## 根据 datanode_id 移除节点
+./sbin/remove-datanode.sh <datanode_id>
+
+## 根据 DataNode RPC 服务地址和端口移除节点
+./sbin/remove-datanode.sh <dn_rpc_address>:<dn_rpc_port>
+
+
+# Windows
+## 根据 datanode_id 移除节点
+.\sbin\remove-datanode.bat <datanode_id>
+
+## 根据 DataNode RPC 服务地址和端口移除节点
+.\sbin\remove-datanode.bat <dn_rpc_address>:<dn_rpc_port>
+```
+
+### 常见问题
+
+请参考 [分布式部署FAQ](https://iotdb.apache.org/zh/UserGuide/Master/FAQ/FAQ-for-cluster-setup.html)
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Deployment-and-Maintenance/Docker-Install.md b/docs/zh/UserGuide/Deployment-and-Maintenance/Docker-Install.md
new file mode 100644
index 00000000000..26ee2ff0f0d
--- /dev/null
+++ b/docs/zh/UserGuide/Deployment-and-Maintenance/Docker-Install.md
@@ -0,0 +1,156 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# docker部署
+
+Apache IoTDB 的 Docker 镜像已经上传至 [https://hub.docker.com/r/apache/iotdb](https://hub.docker.com/r/apache/iotdb)。
+Apache IoTDB 的配置项以环境变量形式添加到容器内。
+
+## docker镜像安装(单机版)
+
+```shell
+# 获取镜像
+docker pull apache/iotdb:1.1.0-standalone
+# 创建 docker bridge 网络
+docker network create --driver=bridge --subnet=172.18.0.0/16 --gateway=172.18.0.1 iotdb
+# 创建 docker 容器
+# 注意:必须固定IP部署。IP改变会导致 confignode 启动失败。
+docker run -d --name iotdb-service \
+ --hostname iotdb-service \
+ --network iotdb \
+ --ip 172.18.0.6 \
+ -p 6667:6667 \
+ -e cn_internal_address=iotdb-service \
+ -e cn_target_config_node_list=iotdb-service:10710 \
+ -e cn_internal_port=10710 \
+ -e cn_consensus_port=10720 \
+ -e dn_rpc_address=iotdb-service \
+ -e dn_internal_address=iotdb-service \
+ -e dn_target_config_node_list=iotdb-service:10710 \
+ -e dn_mpp_data_exchange_port=10740 \
+ -e dn_schema_region_consensus_port=10750 \
+ -e dn_data_region_consensus_port=10760 \
+ -e dn_rpc_port=6667 \
+ apache/iotdb:1.1.0-standalone
+# 尝试使用命令行执行SQL
+docker exec -ti iotdb-service /iotdb/sbin/start-cli.sh -h iotdb-service
+```
+
+外部连接:
+
+```shell
+# <主机IP/hostname> 是物理机的真实IP或域名。如果在同一台物理机,可以是127.0.0.1。
+$IOTDB_HOME/sbin/start-cli.sh -h <主机IP/hostname> -p 6667
+```
+
+```yaml
+# docker-compose-1c1d.yml
+version: "3"
+services:
+ iotdb-service:
+ image: apache/iotdb:1.1.0-standalone
+ hostname: iotdb-service
+ container_name: iotdb-service
+ ports:
+ - "6667:6667"
+ environment:
+ - cn_internal_address=iotdb-service
+ - cn_internal_port=10710
+ - cn_consensus_port=10720
+ - cn_target_config_node_list=iotdb-service:10710
+ - dn_rpc_address=iotdb-service
+ - dn_internal_address=iotdb-service
+ - dn_rpc_port=6667
+ - dn_mpp_data_exchange_port=10740
+ - dn_schema_region_consensus_port=10750
+ - dn_data_region_consensus_port=10760
+ - dn_target_config_node_list=iotdb-service:10710
+ volumes:
+ - ./data:/iotdb/data
+ - ./logs:/iotdb/logs
+ networks:
+ iotdb:
+ ipv4_address: 172.18.0.6
+
+networks:
+ iotdb:
+ external: true
+```
+
+## docker镜像安装(集群版)
+
+目前只支持 host 网络和 overlay 网络,不支持 bridge 网络。overlay 网络参照[1C2D](https://github.com/apache/iotdb/tree/master/docker/src/main/DockerCompose/docker-compose-cluster-1c2d.yml)的写法,host 网络如下。
+
+假如有三台物理机,它们的hostname分别是iotdb-1、iotdb-2、iotdb-3。依次启动。
+以 iotdb-2 节点的docker-compose文件为例:
+
+```yaml
+version: "3"
+services:
+ iotdb-confignode:
+ image: apache/iotdb:1.1.0-confignode
+ container_name: iotdb-confignode
+ environment:
+ - cn_internal_address=iotdb-2
+ - cn_target_config_node_list=iotdb-1:10710
+ - schema_replication_factor=3
+ - cn_internal_port=10710
+ - cn_consensus_port=10720
+ - schema_region_consensus_protocol_class=org.apache.iotdb.consensus.ratis.RatisConsensus
+ - config_node_consensus_protocol_class=org.apache.iotdb.consensus.ratis.RatisConsensus
+ - data_replication_factor=3
+ - data_region_consensus_protocol_class=org.apache.iotdb.consensus.iot.IoTConsensus
+ volumes:
+ - /etc/hosts:/etc/hosts:ro
+ - ./data/confignode:/iotdb/data
+ - ./logs/confignode:/iotdb/logs
+ network_mode: "host"
+
+ iotdb-datanode:
+ image: apache/iotdb:1.1.0-datanode
+ container_name: iotdb-datanode
+ environment:
+ - dn_rpc_address=iotdb-2
+ - dn_internal_address=iotdb-2
+ - dn_target_config_node_list=iotdb-1:10710
+ - data_replication_factor=3
+ - dn_rpc_port=6667
+ - dn_mpp_data_exchange_port=10740
+ - dn_schema_region_consensus_port=10750
+ - dn_data_region_consensus_port=10760
+ - data_region_consensus_protocol_class=org.apache.iotdb.consensus.iot.IoTConsensus
+ - schema_replication_factor=3
+ - schema_region_consensus_protocol_class=org.apache.iotdb.consensus.ratis.RatisConsensus
+ - config_node_consensus_protocol_class=org.apache.iotdb.consensus.ratis.RatisConsensus
+ volumes:
+ - /etc/hosts:/etc/hosts:ro
+ - ./data/datanode:/iotdb/data/
+ - ./logs/datanode:/iotdb/logs/
+ network_mode: "host"
+```
+
+注意:
+
+1. `dn_target_config_node_list`所有节点配置一样,需要配置第一个启动的节点,这里为`iotdb-1`。
+2. 上面docker-compose文件中,`iotdb-2`需要替换为每个节点的 hostname、域名或者IP地址。
+3. 需要映射`/etc/hosts`,文件内配置了 iotdb-1、iotdb-2、iotdb-3 与IP的映射。或者可以在 docker-compose 文件中增加 `extra_hosts` 配置。
+4. 首次启动时,必须首先启动 `iotdb-1`。
+5. 如果部署失败要重新部署集群,必须将所有节点上的IoTDB服务停止并删除,然后清除`data`和`logs`文件夹后,再启动。
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Deployment-and-Maintenance/Environmental-Requirement.md b/docs/zh/UserGuide/Deployment-and-Maintenance/Environmental-Requirement.md
new file mode 100644
index 00000000000..60b6fce4985
--- /dev/null
+++ b/docs/zh/UserGuide/Deployment-and-Maintenance/Environmental-Requirement.md
@@ -0,0 +1,36 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+## 环境要求
+
+要使用IoTDB,你需要具备以下条件:
+
+* Java >= 1.8
+> 1.8, 11到17都是经过验证的。请确保环境路径已被相应设置。
+
+* Maven >= 3.6
+> 如果你想从源代码编译和安装IoTDB)。
+* 设置最大打开文件数为65535,以避免出现 "太多的打开文件 "的错误。
+* (可选)将somaxconn设置为65535,以避免系统在高负载时出现 "连接重置 "错误。
+
+
+> **# Linux** <br>`sudo sysctl -w net.core.somaxconn=65535` <br>**# FreeBSD 或 Darwin** <br>`sudo sysctl -w kern.ipc.somaxconn=65535`
+
diff --git a/docs/zh/UserGuide/Deployment-and-Maintenance/Get-Installation-Package.md b/docs/zh/UserGuide/Deployment-and-Maintenance/Get-Installation-Package.md
new file mode 100644
index 00000000000..17d6f2e604e
--- /dev/null
+++ b/docs/zh/UserGuide/Deployment-and-Maintenance/Get-Installation-Package.md
@@ -0,0 +1,84 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 安装包获取
+
+IoTDB 为您提供了两种安装方式,您可以参考下面的建议,任选其中一种:
+
+第一种,从官网下载安装包。这是我们推荐使用的安装方式,通过该方式,您将得到一个可以立即使用的、打包好的二进制可执行文件。
+
+第二种,使用源码编译。若您需要自行修改代码,可以使用该安装方式。
+
+## 安装环境要求
+
+安装前请保证您的电脑上配有 JDK>=1.8 的运行环境,并配置好 JAVA_HOME 环境变量。
+
+如果您需要从源码进行编译,还需要安装:
+
+1. Maven >= 3.6 的运行环境,具体安装方法可以参考以下链接:[https://maven.apache.org/install.html](https://maven.apache.org/install.html)。
+
+> 注: 也可以选择不安装,使用我们提供的'mvnw' 或 'mvnw.cmd' 工具。使用时请用'mvnw' 或 'mvnw.cmd'命令代替下文的'mvn'命令。
+
+## 从官网下载二进制可执行文件
+
+您可以从 [http://iotdb.apache.org/Download/](http://iotdb.apache.org/Download/) 上下载已经编译好的可执行程序 iotdb-xxx.zip,该压缩包包含了 IoTDB 系统运行所需的所有必要组件。
+
+下载后,您可使用以下操作对 IoTDB 的压缩包进行解压:
+
+```
+Shell > unzip iotdb-<version>.zip
+```
+
+## 使用源码编译
+
+您可以获取已发布的源码 [https://iotdb.apache.org/Download/](https://iotdb.apache.org/Download/) ,或者从 [https://github.com/apache/iotdb/tree/master](https://github.com/apache/iotdb/tree/master) git 仓库获取
+
+源码克隆后,进入到源码文件夹目录下。如果您想编译已经发布过的版本,可以先用`git checkout -b my_{project.version} v{project.version}`命令新建并切换分支。比如您要编译0.12.4这个版本,您可以用如下命令去切换分支:
+
+```shell
+> git checkout -b my_0.12.4 v0.12.4
+```
+
+切换分支之后就可以使用以下命令进行编译:
+
+```
+> mvn clean package -pl server -am -Dmaven.test.skip=true
+```
+
+编译后,IoTDB 服务器会在 "server/target/iotdb-server-{project.version}" 文件夹下,包含以下内容:
+
+```
++- sbin/ <-- script files
+|
++- conf/ <-- configuration files
+|
++- lib/ <-- project dependencies
+|
++- tools/ <-- system tools
+```
+
+如果您想要编译项目中的某个模块,您可以在源码文件夹中使用`mvn clean package -pl {module.name} -am -DskipTests`命令进行编译。如果您需要的是带依赖的 jar 包,您可以在编译命令后面加上`-P get-jar-with-dependencies`参数。比如您想编译带依赖的 jdbc jar 包,您就可以使用以下命令进行编译:
+
+```shell
+> mvn clean package -pl jdbc -am -DskipTests -P get-jar-with-dependencies
+```
+
+编译完成后就可以在`{module.name}/target`目录中找到需要的包了。
diff --git a/docs/zh/UserGuide/Deployment-and-Maintenance/Security-Management.md b/docs/zh/UserGuide/Deployment-and-Maintenance/Security-Management.md
new file mode 100644
index 00000000000..f44034b1274
--- /dev/null
+++ b/docs/zh/UserGuide/Deployment-and-Maintenance/Security-Management.md
@@ -0,0 +1,537 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# 安全控制
+
+## 权限管理
+
+IoTDB 为用户提供了权限管理操作,从而为用户提供对于数据的权限管理功能,保障数据的安全。
+
+我们将通过以下几个具体的例子为您示范基本的用户权限操作,详细的 SQL 语句及使用方式详情请参见本文 [数据模式与概念章节](../Basic-Concept/Data-Model-and-Terminology.md)。同时,在 JAVA 编程环境中,您可以使用 [JDBC API](../API/Programming-JDBC.md) 单条或批量执行权限管理类语句。
+
+### 基本概念
+
+#### 用户
+
+用户即数据库的合法使用者。一个用户与一个唯一的用户名相对应,并且拥有密码作为身份验证的手段。一个人在使用数据库之前,必须先提供合法的(即存于数据库中的)用户名与密码,使得自己成为用户。
+
+#### 权限
+
+数据库提供多种操作,并不是所有的用户都能执行所有操作。如果一个用户可以执行某项操作,则称该用户有执行该操作的权限。权限可分为数据管理权限(如对数据进行增删改查)以及权限管理权限(用户、角色的创建与删除,权限的赋予与撤销等)。数据管理权限往往需要一个路径来限定其生效范围,可使用[路径模式](../Basic-Concept/Data-Model-and-Terminology.md)灵活管理权限。
+
+#### 角色
+
+角色是若干权限的集合,并且有一个唯一的角色名作为标识符。用户通常和一个现实身份相对应(例如交通调度员),而一个现实身份可能对应着多个用户。这些具有相同现实身份的用户往往具有相同的一些权限。角色就是为了能对这样的权限进行统一的管理的抽象。
+
+#### 默认用户及其具有的角色
+
+初始安装后的 IoTDB 中有一个默认用户:root,默认密码为 root。该用户为管理员用户,固定拥有所有权限,无法被赋予、撤销权限,也无法被删除。
+
+### 权限操作示例
+
+根据本文中描述的 [样例数据](https://github.com/thulab/iotdb/files/4438687/OtherMaterial-Sample.Data.txt) 内容,IoTDB 的样例数据可能同时属于 ln, sgcc 等不同发电集团,不同的发电集团不希望其他发电集团获取自己的数据库数据,因此我们需要将不同的数据在集团层进行权限隔离。
+
+#### 创建用户
+
+使用 `CREATE USER <userName> <password>` 创建用户。例如,我们可以使用具有所有权限的root用户为 ln 和 sgcc 集团创建两个用户角色,名为 ln_write_user, sgcc_write_user,密码均为 write_pwd。建议使用反引号(`)包裹用户名。SQL 语句为:
+
+```
+CREATE USER `ln_write_user` 'write_pwd'
+CREATE USER `sgcc_write_user` 'write_pwd'
+```
+
+此时使用展示用户的 SQL 语句:
+
+```
+LIST USER
+```
+
+我们可以看到这两个已经被创建的用户,结果如下:
+
+```
+IoTDB> CREATE USER `ln_write_user` 'write_pwd'
+Msg: The statement is executed successfully.
+IoTDB> CREATE USER `sgcc_write_user` 'write_pwd'
+Msg: The statement is executed successfully.
+IoTDB> LIST USER
++---------------+
+| user|
++---------------+
+| ln_write_user|
+| root|
+|sgcc_write_user|
++---------------+
+Total line number = 3
+It costs 0.157s
+```
+
+#### 赋予用户权限
+
+此时,虽然两个用户已经创建,但是他们不具有任何权限,因此他们并不能对数据库进行操作,例如我们使用 ln_write_user 用户对数据库中的数据进行写入,SQL 语句为:
+
+```
+INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+```
+
+此时,系统不允许用户进行此操作,会提示错误:
+
+```
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+```
+
+现在,我们用root用户分别赋予他们向对应 database 数据的写入权限.
+
+我们使用 `GRANT USER <userName> PRIVILEGES <privileges> ON <nodeName>` 语句赋予用户权限(注:其中,创建用户权限无需指定路径),例如:
+
+```
+GRANT USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+GRANT USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+GRANT USER `ln_write_user` PRIVILEGES CREATE_USER
+```
+
+执行状态如下所示:
+
+```
+IoTDB> GRANT USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+Msg: The statement is executed successfully.
+IoTDB> GRANT USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+Msg: The statement is executed successfully.
+IoTDB> GRANT USER `ln_write_user` PRIVILEGES CREATE_USER
+Msg: The statement is executed successfully.
+```
+
+接着使用ln_write_user再尝试写入数据
+
+```
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+Msg: The statement is executed successfully.
+```
+
+#### 撤销用户权限
+
+授予用户权限后,我们可以使用 `REVOKE USER <userName> PRIVILEGES <privileges> ON <nodeName>` 来撤销已授予的用户权限(注:其中,撤销创建用户权限无需指定路径)。例如,用root用户撤销ln_write_user和sgcc_write_user的权限:
+
+```
+REVOKE USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+REVOKE USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+REVOKE USER `ln_write_user` PRIVILEGES CREATE_USER
+```
+
+执行状态如下所示:
+
+```
+REVOKE USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+Msg: The statement is executed successfully.
+REVOKE USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+Msg: The statement is executed successfully.
+REVOKE USER `ln_write_user` PRIVILEGES CREATE_USER
+Msg: The statement is executed successfully.
+```
+
+撤销权限后,ln_write_user就没有向root.ln.**写入数据的权限了。
+
+```
+INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+```
+
+#### SQL 语句
+
+与权限相关的语句包括:
+
+* 创建用户
+
+```
+CREATE USER <userName> <password>;
+Eg: IoTDB > CREATE USER `thulab` 'passwd';
+```
+
+* 删除用户
+
+```
+DROP USER <userName>;
+Eg: IoTDB > DROP USER `xiaoming`;
+```
+
+* 创建角色
+
+```
+CREATE ROLE <roleName>;
+Eg: IoTDB > CREATE ROLE `admin`;
+```
+
+* 删除角色
+
+```
+DROP ROLE <roleName>;
+Eg: IoTDB > DROP ROLE `admin`;
+```
+
+* 赋予用户权限
+
+```
+GRANT USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES on root.ln.**, root.sgcc.**;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES CREATE_ROLE;
+```
+
+- 赋予用户全部的权限
+
+```
+GRANT USER <userName> PRIVILEGES ALL;
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES ALL;
+```
+
+* 赋予角色权限
+
+```
+GRANT ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES ON root.sgcc.**, root.ln.**;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES CREATE_ROLE;
+```
+
+- 赋予角色全部的权限
+
+```
+GRANT ROLE <roleName> PRIVILEGES ALL;
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES ALL;
+```
+
+* 赋予用户角色
+
+```
+GRANT <roleName> TO <userName>;
+Eg: IoTDB > GRANT `temprole` TO tempuser;
+```
+
+* 撤销用户权限
+
+```
+REVOKE USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES DELETE_TIMESERIES on root.ln.**;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES CREATE_ROLE;
+```
+
+- 移除用户所有权限
+
+```
+REVOKE USER <userName> PRIVILEGES ALL;
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES ALL;
+```
+
+* 撤销角色权限
+
+```
+REVOKE ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES DELETE_TIMESERIES ON root.ln.**;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES CREATE_ROLE;
+```
+
+- 撤销角色全部的权限
+
+```
+REVOKE ROLE <roleName> PRIVILEGES ALL;
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES ALL;
+```
+
+* 撤销用户角色
+
+```
+REVOKE <roleName> FROM <userName>;
+Eg: IoTDB > REVOKE `temprole` FROM tempuser;
+```
+
+* 列出所有用户
+
+```
+LIST USER
+Eg: IoTDB > LIST USER
+```
+
+* 列出指定角色下所有用户
+
+```
+LIST USER OF ROLE <roleName>;
+Eg: IoTDB > LIST USER OF ROLE `roleuser`;
+```
+
+* 列出所有角色
+
+```
+LIST ROLE
+Eg: IoTDB > LIST ROLE
+```
+
+* 列出指定用户下所有角色
+
+```
+LIST ROLE OF USER <username> ;
+Eg: IoTDB > LIST ROLE OF USER `tempuser`;
+```
+
+* 列出用户所有权限
+
+```
+LIST PRIVILEGES USER <username>;
+Eg: IoTDB > LIST PRIVILEGES USER `tempuser`;
+```
+
+* 列出用户在具体路径上相关联的权限
+
+```
+LIST PRIVILEGES USER <username> ON <paths>;
+Eg: IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.**, root.ln.wf01.**;
++--------+-----------------------------------+
+| role| privilege|
++--------+-----------------------------------+
+| | root.ln.** : ALTER_TIMESERIES|
+|temprole|root.ln.wf01.** : CREATE_TIMESERIES|
++--------+-----------------------------------+
+Total line number = 2
+It costs 0.005s
+IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.wf01.wt01.**;
++--------+-----------------------------------+
+| role| privilege|
++--------+-----------------------------------+
+| | root.ln.** : ALTER_TIMESERIES|
+|temprole|root.ln.wf01.** : CREATE_TIMESERIES|
++--------+-----------------------------------+
+Total line number = 2
+It costs 0.005s
+```
+
+* 列出角色所有权限
+
+```
+LIST PRIVILEGES ROLE <roleName>;
+Eg: IoTDB > LIST PRIVILEGES ROLE `actor`;
+```
+
+* 列出角色在具体路径上相关联的权限
+
+```
+LIST PRIVILEGES ROLE <roleName> ON <paths>;
+Eg: IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.**, root.ln.wf01.wt01.**;
++-----------------------------------+
+| privilege|
++-----------------------------------+
+|root.ln.wf01.** : CREATE_TIMESERIES|
++-----------------------------------+
+Total line number = 1
+It costs 0.005s
+IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.wf01.wt01.**;
++-----------------------------------+
+| privilege|
++-----------------------------------+
+|root.ln.wf01.** : CREATE_TIMESERIES|
++-----------------------------------+
+Total line number = 1
+It costs 0.005s
+```
+
+* 更新密码
+
+```
+ALTER USER <username> SET PASSWORD <password>;
+Eg: IoTDB > ALTER USER `tempuser` SET PASSWORD 'newpwd';
+```
+
+
+### 其他说明
+
+#### 用户、权限与角色的关系
+
+角色是权限的集合,而权限和角色都是用户的一种属性。即一个角色可以拥有若干权限。一个用户可以拥有若干角色与权限(称为用户自身权限)。
+
+目前在 IoTDB 中并不存在相互冲突的权限,因此一个用户真正具有的权限是用户自身权限与其所有的角色的权限的并集。即要判定用户是否能执行某一项操作,就要看用户自身权限或用户的角色的所有权限中是否有一条允许了该操作。用户自身权限与其角色权限,他的多个角色的权限之间可能存在相同的权限,但这并不会产生影响。
+
+需要注意的是:如果一个用户自身有某种权限(对应操作 A),而他的某个角色有相同的权限。那么如果仅从该用户撤销该权限无法达到禁止该用户执行操作 A 的目的,还需要从这个角色中也撤销对应的权限,或者从这个用户将该角色撤销。同样,如果仅从上述角色将权限撤销,也不能禁止该用户执行操作 A。
+
+同时,对角色的修改会立即反映到所有拥有该角色的用户上,例如对角色增加某种权限将立即使所有拥有该角色的用户都拥有对应权限,删除某种权限也将使对应用户失去该权限(除非用户本身有该权限)。
+
+#### 系统所含权限列表
+
+| 权限名称 | 说明 | 示例 |
+| :------------------------ | :----------------------------------------------------------- | ------------------------------------------------------------ |
+| CREATE\_DATABASE | 创建 database。包含设置 database 的权限和TTL。路径相关 | Eg1: `CREATE DATABASE root.ln;`<br />Eg2:`set ttl to root.ln 3600000;`<br />Eg3:`unset ttl to root.ln;` |
+| DELETE\_DATABASE | 删除 database。路径相关 | Eg: `delete database root.ln;` |
+| CREATE\_TIMESERIES | 创建时间序列。路径相关 | Eg1: 创建时间序列<br />`create timeseries root.ln.wf02.status with datatype=BOOLEAN,encoding=PLAIN;`<br />Eg2: 创建对齐时间序列<br />`create aligned timeseries root.ln.device1(latitude FLOAT encoding=PLAIN compressor=SNAPPY, longitude FLOAT encoding=PLAIN compressor=SNAPPY);` |
+| INSERT\_TIMESERIES | 插入数据。路径相关 | Eg1: `insert into root.ln.wf02(timestamp,status) values(1,true);`<br />Eg2: `insert into root.sg1.d1(time, s1, s2) aligned values(1, 1, 1)` |
+| ALTER\_TIMESERIES | 修改时间序列标签。路径相关 | Eg1: `alter timeseries root.turbine.d1.s1 ADD TAGS tag3=v3, tag4=v4;`<br />Eg2: `ALTER timeseries root.turbine.d1.s1 UPSERT ALIAS=newAlias TAGS(tag2=newV2, tag3=v3) ATTRIBUTES(attr3=v3, attr4=v4);` |
+| READ\_TIMESERIES | 查询数据。路径相关 | Eg1: `SHOW DATABASES;` <br />Eg2: `show child paths root.ln, show child nodes root.ln;`<br />Eg3: `show devices;`<br />Eg4: `show timeseries root.**;`<br />Eg5: `show schema templates;`<br />Eg6: `show all ttl`<br />Eg7: [数据查询](../Query-Data/Overview.md)(这一节之下的查询语句均使用该权限)<br />Eg8: CVS格式数据导出<br />`./export-csv.bat -h 127.0.0.1 -p 6667 -u tempuser -pw root -td ./`<br />Eg9: 查询性能追踪<br />`tracing select * fr [...]
+| DELETE\_TIMESERIES | 删除数据或时间序列。路径相关 | Eg1: 删除时间序列<br />`delete timeseries root.ln.wf01.wt01.status`<br />Eg2: 删除数据<br />`delete from root.ln.wf02.wt02.status where time < 10`<br />Eg3: 使用DROP关键字<br />`drop timeseries root.ln.wf01.wt01.status` |
+| CREATE\_USER | 创建用户。路径无关 | Eg: `create user thulab 'passwd';` |
+| DELETE\_USER | 删除用户。路径无关 | Eg: `drop user xiaoming;` |
+| MODIFY\_PASSWORD | 修改所有用户的密码。路径无关。(没有该权限者仍然能够修改自己的密码。) | Eg: `alter user tempuser SET PASSWORD 'newpwd';` |
+| LIST\_USER | 列出所有用户,列出具有某角色的所有用户,列出用户在指定路径下相关权限。路径无关 | Eg1: `list user;`<br />Eg2: `list user of role 'wirte_role';`<br />Eg3: `list privileges user admin;`<br />Eg4: `list privileges user 'admin' on root.sgcc.**;` |
+| GRANT\_USER\_PRIVILEGE | 赋予用户权限。路径无关 | Eg: `grant user tempuser privileges DELETE_TIMESERIES on root.ln.**;` |
+| REVOKE\_USER\_PRIVILEGE | 撤销用户权限。路径无关 | Eg: `revoke user tempuser privileges DELETE_TIMESERIES on root.ln.**;` |
+| GRANT\_USER\_ROLE | 赋予用户角色。路径无关 | Eg: `grant temprole to tempuser;` |
+| REVOKE\_USER\_ROLE | 撤销用户角色。路径无关 | Eg: `revoke temprole from tempuser;` |
+| CREATE\_ROLE | 创建角色。路径无关 | Eg: `create role admin;` |
+| DELETE\_ROLE | 删除角色。路径无关 | Eg: `drop role admin;` |
+| LIST\_ROLE | 列出所有角色,列出某用户下所有角色,列出角色在指定路径下相关权限。路径无关 | Eg1: `list role`<br />Eg2: `list role of user 'actor';`<br />Eg3: `list privileges role wirte_role;`<br />Eg4: `list privileges role wirte_role ON root.sgcc;` |
+| GRANT\_ROLE\_PRIVILEGE | 赋予角色权限。路径无关 | Eg: `grant role temprole privileges DELETE_TIMESERIES ON root.ln.**;` |
+| REVOKE\_ROLE\_PRIVILEGE | 撤销角色权限。路径无关 | Eg: `revoke role temprole privileges DELETE_TIMESERIES ON root.ln.**;` |
+| CREATE_FUNCTION | 注册 UDF。路径无关 | Eg: `create function example AS 'org.apache.iotdb.udf.UDTFExample';` |
+| DROP_FUNCTION | 卸载 UDF。路径无关 | Eg: `drop function example` |
+| CREATE_TRIGGER | 创建触发器。路径相关 | Eg1: `CREATE TRIGGER <TRIGGER-NAME> BEFORE INSERT ON <FULL-PATH> AS <CLASSNAME>`<br />Eg2: `CREATE TRIGGER <TRIGGER-NAME> AFTER INSERT ON <FULL-PATH> AS <CLASSNAME>` |
+| DROP_TRIGGER | 卸载触发器。路径相关 | Eg: `drop trigger 'alert-listener-sg1d1s1'` |
+| CREATE_CONTINUOUS_QUERY | 创建连续查询。路径无关 | Eg: `CREATE CONTINUOUS QUERY cq1 RESAMPLE RANGE 40s BEGIN <QUERY-BODY> END` |
+| DROP_CONTINUOUS_QUERY | 卸载连续查询。路径无关 | Eg1: `DROP CONTINUOUS QUERY cq3`<br />Eg2: `DROP CQ cq3` |
+| SHOW_CONTINUOUS_QUERIES | 展示所有连续查询。路径无关 | Eg1: `SHOW CONTINUOUS QUERIES`<br />Eg2: `SHOW cqs` |
+| UPDATE_TEMPLATE | 创建、删除模板。路径无关。 | Eg1: `create schema template t1(s1 int32)`<br />Eg2: `drop schema template t1` |
+| READ_TEMPLATE | 查看所有模板、模板内容。 路径无关 | Eg1: `show schema templates`<br/>Eg2: `show nodes in template t1` |
+| APPLY_TEMPLATE | 挂载、卸载、激活、解除模板。路径有关。 | Eg1: `set schema template t1 to root.sg.d`<br/>Eg2: `unset schema template t1 from root.sg.d`<br/>Eg3: `create timeseries of schema template on root.sg.d`<br/>Eg4: `delete timeseries of schema template on root.sg.d` |
+| READ_TEMPLATE_APPLICATION | 查看模板的挂载路径和激活路径。路径无关 | Eg1: `show paths set schema template t1`<br/>Eg2: `show paths using schema template t1` |
+
+注意: 路径无关的权限只能在路径root.**下赋予或撤销;
+
+注意: 下述sql语句需要赋予多个权限才可以使用:
+
+- 导入数据,需要赋予`READ_TIMESERIES`,`INSERT_TIMESERIES`两种权限。
+
+```
+Eg: IoTDB > ./import-csv.bat -h 127.0.0.1 -p 6667 -u renyuhua -pw root -f dump0.csv
+```
+
+- 查询写回(SELECT_INTO)
+ - 需要所有 `select` 子句中源序列的 `READ_TIMESERIES` 权限
+ - 需要所有 `into` 子句中目标序列 `INSERT_TIMESERIES` 权限
+
+
+```
+Eg: IoTDB > select s1, s1 into t1, t2 from root.sg.d1 limit 5 offset 1000
+```
+
+#### 用户名限制
+
+IoTDB 规定用户名的字符长度不小于 4,其中用户名不能包含空格。
+
+#### 密码限制
+
+IoTDB 规定密码的字符长度不小于 4,其中密码不能包含空格,密码默认采用 MD5 进行加密。
+
+#### 角色名限制
+
+IoTDB 规定角色名的字符长度不小于 4,其中角色名不能包含空格。
+
+#### 权限管理中的路径模式
+
+一个路径模式的结果集包含了它的子模式的结果集的所有元素。例如,`root.sg.d.*`是`root.sg.*.*`的子模式,而`root.sg.**`不是`root.sg.*.*`的子模式。当用户被授予对某个路径模式的权限时,在他的DDL或DML中使用的模式必须是该路径模式的子模式,这保证了用户访问时间序列时不会超出他的权限范围。
+
+#### 权限缓存
+
+在分布式相关的权限操作中,在进行除了创建用户和角色之外的其他权限更改操作时,都会先清除与该用户(角色)相关的所有的`dataNode`的缓存信息,如果任何一台`dataNode`缓存信息清楚失败,这个权限更改的任务就会失败。
+
+#### 非root用户限制进行的操作
+
+目前以下IoTDB支持的sql语句只有`root`用户可以进行操作,且没有对应的权限可以赋予新用户。
+
+##### TsFile管理
+
+- 加载TsFile
+
+```
+Eg: IoTDB > load '/Users/Desktop/data/1575028885956-101-0.tsfile'
+```
+
+- 删除TsFile文件
+
+```
+Eg: IoTDB > remove '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile'
+```
+
+- 卸载TsFile文件到指定目录
+
+```
+Eg: IoTDB > unload '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile' '/data/data/tmp'
+```
+
+##### 删除时间分区(实验性功能)
+
+- 删除时间分区(实验性功能)
+
+```
+Eg: IoTDB > DELETE PARTITION root.ln 0,1,2
+```
+
+##### 连续查询
+
+- 连续查询(CQ)
+
+```
+Eg: IoTDB > CREATE CONTINUOUS QUERY cq1 BEGIN SELECT max_value(temperature) INTO temperature_max FROM root.ln.*.* GROUP BY time(10s) END
+```
+
+##### 运维命令
+
+- FLUSH
+
+```
+Eg: IoTDB > flush
+```
+
+- MERGE
+
+```
+Eg: IoTDB > MERGE
+Eg: IoTDB > FULL MERGE
+```
+
+- CLEAR CACHE
+
+```sql
+Eg: IoTDB > CLEAR CACHE
+```
+
+- SET STSTEM TO READONLY / WRITABLE
+
+```
+Eg: IoTDB > SET STSTEM TO READONLY / WRITABLE
+```
+
+- SCHEMA SNAPSHOT
+
+```sql
+Eg: IoTDB > CREATE SNAPSHOT FOR SCHEMA
+```
+
+- 查询终止
+
+```
+Eg: IoTDB > KILL QUERY 1
+```
+
+##### 水印工具
+
+- 为新用户施加水印
+
+```
+Eg: IoTDB > grant watermark_embedding to Alice
+```
+
+- 撤销水印
+
+```
+Eg: IoTDB > revoke watermark_embedding from Alice
+```
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Ecosystem-Integration/Grafana-Plugin.md b/docs/zh/UserGuide/Ecosystem-Integration/Grafana-Plugin.md
index 8dfae9da80c..e2e192f738a 100644
--- a/docs/zh/UserGuide/Ecosystem-Integration/Grafana-Plugin.md
+++ b/docs/zh/UserGuide/Ecosystem-Integration/Grafana-Plugin.md
@@ -236,7 +236,7 @@ FROM 输入框中的内容必须是时间序列的前缀路径,比如 `root.sg
WHERE 输入框为非必须填写项目,填写内容应当是查询的过滤条件,比如 `time > 0` 或者 `s1 < 1024 and s2 > 1024`。
-CONTROL 输入框为非必须填写项目,填写内容应当是控制查询类型、输出格式的特殊子句。其中GROUP BY 输入框支持使用grafana的全局变量来获取当前时间区间变化$__from(起始时间)、$__to(结束时间),下面是 CONTROL 输入框中一些合法的输入举例:
+CONTROL 输入框为非必须填写项目,填写内容应当是控制查询类型、输出格式的特殊子句。其中GROUP BY 输入框支持使用grafana的全局变量来获取当前时间区间变化`$__from`(起始时间)、`$__to`(结束时间),下面是 CONTROL 输入框中一些合法的输入举例:
* `GROUP BY ([$__from, $__to), 1d)`
* `GROUP BY ([$__from, $__to),3h,1d)`
diff --git a/docs/zh/UserGuide/Ecosystem-Integration/NiFi-IoTDB.md b/docs/zh/UserGuide/Ecosystem-Integration/NiFi-IoTDB.md
index 35188ec6623..8cfab5a19cf 100644
--- a/docs/zh/UserGuide/Ecosystem-Integration/NiFi-IoTDB.md
+++ b/docs/zh/UserGuide/Ecosystem-Integration/NiFi-IoTDB.md
@@ -7,9 +7,9 @@
to you under the Apache License, Version 2.0 (the
"License"); you may not use this file except in compliance
with the License. You may obtain a copy of the License at
-
+
http://www.apache.org/licenses/LICENSE-2.0
-
+
Unless required by applicable law or agreed to in writing,
software distributed under the License is distributed on an
"AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
@@ -105,7 +105,7 @@ Apache NiFi 包含以下功能:
3. `tsName` 和 `dataType` 这两项必须被设置。
4. 当数据插入IoTDB时,Prefix属性会被添加到 tsName以作为插入的字段名。
5. 支持的 `dataTypes` 有:`INT32`, `INT64`, `FLOAT`, `DOUBLE`, `BOOLEAN`, `TEXT`。
-6. 支持的 `encoding` 有: `PLAIN`, `DICTIONARY`, `RLE`, `DIFF`, `TS_2DIFF`, `BITMAP`, `GORILLA_V1`, `REGULAR`, `GORILLA`, `CHIMP`, `SPRINTZ`, `RLBE`。
+6. 支持的 `encoding` 有: `PLAIN`, `DICTIONARY`, `RLE`, `DIFF`, `TS_2DIFF`, `BITMAP`, `GORILLA_V1`, `REGULAR`, `GORILLA`,`ZIGZAG`,`CHIMP`, `SPRINTZ`, `RLBE`。
7. 支持的 `compressionType` 有: `UNCOMPRESSED`, `SNAPPY`, `GZIP`, `LZO`, `SDT`, `PAA`, `PLA`, `LZ4`, `ZSTD`, `LZMA2`。
### Relationships
diff --git a/docs/zh/UserGuide/Edge-Cloud-Collaboration/Sync-Tool.md b/docs/zh/UserGuide/Edge-Cloud-Collaboration/Sync-Tool.md
new file mode 100644
index 00000000000..78ea9adbd69
--- /dev/null
+++ b/docs/zh/UserGuide/Edge-Cloud-Collaboration/Sync-Tool.md
@@ -0,0 +1,362 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# TsFile 同步
+
+## 1.介绍
+
+同步工具是持续将边缘端(发送端) IoTDB 中的时间序列数据上传并加载至云端(接收端) IoTDB 的套件工具。
+
+IoTDB 同步工具内嵌于 IoTDB 引擎,与下游接收端相连,下游支持 IoTDB(单机/集群)。
+
+可以在发送端使用 SQL 命令来启动或者关闭一个同步任务,并且可以随时查看同步任务的状态。在接收端,您可以通过设置 IP 白名单来规定准入 IP 地址范围。
+
+## 2.模型定义
+
+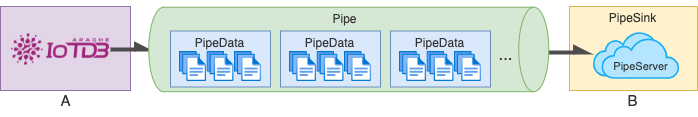
+
+TsFile 同步工具实现了数据从 "流入-> IoTDB ->流出" 的闭环。假设目前有两台机器A和B都安装了IoTDB,希望将 A 上的数据不断同步至 B 中。为了更好地描述这个过程,我们引入以下概念。
+
+- Pipe
+ - 指一次同步任务,在上述案例中,我们可以看作在 A 和 B 之间有一根数据流管道连接了 A 和 B。
+ - 一个正常运行的 Pipe 有两种状态:RUNNING 表示正在向接收端同步数据,STOP 表示暂停向接收端同步数据。
+- PipeSink
+ - 指接收端,在上述案例中,PipeSink 即是 B 这台机器。PipeSink 的类型目前仅支持 IoTDB,即接收端为 B 上安装的 IoTDB 实例。
+
+## 3.注意事项
+
+- 同步工具的发送端目前仅支持 IoTDB 1.0 版本**单数据副本配置**,接收端支持 IoTDB 1.0 版本任意配置。
+- 当有一个或多个发送端指向一个接收端时,这些发送端和接收端各自的设备路径集合之间应当没有交集,否则可能产生不可预料错误
+ - 例如:当发送端A包括路径`root.sg.d.s`,发送端B也包括路径`root.sg.d.s`,当发送端A删除`root.sg` database 时将也会在接收端删除所有B在接收端的`root.sg.d.s`中存放的数据。
+- 两个“端”之间目前不支持相互同步。
+- 同步工具仅同步数据写入,若接收端未创建 database,自动创建与发送端同级 database。当前版本删除操作不保证被同步,不支持 TTL 的设置、Trigger、CQ 等其他操作的同步。
+ - 若在发送端设置了 TTL,则启动 Pipe 时候 IoTDB 中所有未过期的数据以及未来所有的数据写入和删除都会被同步至接收端
+- 对同步任务进行操作时,需保证 `SHOW DATANODES` 中所有处于 Running 状态的 DataNode 节点均可连通,否则将执行失败。
+
+## 4.快速上手
+
+在发送端和接收端执行如下语句即可快速开始两个 IoTDB 之间的数据同步,完整的 SQL 语句和配置事项请查看`配置参数`和`SQL`两节,更多使用范例请参考`使用范例`节。
+
+- 启动发送端 IoTDB 与接收端 IoTDB
+- 创建接收端为 IoTDB 类型的 Pipe Sink
+
+```
+IoTDB> CREATE PIPESINK my_iotdb AS IoTDB (ip='接收端IP', port='接收端端口')
+```
+
+- 创建同步任务Pipe(请确保接收端 IoTDB 已经启动)
+
+```
+IoTDB> CREATE PIPE my_pipe TO my_iotdb
+```
+
+- 开始同步任务
+
+```
+IoTDB> START PIPE my_pipe
+```
+
+- 显示所有同步任务状态
+
+```
+IoTDB> SHOW PIPES
+```
+
+- 暂停任务
+
+```
+IoTDB> STOP PIPE my_pipe
+```
+
+- 继续被暂停的任务
+
+```
+IoTDB> START PIPE my_pipe
+```
+
+- 关闭任务(状态信息将被删除)
+
+```
+IoTDB> DROP PIPE my_pipe
+```
+
+## 5.配置参数
+
+所有参数修改均在`$IOTDB_HOME$/conf/iotdb-common.properties`中,所有修改完成之后执行`load configuration`之后即可立刻生效。
+
+### 5.1发送端相关
+
+| **参数名** | **max_number_of_sync_file_retry** |
+| ---------- | ------------------------------------------ |
+| 描述 | 发送端同步文件到接收端失败时的最大重试次数 |
+| 类型 | Int : [0,2147483647] |
+| 默认值 | 5 |
+
+### 5.2接收端相关
+
+| **参数名** | **ip_white_list** |
+| ---------- | ------------------------------------------------------------ |
+| 描述 | 设置同步功能发送端 IP 地址的白名单,以网段的形式表示,多个网段之间用逗号分隔。发送端向接收端同步数据时,只有当该发送端 IP 地址处于该白名单设置的网段范围内,接收端才允许同步操作。如果白名单为空,则接收端不允许任何发送端同步数据。默认接收端拒绝除了本地以外的全部 IP 的同步请求。 对该参数进行配置时,需要保证发送端所有 DataNode 地址均被覆盖。 |
+| 类型 | String |
+| 默认值 | 127.0.0.1/32 |
+
+## 6.SQL
+
+### SHOW PIPESINKTYPE
+
+- 显示当前所能支持的 PipeSink 类型。
+
+```Plain%20Text
+IoTDB> SHOW PIPESINKTYPE
+IoTDB>
++-----+
+| type|
++-----+
+|IoTDB|
++-----+
+```
+
+### CREATE PIPESINK
+
+- 创建接收端为 IoTDB 类型的 PipeSink,其中IP和port是可选参数。当接收端为集群时,填写任意一个 DataNode 的 `rpc_address` 与 `rpc_port`。
+
+```
+IoTDB> CREATE PIPESINK <PipeSinkName> AS IoTDB [(ip='127.0.0.1',port=6667);]
+```
+
+### DROP PIPESINK
+
+- 删除 PipeSink。当 PipeSink 正在被同步任务使用时,无法删除 PipeSink。
+
+```
+IoTDB> DROP PIPESINK <PipeSinkName>
+```
+
+### SHOW PIPESINK
+
+- 显示当前所有 PipeSink 定义,结果集有三列,分别表示 PipeSink 的名字,PipeSink 的类型,PipeSink 的属性。
+
+```
+IoTDB> SHOW PIPESINKS
+IoTDB> SHOW PIPESINK [PipeSinkName]
+IoTDB>
++-----------+-----+------------------------+
+| name| type| attributes|
++-----------+-----+------------------------+
+|my_pipesink|IoTDB|ip='127.0.0.1',port=6667|
++-----------+-----+------------------------+
+```
+
+### CREATE PIPE
+
+- 创建同步任务
+ - 其中 select 语句目前仅支持`**`(即所有序列中的数据),from 语句目前仅支持`root`,where语句仅支持指定 time 的起始时间。起始时间的指定形式可以是 yyyy-mm-dd HH:MM:SS或时间戳。
+
+```Plain%20Text
+IoTDB> CREATE PIPE my_pipe TO my_iotdb [FROM (select ** from root WHERE time>=yyyy-mm-dd HH:MM:SS)]
+```
+
+### STOP PIPE
+
+- 暂停任务
+
+```
+IoTDB> STOP PIPE <PipeName>
+```
+
+### START PIPE
+
+- 开始任务
+
+```
+IoTDB> START PIPE <PipeName>
+```
+
+### DROP PIPE
+
+- 关闭任务(状态信息可被删除)
+
+```
+IoTDB> DROP PIPE <PipeName>
+```
+
+### SHOW PIPE
+
+> 该指令在发送端和接收端均可执行
+
+- 显示所有同步任务状态
+
+ - `create time`:Pipe 的创建时间
+
+ - `name`:Pipe 的名字
+
+ - `role`:当前 IoTDB 在 Pipe 中的角色,可能有两种角色:
+ - sender,当前 IoTDB 为同步发送端
+ - receiver,当前 IoTDB 为同步接收端
+
+ - `remote`:Pipe的对端信息
+ - 当 role 为 sender 时,这一字段值为 PipeSink 名称
+ - 当 role 为 receiver 时,这一字段值为发送端 IP
+
+ - `status`:Pipe状态
+
+ - `attributes`:Pipe属性
+ - 当 role 为 sender 时,这一字段值为 Pipe 的同步起始时间和是否同步删除操作
+ - 当 role 为 receiver 时,这一字段值为当前 DataNode 上创建的同步连接对应的存储组名称
+
+ - `message`:Pipe运行信息,当 Pipe 正常运行时,这一字段通常为NORMAL,当出现异常时,可能出现两种状态:
+ - WARN 状态,这表明发生了数据丢失或者其他错误,但是 Pipe 会保持运行
+ - ERROR 状态,这表明出现了网络连接正常但数据无法传输的问题,例如发送端 IP 不在接收端白名单中,或是发送端与接收端版本不兼容
+ - 当出现 ERROR 状态时,建议 STOP PIPE 后查看 DataNode 日志,检查接收端配置或网络情况后重新 START PIPE
+
+```Plain%20Text
+IoTDB> SHOW PIPES
+IoTDB>
++-----------------------+--------+--------+-------------+---------+------------------------------------+-------+
+| create time| name | role| remote| status| attributes|message|
++-----------------------+--------+--------+-------------+---------+------------------------------------+-------+
+|2022-03-30T20:58:30.689|my_pipe1| sender| my_pipesink| STOP|SyncDelOp=false,DataStartTimestamp=0| NORMAL|
++-----------------------+--------+--------+-------------+---------+------------------------------------+-------+
+|2022-03-31T12:55:28.129|my_pipe2|receiver|192.168.11.11| RUNNING| Database='root.vehicle'| NORMAL|
++-----------------------+--------+--------+-------------+---------+------------------------------------+-------+
+```
+
+- 显示指定同步任务状态,当未指定PipeName时,与`SHOW PIPES`等效
+
+```
+IoTDB> SHOW PIPE [PipeName]
+```
+
+## 7.使用示例
+
+### 目标
+
+- 创建一个从边端 IoTDB 到 云端 IoTDB 的 同步工作
+- 边端希望同步从2022年3月30日0时之后的数据
+- 边端不希望同步所有的删除操作
+- 云端 IoTDB 仅接受来自边端的 IoTDB 的数据
+
+### 接收端操作
+
+`vi conf/iotdb-common.properties` 配置云端参数,将白名单设置为仅接收来自 IP 为 192.168.0.1 的边端的数据
+
+```
+####################
+### PIPE Server Configuration
+####################
+# White IP list of Sync client.
+# Please use the form of network segment to present the range of IP, for example: 192.168.0.0/16
+# If there are more than one IP segment, please separate them by commas
+# The default is to allow all IP to sync
+# Datatype: String
+ip_white_list=192.168.0.1/32
+```
+
+### 发送端操作
+
+创建云端 PipeSink,指定类型为 IoTDB,指定云端 IP 地址为 192.168.0.1,指定云端的 PipeServer 服务端口为6667
+
+```
+IoTDB> CREATE PIPESINK my_iotdb AS IoTDB (ip='192.168.0.1',port=6667)
+```
+
+创建Pipe,指定连接到my_iotdb的PipeSink,在WHREE子句中输入开始时间点2022年3月30日0时。以下两条执行语句等价。
+
+```
+IoTDB> CREATE PIPE p TO my_iotdb FROM (select ** from root where time>=2022-03-30 00:00:00)
+IoTDB> CREATE PIPE p TO my_iotdb FROM (select ** from root where time>= 1648569600000)
+```
+
+启动Pipe
+
+```Plain%20Text
+IoTDB> START PIPE p
+```
+
+显示同步任务状态
+
+```
+IoTDB> SHOW PIPE p
+```
+
+### 结果验证
+
+在发送端执行以下 SQL
+
+```SQL
+CREATE DATABASE root.vehicle;
+CREATE TIMESERIES root.vehicle.d0.s0 WITH DATATYPE=INT32, ENCODING=RLE;
+CREATE TIMESERIES root.vehicle.d0.s1 WITH DATATYPE=TEXT, ENCODING=PLAIN;
+CREATE TIMESERIES root.vehicle.d1.s2 WITH DATATYPE=FLOAT, ENCODING=RLE;
+CREATE TIMESERIES root.vehicle.d1.s3 WITH DATATYPE=BOOLEAN, ENCODING=PLAIN;
+insert into root.vehicle.d0(timestamp,s0) values(now(),10);
+insert into root.vehicle.d0(timestamp,s0,s1) values(now(),12,'12');
+insert into root.vehicle.d0(timestamp,s1) values(now(),'14');
+insert into root.vehicle.d1(timestamp,s2) values(now(),16.0);
+insert into root.vehicle.d1(timestamp,s2,s3) values(now(),18.0,true);
+insert into root.vehicle.d1(timestamp,s3) values(now(),false);
+flush;
+```
+
+在发送端和接受端执行查询,可查询到相同的结果
+
+```Plain%20Text
+IoTDB> select ** from root.vehicle
++-----------------------------+------------------+------------------+------------------+------------------+
+| Time|root.vehicle.d0.s0|root.vehicle.d0.s1|root.vehicle.d1.s3|root.vehicle.d1.s2|
++-----------------------------+------------------+------------------+------------------+------------------+
+|2022-04-03T20:08:17.127+08:00| 10| null| null| null|
+|2022-04-03T20:08:17.358+08:00| 12| 12| null| null|
+|2022-04-03T20:08:17.393+08:00| null| 14| null| null|
+|2022-04-03T20:08:17.538+08:00| null| null| null| 16.0|
+|2022-04-03T20:08:17.753+08:00| null| null| true| 18.0|
+|2022-04-03T20:08:18.263+08:00| null| null| false| null|
++-----------------------------+------------------+------------------+------------------+------------------+
+Total line number = 6
+It costs 0.134s
+```
+
+## 8.常见问题
+
+- 执行 `CREATE PIPESINK demo as IoTDB` 提示 `PIPESINK [demo] already exists in IoTDB.`
+ - 原因:当前 PipeSink 已存在
+ - 解决方案:删除 PipeSink 后重新创建
+- 执行 `DROP PIPESINK pipesinkName` 提示 `Can not drop PIPESINK [demo], because PIPE [mypipe] is using it.`
+ - 原因:不允许删除有正在运行的PIPE所使用的 PipeSink
+ - 解决方案:在发送端执行 `SHOW PIPE`,停止使用该 PipeSink 的 PIPE
+- 执行 `CREATE PIPE p to demo` 提示 `PIPE [p] is STOP, please retry after drop it.`
+ - 原因:当前 Pipe 已存在
+ - 解决方案:删除 Pipe 后重新创建
+- 执行 `CREATE PIPE p to demo`提示 `Fail to create PIPE [p] because Connection refused on DataNode: {id=2, internalEndPoint=TEndPoint(ip:127.0.0.1, port:10732)}.`
+ - 原因:存在状态为 Running 的 DataNode 无法连通
+ - 解决方案:执行 `SHOW DATANODES` 语句,检查无法连通的 DataNode 网络,或等待其状态变为 Unknown 后重新执行语句。
+- 执行 `START PIPE p` 提示 `Fail to start PIPE [p] because Connection refused on DataNode: {id=2, internalEndPoint=TEndPoint(ip:127.0.0.1, port:10732)}.`
+ - 原因:存在状态为 Running 的 DataNode 无法连通
+ - 解决方案:执行 `SHOW DATANODES` 语句,检查无法连通的 DataNode 网络,或等待其状态变为 Unknown 后重新执行语句。
+- 执行 `STOP PIPE p` 提示 `Fail to stop PIPE [p] because Connection refused on DataNode: {id=2, internalEndPoint=TEndPoint(ip:127.0.0.1, port:10732)}.`
+ - 原因:存在状态为 Running 的 DataNode 无法连通
+ - 解决方案:执行 `SHOW DATANODES` 语句,检查无法连通的 DataNode 网络,或等待其状态变为 Unknown 后重新执行语句。
+- 执行 `DROP PIPE p` 提示 `Fail to DROP_PIPE because Fail to drop PIPE [p] because Connection refused on DataNode: {id=2, internalEndPoint=TEndPoint(ip:127.0.0.1, port:10732)}. Please execute [DROP PIPE p] later to retry.`
+ - 原因:存在状态为 Running 的 DataNode 无法连通,Pipe 已在部分节点上被删除,状态被置为 ***DROP***。
+ - 解决方案:执行 `SHOW DATANODES` 语句,检查无法连通的 DataNode 网络,或等待其状态变为 Unknown 后重新执行语句。
+- 运行时日志提示 `org.apache.iotdb.commons.exception.IoTDBException: root.** already been created as database`
+ - 原因:同步工具试图在接收端自动创建发送端的Database,属于正常现象
+ - 解决方案:无需干预
diff --git a/docs/zh/UserGuide/FAQ/Frequently-asked-questions.md b/docs/zh/UserGuide/FAQ/Frequently-asked-questions.md
index 4c503e89955..2721370fed7 100644
--- a/docs/zh/UserGuide/FAQ/Frequently-asked-questions.md
+++ b/docs/zh/UserGuide/FAQ/Frequently-asked-questions.md
@@ -23,7 +23,9 @@
# 常见问题
-**如何查询我的 IoTDB 版本**
+## 常见问题
+
+### 如何查询我的IoTDB版本?
有几种方法可以识别您使用的 IoTDB 版本:
@@ -65,7 +67,7 @@ Total line number = 1
It costs 0.241s
```
-**在哪里可以找到 IoTDB 的日志**
+### 在哪里可以找到IoTDB的日志?
假设您的根目录是:
@@ -87,11 +89,11 @@ Readme.md
在默认的设置里,logs 文件夹会被存储在```IOTDB_HOME/logs```。您可以在```IOTDB_HOME/conf```目录下的```logback.xml```文件中修改日志的级别和日志的存储路径。
-**在哪里可以找到 IoTDB 的数据文件**
+### 在哪里可以找到IoTDB的数据文件?
在默认的设置里,数据文件(包含 TsFile,metadata,WAL)被存储在```IOTDB_HOME/data/datanode```文件夹。
-**如何知道 IoTDB 中存储了多少时间序列**
+### 如何知道IoTDB中存储了多少时间序列?
使用 IoTDB 的命令行接口:
@@ -114,15 +116,15 @@ IoTDB> count timeseries root
> 6
```
-**可以使用 Hadoop 和 Spark 读取 IoTDB 中的 TsFile 吗?**
+### 可以使用Hadoop和Spark读取IoTDB中的TsFile吗?
是的。IoTDB 与开源生态紧密结合。IoTDB 支持 [Hadoop](https://github.com/apache/iotdb/tree/master/hadoop), [Spark](https://github.com/apache/iotdb/tree/master/spark-tsfile) 和 [Grafana](https://github.com/apache/iotdb/tree/master/grafana) 可视化工具。
-**IoTDB 如何处理重复的数据点**
+### IoTDB如何处理重复的数据点?
一个数据点是由一个完整的时间序列路径(例如:```root.vehicle.d0.s0```) 和时间戳唯一标识的。如果您使用与现有点相同的路径和时间戳提交一个新点,那么 IoTDB 将更新这个点的值,而不是插入一个新点。
-**我如何知道具体的 timeseries 的类型**
+### 我如何知道具体的timeseries的类型?
在 IoTDB 的命令行接口中使用 SQL ```SHOW TIMESERIES <timeseries path>```:
@@ -144,7 +146,7 @@ IoTDB> show timeseries root.fit.d1.s1
IoTDB> show timeseries root.fit.d1.*
```
-**如何更改 IoTDB 的客户端时间显示格式**
+### 如何更改IoTDB的客户端时间显示格式?
IoTDB 客户端默认显示的时间是人类可读的(比如:```1970-01-01T08:00:00.001```),如果您想显示是时间戳或者其他可读格式,请在启动命令上添加参数```-disableISO8601```:
@@ -152,7 +154,87 @@ IoTDB 客户端默认显示的时间是人类可读的(比如:```1970-01-01T
> $IOTDB_CLI_HOME/sbin/start-cli.sh -h 127.0.0.1 -p 6667 -u root -pw root -disableISO8601
```
-**怎么处理来自`org.apache.ratis.grpc.server.GrpcLogAppender`的`IndexOutOfBoundsException`**
+### 怎么处理来自`org.apache.ratis.grpc.server.GrpcLogAppender`的`IndexOutOfBoundsException`?
这是我们的依赖Ratis 2.4.1的一个内部错误日志,不会对数据写入和读取造成任何影响。
-已经报告给Ratis社区,并会在未来的版本中修复。
\ No newline at end of file
+已经报告给Ratis社区,并会在未来的版本中修复。
+
+## 分布式部署 FAQ
+
+### 集群启停
+
+#### 1. ConfigNode初次启动失败,如何排查原因?
+
+- ConfigNode初次启动时确保已清空data/confignode目录
+- 确保该ConfigNode使用到的<IP+端口>没有被占用,没有与已启动的ConfigNode使用到的<IP+端口>冲突
+- 确保该ConfigNode的cn_target_confignode_list(指向存活的ConfigNode;如果该ConfigNode是启动的第一个ConfigNode,该值指向自身)配置正确
+- 确保该ConfigNode的配置项(共识协议、副本数等)等与cn_target_confignode_list对应的ConfigNode集群一致
+
+#### 2. ConfigNode初次启动成功,show cluster的结果里为何没有该节点?
+
+- 检查cn_target_confignode_list是否正确指向了正确的地址; 如果cn_target_confignode_list指向了自身,则会启动一个新的ConfigNode集群
+
+#### 3. DataNode初次启动失败,如何排查原因?
+
+- DataNode初次启动时确保已清空data/datanode目录。 如果启动结果为“Reject DataNode restart.”则表示启动时可能没有清空data/datanode目录
+- 确保该DataNode使用到的<IP+端口>没有被占用,没有与已启动的DataNode使用到的<IP+端口>冲突
+- 确保该DataNode的dn_target_confignode_list指向存活的ConfigNode
+
+#### 4. 移除DataNode执行失败,如何排查?
+
+- 检查remove-datanode脚本的参数是否正确,是否传入了正确的ip:port或正确的dataNodeId
+- 只有集群可用节点数量 > max(元数据副本数量, 数据副本数量)时,移除操作才允许被执行
+- 执行移除DataNode的过程会将该DataNode上的数据迁移到其他存活的DataNode,数据迁移以Region为粒度,如果某个Region迁移失败,则被移除的DataNode会一直处于Removing状态
+- 补充:处于Removing状态的节点,其节点上的Region也是Removing或Unknown状态,即不可用状态。 该Remvoing状态的节点也不会接受客户端的请求。如果要使Removing状态的节点变为可用,用户可以使用set system status to running 命令将该节点设置为Running状态;如果要使迁移失败的Region处于可用状态,可以使用migrate region from datanodeId1 to datanodeId2 命令将该不可用的Region迁移到其他存活的节点。另外IoTDB后续也会提供remove-datanode.sh -f命令,来强制移除节点(迁移失败的Region会直接丢弃)
+
+#### 5. 挂掉的DataNode是否支持移除?
+
+- 当前集群副本数量大于1时可以移除。 如果集群副本数量等于1,则不支持移除。 在下个版本会推出强制移除的命令
+
+#### 6. 从0.13升级到1.0需要注意什么?
+
+- 0.13版本与1.0版本的文件目录结构是不同的,不能将0.13的data目录直接拷贝到1.0集群使用。如果需要将0.13的数据导入至1.0,可以使用LOAD功能
+- 0.13版本的默认RPC地址是0.0.0.0,1.0版本的默认RPC地址是127.0.0.1
+
+
+### 集群重启
+
+#### 1. 如何重启集群中的某个ConfigNode?
+
+- 第一步:通过stop-confignode.sh或kill进程方式关闭ConfigNode进程
+- 第二步:通过执行start-confignode.sh启动ConfigNode进程实现重启
+- 下个版本IoTDB会提供一键重启的操作
+
+#### 2. 如何重启集群中的某个DataNode?
+
+- 第一步:通过stop-datanode.sh或kill进程方式关闭DataNode进程
+- 第二步:通过执行start-datanode.sh启动DataNode进程实现重启
+- 下个版本IoTDB会提供一键重启的操作
+
+#### 3. 将某个ConfigNode移除后(remove-confignode),能否再利用该ConfigNode的data目录重启?
+
+- 不能。会报错:Reject ConfigNode restart. Because there are no corresponding ConfigNode(whose nodeId=xx) in the cluster.
+
+#### 4. 将某个DataNode移除后(remove-datanode),能否再利用该DataNode的data目录重启?
+
+- 不能正常重启,启动结果为“Reject DataNode restart. Because there are no corresponding DataNode(whose nodeId=xx) in the cluster. Possible solutions are as follows:...”
+
+#### 5. 用户看到某个ConfigNode/DataNode变成了Unknown状态,在没有kill对应进程的情况下,直接删除掉ConfigNode/DataNode对应的data目录,然后执行start-confignode.sh/start-datanode.sh,这种情况下能成功吗?
+
+- 无法启动成功,会报错端口已被占用
+
+### 集群运维
+
+#### 1. Show cluster执行失败,显示“please check server status”,如何排查?
+
+- 确保ConfigNode集群一半以上的节点处于存活状态
+- 确保客户端连接的DataNode处于存活状态
+
+#### 2. 某一DataNode节点的磁盘文件损坏,如何修复这个节点?
+
+- 当前只能通过remove-datanode的方式进行实现。remove-datanode执行的过程中会将该DataNode上的数据迁移至其他存活的DataNode节点(前提是集群设置的副本数大于1)
+- 下个版本IoTDB会提供一键修复节点的功能
+
+#### 3. 如何降低ConfigNode、DataNode使用的内存?
+
+- 在conf/confignode-env.sh、conf/datanode-env.sh文件可通过调整MAX_HEAP_SIZE、MAX_DIRECT_MEMORY_SIZE等选项可以调整ConfigNode、DataNode使用的最大堆内、堆外内存
\ No newline at end of file
diff --git a/docs/zh/UserGuide/IoTDB-Introduction/Scenario.md b/docs/zh/UserGuide/IoTDB-Introduction/Scenario.md
index c963010c2cf..3fad46cf7a0 100644
--- a/docs/zh/UserGuide/IoTDB-Introduction/Scenario.md
+++ b/docs/zh/UserGuide/IoTDB-Introduction/Scenario.md
@@ -19,58 +19,77 @@
-->
-## 应用场景
+# 应用场景
- * 场景 1
+## 应用1——车联网
-某公司采用表面贴装技术(SMT)生产芯片:需要首先在芯片上的焊接点处印刷(即涂抹)锡膏,然后将元器件放置在锡膏上,进而通过加热熔化锡膏并冷却,使得元器件被焊接在芯片上。上述流程采用自动化生产线。为了确保产品质量合格,在印刷锡膏后,需要通过光学设备对锡膏印刷的质量进行评估:采用三维锡膏印刷检测(SPI)设备对每个焊接点上的锡膏的体积(v)、高度(h)、面积(a)、水平偏移(px)、竖直偏移(py)进行度量。
+### 背景
-为了提升印刷质量,该公司有必要将各个芯片上焊接点的度量值进行存储,以便后续基于这些数据进行分析。
+> - 难点:设备多,序列多
-此时可以采用 IoTDB 套件中的 TsFile 组件、TsFileSync 工具和 Hadoop/Spark 集成组件对数据进行存储:每新印刷一个芯片,就在 SPI 设备上使用 SDK 写一条数据,这些数据最终形成一个 TsFile 文件。通过 TsFileSync 工具,生成的 TsFile 文件将按一定规则(如每天)被同步到 Hadoop 数据中心,并由数据分析人员对其进行分析。
+某车企业务体量庞大,需处理车辆多、数据量大,亿级数据测点,每秒超千万条新增数据点,毫秒级采集频率,对数据库的实时写入、存储与处理能力均要求较高。
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/51579014-695ef980-1efa-11e9-8cbc-e9e7ee4fa0d8.png">
+原始架构中使用Hbase集群作为存储数据库,查询延迟高,系统维护难度和成本高。难以满足需求。而IoTDB支持百万级测点数高频数据写入和查询毫秒级响应,高效的数据处理方式可以让用户快速、准确地获取到所需数据,大幅提升了数据处理的效率。
-在场景 1 中,仅需要 TsFile、TsFileSync 部署在一台 PC 上,此外还需要部署 Hadoop/Spark 连接器用于数据中心端 Hadoop/Spark 集群的数据存储和分析。其示意图如上图所示。下图展示了此时的应用架构。
+因此选择以IoTDB为数据存储层,架构轻量,减轻运维成本,且支持弹性扩缩容和高可用,确保系统的稳定性和可用性。
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/81768490-bf034f00-950d-11ea-9b56-fef3edca0958.png">
+### 架构
- * 场景 2
+该车企以IoTDB为时序数据存储引擎的数据管理架构如下图所示。
-某公司拥有多座风力发电机,公司在每个发电机上安装了上百种传感器,分别采集该发电机的工作状态、工作环境中的风速等信息。
-为了保证发电机的正常运转并对发电机及时监控和分析,公司需要收集这些传感器信息,在发电机工作环境中进行部分计算和分析,还需要将收集的原始信息上传到数据中心。
+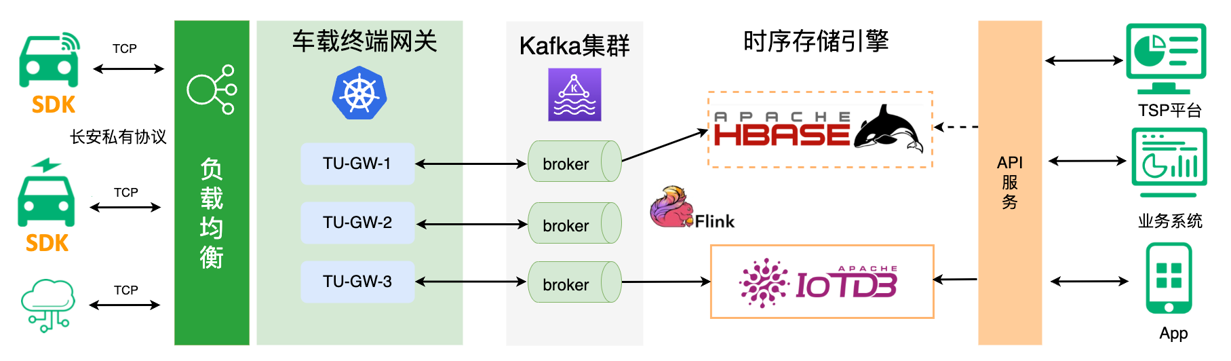
-此时可以采用 IoTDB 套件中的 IoTDB、TsFileSync 工具和 Hadoop/Spark 集成组件等。需要部署一个场控 PC 机,其上安装 IoTDB 和 TsFileSync 工具,用于支持读写数据、本地计算和分析以及上传数据到数据中心。此外还需要部署 Hadoop/Spark 连接器用于数据中心端 Hadoop/Spark 集群的数据存储和分析。如下图所示。
+车辆数据基于TCP和工业协议编码后发送至边缘网关,网关将数据发往消息队列Kafka集群,解耦生产和消费两端。Kafka将数据发送至Flink进行实时处理,处理后的数据写入IoTDB中,历史数据和最新数据均在IoTDB中进行查询,最后数据通过API流入可视化平台等进行应用。
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/51579033-7ed42380-1efa-11e9-889f-fb4180291a9e.png">
+## 应用2——智能运维
-下图给出了此时的应用架构。
+### 背景
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/51579064-8f849980-1efa-11e9-8cd6-a7339cd0540f.jpg">
+某钢厂旨在搭建低成本、大规模接入能力的远程智能运维软硬件平台,接入数百条产线,百万以上设备,千万级时间序列,实现智能运维远程覆盖。
- * 场景 3
+此过程中面临诸多痛点:
-某工厂在厂区范围内拥有多种机械手设备,这些机械手设备的硬件配置有限,很难搭载复杂的应用程序。在每个机械手设备上工厂安装了很多种传感器,用以对机械手的工作状态、温度等信息进行监控。由于工厂的网络环境原因,在工厂内部的机械手均处于工厂内部局域网内,无法连接外部网络。同时,工厂中会有少量服务器能够直接连接外部公网。
+> - 设备种类繁多、协议众多、数据类型众多
+> - 时序数据特别是高频数据,数据量巨大
+> - 海量时序数据下的读写速度无法满足业务需求
+> - 现有时序数据管理组件无法满足各类高级应用需求
-为了保证机械手的监控数据能够及时监控和分析,公司需要收集这些机械手传感器信息,将其发送至可以连接外部网络的服务器上,而后将原始数据信息上传到数据中心进行复杂的计算和分析。
+而选取IoTDB作为智能运维平台的存储数据库后,能稳定写入多频及高频采集数据,覆盖钢铁全工序,并采用复合压缩算法使数据大小缩减10倍以上,节省成本。IoTDB 还有效支持超过10年的历史数据降采样查询,帮助企业挖掘数据趋势,助力企业长远战略分析。
-此时,可以采用 IoTDB 套件中的 IoTDB、IoTDB-Client 工具、TsFileSync 工具和 Hadoop/Spark 集成组件等。将 IoTDB 服务器安装在工厂连接外网的服务器上,用户接收机械手传输的数据并将数据上传到数据中心。将 IoTDB-Client 工具安装在每一个连接工厂内网的机械手上,用于将传感器产生的实时数据上传到工厂内部服务器。再使用 TsFileSync 工具将原始数据上传到数据中心。此外还需要部署 Hadoop/Spark 连接器用于数据中心端 Hadoop/Spark 集群的数据存储和分析。如下图中间场景所示。
+### 架构
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/51579080-96aba780-1efa-11e9-87ac-940c45b19dd7.jpg">
+下图为该钢厂的智能运维平台架构设计。
-下图给出了此时的应用架构。
+
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/81768477-b874d780-950d-11ea-80ca-8807b9bd0970.png">
+## 应用3——智能工厂
- * 场景 4
+### 背景
-某汽车公司在其下属的汽车上均安装了传感器采集车辆的行驶状态等监控信息。这些汽车设备的硬件配置有限,很难搭载复杂的应用程序。安装传感器的汽车可以通过窄带物联网相互连接,也可以通过窄带物联网将数据发送至外部网络。
+> - 难点/亮点:云边协同
-为了能够实时接收汽车传感器所采集的物联网数据,公司需要在车辆行驶的过程中将传感器数据通过窄带物联网实时发送至数据中心,而后在数据中心的服务器上进行复杂的计算和分析。
+某卷烟厂希望从“传统工厂”向“高端工厂”完成转型升级,利用物联网和设备监控技术,加强信息管理和服务实现数据在企业内部自由流动,数据和决策的上通下达,帮助企业提高生产力,降低运营成本。
-此时,可以采用 IoTDB 套件中的 IoTDB、IoTDB-Client 和 Hadoop/Spark 集成组件等。将 IoTDB-Client 工具安装在每一辆车联网内的车辆上,使用 IoTDB-JDBC 工具将数据直接传回数据中心的服务器。
+### 架构
-此外还需要部署 Hadoop/Spark 集群用于数据中心端的数据存储和分析。如下图所示。
+下图为该工厂的物联网系统架构,IoTDB贯穿公司、工厂、车间三级物联网平台,实现设备统一联调联控。车间层面的数据通过边缘层的IoTDB进行实时采集、处理和存储,并实现了一系列的分析任务。经过预处理的数据被发送至平台层的IoTDB,进行业务层面的数据治理,如设备管理、连接管理、服务支持等。最终,数据会被集成到集团层面的IoTDB中,供整个组织进行综合分析和决策。
-<img style="width:100%; max-width:800px; max-height:600px; margin-left:auto; margin-right:auto; display:block;" src="https://alioss.timecho.com/docs/img/github/51579095-a4f9c380-1efa-11e9-9f95-17165ec55568.jpg">
+
+
+
+## 应用4——工况监控
+
+### 背景
+
+> - 难点/亮点:智慧供热,降本增效
+
+某电厂需要对风机锅炉设备、发电机、变电设备等主辅机数万测点进行监控。在以往的供暖供热过程中缺少对于下一阶段的供热量的预判,导致无效供热、过度供热、供热不足等情况。
+
+使用IoTDB作为存储与分析引擎后,结合气象数据、楼控数据、户控数据、换热站数据、官网数据、热源侧数据等总和评判供热量,所有数据在IoTDB中进行时间对齐,为智慧供热提供可靠的数据依据,实现智慧供热。同时也解决了按需计费、管网、热战等相关供热过程中各重要组成部分的工况监控,减少了人力投入。
+
+### 架构
+
+下图为该电厂的供热场景数据管理架构。
+
+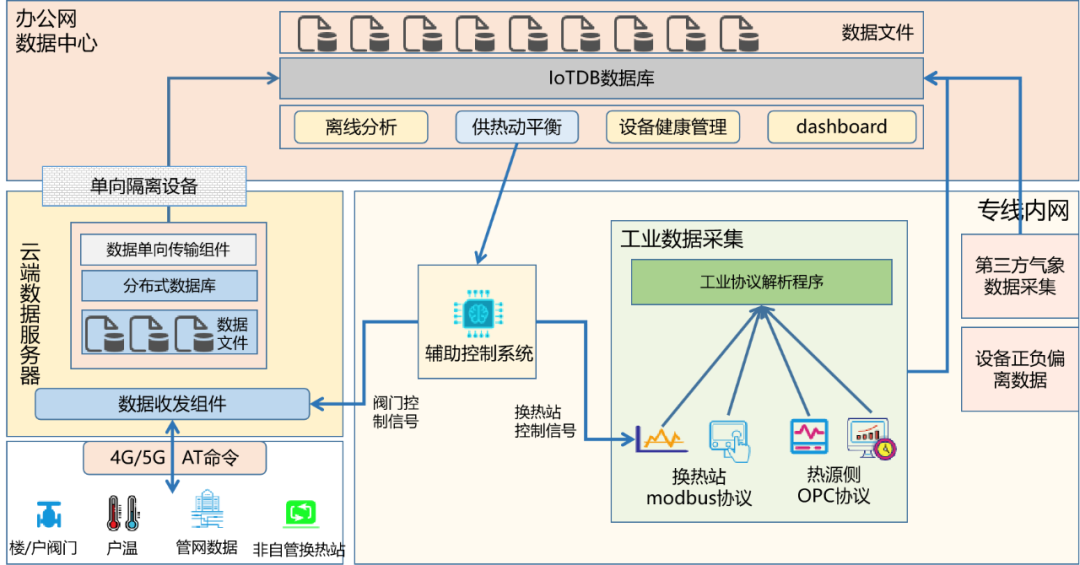
diff --git a/docs/zh/UserGuide/Maintenance-Tools/Watermark-Tool.md b/docs/zh/UserGuide/Maintenance-Tools/Watermark-Tool.md
new file mode 100644
index 00000000000..e1fbb7bd7b2
--- /dev/null
+++ b/docs/zh/UserGuide/Maintenance-Tools/Watermark-Tool.md
@@ -0,0 +1,196 @@
+<!--
+Licensed to the Apache Software Foundation (ASF) under one
+or more contributor license agreements. See the NOTICE file
+distributed with this work for additional information
+regarding copyright ownership. The ASF licenses this file
+to you under the Apache License, Version 2.0 (the
+"License"); you may not use this file except in compliance
+with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+Unless required by applicable law or agreed to in writing,
+software distributed under the License is distributed on an
+"AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+KIND, either express or implied. See the License for the
+specific language governing permissions and limitations
+under the License.
+
+-->
+## 水印工具
+
+这个工具提供了 1)IoTDB 查询结果水印嵌入功能,2)可疑数据的水印检测功能。
+
+### 水印嵌入
+
+#### 配置
+
+IoTDB 默认关闭水印嵌入功能。为了使用这个功能,第一步要做的事情是修改配置文件`iotdb-datanode.properties`中的以下各项:
+
+| 名称 | 示例 | 解释 |
+| ----------------------- | ------------------------------------------------------ | ----------------------------------- |
+| watermark_module_opened | false | `true`打开水印嵌入功能;`false`关闭 |
+| watermark_secret_key | IoTDB*2019@Beijing | 自定义密钥 |
+| watermark_bit_string | 100101110100 | 要被嵌入的 0-1 比特串 |
+| watermark_method | GroupBasedLSBMethod(embed_row_cycle=2,embed_lsb_num=5) | 指定水印算法及其参数 |
+
+注意:
+
+- `watermark_module_opened`: 如果您想使用水印嵌入功能,请将其设置成`true`。
+- `watermark_secret_key`: 不能使用字符 '&'。密钥长度没有限制,一般来说密钥越长,攻击难度就越高。
+- `watermark_bit_string`: 比特串长度没有限制(除了不能为空字符串),但是当长度过短时,水印检测可能达不到要求的显著性水平。
+- `watermark_method`: 现在仅支持一种算法 GroupBasedLSBMethod,因此您实际上可以修改的只有这个算法的两个参数`embed_row_cycle`和`embed_lsb_num`的值:
+ - 均是正整数
+ - `embed_row_cycle`控制了被嵌入水印的行占总行数的比例。`embed_row_cycle`越小,被嵌入水印的行的比例就越大。当`embed_row_cycle`等于 1 的时候,所有的行都将嵌入水印。
+ - GroupBasedLSBMethod 使用 LSB 嵌入。`embed_lsb_num`控制了允许嵌入水印的最低有效位的数量。`embed_lsb_num`越大,数值的可变化范围就越大。
+- `watermark_secret_key`, `watermark_bit_string`和`watermark_method`都不应该被攻击者获得。您需要自己负责配置文件`iotdb-datanode.properties`的安全管理。
+
+#### 使用示例
+
+ * 第一步:创建一个新用户 Alice,授予读权限,然后查询
+
+一个新创建的用户默认不使用水印。因此查询结果就是数据库中的原始数据。
+
+```
+.\start-cli.bat -u root -pw root
+create user Alice '1234'
+grant user Alice privileges READ_TIMESERIES on root.vehicle
+exit
+
+.\start-cli.bat -u Alice -pw 1234
+select * from root
++-----------------------------------+------------------+
+| Time|root.vehicle.d0.s0|
++-----------------------------------+------------------+
+| 1970-01-01T08:00:00.001+08:00| 21.5|
+| 1970-01-01T08:00:00.002+08:00| 22.5|
+| 1970-01-01T08:00:00.003+08:00| 23.5|
+| 1970-01-01T08:00:00.004+08:00| 24.5|
+| 1970-01-01T08:00:00.005+08:00| 25.5|
+| 1970-01-01T08:00:00.006+08:00| 26.5|
+| 1970-01-01T08:00:00.007+08:00| 27.5|
+| 1970-01-01T08:00:00.008+08:00| 28.5|
+| 1970-01-01T08:00:00.009+08:00| 29.5|
+| 1970-01-01T08:00:00.010+08:00| 30.5|
+| 1970-01-01T08:00:00.011+08:00| 31.5|
+| 1970-01-01T08:00:00.012+08:00| 32.5|
+| 1970-01-01T08:00:00.013+08:00| 33.5|
+| 1970-01-01T08:00:00.014+08:00| 34.5|
+| 1970-01-01T08:00:00.015+08:00| 35.5|
+| 1970-01-01T08:00:00.016+08:00| 36.5|
+| 1970-01-01T08:00:00.017+08:00| 37.5|
+| 1970-01-01T08:00:00.018+08:00| 38.5|
+| 1970-01-01T08:00:00.019+08:00| 39.5|
+| 1970-01-01T08:00:00.020+08:00| 40.5|
+| 1970-01-01T08:00:00.021+08:00| 41.5|
+| 1970-01-01T08:00:00.022+08:00| 42.5|
+| 1970-01-01T08:00:00.023+08:00| 43.5|
+| 1970-01-01T08:00:00.024+08:00| 44.5|
+| 1970-01-01T08:00:00.025+08:00| 45.5|
+| 1970-01-01T08:00:00.026+08:00| 46.5|
+| 1970-01-01T08:00:00.027+08:00| 47.5|
+| 1970-01-01T08:00:00.028+08:00| 48.5|
+| 1970-01-01T08:00:00.029+08:00| 49.5|
+| 1970-01-01T08:00:00.030+08:00| 50.5|
+| 1970-01-01T08:00:00.031+08:00| 51.5|
+| 1970-01-01T08:00:00.032+08:00| 52.5|
+| 1970-01-01T08:00:00.033+08:00| 53.5|
++-----------------------------------+------------------+
+```
+
+ * 第二步:给 Alice 施加水印嵌入
+
+sql 用法:`grant watermark_embedding to Alice`
+
+您可以使用`grant watermark_embedding to user1,user2,...`来同时给多个用户施加水印嵌入。
+
+只有 root 用户有权限运行该指令。在 root 给 Alice 施加水印嵌入之后,Alice 的所有查询结果都将被嵌入水印。
+
+```
+.\start-cli.bat -u root -pw root
+grant watermark_embedding to Alice
+exit
+
+.\start-cli.bat -u Alice -pw 1234
+select * from root
+
++-----------------------------------+------------------+
+| Time|root.vehicle.d0.s0|
++-----------------------------------+------------------+
+| 1970-01-01T08:00:00.001+08:00| 21.5|
+| 1970-01-01T08:00:00.002+08:00| 22.5|
+| 1970-01-01T08:00:00.003+08:00| 23.500008|
+| 1970-01-01T08:00:00.004+08:00| 24.500015|
+| 1970-01-01T08:00:00.005+08:00| 25.5|
+| 1970-01-01T08:00:00.006+08:00| 26.500015|
+| 1970-01-01T08:00:00.007+08:00| 27.5|
+| 1970-01-01T08:00:00.008+08:00| 28.500004|
+| 1970-01-01T08:00:00.009+08:00| 29.5|
+| 1970-01-01T08:00:00.010+08:00| 30.5|
+| 1970-01-01T08:00:00.011+08:00| 31.5|
+| 1970-01-01T08:00:00.012+08:00| 32.5|
+| 1970-01-01T08:00:00.013+08:00| 33.5|
+| 1970-01-01T08:00:00.014+08:00| 34.5|
+| 1970-01-01T08:00:00.015+08:00| 35.500004|
+| 1970-01-01T08:00:00.016+08:00| 36.5|
+| 1970-01-01T08:00:00.017+08:00| 37.5|
+| 1970-01-01T08:00:00.018+08:00| 38.5|
+| 1970-01-01T08:00:00.019+08:00| 39.5|
+| 1970-01-01T08:00:00.020+08:00| 40.5|
+| 1970-01-01T08:00:00.021+08:00| 41.5|
+| 1970-01-01T08:00:00.022+08:00| 42.500015|
+| 1970-01-01T08:00:00.023+08:00| 43.5|
+| 1970-01-01T08:00:00.024+08:00| 44.500008|
+| 1970-01-01T08:00:00.025+08:00| 45.50003|
+| 1970-01-01T08:00:00.026+08:00| 46.500008|
+| 1970-01-01T08:00:00.027+08:00| 47.500008|
+| 1970-01-01T08:00:00.028+08:00| 48.5|
+| 1970-01-01T08:00:00.029+08:00| 49.5|
+| 1970-01-01T08:00:00.030+08:00| 50.5|
+| 1970-01-01T08:00:00.031+08:00| 51.500008|
+| 1970-01-01T08:00:00.032+08:00| 52.5|
+| 1970-01-01T08:00:00.033+08:00| 53.5|
++-----------------------------------+------------------+
+```
+
+ * 第三步:撤销 Alice 的水印嵌入
+
+sql 用法:`revoke watermark_embedding from Alice`
+
+您可以使用`revoke watermark_embedding from user1,user2,...`来同时撤销多个用户的水印嵌入。
+
+只有 root 用户有权限运行该指令。在 root 撤销 Alice 的水印嵌入之后,Alice 的所有查询结果就又是数据库中的原始数据了。
+
+### 水印检测
+
+`detect-watermark.sh` 和 `detect-watermark.bat` 是给不同平台提供的功能相同的工具脚本。
+
+用法: ./detect-watermark.sh [filePath] [secretKey] [watermarkBitString] [embed_row_cycle] [embed_lsb_num] [alpha] [columnIndex] [dataType: int/float/double]
+
+示例: ./detect-watermark.sh /home/data/dump1.csv IoTDB*2019@Beijing 100101110100 2 5 0.05 1 float
+
+| Args | 示例 | 解释 |
+| ------------------ | -------------------- | ---------------------------------------------- |
+| filePath | /home/data/dump1.csv | 可疑数据的文件路径 |
+| secretKey | IoTDB*2019@Beijing | 参见水印嵌入小节 |
+| watermarkBitString | 100101110100 | 参见水印嵌入小节 |
+| embed_row_cycle | 2 | 参见水印嵌入小节 |
+| embed_lsb_num | 5 | 参见水印嵌入小节 |
+| alpha | 0.05 | 显著性水平 |
+| columnIndex | 1 | 指定可疑数据的某一列进行检测 |
+| dataType | float | 指定检测列的数据类型;int/float/double 任选其一 |
+
+注意:
+
+- `filePath`: 您可以使用 export-csv 工具来生成这样的数据文件。第一行是表头, 第一列是时间列。文件中的数据示例如下:
+
+| Time | root.vehicle.d0.s1 | root.vehicle.d0.s1 |
+| ----------------------------- | ------------------ | ------------------ |
+| 1970-01-01T08:00:00.001+08:00 | 100 | null |
+| ... | ... | ... |
+
+- `watermark_secret_key`, `watermark_bit_string`, `embed_row_cycle`和`embed_lsb_num`应该和水印嵌入过程使用的值保持一致。
+
+- `alpha`: 取值范围 [0,1]。水印检测基于显著性检验,`alpha`越小,没有嵌入水印的数据被检测成嵌入水印的可能性越低,从而检测出嵌入水印的结果的可信度越高。
+
+- `columnIndex`: 正整数
diff --git a/docs/zh/UserGuide/Operate-Metadata/Auto-Create-MetaData.md b/docs/zh/UserGuide/Operate-Metadata/Auto-Create-MetaData.md
index 6f3fbd08859..64662bb0d64 100644
--- a/docs/zh/UserGuide/Operate-Metadata/Auto-Create-MetaData.md
+++ b/docs/zh/UserGuide/Operate-Metadata/Auto-Create-MetaData.md
@@ -108,4 +108,4 @@
* 可配置的编码方式包括:PLAIN, RLE, TS_2DIFF, GORILLA, DICTIONARY
-* 数据类型与编码方式的对应关系详见 [编码方式](../Data-Concept/Encoding.md)。
\ No newline at end of file
+* 数据类型与编码方式的对应关系详见 [编码方式](../Basic-Concept/Encoding.md)。
\ No newline at end of file
diff --git a/docs/zh/UserGuide/Operate-Metadata/Timeseries.md b/docs/zh/UserGuide/Operate-Metadata/Timeseries.md
index df789e5f91d..73b56c49d40 100644
--- a/docs/zh/UserGuide/Operate-Metadata/Timeseries.md
+++ b/docs/zh/UserGuide/Operate-Metadata/Timeseries.md
@@ -51,7 +51,7 @@ IoTDB> create timeseries root.ln.wf02.wt02.status WITH DATATYPE=BOOLEAN, ENCODIN
error: encoding TS_2DIFF does not support BOOLEAN
```
-详细的数据类型与编码方式的对应列表请参见 [编码方式](../Data-Concept/Encoding.md)。
+详细的数据类型与编码方式的对应列表请参见 [编码方式](../Basic-Concept/Encoding.md)。
### 创建对齐时间序列
diff --git a/docs/zh/UserGuide/Query-Data/Select-Into.md b/docs/zh/UserGuide/Query-Data/Select-Into.md
index 15869ef74ae..c01e9771fcc 100644
--- a/docs/zh/UserGuide/Query-Data/Select-Into.md
+++ b/docs/zh/UserGuide/Query-Data/Select-Into.md
@@ -270,7 +270,7 @@ select s1, s2 into root.sg_copy.d1(t1, t2), aligned root.sg_copy.d2(t1, t2) from
#### 其他要注意的点
- 对于一般的聚合查询,时间戳是无意义的,约定使用 0 来存储。
-- 当目标序列存在时,需要保证源序列和目标时间序列的数据类型兼容。关于数据类型的兼容性,查看文档 [数据类型](../Data-Concept/Data-Type.md#数据类型兼容性)。
+- 当目标序列存在时,需要保证源序列和目标时间序列的数据类型兼容。关于数据类型的兼容性,查看文档 [数据类型](../Basic-Concept/Data-Type.md#数据类型兼容性)。
- 当目标序列不存在时,系统将自动创建目标序列(包括 database)。
- 当查询的序列不存在或查询的序列不存在数据,则不会自动创建目标序列。
diff --git a/docs/zh/UserGuide/Query-Data/Where-Condition.md b/docs/zh/UserGuide/Query-Data/Where-Condition.md
index 0fc4bf1c314..589a5e4eb86 100644
--- a/docs/zh/UserGuide/Query-Data/Where-Condition.md
+++ b/docs/zh/UserGuide/Query-Data/Where-Condition.md
@@ -30,7 +30,7 @@
### 时间过滤条件
-使用时间过滤条件可以筛选特定时间范围的数据。对于时间戳支持的格式,请参考 [时间戳类型](../Data-Concept/Data-Type.md) 。
+使用时间过滤条件可以筛选特定时间范围的数据。对于时间戳支持的格式,请参考 [时间戳类型](../Basic-Concept/Data-Type.md) 。
示例如下:
diff --git a/docs/zh/UserGuide/QuickStart/ClusterQuickStart.md b/docs/zh/UserGuide/QuickStart/ClusterQuickStart.md
index ab11f3a8fed..2a40be1ab3f 100644
--- a/docs/zh/UserGuide/QuickStart/ClusterQuickStart.md
+++ b/docs/zh/UserGuide/QuickStart/ClusterQuickStart.md
@@ -19,17 +19,17 @@
-->
-## 集群快速上手
+# 集群版
以本地环境为例,演示 IoTDB 集群的启动、扩容与缩容。
**注意:本文档为使用本地不同端口,进行伪分布式环境部署的教程,仅用于练习。在真实环境部署时,一般不需要修改节点端口,仅需配置节点 IPV4 地址或域名即可。**
-### 1. 准备启动环境
+## 1. 准备启动环境
解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster0 目录。
-### 2. 启动最小集群
+## 2. 启动最小集群
在 Linux 环境中,部署 1 个 ConfigNode 和 1 个 DataNode(1C1D)集群版,默认 1 副本:
```
@@ -37,7 +37,7 @@
./cluster0/sbin/start-datanode.sh
```
-### 3. 验证最小集群
+## 3. 验证最小集群
+ 最小集群启动成功,启动 Cli 进行验证:
```
@@ -58,11 +58,11 @@ Total line number = 2
It costs 0.242s
```
-### 4. 准备扩容环境
+## 4. 准备扩容环境
解压 apache-iotdb-1.0.0-all-bin.zip 至 cluster1 目录和 cluster2 目录
-### 5. 修改节点配置文件
+## 5. 修改节点配置文件
对于 cluster1 目录:
@@ -112,7 +112,7 @@ It costs 0.242s
| dn\_data\_region\_consensus\_port | 10762 |
| dn\_target\_config\_node\_list | 127.0.0.1:10710 |
-### 6. 集群扩容
+## 6. 集群扩容
将集群扩容至 3 个 ConfigNode 和 3 个 DataNode(3C3D)集群版,
指令执行顺序为先启动 ConfigNode,再启动 DataNode:
@@ -123,7 +123,7 @@ It costs 0.242s
./cluster2/sbin/start-datanode.sh
```
-### 7. 验证扩容结果
+## 7. 验证扩容结果
在 Cli 执行 `show cluster details`,结果如下:
```
@@ -142,7 +142,7 @@ Total line number = 6
It costs 0.012s
```
-### 8. 集群缩容
+## 8. 集群缩容
+ 缩容一个 ConfigNode:
```
@@ -162,7 +162,7 @@ It costs 0.012s
./cluster0/sbin/remove-confignode.sh 4
```
-### 9. 验证缩容结果
+## 9. 验证缩容结果
在 Cli 执行 `show cluster details`,结果如下:
```
@@ -177,4 +177,5 @@ IoTDB> show cluster details
+------+----------+-------+---------------+------------+-------------------+----------+-------+-------+-------------------+-----------------+
Total line number = 4
It costs 0.005s
-```
\ No newline at end of file
+```
+
diff --git a/docs/zh/UserGuide/QuickStart/General-SQL-Statements.md b/docs/zh/UserGuide/QuickStart/General-SQL-Statements.md
new file mode 100644
index 00000000000..99d0ef5defe
--- /dev/null
+++ b/docs/zh/UserGuide/QuickStart/General-SQL-Statements.md
@@ -0,0 +1,159 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+## 数据库管理
+
+数据库(Database)类似关系数据库中的 Database,是一组结构化的时序数据的集合。
+
+* 创建数据库
+
+ 创建一个名为 root.ln 的数据库,语法如下:
+```
+CREATE DATABASE root.ln
+```
+* 查看数据库
+
+查看所有数据库:
+```
+SHOW DATABASES
+```
+* 删除数据库
+
+删除名为 root.ln 的数据库:
+```
+DELETE DATABASE root.ln
+```
+* 统计数据库数量
+
+统计数据库的总数
+```
+COUNT DATABASES
+```
+## 时间序列管理
+
+时间序列(Timeseries)是以时间为索引的数据点的集合,在IoTDB中时间序列指的是一个测点的完整序列,本节主要介绍时间序列的管理方式。
+
+* 创建时间序列
+
+需指定编码方式与数据类型。例如创建一条名为root.ln.wf01.wt01.temperature的时间序列:
+```
+CREATE TIMESERIES root.ln.wf01.wt01.temperature WITH datatype=FLOAT,ENCODING=RLE
+```
+* 查看时间序列
+
+查看所有时间序列:
+```
+SHOW TIMESERIES
+```
+
+使用通配符匹配数据库root.ln下的时间序列:
+
+```
+SHOW TIMESERIES root.ln.**
+```
+* 删除时间序列
+
+创建名为 root.ln.wf01.wt01.temperature 的时间序列
+```
+DELETE TIMESERIES root.ln.wf01.wt01.temperature
+```
+* 统计时间序列
+
+统计时间序列的总数
+```
+COUNT TIMESERIES root.**
+```
+统计某通配符路径下的时间序列数量:
+```
+COUNT TIMESERIES root.ln.**
+```
+## 时间序列路径管理
+
+除时间序列概念外,IoTDB中还有子路径、设备的概念。
+
+**子路径:**是一条完整时间序列名称中的一部分路径,如时间序列名称为root.ln.wf01.wt01.temperature,则root.ln、root.ln.wf01、root.ln.wf01.wt01都是其子路径。
+
+**设备:**是一组时间序列的组合,在 IoTDB 中设备是由root至倒数第二级节点的子路径,如时间序列名称为root.ln.wf01.wt01.temperature,则root.ln.wf01.wt01是其设备
+
+* 查看设备
+```
+SHOW DEVICES
+```
+
+* 查看子路径
+
+查看 root.ln 的下一层:
+```
+SHOW CHILD PATHS root.ln
+```
+* 查看子节点
+
+查看 root.ln 的下一层:
+```
+SHOW CHILD NODES root.ln
+```
+* 统计设备数量
+
+统计所有设备
+```
+COUNT DEVICES
+```
+* 统计节点数
+
+统计路径中指定层级的节点个数
+```
+COUNT NODES root.ln.** LEVEL=2
+```
+## 查询数据
+
+以下为IoTDB中常用查询语句。
+
+* 查询指定时间序列的数据
+
+查询root.ln.wf01.wt01设备下的所有时间序列的数据
+
+```
+SELECT * FROM root.ln.wf01.wt01
+```
+
+* 查询某时间范围内的时间序列数据
+
+查询root.ln.wf01.wt01.temperature时间序列中时间戳大于 2022-01-01T00:05:00.000 的数据
+
+```
+SELECT temperature FROM root.ln.wf01.wt01 WHERE time > 2022-01-01T00:05:00.000
+```
+
+* 查询数值在指定范围内的时间序列数据
+
+查询root.ln.wf01.wt01.temperature时间序列中数值大于 36.5 的数据:
+
+```
+SELECT temperature FROM root.ln.wf01.wt01 WHERE temperature > 36.5
+```
+
+* 使用 last 查询最新点数据
+```
+SELECT last * FROM root.ln.wf01.wt01
+```
+
+
+
diff --git a/docs/zh/UserGuide/SQL-Manual/SQL-Manual.md b/docs/zh/UserGuide/SQL-Manual/SQL-Manual.md
new file mode 100644
index 00000000000..dba87ab6c9c
--- /dev/null
+++ b/docs/zh/UserGuide/SQL-Manual/SQL-Manual.md
@@ -0,0 +1,2511 @@
+# 一、元数据操作
+
+## 1、数据库管理
+
+### 创建数据库
+
+```sql
+CREATE DATABASE root.ln
+
+CREATE DATABASE root.ln.wf01
+> Msg: 300: root.ln has already been created as database.
+```
+
+### 查看数据库
+
+```sql
+show databases
+show databases root.*
+show databases root.**
+```
+
+### 删除数据库
+
+```sql
+DELETE DATABASE root.ln
+DELETE DATABASE root.sgcc
+DELETE DATABASE root.**
+```
+
+### 统计数据库数量
+
+```sql
+count databases
+count databases root.*
+count databases root.sgcc.*
+count databases root.sgcc
+```
+
+## 2、时间序列管理
+
+### 创建时间序列
+
+```sql
+create timeseries root.ln.wf01.wt01.status with datatype=BOOLEAN,encoding=PLAIN
+create timeseries root.ln.wf01.wt01.temperature with datatype=FLOAT,encoding=RLE
+create timeseries root.ln.wf02.wt02.hardware with datatype=TEXT,encoding=PLAIN
+create timeseries root.ln.wf02.wt02.status with datatype=BOOLEAN,encoding=PLAIN
+create timeseries root.sgcc.wf03.wt01.status with datatype=BOOLEAN,encoding=PLAIN
+create timeseries root.sgcc.wf03.wt01.temperature with datatype=FLOAT,encoding=RLE
+```
+
+- 简化版
+
+```sql
+create timeseries root.ln.wf01.wt01.status BOOLEAN encoding=PLAIN
+create timeseries root.ln.wf01.wt01.temperature FLOAT encoding=RLE
+create timeseries root.ln.wf02.wt02.hardware TEXT encoding=PLAIN
+create timeseries root.ln.wf02.wt02.status BOOLEAN encoding=PLAIN
+create timeseries root.sgcc.wf03.wt01.status BOOLEAN encoding=PLAIN
+create timeseries root.sgcc.wf03.wt01.temperature FLOAT encoding=RLE
+```
+
+- 错误提示
+
+```sql
+create timeseries root.ln.wf02.wt02.status WITH DATATYPE=BOOLEAN, ENCODING=TS_2DIFF
+> error: encoding TS_2DIFF does not support BOOLEAN
+```
+
+### 创建对齐时间序列
+
+```sql
+CREATE ALIGNED TIMESERIES root.ln.wf01.GPS(latitude FLOAT encoding=PLAIN compressor=SNAPPY, longitude FLOAT encoding=PLAIN compressor=SNAPPY)
+```
+
+### 删除时间序列
+
+```sql
+delete timeseries root.ln.wf01.wt01.status
+delete timeseries root.ln.wf01.wt01.temperature, root.ln.wf02.wt02.hardware
+delete timeseries root.ln.wf02.*
+drop timeseries root.ln.wf02.*
+```
+
+### 查看时间序列
+
+```sql
+SHOW TIMESERIES
+SHOW TIMESERIES <Path>
+show timeseries root.**
+show timeseries root.ln.**
+show timeseries root.ln.** limit 10 offset 10
+show timeseries root.ln.** where timeseries contains 'wf01.wt'
+show timeseries root.ln.** where dataType=FLOAT
+SHOW LATEST TIMESERIES
+```
+
+### 统计时间序列数量
+
+```sql
+COUNT TIMESERIES root.**
+COUNT TIMESERIES root.ln.**
+COUNT TIMESERIES root.ln.*.*.status
+COUNT TIMESERIES root.ln.wf01.wt01.status
+COUNT TIMESERIES root.** WHERE TIMESERIES contains 'sgcc'
+COUNT TIMESERIES root.** WHERE DATATYPE = INT64
+COUNT TIMESERIES root.** WHERE TAGS(unit) contains 'c'
+COUNT TIMESERIES root.** WHERE TAGS(unit) = 'c'
+COUNT TIMESERIES root.** WHERE TIMESERIES contains 'sgcc' group by level = 1
+COUNT TIMESERIES root.** GROUP BY LEVEL=1
+COUNT TIMESERIES root.ln.** GROUP BY LEVEL=2
+COUNT TIMESERIES root.ln.wf01.* GROUP BY LEVEL=2
+```
+
+### 标签点管理
+
+```sql
+create timeseries root.turbine.d1.s1(temprature) with datatype=FLOAT, encoding=RLE, compression=SNAPPY tags(tag1=v1, tag2=v2) attributes(attr1=v1, attr2=v2)
+```
+
+- 重命名标签或属性
+
+```sql
+ALTER timeseries root.turbine.d1.s1 RENAME tag1 TO newTag1
+```
+
+- 重新设置标签或属性的值
+
+```sql
+ALTER timeseries root.turbine.d1.s1 SET newTag1=newV1, attr1=newV1
+```
+
+- 删除已经存在的标签或属性
+
+```sql
+ALTER timeseries root.turbine.d1.s1 DROP tag1, tag2
+```
+
+- 添加新的标签
+
+```sql
+ALTER timeseries root.turbine.d1.s1 ADD TAGS tag3=v3, tag4=v4
+```
+
+- 添加新的属性
+
+```sql
+ALTER timeseries root.turbine.d1.s1 ADD ATTRIBUTES attr3=v3, attr4=v4
+```
+
+- 更新插入别名,标签和属性
+
+```sql
+ALTER timeseries root.turbine.d1.s1 UPSERT ALIAS=newAlias TAGS(tag2=newV2, tag3=v3) ATTRIBUTES(attr3=v3, attr4=v4)
+```
+
+- 使用标签作为过滤条件查询时间序列
+
+```sql
+SHOW TIMESERIES (<`PathPattern`>)? timeseriesWhereClause
+```
+
+返回给定路径的下的所有满足条件的时间序列信息:
+
+```sql
+ALTER timeseries root.ln.wf02.wt02.hardware ADD TAGS unit=c
+ALTER timeseries root.ln.wf02.wt02.status ADD TAGS description=test1
+show timeseries root.ln.** where TAGS(unit)='c'
+show timeseries root.ln.** where TAGS(description) contains 'test1'
+```
+
+- 使用标签作为过滤条件统计时间序列数量
+
+```sql
+COUNT TIMESERIES (<`PathPattern`>)? timeseriesWhereClause
+COUNT TIMESERIES (<`PathPattern`>)? timeseriesWhereClause GROUP BY LEVEL=<INTEGER>
+```
+
+返回给定路径的下的所有满足条件的时间序列的数量:
+
+```sql
+count timeseries
+count timeseries root.** where TAGS(unit)='c'
+count timeseries root.** where TAGS(unit)='c' group by level = 2
+```
+
+创建对齐时间序列:
+
+```sql
+create aligned timeseries root.sg1.d1(s1 INT32 tags(tag1=v1, tag2=v2) attributes(attr1=v1, attr2=v2), s2 DOUBLE tags(tag3=v3, tag4=v4) attributes(attr3=v3, attr4=v4))
+```
+
+支持查询:
+
+```sql
+show timeseries where TAGS(tag1)='v1'
+```
+
+## 3、时间序列路径管理
+
+### 查看路径的所有子路径
+
+SHOW CHILD PATHS pathPattern
+
+- 查询 root.ln 的下一层:show child paths root.ln
+- 查询形如 root.xx.xx.xx 的路径:show child paths root.*.*
+
+### 查看路径的所有子节点
+
+SHOW CHILD NODES pathPattern
+
+- 查询 root 的下一层:show child nodes root
+- 查询 root.ln 的下一层 :show child nodes root.ln
+
+### 查看设备
+
+IoTDB> show devices
+
+IoTDB> show devices root.ln.**
+
+#### 查看设备及其 database 信息
+
+IoTDB> show devices with database
+
+IoTDB> show devices root.ln.** with database
+
+### 统计节点数
+
+IoTDB > COUNT NODES root.** LEVEL=2
+
+IoTDB > COUNT NODES root.ln.** LEVEL=2
+
+IoTDB > COUNT NODES root.ln.wf01.* LEVEL=3
+
+IoTDB > COUNT NODES root.**.temperature LEVEL=3
+
+### 统计设备数量
+
+IoTDB> show devices
+
+IoTDB> count devices
+
+IoTDB> count devices root.ln.**
+
+## 4、设备模板管理
+
+
+
+
+
+Create template(s1 int, s2 float) on root.sg
+
+Create device root.sg.d1
+
+
+
+
+
+### 创建元数据模板
+
+```Go
+CREATE SCHEMA TEMPLATE <templateName> ALIGNED? '(' <measurementId> <attributeClauses> [',' <measurementId> <attributeClauses>]+ ')'
+```
+
+创建包含两个非对齐序列的元数据模板
+
+IoTDB> create schema template t1 (temperature FLOAT encoding=RLE, status BOOLEAN encoding=PLAIN compression=SNAPPY)
+
+创建包含一组对齐序列的元数据模板
+
+IoTDB> create schema template t2 aligned (lat FLOAT encoding=Gorilla, lon FLOAT encoding=Gorilla)
+
+### 挂载元数据模板
+
+IoTDB> set SCHEMA TEMPLATE t1 to root.sg1
+
+### 激活元数据模板
+
+IoTDB> create timeseries using SCHEMA TEMPLATE on root.sg1.d1
+
+IoTDB> set SCHEMA TEMPLATE t1 to root.sg1.d1
+
+IoTDB> set SCHEMA TEMPLATE t2 to root.sg1.d2
+
+IoTDB> create timeseries using schema template on root.sg1.d1
+
+IoTDB> create timeseries using schema template on root.sg1.d2
+
+### 查看元数据模板
+
+IoTDB> show schema templates
+
+- 查看某个元数据模板下的物理量
+
+IoTDB> show nodes in schema template t1
+
+- 查看挂载了某个元数据模板的路径
+
+IoTDB> show paths set schema template t1
+
+- 查看使用了某个元数据模板的路径(即模板在该路径上已激活,序列已创建)
+
+IoTDB> show paths using schema template t1
+
+IoTDB> show devices using schema template t1
+
+### 解除元数据模板
+
+IoTDB> delete timeseries of schema template t1 from root.sg1.d1
+
+IoTDB> deactivate schema template t1 from root.sg1.d1
+
+批量处理
+
+IoTDB> delete timeseries of schema template t1 from root.sg1.*, root.sg2.*
+
+IoTDB> deactivate schema template t1 from root.sg1.*, root.sg2.*
+
+### 卸载元数据模板
+
+IoTDB> unset schema template t1 from root.sg1.d1
+
+### 删除元数据模板
+
+IoTDB> drop schema template t1
+
+## 5、数据存活时间管理
+
+### 设置 TTL
+
+IoTDB> set ttl to root.ln 3600000
+
+IoTDB> set ttl to root.sgcc.** 3600000
+
+IoTDB> set ttl to root.** 3600000
+
+### 取消 TTL
+
+IoTDB> unset ttl to root.ln
+
+IoTDB> unset ttl to root.sgcc.**
+
+IoTDB> unset ttl to root.**
+
+### 显示 TTL
+
+IoTDB> SHOW ALL TTL
+
+IoTDB> SHOW TTL ON StorageGroupNames
+
+# 写入数据
+
+## 1、写入单列数据
+
+IoTDB > insert into root.ln.wf02.wt02(timestamp,status) values(1,true)
+
+IoTDB > insert into root.ln.wf02.wt02(timestamp,hardware) values(1, 'v1'),(2, 'v1')
+
+## 2、写入多列数据
+
+IoTDB > insert into root.ln.wf02.wt02(timestamp, status, hardware) values (2, false, 'v2')
+
+IoTDB > insert into root.ln.wf02.wt02(timestamp, status, hardware) VALUES (3, false, 'v3'),(4, true, 'v4')
+
+## 3、使用服务器时间戳
+
+IoTDB > insert into root.ln.wf02.wt02(status, hardware) values (false, 'v2')
+
+## 4、写入对齐时间序列数据
+
+IoTDB > create aligned timeseries root.sg1.d1(s1 INT32, s2 DOUBLE)
+
+IoTDB > insert into root.sg1.d1(timestamp, s1, s2) aligned values(1, 1, 1)
+
+IoTDB > insert into root.sg1.d1(timestamp, s1, s2) aligned values(2, 2, 2), (3, 3, 3)
+
+IoTDB > select * from root.sg1.d1
+
+## 5、加载 TsFile 文件数据
+
+load '<path/dir>' [sglevel=int][verify=true/false][onSuccess=delete/none]
+
+### 通过指定文件路径(绝对路径)加载单 tsfile 文件
+
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile'`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' sglevel=1`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' onSuccess=delete`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true sglevel=1`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false sglevel=1`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=true onSuccess=none`
+- `load '/Users/Desktop/data/1575028885956-101-0.tsfile' verify=false sglevel=1 onSuccess=delete`
+
+### 通过指定文件夹路径(绝对路径)批量加载文件
+
+- `load '/Users/Desktop/data'`
+- `load '/Users/Desktop/data' verify=false`
+- `load '/Users/Desktop/data' verify=true`
+- `load '/Users/Desktop/data' verify=true sglevel=1`
+- `load '/Users/Desktop/data' verify=false sglevel=1 onSuccess=delete`
+
+# 删除数据
+
+## 1、删除单列数据
+
+delete from root.ln.wf02.wt02.status where time<=2017-11-01T16:26:00;
+
+delete from root.ln.wf02.wt02.status where time>=2017-01-01T00:00:00 and time<=2017-11-01T16:26:00;
+
+delete from root.ln.wf02.wt02.status where time < 10
+
+delete from root.ln.wf02.wt02.status where time <= 10
+
+delete from root.ln.wf02.wt02.status where time < 20 and time > 10
+
+delete from root.ln.wf02.wt02.status where time <= 20 and time >= 10
+
+delete from root.ln.wf02.wt02.status where time > 20
+
+delete from root.ln.wf02.wt02.status where time >= 20
+
+delete from root.ln.wf02.wt02.status where time = 20
+
+出错:
+
+delete from root.ln.wf02.wt02.status where time > 4 or time < 0
+
+Msg: 303: Check metadata error: For delete statement, where clause can only contain atomic
+
+expressions like : time > XXX, time <= XXX, or two atomic expressions connected by 'AND'
+
+删除时间序列中的所有数据:
+
+delete from root.ln.wf02.wt02.status
+
+## 2、删除多列数据
+
+delete from root.ln.wf02.wt02.* where time <= 2017-11-01T16:26:00;
+
+声明式的编程方式:
+
+IoTDB> delete from root.ln.wf03.wt02.status where time < now()
+
+Msg: The statement is executed successfully.
+
+# 数据查询
+
+## 1、基础查询
+
+### 时间过滤查询
+
+select temperature from root.ln.wf01.wt01 where time < 2017-11-01T00:08:00.000
+
+### 根据一个时间区间选择多列数据
+
+select status, temperature from root.ln.wf01.wt01 where time > 2017-11-01T00:05:00.000 and time < 2017-11-01T00:12:00.000;
+
+### 按照多个时间区间选择同一设备的多列数据
+
+select status, temperature from root.ln.wf01.wt01 where (time > 2017-11-01T00:05:00.000 and time < 2017-11-01T00:12:00.000) or (time >= 2017-11-01T16:35:00.000 and time <= 2017-11-01T16:37:00.000);
+
+### 按照多个时间区间选择不同设备的多列数据
+
+select wf01.wt01.status, wf02.wt02.hardware from root.ln where (time > 2017-11-01T00:05:00.000 and time < 2017-11-01T00:12:00.000) or (time >= 2017-11-01T16:35:00.000 and time <= 2017-11-01T16:37:00.000);
+
+### 根据时间降序返回结果集
+
+select * from root.ln.** where time > 1 order by time desc limit 10;
+
+## 2、选择表达式
+
+### 使用别名
+
+select s1 as temperature, s2 as speed from root.ln.wf01.wt01;
+
+### 运算符
+
+### 函数
+
+不支持:
+
+select s1, count(s1) from root.sg.d1;
+
+select sin(s1), count(s1) from root.sg.d1;
+
+select s1, count(s1) from root.sg.d1 group by ([10,100),10ms);
+
+#### 时间序列查询嵌套表达式
+
+示例 1:
+
+select a,
+
+ b,
+
+ ((a + 1) * 2 - 1) % 2 + 1.5,
+
+ sin(a + sin(a + sin(b))),
+
+ -(a + b) * (sin(a + b) * sin(a + b) + cos(a + b) * cos(a + b)) + 1
+
+from root.sg1;
+
+示例 2:
+
+select (a + b) * 2 + sin(a) from root.sg
+
+示例 3:
+
+select (a + *) / 2 from root.sg1
+
+示例 4:
+
+select (a + b) * 3 from root.sg, root.ln
+
+#### 聚合查询嵌套表达式
+
+示例 1:
+
+select avg(temperature),
+
+ sin(avg(temperature)),
+
+ avg(temperature) + 1,
+
+ -sum(hardware),
+
+ avg(temperature) + sum(hardware)
+
+from root.ln.wf01.wt01;
+
+示例 2:
+
+select avg(*),
+
+ (avg(*) + 1) * 3 / 2 -1
+
+from root.sg1
+
+示例 3:
+
+select avg(temperature),
+
+ sin(avg(temperature)),
+
+ avg(temperature) + 1,
+
+ -sum(hardware),
+
+ avg(temperature) + sum(hardware) as custom_sum
+
+from root.ln.wf01.wt01
+
+GROUP BY([10, 90), 10ms);
+
+## 3、最新点查询
+
+SQL 语法:
+
+```Go
+select last <Path> [COMMA <Path>]* from < PrefixPath > [COMMA < PrefixPath >]* <whereClause> [ORDER BY TIMESERIES (DESC | ASC)?]
+```
+
+查询 root.ln.wf01.wt01.status 的最新数据点
+
+IoTDB> select last status from root.ln.wf01.wt01
+
+查询 root.ln.wf01.wt01 下 status,temperature 时间戳大于等于 2017-11-07T23:50:00 的最新数据点
+
+IoTDB> select last status, temperature from root.ln.wf01.wt01 where time >= 2017-11-07T23:50:00
+
+ 查询 root.ln.wf01.wt01 下所有序列的最新数据点,并按照序列名降序排列
+
+IoTDB> select last * from root.ln.wf01.wt01 order by timeseries desc;
+
+## 4、查询对齐模式
+
+### 按设备对齐
+
+select * from root.ln.** where time <= 2017-11-01T00:01:00 align by device;
+
+### 设备对齐模式下的排序
+
+#### 时间对齐模式下的排序
+
+select * from root.ln.** where time <= 2017-11-01T00:01:00 order by time desc;
+
+#### 设备对齐模式下的排序
+
+select * from root.ln.** where time <= 2017-11-01T00:01:00 order by device desc,time asc align by device;
+
+在时间戳相等时按照设备名排序
+
+select * from root.ln.** where time <= 2017-11-01T00:01:00 order by time asc,device desc align by device;
+
+没有显式指定时
+
+select * from root.ln.** where time <= 2017-11-01T00:01:00 align by device;
+
+对聚合后的结果进行排序
+
+select count(*) from root.ln.** group by ((2017-11-01T00:00:00.000+08:00,2017-11-01T00:03:00.000+08:00],1m) order by device asc,time asc align by device
+
+## 5、查询过滤条件
+
+选择时间戳大于 2022-01-01T00:05:00.000 的数据:
+
+select s1 from root.sg1.d1 where time > 2022-01-01T00:05:00.000;
+
+选择时间戳等于 2022-01-01T00:05:00.000 的数据:
+
+select s1 from root.sg1.d1 where time = 2022-01-01T00:05:00.000;
+
+选择时间区间 [2017-11-01T00:05:00.000, 2017-11-01T00:12:00.000) 内的数据:
+
+select s1 from root.sg1.d1 where time >= 2022-01-01T00:05:00.000 and time < 2017-11-01T00:12:00.000;
+
+### 值过滤条件
+
+选择值大于 36.5 的数据:
+
+select temperature from root.sg1.d1 where temperature > 36.5;
+
+选择值等于 true 的数据:
+
+select status from root.sg1.d1 where status = true;
+
+选择区间 [36.5,40] 内或之外的数据:
+
+select temperature from root.sg1.d1 where temperature between 36.5 and 40;
+
+select temperature from root.sg1.d1 where temperature not between 36.5 and 40;
+
+选择值在特定范围内的数据:
+
+select code from root.sg1.d1 where code in ('200', '300', '400', '500');
+
+选择值在特定范围外的数据:
+
+select code from root.sg1.d1 where code not in ('200', '300', '400', '500');
+
+选择值为空的数据:
+
+select code from root.sg1.d1 where temperature is null;
+
+选择值为非空的数据:
+
+select code from root.sg1.d1 where temperature is not null;
+
+### 模糊查询
+
+查询 `root.sg.d1` 下 `value` 含有`'cc'`的数据
+
+IoTDB> select * from root.sg.d1 where value like '%cc%'
+
+查询 `root.sg.d1` 下 `value` 中间为 `'b'`、前后为任意单个字符的数据
+
+IoTDB> select * from root.sg.device where value like '_b_'
+
+查询 root.sg.d1 下 value 值为26个英文字符组成的字符串
+
+IoTDB> select * from root.sg.d1 where value regexp '^[A-Za-z]+$'
+
+查询 root.sg.d1 下 value 值为26个小写英文字符组成的字符串且时间大于100的
+
+IoTDB> select * from root.sg.d1 where value regexp '^[a-z]+$' and time > 100
+
+## 6、分段分组聚合
+
+#### 未指定滑动步长的时间区间分组聚合查询
+
+select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017-11-01T00:00:00, 2017-11-07T23:00:00),1d);
+
+#### 指定滑动步长的时间区间分组聚合查询
+
+select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017-11-01 00:00:00, 2017-11-07 23:00:00), 3h, 1d);
+
+滑动步长可以小于聚合窗口
+
+select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017-11-01 00:00:00, 2017-11-01 10:00:00), 4h, 2h);
+
+#### 按照自然月份的时间区间分组聚合查询
+
+select count(status) from root.ln.wf01.wt01 where time > 2017-11-01T01:00:00 group by([2017-11-01T00:00:00, 2019-11-07T23:00:00), 1mo, 2mo);
+
+每个时间间隔窗口内都有数据
+
+select count(status) from root.ln.wf01.wt01 group by([2017-10-31T00:00:00, 2019-11-07T23:00:00), 1mo, 2mo);
+
+#### 左开右闭区间
+
+select count(status) from root.ln.wf01.wt01 group by ((2017-11-01T00:00:00, 2017-11-07T23:00:00],1d);
+
+#### 与分组聚合混合使用
+
+统计降采样后的数据点个数
+
+select count(status) from root.ln.wf01.wt01 group by ((2017-11-01T00:00:00, 2017-11-07T23:00:00],1d), level=1;
+
+加上滑动 Step 的降采样后的结果也可以汇总
+
+select count(status) from root.ln.wf01.wt01 group by ([2017-11-01 00:00:00, 2017-11-07 23:00:00), 3h, 1d), level=1;
+
+### 路径层级分组聚合
+
+统计不同 database 下 status 序列的数据点个数
+
+select count(status) from root.** group by level = 1
+
+ 统计不同设备下 status 序列的数据点个数
+
+select count(status) from root.** group by level = 3
+
+统计不同 database 下的不同设备中 status 序列的数据点个数
+
+select count(status) from root.** group by level = 1, 3
+
+查询所有序列下温度传感器 temperature 的最大值
+
+select max_value(temperature) from root.** group by level = 0
+
+查询某一层级下所有传感器拥有的总数据点数
+
+select count(*) from root.ln.** group by level = 2
+
+### 标签分组聚合
+
+#### 单标签聚合查询
+
+SELECT AVG(temperature) FROM root.factory1.** GROUP BY TAGS(city);
+
+#### 多标签聚合查询
+
+SELECT avg(temperature) FROM root.factory1.** GROUP BY TAGS(city, workshop);
+
+#### 基于时间区间的标签聚合查询
+
+SELECT AVG(temperature) FROM root.factory1.** GROUP BY ([1000, 10000), 5s), TAGS(city, workshop);
+
+### 差值分段聚合
+
+group by variation(controlExpression[,delta][,ignoreNull=true/false])
+
+#### delta=0时的等值事件分段
+
+select __endTime, avg(s1), count(s2), sum(s3) from root.sg.d group by variation(s6)
+
+指定ignoreNull为false
+
+select __endTime, avg(s1), count(s2), sum(s3) from root.sg.d group by variation(s6, ignoreNull=false)
+
+#### delta!=0时的差值事件分段
+
+select __endTime, avg(s1), count(s2), sum(s3) from root.sg.d group by variation(s6, 4)
+
+### 条件分段聚合
+
+group by condition(predict,[keep>/>=/=/<=/<]threshold,[,ignoreNull=true/false])
+
+查询至少连续两行以上的charging_status=1的数据
+
+select max_time(charging_status),count(vehicle_status),last_value(soc) from root.** group by condition(charging_status=1,KEEP>=2,ignoreNull=true)
+
+当设置`ignoreNull`为false时,遇到null值为将其视为一个不满足条件的行,得到结果原先的分组被含null的行拆分
+
+select max_time(charging_status),count(vehicle_status),last_value(soc) from root.** group by condition(charging_status=1,KEEP>=2,ignoreNull=false)
+
+### 会话分段聚合
+
+group by session(timeInterval)
+
+按照不同的时间单位设定时间间隔
+
+select __endTime,count(*) from root.** group by session(1d)
+
+和`HAVING`、`ALIGN BY DEVICE`共同使用
+
+select __endTime,sum(hardware) from root.ln.wf02.wt01 group by session(50s) having sum(hardware)>0 align by device
+
+## 点数分段聚合
+
+group by count(controlExpression, size[,ignoreNull=true/false])
+
+select count(charging_stauts), first_value(soc) from root.sg group by count(charging_status,5)
+
+当使用ignoreNull将null值也考虑进来
+
+select count(charging_stauts), first_value(soc) from root.sg group by count(charging_status,5,ignoreNull=false)
+
+## 7、聚合结果过滤
+
+不正确的:
+
+select count(s1) from root.** group by ([1,3),1ms) having sum(s1) > s1
+
+select count(s1) from root.** group by ([1,3),1ms) having s1 > 1
+
+select count(s1) from root.** group by ([1,3),1ms), level=1 having sum(d1.s1) > 1
+
+select count(d1.s1) from root.** group by ([1,3),1ms), level=1 having sum(s1) > 1
+
+SQL 示例:
+
+ select count(s1) from root.** group by ([1,11),2ms), level=1 having count(s2) > 2;
+
+ select count(s1), count(s2) from root.** group by ([1,11),2ms) having count(s2) > 1 align by device;
+
+## 8、结果集补空值
+
+FILL '(' PREVIOUS | LINEAR | constant ')'
+
+#### `PREVIOUS` 填充
+
+select temperature, status from root.sgcc.wf03.wt01 where time >= 2017-11-01T16:37:00.000 and time <= 2017-11-01T16:40:00.000 fill(previous);
+
+#### `LINEAR` 填充
+
+select temperature, status from root.sgcc.wf03.wt01 where time >= 2017-11-01T16:37:00.000 and time <= 2017-11-01T16:40:00.000 fill(linear);
+
+#### 常量填充
+
+select temperature, status from root.sgcc.wf03.wt01 where time >= 2017-11-01T16:37:00.000 and time <= 2017-11-01T16:40:00.000 fill(2.0);
+
+使用 `BOOLEAN` 类型的常量填充
+
+select temperature, status from root.sgcc.wf03.wt01 where time >= 2017-11-01T16:37:00.000 and time <= 2017-11-01T16:40:00.000 fill(true);
+
+## 9、查询结果分页
+
+### 按行分页
+
+ 基本的 `LIMIT` 子句
+
+select status, temperature from root.ln.wf01.wt01 limit 10
+
+带 `OFFSET` 的 `LIMIT` 子句
+
+select status, temperature from root.ln.wf01.wt01 limit 5 offset 3
+
+`LIMIT` 子句与 `WHERE` 子句结合
+
+select status,temperature from root.ln.wf01.wt01 where time > 2017-11-01T00:05:00.000 and time< 2017-11-01T00:12:00.000 limit 5 offset 3
+
+ `LIMIT` 子句与 `GROUP BY` 子句组合
+
+select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017-11-01T00:00:00, 2017-11-07T23:00:00),1d) limit 4 offset 3
+
+### 按列分页
+
+ 基本的 `SLIMIT` 子句
+
+select * from root.ln.wf01.wt01 where time > 2017-11-01T00:05:00.000 and time < 2017-11-01T00:12:00.000 slimit 1
+
+带 `SOFFSET` 的 `SLIMIT` 子句
+
+select * from root.ln.wf01.wt01 where time > 2017-11-01T00:05:00.000 and time < 2017-11-01T00:12:00.000 slimit 1 soffset 1
+
+`SLIMIT` 子句与 `GROUP BY` 子句结合
+
+select max_value(*) from root.ln.wf01.wt01 group by ([2017-11-01T00:00:00, 2017-11-07T23:00:00),1d) slimit 1 soffset 1
+
+`SLIMIT` 子句与 `LIMIT` 子句结合
+
+select * from root.ln.wf01.wt01 limit 10 offset 100 slimit 2 soffset 0
+
+## 10、查询写回(SELECT INTO)
+
+#### 整体描述
+
+selectIntoStatement
+
+ : SELECT
+
+ resultColumn [, resultColumn] ...
+
+ INTO intoItem [, intoItem] ...
+
+ FROM prefixPath [, prefixPath] ...
+
+ [WHERE whereCondition]
+
+ [GROUP BY groupByTimeClause, groupByLevelClause]
+
+ [FILL {PREVIOUS | LINEAR | constant}]
+
+ [LIMIT rowLimit OFFSET rowOffset]
+
+ [ALIGN BY DEVICE]
+
+ ;
+
+
+
+intoItem
+
+ : [ALIGNED] intoDevicePath '(' intoMeasurementName [',' intoMeasurementName]* ')'
+
+ ;
+
+按时间对齐,将 `root.sg` database 下四条序列的查询结果写入到 `root.sg_copy` database 下指定的四条序列中
+
+IoTDB> select s1, s2 into root.sg_copy.d1(t1), root.sg_copy.d2(t1, t2), root.sg_copy.d1(t2) from root.sg.d1, root.sg.d2;
+
+按时间对齐,将聚合查询的结果存储到指定序列中
+
+IoTDB> select count(s1 + s2), last_value(s2) into root.agg.count(s1_add_s2), root.agg.last_value(s2) from root.sg.d1 group by ([0, 100), 10ms);
+
+按设备对齐
+
+IoTDB> select s1, s2 into root.sg_copy.d1(t1, t2), root.sg_copy.d2(t1, t2) from root.sg.d1, root.sg.d2 align by device;
+
+按设备对齐,将表达式计算的结果存储到指定序列中
+
+IoTDB> select s1 + s2 into root.expr.add(d1s1_d1s2), root.expr.add(d2s1_d2s2) from root.sg.d1, root.sg.d2 align by device;
+
+#### 使用变量占位符
+
+##### 按时间对齐(默认)
+
+###### (1)目标设备不使用变量占位符 & 目标物理量列表使用变量占位符
+
+select s1, s2
+
+into root.sg_copy.d1(::), root.sg_copy.d2(s1), root.sg_copy.d1(${3}), root.sg_copy.d2(::)
+
+from root.sg.d1, root.sg.d2;
+
+该语句等价于:
+
+select s1, s2
+
+into root.sg_copy.d1(s1), root.sg_copy.d2(s1), root.sg_copy.d1(s2), root.sg_copy.d2(s2)
+
+from root.sg.d1, root.sg.d2;
+
+###### (2)目标设备使用变量占位符 & 目标物理量列表不使用变量占位符
+
+select d1.s1, d1.s2, d2.s3, d3.s4
+
+into ::(s1_1, s2_2), root.sg.d2_2(s3_3), root.${2}_copy.::(s4)
+
+from root.sg;
+
+###### (3)目标设备使用变量占位符 & 目标物理量列表使用变量占位符
+
+select * into root.sg_bk.::(::) from root.sg.**;
+
+##### 按设备对齐(使用 `ALIGN BY DEVICE`)
+
+###### (1)目标设备不使用变量占位符 & 目标物理量列表使用变量占位符
+
+select s1, s2, s3, s4
+
+into root.backup_sg.d1(s1, s2, s3, s4), root.backup_sg.d2(::), root.sg.d3(backup_${4})
+
+from root.sg.d1, root.sg.d2, root.sg.d3
+
+align by device;
+
+###### (2)目标设备使用变量占位符 & 目标物理量列表不使用变量占位符
+
+select avg(s1), sum(s2) + sum(s3), count(s4)
+
+into root.agg_${2}.::(avg_s1, sum_s2_add_s3, count_s4)
+
+from root.**
+
+align by device;
+
+###### (3)目标设备使用变量占位符 & 目标物理量列表使用变量占位符
+
+select * into ::(backup_${4}) from root.sg.** align by device;
+
+#### 指定目标序列为对齐序列
+
+select s1, s2 into root.sg_copy.d1(t1, t2), aligned root.sg_copy.d2(t1, t2) from root.sg.d1, root.sg.d2 align by device;
+
+## 11、连续查询(Continuous Query, CQ)
+
+### 语法
+
+```Go
+CREATE (CONTINUOUS QUERY | CQ) <cq_id>
+[RESAMPLE
+ [EVERY <every_interval>]
+ [BOUNDARY <execution_boundary_time>]
+ [RANGE <start_time_offset>[, end_time_offset]]
+]
+[TIMEOUT POLICY BLOCKED|DISCARD]
+BEGIN
+ SELECT CLAUSE
+ INTO CLAUSE
+ FROM CLAUSE
+ [WHERE CLAUSE]
+ [GROUP BY(<group_by_interval>[, <sliding_step>]) [, level = <level>]]
+ [HAVING CLAUSE]
+ [FILL {PREVIOUS | LINEAR | constant}]
+ [LIMIT rowLimit OFFSET rowOffset]
+ [ALIGN BY DEVICE]
+END
+```
+
+#### 配置连续查询执行的周期性间隔
+
+CREATE CONTINUOUS QUERY cq1
+
+RESAMPLE EVERY 20s
+
+BEGIN
+
+ SELECT max_value(temperature)
+
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+
+ FROM root.ln.*.*
+
+ GROUP BY(10s)
+
+END
+
+
+
+\> SELECT temperature_max from root.ln.*.*;
+
+#### 配置连续查询的时间窗口大小
+
+CREATE CONTINUOUS QUERY cq2
+
+RESAMPLE RANGE 40s
+
+BEGIN
+
+ SELECT max_value(temperature)
+
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+
+ FROM root.ln.*.*
+
+ GROUP BY(10s)
+
+END
+
+
+
+\> SELECT temperature_max from root.ln.*.*;
+
+#### 同时配置连续查询执行的周期性间隔和时间窗口大小
+
+CREATE CONTINUOUS QUERY cq3
+
+RESAMPLE EVERY 20s RANGE 40s
+
+BEGIN
+
+ SELECT max_value(temperature)
+
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+
+ FROM root.ln.*.*
+
+ GROUP BY(10s)
+
+ FILL(100.0)
+
+END
+
+
+
+\> SELECT temperature_max from root.ln.*.*;
+
+#### 配置连续查询每次查询执行时间窗口的结束时间
+
+CREATE CONTINUOUS QUERY cq4
+
+RESAMPLE EVERY 20s RANGE 40s, 20s
+
+BEGIN
+
+ SELECT max_value(temperature)
+
+ INTO root.ln.wf02.wt02(temperature_max), root.ln.wf02.wt01(temperature_max), root.ln.wf01.wt02(temperature_max), root.ln.wf01.wt01(temperature_max)
+
+ FROM root.ln.*.*
+
+ GROUP BY(10s)
+
+ FILL(100.0)
+
+END
+
+
+
+\> SELECT temperature_max from root.ln.*.*;
+
+#### 没有GROUP BY TIME子句的连续查询
+
+CREATE CONTINUOUS QUERY cq5
+
+RESAMPLE EVERY 20s
+
+BEGIN
+
+ SELECT temperature + 1
+
+ INTO root.precalculated_sg.::(temperature)
+
+ FROM root.ln.*.*
+
+ align by device
+
+END
+
+
+
+\> SELECT temperature from root.precalculated_sg.*.* align by device;
+
+### 连续查询的管理
+
+#### 查询系统已有的连续查询
+
+展示集群中所有的已注册的连续查询
+
+SHOW (CONTINUOUS QUERIES | CQS)
+
+SHOW CONTINUOUS QUERIES;
+
+#### 删除已有的连续查询
+
+删除指定的名为cq_id的连续查询:
+
+```Go
+DROP (CONTINUOUS QUERY | CQ) <cq_id>
+```
+
+DROP CONTINUOUS QUERY s1_count_cq;
+
+#### 作为子查询的替代品
+
+\1. 创建一个连续查询
+
+CREATE CQ s1_count_cq
+
+BEGIN
+
+ SELECT count(s1)
+
+ INTO root.sg_count.d.count_s1
+
+ FROM root.sg.d
+
+ GROUP BY(30m)
+
+END
+
+1. 查询连续查询的结果
+
+SELECT avg(count_s1) from root.sg_count.d;
+
+# 运算符和函数
+
+## 1、用户自定义函数
+
+##### UDFParameters
+
+SELECT UDF(s1, s2, 'key1'='iotdb', 'key2'='123.45') FROM root.sg.d;
+
+### UDF 注册
+
+```Go
+CREATE FUNCTION <UDF-NAME> AS <UDF-CLASS-FULL-PATHNAME> (USING URI URI-STRING)?
+```
+
+##### 不指定URI
+
+CREATE FUNCTION example AS 'org.apache.iotdb.udf.UDTFExample'
+
+##### 指定URI
+
+CREATE FUNCTION example AS 'org.apache.iotdb.udf.UDTFExample' USING URI 'http://jar/example.jar'
+
+### UDF 卸载
+
+```Go
+DROP FUNCTION <UDF-NAME>
+```
+
+DROP FUNCTION example
+
+### UDF 查询
+
+#### 带自定义输入参数的查询
+
+SELECT example(s1, 'key1'='value1', 'key2'='value2'), example(*, 'key3'='value3') FROM root.sg.d1;
+
+SELECT example(s1, s2, 'key1'='value1', 'key2'='value2') FROM root.sg.d1;
+
+#### 与其他查询的嵌套查询
+
+SELECT s1, s2, example(s1, s2) FROM root.sg.d1;
+
+SELECT *, example(*) FROM root.sg.d1 DISABLE ALIGN;
+
+SELECT s1 * example(* / s1 + s2) FROM root.sg.d1;
+
+SELECT s1, s2, s1 + example(s1, s2), s1 - example(s1 + example(s1, s2) / s2) FROM root.sg.d1;
+
+### 查看所有注册的 UDF
+
+SHOW FUNCTIONS
+
+## 2、聚合函数
+
+### COUNT_IF
+
+语法
+
+count_if(predicate, [keep >=/>/=/!=/</<=]threshold[, 'ignoreNull'='true/false'])
+
+##### 不使用ignoreNull参数(忽略null)
+
+select count_if(s1=0 & s2=0, 3), count_if(s1=1 & s2=0, 3) from root.db.d1
+
+##### 使用ignoreNull参数
+
+select count_if(s1=0 & s2=0, 3, 'ignoreNull'='false'), count_if(s1=1 & s2=0, 3, 'ignoreNull'='false') from root.db.d1
+
+## TIME_DURATION
+
+语法
+
+ time_duration(Path)
+
+示例
+
+select time_duration(s1) from root.db.d1
+
+## 3、算数运算符和函数
+
+### 算数运算符
+
+select s1, - s1, s2, + s2, s1 + s2, s1 - s2, s1 * s2, s1 / s2, s1 % s2 from root.sg.d1
+
+### 数学函数
+
+select s1, sin(s1), cos(s1), tan(s1) from root.sg1.d1 limit 5 offset 1000;
+
+#### ROUND
+
+select s4,round(s4),round(s4,2),round(s4,-1) from root.sg1.d1
+
+## 4、比较运算符和函数
+
+### 基本比较运算符
+
+select a, b, a > 10, a <= b, !(a <= b), a > 10 && a > b from root.test;
+
+### `BETWEEN ... AND ...` 运算符
+
+select temperature from root.sg1.d1 where temperature between 36.5 and 40;
+
+select temperature from root.sg1.d1 where temperature not between 36.5 and 40;
+
+### 模糊匹配运算符
+
+ 查询 `root.sg.d1` 下 `value` 含有`'cc'`的数据
+
+select * from root.sg.d1 where value like '%cc%'
+
+查询 `root.sg.d1` 下 `value` 中间为 `'b'`、前后为任意单个字符的数据
+
+select * from root.sg.device where value like '_b_'
+
+#### 使用 `Regexp` 进行模糊匹配
+
+ 查询 root.sg.d1 下 value 值为26个英文字符组成的字符串
+
+select * from root.sg.d1 where value regexp '^[A-Za-z]+$'
+
+查询 root.sg.d1 下 value 值为26个小写英文字符组成的字符串且时间大于100的
+
+select * from root.sg.d1 where value regexp '^[a-z]+$' and time > 100
+
+
+
+select b, b like '1%', b regexp '[0-2]' from root.test
+
+`IS NULL` 运算符
+
+选择值为空的数据:
+
+select code from root.sg1.d1 where temperature is null;
+
+选择值为非空的数据:
+
+select code from root.sg1.d1 where temperature is not null;
+
+`IN` 运算符
+
+选择值在特定范围内的数据:
+
+select code from root.sg1.d1 where code in ('200', '300', '400', '500');
+
+选择值在特定范围外的数据:
+
+select code from root.sg1.d1 where code not in ('200', '300', '400', '500');
+
+
+
+select a, a in (1, 2) from root.test;
+
+### 条件函数
+
+select ts, on_off(ts, 'threshold'='2') from root.test;
+
+select ts, in_range(ts, 'lower'='2', 'upper'='3.1') from root.test;
+
+## 5、逻辑运算符
+
+select a, b, a > 10, a <= b, !(a <= b), a > 10 && a > b from root.test;
+
+## 6、字符串处理
+
+### STRING_CONTAINS
+
+select s1, string_contains(s1, 's'='warn') from root.sg1.d4;
+
+### STRING_MATCHES
+
+select s1, string_matches(s1, 'regex'='[^\\s]+37229') from root.sg1.d4;
+
+### Length
+
+select s1, length(s1) from root.sg1.d1
+
+### Locate
+
+select s1, locate(s1, "target"="1") from root.sg1.d1
+
+select s1, locate(s1, "target"="1", "reverse"="true") from root.sg1.d1
+
+### StartsWith
+
+select s1, startswith(s1, "target"="1") from root.sg1.d1
+
+### EndsWith
+
+select s1, endswith(s1, "target"="1") from root.sg1.d1
+
+### Concat
+
+select s1, s2, concat(s1, s2, "target1"="IoT", "target2"="DB") from root.sg1.d1
+
+select s1, s2, concat(s1, s2, "target1"="IoT", "target2"="DB", "series_behind"="true") from root.sg1.d1
+
+### Substring
+
+select s1, substring(s1 from 1 for 2) from root.sg1.d1
+
+### Replace
+
+select s1, replace(s1, 'es', 'tt') from root.sg1.d1
+
+### Upper
+
+select s1, upper(s1) from root.sg1.d1
+
+### Lower
+
+select s1, lower(s1) from root.sg1.d1
+
+### Trim
+
+select s3, trim(s3) from root.sg1.d1
+
+### StrCmp
+
+select s1, s2, strcmp(s1, s2) from root.sg1.d1
+
+### StrReplace
+
+select strreplace(s1, "target"=",", "replace"="/", "limit"="2") from root.test.d1
+
+select strreplace(s1, "target"=",", "replace"="/", "limit"="1", "offset"="1", "reverse"="true") from root.test.d1
+
+### RegexMatch
+
+select regexmatch(s1, "regex"="\d+\.\d+\.\d+\.\d+", "group"="0") from root.test.d1
+
+### RegexReplace
+
+select regexreplace(s1, "regex"="192\.168\.0\.(\d+)", "replace"="cluster-$1", "limit"="1") from root.test.d1
+
+### RegexSplit
+
+select regexsplit(s1, "regex"=",", "index"="-1") from root.test.d1
+
+select regexsplit(s1, "regex"=",", "index"="3") from root.test.d1
+
+## 7、数据类型转换
+
+### CAST
+
+SELECT cast(s1 as INT32) from root.sg
+
+#### 使用示例
+
+cast BOOLEAN to other types
+
+select cast(s5 as INT32), cast(s5 as INT64),cast(s5 as FLOAT),cast(s5 as DOUBLE), cast(s5 as TEXT) from root.sg.d1
+
+cast TEXT to numeric types
+
+select cast(s6 as INT32), cast(s6 as INT64), cast(s6 as FLOAT), cast(s6 as DOUBLE) from root.sg.d1 where time < 2
+
+cast TEXT to BOOLEAN
+
+select cast(s6 as BOOLEAN) from root.sg.d1 where time >= 2
+
+## 8、常序列生成函数
+
+select s1, s2, const(s1, 'value'='1024', 'type'='INT64'), pi(s2), e(s1, s2) from root.sg1.d1;
+
+## 9、选择函数
+
+select s1, top_k(s1, 'k'='2'), bottom_k(s1, 'k'='2') from root.sg1.d2 where time > 2020-12-10T20:36:15.530+08:00;
+
+## 10、区间查询函数
+
+select s1, zero_count(s1), non_zero_count(s2), zero_duration(s3), non_zero_duration(s4) from root.sg.d2;
+
+## 11、趋势计算函数
+
+select s1, time_difference(s1), difference(s1), non_negative_difference(s1), derivative(s1), non_negative_derivative(s1) from root.sg1.d1 limit 5 offset 1000;
+
+##### 不使用ignoreNull参数(忽略null)
+
+SELECT DIFF(s1), DIFF(s2) from root.test;
+
+##### 使用ignoreNull参数
+
+SELECT DIFF(s1, 'ignoreNull'='false'), DIFF(s2, 'ignoreNull'='false') from root.test;
+
+## 12、采样函数
+
+### 等数量分桶随机采样
+
+select equal_size_bucket_random_sample(temperature,'proportion'='0.1') as random_sample from root.ln.wf01.wt01;
+
+### 等数量分桶聚合采样
+
+select equal_size_bucket_agg_sample(temperature, 'type'='avg','proportion'='0.1') as agg_avg, equal_size_bucket_agg_sample(temperature, 'type'='max','proportion'='0.1') as agg_max, equal_size_bucket_agg_sample(temperature,'type'='min','proportion'='0.1') as agg_min, equal_size_bucket_agg_sample(temperature, 'type'='sum','proportion'='0.1') as agg_sum, equal_size_bucket_agg_sample(temperature, 'type'='extreme','proportion'='0.1') as agg_extreme, equal_size_bucket_agg_sample(temperature, ' [...]
+
+### 等数量分桶 M4 采样
+
+select equal_size_bucket_m4_sample(temperature, 'proportion'='0.1') as M4_sample from root.ln.wf01.wt01;
+
+### 等数量分桶离群值采样
+
+select equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='avg', 'number'='2') as outlier_avg_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='stendis', 'number'='2') as outlier_stendis_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='cos', 'number'='2') as outlier_cos_sample, equal_size_bucket_outlier_sample(temperature, 'proportion'='0.1', 'type'='prenextdis', 'number'='2') as outlier_prenextdis_sam [...]
+
+## M4函数
+
+查询语句1:
+
+select M4(s1,'timeInterval'='25','displayWindowBegin'='0','displayWindowEnd'='100') from root.vehicle.d1
+
+查询语句2:
+
+select M4(s1,'windowSize'='10') from root.vehicle.d1
+
+使用Grafana的[模板变量](https://grafana.com/docs/grafana/latest/dashboards/variables/add-template-variables/#global-variables)
+
+select M4(s1,'timeInterval'='$__interval_ms') from root.sg1.d1
+
+## 13、时间序列处理
+
+### CHANGE_POINTS
+
+select change_points(s1), change_points(s2), change_points(s3), change_points(s4), change_points(s5), change_points(s6) from root.testChangePoints.d1
+
+## 14、Lambda 表达式
+
+### JEXL 自定义函数
+
+select jexl(temperature, 'expr'='x -> {x + x}') as jexl1, jexl(temperature, 'expr'='x -> {x * 3}') as jexl2, jexl(temperature, 'expr'='x -> {x * x}') as jexl3, jexl(temperature, 'expr'='x -> {multiply(x, 100)}') as jexl4, jexl(temperature, st, 'expr'='(x, y) -> {x + y}') as jexl5, jexl(temperature, st, str, 'expr'='(x, y, z) -> {x + y + z}') as jexl6 from root.ln.wf01.wt01;
+
+## 15、条件表达式
+
+### CASE
+
+#### 语法示例
+
+- 格式1:
+
+ CASE
+
+ WHEN condition1 THEN expression1
+
+ [WHEN condition2 THEN expression2] ...
+
+ [ELSE expression_end]
+
+ END
+
+- 格式2:
+
+ CASE caseValue
+
+ WHEN whenValue1 THEN expression1
+
+ [WHEN whenValue2 THEN expression2] ...
+
+ [ELSE expression_end]
+
+ END
+
+##### 示例1
+
+select T, P, case
+
+when 1000<T and T<1050 and 1000000<P and P<1100000 then "good!"
+
+when T<=1000 or T>=1050 then "bad temperature"
+
+when P<=1000000 or P>=1100000 then "bad pressure"
+
+end as `result`
+
+from root.test1
+
+##### 示例2
+
+select str, case
+
+when str like "%cc%" then "has cc"
+
+when str like "%dd%" then "has dd"
+
+else "no cc and dd" end as `result`
+
+from root.test2
+
+##### 示例3:搭配聚合函数
+
+select
+
+count(case when x<=1 then 1 end) as `(-∞,1]`,
+
+count(case when 1<x and x<=3 then 1 end) as `(1,3]`,
+
+count(case when 3<x and x<=7 then 1 end) as `(3,7]`,
+
+count(case when 7<x then 1 end) as `(7,+∞)`
+
+from root.test3
+
+###### 非法:CASE表达式←聚合函数
+
+select case when x<=1 then avg(x) else sum(x) end from root.test3
+
+##### 示例4:格式2
+
+select x, case x when 1 then "one" when 2 then "two" else "other" end from root.test4
+
+##### 示例5:结果子句类型
+
+###### 非法:BOOLEAN与其它类型共存
+
+select x, case x when 1 then true when 2 then 2 end from root.test4
+
+###### 合法:只存在BOOLEAN类型
+
+select x, case x when 1 then true when 2 then false end as `result` from root.test4
+
+###### 非法:TEXT与其它类型共存
+
+select x, case x when 1 then 1 when 2 then "str" end from root.test4
+
+###### 合法:数值类型共存
+
+select x, case x
+
+when 1 then 1
+
+when 2 then 222222222222222
+
+when 3 then 3.3
+
+when 4 then 4.4444444444444
+
+end as `result`
+
+from root.test4
+
+## 16、数据画像
+
+### ACF
+
+select acf(s1) from root.test.d1 where time <= 2020-01-01 00:00:05
+
+### Distinct
+
+select distinct(s2) from root.test.d2
+
+### Histogram
+
+select histogram(s1,"min"="1","max"="20","count"="10") from root.test.d1
+
+### Integral
+
+select integral(s1) from root.test.d1 where time <= 2020-01-01 00:00:10
+
+#### 指定时间单位
+
+select integral(s1, "unit"="1m") from root.test.d1 where time <= 2020-01-01 00:00:10
+
+### IntegralAvg
+
+select integralavg(s1) from root.test.d1 where time <= 2020-01-01 00:00:10
+
+### Mad
+
+select mad(s0) from root.test
+
+##### 近似查询
+
+select mad(s0, "error"="0.01") from root.test
+
+### Median
+
+select median(s0, "error"="0.01") from root.test
+
+### MinMax
+
+select minmax(s1) from root.test
+
+### Mode
+
+select mode(s2) from root.test.d2
+
+### MvAvg
+
+select mvavg(s1, "window"="3") from root.test
+
+### PACF
+
+select pacf(s1, "lag"="5") from root.test
+
+### Percentile
+
+select percentile(s0, "rank"="0.2", "error"="0.01") from root.test
+
+### Quantile
+
+select quantile(s0, "rank"="0.2", "K"="800") from root.test
+
+### Period
+
+select period(s1) from root.test.d3
+
+### QLB
+
+select QLB(s1) from root.test.d1
+
+### Resample
+
+##### 上采样
+
+select resample(s1,'every'='5m','interp'='linear') from root.test.d1
+
+##### 下采样
+
+select resample(s1,'every'='30m','aggr'='first') from root.test.d1
+
+##### 指定重采样时间段
+
+select resample(s1,'every'='30m','start'='2021-03-06 15:00:00') from root.test.d1
+
+### Sample
+
+##### 蓄水池采样
+
+select sample(s1,'method'='reservoir','k'='5') from root.test.d1
+
+##### 等距采样
+
+select sample(s1,'method'='isometric','k'='5') from root.test.d1
+
+### Segment
+
+select segment(s1,"error"="0.1") from root.test
+
+### Skew
+
+select skew(s1) from root.test.d1
+
+### Spline
+
+select spline(s1, "points"="151") from root.test
+
+### Spread
+
+select spread(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+
+### Stddev
+
+select stddev(s1) from root.test.d1
+
+### ZScore
+
+select zscore(s1) from root.test
+
+## 17、异常检测
+
+### IQR
+
+select iqr(s1) from root.test
+
+### KSigma
+
+select ksigma(s1,"k"="1.0") from root.test.d1 where time <= 2020-01-01 00:00:30
+
+### LOF
+
+select lof(s1,s2) from root.test.d1 where time<1000
+
+##### 诊断一维时间序列
+
+select lof(s1, "method"="series") from root.test.d1 where time<1000
+
+### MissDetect
+
+select missdetect(s2,'minlen'='10') from root.test.d2
+
+### Range
+
+select range(s1,"lower_bound"="101.0","upper_bound"="125.0") from root.test.d1 where time <= 2020-01-01 00:00:30
+
+### TwoSidedFilter
+
+select TwoSidedFilter(s0, 'len'='5', 'threshold'='0.3') from root.test
+
+### Outlier
+
+select outlier(s1,"r"="5.0","k"="4","w"="10","s"="5") from root.test
+
+## 18、数据匹配
+
+### Cov
+
+select cov(s1,s2) from root.test.d2
+
+### Dtw
+
+select dtw(s1,s2) from root.test.d2
+
+### Pearson
+
+select pearson(s1,s2) from root.test.d2
+
+### PtnSym
+
+select ptnsym(s4, 'window'='5', 'threshold'='0') from root.test.d1
+
+### XCorr
+
+select xcorr(s1, s2) from root.test.d1 where time <= 2020-01-01 00:00:05
+
+## 19、频域分析
+
+### Conv
+
+select conv(s1,s2) from root.test.d2
+
+### Deconv
+
+##### 计算去卷积的商
+
+select deconv(s3,s2) from root.test.d2
+
+##### 计算去卷积的余数
+
+select deconv(s3,s2,'result'='remainder') from root.test.d2
+
+### DWT
+
+select dwt(s1,"method"="haar") from root.test.d1
+
+### FFT
+
+##### 等距傅里叶变换
+
+select fft(s1) from root.test.d1
+
+##### 等距傅里叶变换并压缩
+
+select fft(s1, 'result'='real', 'compress'='0.99'), fft(s1, 'result'='imag','compress'='0.99') from root.test.d1
+
+### HighPass
+
+select highpass(s1,'wpass'='0.45') from root.test.d1
+
+### IFFT
+
+select ifft(re, im, 'interval'='1m', 'start'='2021-01-01 00:00:00') from root.test.d1
+
+### LowPass
+
+select lowpass(s1,'wpass'='0.45') from root.test.d1
+
+## 20、数据质量
+
+### Completeness
+
+###### 参数缺省
+
+select completeness(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+
+###### 指定窗口大小
+
+select completeness(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+
+### Consistency
+
+###### 参数缺省
+
+select consistency(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+
+###### 指定窗口大小
+
+select consistency(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+
+### Timeliness
+
+###### 参数缺省
+
+select timeliness(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+
+###### 指定窗口大小
+
+select timeliness(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+
+### Validity
+
+###### 参数缺省
+
+select validity(s1) from root.test.d1 where time <= 2020-01-01 00:00:30
+
+###### 指定窗口大小
+
+select validity(s1,"window"="15") from root.test.d1 where time <= 2020-01-01 00:01:00
+
+### Accuracy
+
+select Accuracy(t1,t2,t3,m1,m2,m3) from root.test
+
+## 21、数据修复
+
+### TimestampRepair
+
+##### 指定标准时间间隔
+
+select timestamprepair(s1,'interval'='10000') from root.test.d2
+
+##### 自动推算标准时间间隔
+
+select timestamprepair(s1) from root.test.d2
+
+### ValueFill
+
+##### 使用 linear 方法进行填补
+
+select valuefill(s1) from root.test.d2
+
+##### 使用 previous 方法进行填补
+
+select valuefill(s1,"method"="previous") from root.test.d2
+
+### ValueRepair
+
+##### 使用 Screen 方法进行修复
+
+select valuerepair(s1) from root.test.d2
+
+##### 使用 LsGreedy 方法进行修复
+
+select valuerepair(s1,'method'='LsGreedy') from root.test.d2
+
+### MasterRepair
+
+select MasterRepair(t1,t2,t3,m1,m2,m3) from root.test
+
+### SeasonalRepair
+
+##### 使用经典分解方法进行修复
+
+select seasonalrepair(s1,'period'=3,'k'=2) from root.test.d2
+
+##### 使用改进的分解方法进行修复
+
+select seasonalrepair(s1,'method'='improved','period'=3) from root.test.d2
+
+## 22、序列发现
+
+### ConsecutiveSequences
+
+##### 手动指定标准时间间隔
+
+select consecutivesequences(s1,s2,'gap'='5m') from root.test.d1
+
+##### 自动估计标准时间间隔
+
+select consecutivesequences(s1,s2) from root.test.d1
+
+### ConsecutiveWindows
+
+select consecutivewindows(s1,s2,'length'='10m') from root.test.d1
+
+## 23、机器学习
+
+### AR
+
+select ar(s0,"p"="2") from root.test.d0
+
+### Representation
+
+select representation(s0,"tb"="3","vb"="2") from root.test.d0
+
+### RM
+
+select rm(s0, s1,"tb"="3","vb"="2") from root.test.d0
+
+# 管理触发器
+
+## 1、使用 SQL 语句注册该触发器
+
+// Create Trigger
+
+createTrigger
+
+ : CREATE triggerType TRIGGER triggerName=identifier triggerEventClause ON pathPattern AS className=STRING_LITERAL uriClause? triggerAttributeClause?
+
+ ;
+
+
+
+triggerType
+
+ : STATELESS | STATEFUL
+
+ ;
+
+
+
+triggerEventClause
+
+ : (BEFORE | AFTER) INSERT
+
+ ;
+
+
+
+uriClause
+
+ : USING URI uri
+
+ ;
+
+
+
+uri
+
+ : STRING_LITERAL
+
+ ;
+
+
+
+triggerAttributeClause
+
+ : WITH LR_BRACKET triggerAttribute (COMMA triggerAttribute)* RR_BRACKET
+
+ ;
+
+
+
+triggerAttribute
+
+ : key=attributeKey operator_eq value=attributeValue
+
+ ;
+
+### SQL 语句示例:
+
+CREATE STATELESS TRIGGER triggerTest
+
+BEFORE INSERT
+
+ON root.sg.**
+
+AS 'org.apache.iotdb.trigger.ClusterAlertingExample'
+
+USING URI 'http://jar/ClusterAlertingExample.jar'
+
+WITH (
+
+ "name" = "trigger",
+
+ "limit" = "100"
+
+)
+
+## 2、卸载触发器
+
+### 卸载触发器的 SQL 语法如下:
+
+// Drop Trigger
+
+dropTrigger
+
+ : DROP TRIGGER triggerName=identifier
+
+;
+
+### 示例语句:
+
+DROP TRIGGER triggerTest1
+
+## 查询触发器
+
+SHOW TRIGGERS
+
+# 权限管理
+
+## 1、创建用户
+
+CREATE USER `ln_write_user` 'write_pwd'
+
+CREATE USER `sgcc_write_user` 'write_pwd'
+
+## 2、展示用户
+
+LIST USER
+
+## 3、赋予用户权限
+
+INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+
+系统不允许用户进行此操作,会提示错误:
+
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp,status) values(1509465600000,true)
+
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+
+用root用户分别赋予他们向对应 database 数据的写入权限
+
+GRANT USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+
+GRANT USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+
+GRANT USER `ln_write_user` PRIVILEGES CREATE_USER
+
+使用ln_write_user再尝试写入数据
+
+IoTDB> INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+
+Msg: The statement is executed successfully.
+
+## 4、撤销用户权限
+
+用root用户撤销ln_write_user和sgcc_write_user的权限:
+
+REVOKE USER `ln_write_user` PRIVILEGES INSERT_TIMESERIES on root.ln.**
+
+REVOKE USER `sgcc_write_user` PRIVILEGES INSERT_TIMESERIES on root.sgcc1.**, root.sgcc2.**
+
+REVOKE USER `ln_write_user` PRIVILEGES CREATE_USER
+
+撤销权限后,ln_write_user就没有向root.ln.**写入数据的权限了
+
+INSERT INTO root.ln.wf01.wt01(timestamp, status) values(1509465600000, true)
+
+Msg: 602: No permissions for this operation, please add privilege INSERT_TIMESERIES.
+
+### 5、SQL 语句
+
+- 创建用户
+
+```Go
+CREATE USER <userName> <password>;
+```
+
+Eg: IoTDB > CREATE USER `thulab` 'passwd';
+
+- 删除用户
+
+```Go
+DROP USER <userName>;
+```
+
+Eg: IoTDB > DROP USER `xiaoming`;
+
+- 创建角色
+
+```Go
+CREATE ROLE <roleName>;
+```
+
+Eg: IoTDB > CREATE ROLE `admin`;
+
+- 删除角色
+
+```Go
+DROP USER <userName>;
+```
+
+Eg: IoTDB > DROP USER `xiaoming`;
+
+- 赋予用户权限
+
+```Go
+GRANT USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+```
+
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES on root.ln.**, root.sgcc.**;
+
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES CREATE_ROLE;
+
+- 赋予用户全部的权限
+
+```Go
+GRANT USER <userName> PRIVILEGES ALL;
+```
+
+Eg: IoTDB > GRANT USER `tempuser` PRIVILEGES ALL;
+
+- 赋予角色权限
+
+```Go
+GRANT ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+```
+
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES INSERT_TIMESERIES, DELETE_TIMESERIES ON root.sgcc.**, root.ln.**;
+
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES CREATE_ROLE;
+
+- 赋予角色全部的权限
+
+```Go
+GRANT ROLE <roleName> PRIVILEGES ALL;
+```
+
+Eg: IoTDB > GRANT ROLE `temprole` PRIVILEGES ALL;
+
+- 赋予用户角色
+
+```Go
+GRANT <roleName> TO <userName>;
+```
+
+Eg: IoTDB > GRANT `temprole` TO tempuser;
+
+- 撤销用户权限
+
+```Go
+REVOKE USER <userName> PRIVILEGES <privileges> ON <nodeNames>;
+```
+
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES DELETE_TIMESERIES on root.ln.**;
+
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES CREATE_ROLE;
+
+- 移除用户所有权限
+
+```Go
+REVOKE USER <userName> PRIVILEGES ALL;
+```
+
+Eg: IoTDB > REVOKE USER `tempuser` PRIVILEGES ALL;
+
+- 撤销角色权限
+
+```Go
+REVOKE ROLE <roleName> PRIVILEGES <privileges> ON <nodeNames>;
+```
+
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES DELETE_TIMESERIES ON root.ln.**;
+
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES CREATE_ROLE;
+
+- 撤销角色全部的权限
+
+```Go
+REVOKE ROLE <roleName> PRIVILEGES ALL;
+```
+
+Eg: IoTDB > REVOKE ROLE `temprole` PRIVILEGES ALL;
+
+- 撤销用户角色
+
+```Go
+REVOKE <roleName> FROM <userName>;
+```
+
+Eg: IoTDB > REVOKE `temprole` FROM tempuser;
+
+- 列出所有用户
+
+LIST USER
+
+Eg: IoTDB > LIST USER
+
+- 列出指定角色下所有用户
+
+```Go
+LIST USER OF ROLE <roleName>;
+```
+
+Eg: IoTDB > LIST USER OF ROLE `roleuser`;
+
+- 列出所有角色
+
+```Go
+REVOKE <roleName> FROM <userName>;
+```
+
+Eg: IoTDB > REVOKE `temprole` FROM tempuser;
+
+- 列出指定用户下所有角色
+
+```Go
+LIST USER OF ROLE <roleName>;
+```
+
+Eg: IoTDB > LIST USER OF ROLE `roleuser`;
+
+- 列出用户所有权限
+
+```Go
+LIST PRIVILEGES USER <username>;
+```
+
+Eg: IoTDB > LIST PRIVILEGES USER `tempuser`;
+
+- 列出用户在具体路径上相关联的权限
+
+```Go
+LIST PRIVILEGES USER <username> ON <paths>;
+```
+
+Eg: IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.**, root.ln.wf01.**;
+
+IoTDB> LIST PRIVILEGES USER `tempuser` ON root.ln.wf01.wt01.**;
+
+- 列出角色所有权限
+
+```Go
+LIST PRIVILEGES ROLE <roleName>;
+```
+
+Eg: IoTDB > LIST PRIVILEGES ROLE `actor`;
+
+- 列出角色在具体路径上相关联的权限
+
+```Go
+LIST PRIVILEGES ROLE <roleName> ON <paths>;
+```
+
+Eg: IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.**, root.ln.wf01.wt01.**;
+
+IoTDB> LIST PRIVILEGES ROLE `temprole` ON root.ln.wf01.wt01.**;
+
+- 更新密码
+
+```Go
+ALTER USER <username> SET PASSWORD <password>;
+```
+
+Eg: IoTDB > ALTER USER `tempuser` SET PASSWORD 'newpwd';
+
+### 6、非root用户限制进行的操作
+
+###### TsFile管理
+
+- 加载TsFile
+
+Eg: IoTDB > load '/Users/Desktop/data/1575028885956-101-0.tsfile'
+
+- 删除TsFile文件
+
+Eg: IoTDB > remove '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile'
+
+- 卸载TsFile文件到指定目录
+
+Eg: IoTDB > unload '/Users/Desktop/data/data/root.vehicle/0/0/1575028885956-101-0.tsfile' '/data/data/tmp'
+
+###### 删除时间分区(实验性功能)
+
+- 删除时间分区(实验性功能)
+
+Eg: IoTDB > DELETE PARTITION root.ln 0,1,2
+
+###### 连续查询
+
+- 连续查询(CQ)
+
+Eg: IoTDB > CREATE CONTINUOUS QUERY cq1 BEGIN SELECT max_value(temperature) INTO temperature_max FROM root.ln.*.* GROUP BY time(10s) END
+
+###### 运维命令
+
+- FLUSH
+
+Eg: IoTDB > flush
+
+- MERGE
+
+Eg: IoTDB > MERGE
+
+Eg: IoTDB > FULL MERGE
+
+- CLEAR CACHE
+
+Eg: IoTDB > CLEAR CACHE
+
+- SET STSTEM TO READONLY / WRITABLE
+
+Eg: IoTDB > SET STSTEM TO READONLY / WRITABLE
+
+- SCHEMA SNAPSHOT
+
+Eg: IoTDB > CREATE SNAPSHOT FOR SCHEMA
+
+- 查询终止
+
+Eg: IoTDB > KILL QUERY 1
+
+###### 水印工具
+
+- 为新用户施加水印
+
+Eg: IoTDB > grant watermark_embedding to Alice
+
+- 撤销水印
+
+Eg: IoTDB > revoke watermark_embedding from Alice
+
+# 运维命令
+
+## 1、FLUSH
+
+IoTDB> FLUSH
+
+IoTDB> FLUSH ON LOCAL
+
+IoTDB> FLUSH ON CLUSTER
+
+IoTDB> FLUSH root.ln
+
+IoTDB> FLUSH root.sg1,root.sg2 ON LOCAL
+
+IoTDB> FLUSH root.sg1,root.sg2 ON CLUSTER
+
+## 2、CLEAR CACHE
+
+IoTDB> CLEAR CACHE
+
+IoTDB> CLEAR CACHE ON LOCAL
+
+IoTDB> CLEAR CACHE ON CLUSTER
+
+## 3、SET SYSTEM TO READONLY / RUNNING
+
+IoTDB> SET SYSTEM TO RUNNING
+
+IoTDB> SET SYSTEM TO READONLY ON LOCAL
+
+IoTDB> SET SYSTEM TO READONLY ON CLUSTER
+
+## 4、终止查询
+
+### 查询超时
+
+IoTDB> select * from root.**;
+
+Msg: 701 Current query is time out, please check your statement or modify timeout parameter.
+
+### 查询终止
+
+#### 终止指定查询
+
+```Go
+KILL QUERY <queryId>
+```
+
+##### 示例
+
+kill query '20221205_114444_00003_5'
+
+#### 终止所有查询
+
+KILL ALL QUERIES
+
+## 5、SHOW QUERIES
+
+### 语法
+
+SHOW QUERIES | (QUERY PROCESSLIST)
+
+[WHERE whereCondition]
+
+[ORDER BY sortKey {ASC | DESC}]
+
+[LIMIT rowLimit] [OFFSET rowOffset]
+
+### SQL示例
+
+#### 示例1:获取当前所有执行时间大于30s的查询
+
+SHOW QUERIES WHERE ElapsedTime > 30
+
+#### 示例2:获取当前执行耗时Top5的查询
+
+SHOW QUERIES limit 5
+
+SHOW QUERIES ORDER BY ElapsedTime DESC limit 5
+
+
+
+# TsFile 同步
+
+## 快速上手
+
+- 创建接收端为 IoTDB 类型的 Pipe Sink
+
+IoTDB> CREATE PIPESINK my_iotdb AS IoTDB (ip='接收端IP', port='接收端端口')
+
+- 创建同步任务Pipe(请确保接收端 IoTDB 已经启动)
+
+IoTDB> CREATE PIPE my_pipe TO my_iotdb
+
+- 开始同步任务
+
+IoTDB> START PIPE my_pipe
+
+- 显示所有同步任务状态
+
+IoTDB> SHOW PIPES
+
+- 暂停任务
+
+IoTDB> STOP PIPE my_pipe
+
+- 继续被暂停的任务
+
+IoTDB> START PIPE my_pipe
+
+- 关闭任务(状态信息将被删除)
+
+IoTDB> DROP PIPE my_pipe
+
+## SQL
+
+### SHOW PIPESINKTYPE
+
+IoTDB> SHOW PIPESINKTYPE
+
+### CREATE PIPESINK
+
+```Go
+IoTDB> CREATE PIPESINK <PipeSinkName> AS IoTDB [(ip='127.0.0.1',port=6667);]
+```
+
+### DROP PIPESINK
+
+```Go
+IoTDB> DROP PIPESINK <PipeSinkName>
+```
+
+### SHOW PIPESINK
+
+IoTDB> SHOW PIPESINKS IoTDB> SHOW PIPESINK [PipeSinkName]
+
+### CREATE PIPE
+
+IoTDB> CREATE PIPE my_pipe TO my_iotdb [FROM (select ** from root WHERE time>=yyyy-mm-dd HH:MM:SS)]
+
+### STOP PIPE
+
+```Go
+IoTDB> STOP PIPE <PipeName>
+```
+
+### START PIPE
+
+```Go
+IoTDB> START PIPE <PipeName>
+```
+
+### DROP PIPE
+
+```Go
+IoTDB> DROP PIPE <PipeName>
+```
+
+### SHOW PIPE
+
+IoTDB> SHOW PIPES
+
+IoTDB> SHOW PIPE [PipeName]
+