You are viewing a plain text version of this content. The canonical link for it is here.
Posted to commits@hudi.apache.org by GitBox <gi...@apache.org> on 2022/11/23 10:53:15 UTC
[GitHub] [hudi] TengHuo opened a new issue, #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
TengHuo opened a new issue, #7284:
URL: https://github.com/apache/hudi/issues/7284

   Related JIRA ticket: https://issues.apache.org/jira/browse/HUDI-5271

   **Describe the problem you faced**

   When using Spark to create a hudi table with these config,

   * INMEMORY or CONSISTENT_HASHING BUCKET index
   * Decimal data type in schema
   * MOR Hudi table
   * Use Spark catalog

   It will trigger an exception when query this table.

   ```log
   ERROR org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Got exception when reading log file
   org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:209)
   ...
   ```

   **To Reproduce**

   Steps to reproduce the behavior:

   ```java
   class TestInsertTable extends HoodieSparkSqlTestBase {

     test("Test Insert Into MOR table") {
       withTempDir { tmp =>
         val tableName = "test_mor_tab"
         // Create a partitioned table
         spark.sql(
           s"""
              |create table $tableName (
              |  id int,
              |  dt string,
              |  name string,
              |  price double,
              |  ts long,
              |  new_test_col decimal(25, 4) comment 'a column for test decimal type'
              |) using hudi
              |options
              |(
              |    type = 'mor'
              |    ,primaryKey = 'id'
              |    ,hoodie.index.type = 'INMEMORY'
              |)
              | tblproperties (primaryKey = 'id')
              | partitioned by (dt)
              | location '${tmp.getCanonicalPath}'
          """.stripMargin)

         // Note: Do not write the field alias, the partition field must be placed last.
         spark.sql(
           s"""
              | insert into $tableName values
              | (1, 'a1', 10, 1000, 1.0, "2021-01-05"),
              | (2, 'a2', 20, 2000, 2.0, "2021-01-06"),
              | (3, 'a3', 30, 3000, 3.0, "2021-01-07")
                 """.stripMargin)

         spark.sql(s"select id, name, price, ts, dt from $tableName").show(false)
       }
     }
   }
   ```

   1. Rdd this test case in module `hudi-spark-datasource`/`hudi-spark` in the test class `org.apache.spark.sql.hudi.TestInsertTable`

   **Expected behavior**

   This test case should run properly without any exception

   **Environment Description**

   * Hudi version : latest master branch, commit `3109d890f13b1b29e5796a9f34ab28fa898ec23c`

   * Spark version : tried Spark 2.4/3.1, all have the same issue

   * Hive version : N/A

   * Hadoop version : N/A

   * Storage (HDFS/S3/GCS..) : HDFS

   * Running on Docker? (yes/no) : no


   **Additional context**

   Add any other context about the problem here.

   **Stacktrace**

   The full error stack of the above test case

   ```log

   19963 [ScalaTest-run-running-TestInsertTable] INFO  org.apache.spark.sql.catalyst.expressions.codegen.CodeGenerator [] - Code generated in 20.563541 ms
   20015 [ScalaTest-run-running-TestInsertTable] INFO  org.apache.spark.sql.catalyst.expressions.codegen.CodeGenerator [] - Code generated in 18.67177 ms
   20036 [ScalaTest-run-running-TestInsertTable] INFO  org.apache.spark.SparkContext [] - Starting job: apply at OutcomeOf.scala:85
   20036 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Got job 24 (apply at OutcomeOf.scala:85) with 1 output partitions
   20036 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Final stage: ResultStage 35 (apply at OutcomeOf.scala:85)
   20036 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Parents of final stage: List()
   20036 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Missing parents: List()
   20037 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Submitting ResultStage 35 (MapPartitionsRDD[71] at apply at OutcomeOf.scala:85), which has no missing parents
   20051 [dag-scheduler-event-loop] INFO  org.apache.spark.storage.memory.MemoryStore [] - Block broadcast_33 stored as values in memory (estimated size 15.4 KB, free 2002.3 MB)
   20060 [dag-scheduler-event-loop] INFO  org.apache.spark.storage.memory.MemoryStore [] - Block broadcast_33_piece0 stored as bytes in memory (estimated size 7.4 KB, free 2002.3 MB)
   20060 [dispatcher-event-loop-0] INFO  org.apache.spark.storage.BlockManagerInfo [] - Added broadcast_33_piece0 in memory on 10.2.175.58:53317 (size: 7.4 KB, free: 2004.2 MB)
   20061 [dag-scheduler-event-loop] INFO  org.apache.spark.SparkContext [] - Created broadcast 33 from broadcast at DAGScheduler.scala:1161
   20061 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - Submitting 1 missing tasks from ResultStage 35 (MapPartitionsRDD[71] at apply at OutcomeOf.scala:85) (first 15 tasks are for partitions Vector(0))
   20061 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.TaskSchedulerImpl [] - Adding task set 35.0 with 1 tasks
   20064 [dispatcher-event-loop-1] INFO  org.apache.spark.scheduler.TaskSetManager [] - Starting task 0.0 in stage 35.0 (TID 44, localhost, executor driver, partition 0, PROCESS_LOCAL, 8249 bytes)
   20064 [Executor task launch worker for task 44] INFO  org.apache.spark.executor.Executor [] - Running task 0.0 in stage 35.0 (TID 44)
   20080 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.HoodieTableMetaClient [] - Loading HoodieTableMetaClient from file:/private/var/folders/n7/7v_cwpdn79lc75czxd84bdd8mwzd9l/T/spark-cdd1a67d-c0be-4c46-826a-445e29dfa751
   20081 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.HoodieTableConfig [] - Loading table properties from file:/private/var/folders/n7/7v_cwpdn79lc75czxd84bdd8mwzd9l/T/spark-cdd1a67d-c0be-4c46-826a-445e29dfa751/.hoodie/hoodie.properties
   20081 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.HoodieTableMetaClient [] - Finished Loading Table of type MERGE_ON_READ(version=1, baseFileFormat=PARQUET) from file:/private/var/folders/n7/7v_cwpdn79lc75czxd84bdd8mwzd9l/T/spark-cdd1a67d-c0be-4c46-826a-445e29dfa751
   20083 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.timeline.HoodieActiveTimeline [] - Loaded instants upto : Option{val=[20221123105000131__deltacommit__COMPLETED]}
   20083 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Scanning log file HoodieLogFile{pathStr='file:/private/var/folders/n7/7v_cwpdn79lc75czxd84bdd8mwzd9l/T/spark-cdd1a67d-c0be-4c46-826a-445e29dfa751/dt=2021-01-05/.04aba946-8423-4ddd-9d04-fbbd91ba37a2-0_20221123105000131.log.1_0-17-17', fileLen=-1}
   20084 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Reading a data block from file file:/private/var/folders/n7/7v_cwpdn79lc75czxd84bdd8mwzd9l/T/spark-cdd1a67d-c0be-4c46-826a-445e29dfa751/dt=2021-01-05/.04aba946-8423-4ddd-9d04-fbbd91ba37a2-0_20221123105000131.log.1_0-17-17 at instant 20221123105000131
   20084 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Merging the final data blocks
   20084 [Executor task launch worker for task 44] INFO  org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Number of remaining logblocks to merge 1
   20086 [Executor task launch worker for task 44] ERROR org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader [] - Got exception when reading log file
   org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:207) ~[classes/:?]
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:144) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processDataBlock(AbstractHoodieLogRecordReader.java:633) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processQueuedBlocksForInstant(AbstractHoodieLogRecordReader.java:715) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:368) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:220) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scan(AbstractHoodieLogRecordReader.java:209) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.performScan(HoodieMergedLogRecordScanner.java:112) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.<init>(HoodieMergedLogRecordScanner.java:105) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner$Builder.build(HoodieMergedLogRecordScanner.java:343) ~[classes/:?]
   	at org.apache.hudi.LogFileIterator$.scanLog(LogFileIterator.scala:305) ~[classes/:?]
   	at org.apache.hudi.LogFileIterator.<init>(LogFileIterator.scala:88) ~[classes/:?]
   	at org.apache.hudi.HoodieMergeOnReadRDD.compute(HoodieMergeOnReadRDD.scala:96) ~[classes/:?]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:90) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.scheduler.Task.run(Task.scala:123) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.executor.Executor$TaskRunner$$anonfun$10.apply(Executor.scala:408) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:1360) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:414) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149) ~[?:1.8.0_345]
   	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624) ~[?:1.8.0_345]
   	at java.lang.Thread.run(Thread.java:750) ~[?:1.8.0_345]
   20095 [Executor task launch worker for task 44] ERROR org.apache.spark.executor.Executor [] - Exception in task 0.0 in stage 35.0 (TID 44)
   org.apache.hudi.exception.HoodieException: Exception when reading log file
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:377) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:220) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scan(AbstractHoodieLogRecordReader.java:209) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.performScan(HoodieMergedLogRecordScanner.java:112) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.<init>(HoodieMergedLogRecordScanner.java:105) ~[classes/:?]
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner$Builder.build(HoodieMergedLogRecordScanner.java:343) ~[classes/:?]
   	at org.apache.hudi.LogFileIterator$.scanLog(LogFileIterator.scala:305) ~[classes/:?]
   	at org.apache.hudi.LogFileIterator.<init>(LogFileIterator.scala:88) ~[classes/:?]
   	at org.apache.hudi.HoodieMergeOnReadRDD.compute(HoodieMergeOnReadRDD.scala:96) ~[classes/:?]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:90) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.scheduler.Task.run(Task.scala:123) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.executor.Executor$TaskRunner$$anonfun$10.apply(Executor.scala:408) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:1360) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:414) ~[spark-core_2.11-2.4.4.jar:2.4.4]
   	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149) ~[?:1.8.0_345]
   	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624) ~[?:1.8.0_345]
   	at java.lang.Thread.run(Thread.java:750) ~[?:1.8.0_345]
   Caused by: org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145) ~[avro-1.8.2.jar:1.8.2]
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:207) ~[classes/:?]
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:144) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processDataBlock(AbstractHoodieLogRecordReader.java:633) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processQueuedBlocksForInstant(AbstractHoodieLogRecordReader.java:715) ~[classes/:?]
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:368) ~[classes/:?]
   	... 27 more
   20111 [task-result-getter-0] WARN  org.apache.spark.scheduler.TaskSetManager [] - Lost task 0.0 in stage 35.0 (TID 44, localhost, executor driver): org.apache.hudi.exception.HoodieException: Exception when reading log file
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:377)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:220)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scan(AbstractHoodieLogRecordReader.java:209)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.performScan(HoodieMergedLogRecordScanner.java:112)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.<init>(HoodieMergedLogRecordScanner.java:105)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner$Builder.build(HoodieMergedLogRecordScanner.java:343)
   	at org.apache.hudi.LogFileIterator$.scanLog(LogFileIterator.scala:305)
   	at org.apache.hudi.LogFileIterator.<init>(LogFileIterator.scala:88)
   	at org.apache.hudi.HoodieMergeOnReadRDD.compute(HoodieMergeOnReadRDD.scala:96)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:90)
   	at org.apache.spark.scheduler.Task.run(Task.scala:123)
   	at org.apache.spark.executor.Executor$TaskRunner$$anonfun$10.apply(Executor.scala:408)
   	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:1360)
   	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:414)
   	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149)
   	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624)
   	at java.lang.Thread.run(Thread.java:750)
   Caused by: org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292)
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88)
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232)
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:207)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:144)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processDataBlock(AbstractHoodieLogRecordReader.java:633)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processQueuedBlocksForInstant(AbstractHoodieLogRecordReader.java:715)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:368)
   	... 27 more

   20113 [task-result-getter-0] ERROR org.apache.spark.scheduler.TaskSetManager [] - Task 0 in stage 35.0 failed 1 times; aborting job
   20113 [task-result-getter-0] INFO  org.apache.spark.scheduler.TaskSchedulerImpl [] - Removed TaskSet 35.0, whose tasks have all completed, from pool
   20116 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.TaskSchedulerImpl [] - Cancelling stage 35
   20117 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.TaskSchedulerImpl [] - Killing all running tasks in stage 35: Stage cancelled
   20118 [dag-scheduler-event-loop] INFO  org.apache.spark.scheduler.DAGScheduler [] - ResultStage 35 (apply at OutcomeOf.scala:85) failed in 0.081 s due to Job aborted due to stage failure: Task 0 in stage 35.0 failed 1 times, most recent failure: Lost task 0.0 in stage 35.0 (TID 44, localhost, executor driver): org.apache.hudi.exception.HoodieException: Exception when reading log file
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:377)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:220)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scan(AbstractHoodieLogRecordReader.java:209)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.performScan(HoodieMergedLogRecordScanner.java:112)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.<init>(HoodieMergedLogRecordScanner.java:105)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner$Builder.build(HoodieMergedLogRecordScanner.java:343)
   	at org.apache.hudi.LogFileIterator$.scanLog(LogFileIterator.scala:305)
   	at org.apache.hudi.LogFileIterator.<init>(LogFileIterator.scala:88)
   	at org.apache.hudi.HoodieMergeOnReadRDD.compute(HoodieMergeOnReadRDD.scala:96)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:90)
   	at org.apache.spark.scheduler.Task.run(Task.scala:123)
   	at org.apache.spark.executor.Executor$TaskRunner$$anonfun$10.apply(Executor.scala:408)
   	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:1360)
   	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:414)
   	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149)
   	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624)
   	at java.lang.Thread.run(Thread.java:750)
   Caused by: org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292)
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88)
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232)
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:207)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:144)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processDataBlock(AbstractHoodieLogRecordReader.java:633)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processQueuedBlocksForInstant(AbstractHoodieLogRecordReader.java:715)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:368)
   	... 27 more
   ```


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1327268261

   The exception mentioned above can be triggered with this test case

   ```scala
     test("Test Insert Into MOR table 2") {
       withTempDir { tmp =>
         val tableName = generateTableName
         // Create a partitioned table
         spark.sql(
           s"""
              |create table $tableName (
              |  id int,
              |  dt string,
              |  name string,
              |  price double,
              |  ts long,
              |  test_decimal_col decimal(25, 4)
              |) using hudi
              |options
              |(
              |    type = 'mor'
              |    ,primaryKey = 'id'
              |    ,hoodie.index.type = 'INMEMORY'
              |)
              | tblproperties (primaryKey = 'id')
              | partitioned by (dt)
              | location '${tmp.getCanonicalPath}'
              | """.stripMargin)

         // Note: Do not write the field alias, the partition field must be placed last.
         spark.sql(
           s"""
              | insert into $tableName values
              | (1, 'a1', 10, 1000, 1.0, "2021-01-05"),
              | (2, 'a2', 20, 2000, 2.0, "2021-01-06"),
              | (3, 'a3', 30, 3000, 3.0, "2021-01-07")
             """.stripMargin)

         spark.sql(
           s"""
              | insert into $tableName values
              | (1, 'a1', 10, null, 1.0, "2021-01-05"),
              | (4, 'a2', 20, 2000, null, "2021-01-06"),
              | (5, 'a3', 30, 3000, 3.0, "2021-01-07")
             """.stripMargin)

         spark.sql(s"select id, name, price, ts, cast(test_decimal_col AS string), dt from $tableName").show(false)
       }
     }
   ```

   The reason of this exception is `null` value in insert data. When there is a null data in data, `HoodieSparkSqlWriter` will do a schema evolution here:

   https://github.com/apache/hudi/blob/b6124ff85a107ab170430947a24bc71df8612f1c/hudi-spark-datasource/hudi-spark-common/src/main/scala/org/apache/hudi/HoodieSparkSqlWriter.scala#L209

   Then, the schema will be converted here:

   https://github.com/apache/hudi/blob/b6124ff85a107ab170430947a24bc71df8612f1c/hudi-common/src/main/java/org/apache/hudi/internal/schema/convert/AvroInternalSchemaConverter.java#L440

   PS: seems @alexeykudinkin just fixed this issue yesterday in https://github.com/apache/hudi/pull/6358. I'm checking it.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by "TengHuo (via GitHub)" <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1617178498

   Also fixed in PR https://github.com/apache/hudi/pull/8026


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] codope commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
codope commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1326367764

   @TengHuo Thanks for sharing a reproducible test. It does look like a bug. I'll review the patch.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1324899843

   @voonhous and me did some trouble shooting on this issue. And we found it is cased by the difference between writer schema and reader schema at this line:

   https://github.com/apache/hudi/blob/76a28daeb08e7192d75dfc447624c827643bef0d/hudi-common/src/main/java/org/apache/hudi/common/table/log/block/HoodieAvroDataBlock.java#L171

   Writer schema:

   ```json
   {
       "type": "record",
       "name": "test_mor_tab_record",
       "namespace": "hoodie.test_mor_tab",
       "fields": [
           {
               "name": "_hoodie_commit_time",
               "type": [
                   "null",
                   "string"
               ],
               "doc": "",
               "default": null
           },
           {
               "name": "_hoodie_commit_seqno",
               "type": [
                   "null",
                   "string"
               ],
               "doc": "",
               "default": null
           },
           {
               "name": "_hoodie_record_key",
               "type": [
                   "null",
                   "string"
               ],
               "doc": "",
               "default": null
           },
           {
               "name": "_hoodie_partition_path",
               "type": [
                   "null",
                   "string"
               ],
               "doc": "",
               "default": null
           },
           {
               "name": "_hoodie_file_name",
               "type": [
                   "null",
                   "string"
               ],
               "doc": "",
               "default": null
           },
           {
               "name": "id",
               "type": "int"
           },
           {
               "name": "name",
               "type": "string"
           },
           {
               "name": "price",
               "type": "double"
           },
           {
               "name": "ts",
               "type": "long"
           },
           {
               "name": "new_test_col",
               "type": {
                   "type": "fixed",
                   "name": "fixed",
                   "namespace": "hoodie.test_mor_tab.test_mor_tab_record.new_test_col",
                   "size": 11,
                   "logicalType": "decimal",
                   "precision": 25,
                   "scale": 4
               },
               "doc": "a column for test decimal type"
           },
           {
               "name": "dt",
               "type": "string"
           }
       ]
   }
   ```

   Reader schema:

   ```json
   {
       "type": "record",
       "name": "Record",
       "fields": [
           {
               "name": "_hoodie_commit_time",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "_hoodie_commit_seqno",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "_hoodie_record_key",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "_hoodie_partition_path",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "_hoodie_file_name",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "id",
               "type": [
                   "int",
                   "null"
               ]
           },
           {
               "name": "name",
               "type": [
                   "string",
                   "null"
               ]
           },
           {
               "name": "price",
               "type": [
                   "double",
                   "null"
               ]
           },
           {
               "name": "ts",
               "type": [
                   "long",
                   "null"
               ]
           },
           {
               "name": "new_test_col",
               "type": [
                   {
                       "type": "fixed",
                       "name": "fixed",
                       "namespace": "Record.new_test_col",
                       "size": 11,
                       "logicalType": "decimal",
                       "precision": 25,
                       "scale": 4
                   },
                   "null"
               ]
           },
           {
               "name": "dt",
               "type": [
                   "string",
                   "null"
               ]
           }
       ]
   }
   ```

   It can be saw in writer schema, the type of column `new_test_col` is a `fixed` type, and with namespace is `hoodie.test_mor_tab.test_mor_tab_record.new_test_col`.

   ```json
   {
       "name": "new_test_col",
       "type": {
           "type": "fixed",
           "name": "fixed",
           "namespace": "hoodie.test_mor_tab.test_mor_tab_record.new_test_col",
           "size": 11,
           "logicalType": "decimal",
           "precision": 25,
           "scale": 4
       },
       "doc": "a column for test decimal type"
   }
   ```

   But in reader schema, the type of column `new_test_col` is a `union` type, and with namespace is`Record.new_test_col`.

   ```json
   {
       "name": "new_test_col",
       "type": [
           {
               "type": "fixed",
               "name": "fixed",
               "namespace": "Record.new_test_col",
               "size": 11,
               "logicalType": "decimal",
               "precision": 25,
               "scale": 4
           },
           "null"
       ]
   }
   ```

   According to [Avro doc](https://avro.apache.org/docs/1.8.2/spec.html#Schema+Resolution), `UNION` type is compatible in schema evolution with other primitive types. So, it is acceptable to read "fixed" type data with `union` type.

   However, the namespace in reader schema is different with writer schema, it causes the exception mentioned above `org.apache.avro.AvroTypeException: Found hoodie.test_mor_tab.test_mor_tab_record.new_test_col.fixed, expecting union`.

   If I replace the reader schema with the same namespace as writer schema, the test case can run properly.

   ```java
   ...
       private RecordIterator(Schema readerSchema, Schema writerSchema, byte[] content, InternalSchema internalSchema) throws IOException {
         this.content = content;

         this.dis = new SizeAwareDataInputStream(new DataInputStream(new ByteArrayInputStream(this.content)));

         // 1. Read version for this data block
         int version = this.dis.readInt();
         HoodieAvroDataBlockVersion logBlockVersion = new HoodieAvroDataBlockVersion(version);

         Schema finalReadSchema = readerSchema;
         if (!internalSchema.isEmptySchema()) {
           // we should use write schema to read log file,
           // since when we have done some DDL operation, the readerSchema maybe different from writeSchema, avro reader will throw exception.
           // eg: origin writeSchema is: "a String, b double" then we add a new column now the readerSchema will be: "a string, c int, b double". it's wrong to use readerSchema to read old log file.
           // after we read those record by writeSchema,  we rewrite those record with readerSchema in AbstractHoodieLogRecordReader
           finalReadSchema = writerSchema;
         }

         Schema readSchema = new Schema.Parser().parse("{\"type\":\"record\",\"name\":\"Record\",\"fields\":[{\"name\":\"_hoodie_commit_time\",\"type\":[\"string\",\"null\"]},{\"name\":\"_hoodie_commit_seqno\",\"type\":[\"string\",\"null\"]},{\"name\":\"_hoodie_record_key\",\"type\":[\"string\",\"null\"]},{\"name\":\"_hoodie_partition_path\",\"type\":[\"string\",\"null\"]},{\"name\":\"_hoodie_file_name\",\"type\":[\"string\",\"null\"]},{\"name\":\"id\",\"type\":[\"int\",\"null\"]},{\"name\":\"name\",\"type\":[\"string\",\"null\"]},{\"name\":\"price\",\"type\":[\"double\",\"null\"]},{\"name\":\"ts\",\"type\":[\"long\",\"null\"]},{\"name\":\"new_test_col\",\"type\":[{\"type\":\"fixed\",\"name\":\"fixed\",\"namespace\":\"hoodie.test_mor_tab.test_mor_tab_record.new_test_col\",\"size\":11,\"logicalType\":\"decimal\",\"precision\":25,\"scale\":4},\"null\"]},{\"name\":\"dt\",\"type\":[\"string\",\"null\"]}]}");
         this.reader = new GenericDatumReader<>(writerSchema, readSchema);

         if (logBlockVersion.hasRecordCount()) {
           this.totalRecords = this.dis.readInt();
         }
       }
   ...
   ```


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1328453643

   **Update**

   The code of Avro schema convert was refactored by Alexey in this PR https://github.com/apache/hudi/pull/6358, so I tested this issue based on the latest master d10d987288b868b7ce46a63675776836c53115c6. It is based on the new code of Alexey.

   This is the new branch for reproduce this issue: https://github.com/apache/hudi/compare/master...TengHuo:hudi:HUDI-5271-verify2

   Run the test case `TestMorTable`, it will throw a similar exception as above

   ```
   Job aborted due to stage failure: Task 0 in stage 54.0 failed 1 times, most recent failure: Lost task 0.0 in stage 54.0 (TID 65, localhost, executor driver): org.apache.hudi.exception.HoodieException: Exception when reading log file
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:379)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:222)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scan(AbstractHoodieLogRecordReader.java:211)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.performScan(HoodieMergedLogRecordScanner.java:113)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner.<init>(HoodieMergedLogRecordScanner.java:106)
   	at org.apache.hudi.common.table.log.HoodieMergedLogRecordScanner$Builder.build(HoodieMergedLogRecordScanner.java:344)
   	at org.apache.hudi.LogFileIterator$.scanLog(LogFileIterator.scala:305)
   	at org.apache.hudi.LogFileIterator.<init>(LogFileIterator.scala:88)
   	at org.apache.hudi.HoodieMergeOnReadRDD.compute(HoodieMergeOnReadRDD.scala:96)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.rdd.MapPartitionsRDD.compute(MapPartitionsRDD.scala:52)
   	at org.apache.spark.rdd.RDD.computeOrReadCheckpoint(RDD.scala:324)
   	at org.apache.spark.rdd.RDD.iterator(RDD.scala:288)
   	at org.apache.spark.scheduler.ResultTask.runTask(ResultTask.scala:90)
   	at org.apache.spark.scheduler.Task.run(Task.scala:123)
   	at org.apache.spark.executor.Executor$TaskRunner$$anonfun$10.apply(Executor.scala:408)
   	at org.apache.spark.util.Utils$.tryWithSafeFinally(Utils.scala:1360)
   	at org.apache.spark.executor.Executor$TaskRunner.run(Executor.scala:414)
   	at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149)
   	at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624)
   	at java.lang.Thread.run(Thread.java:750)
   Caused by: org.apache.avro.AvroTypeException: Found hoodie.h0.h0_record.test_decimal_col.fixed, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292)
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88)
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232)
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:187)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:135)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processDataBlock(AbstractHoodieLogRecordReader.java:634)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.processQueuedBlocksForInstant(AbstractHoodieLogRecordReader.java:692)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:370)
   	... 24 more
   ```


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] codope commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by "codope (via GitHub)" <gi...@apache.org>.
codope commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1488319725

   @TengHuo Since, #6358 is now merged. Can you try with the latest master? I could not reproduce. We can close the issue if you're good.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1324978399

   After checking, we found this reader schema comes from Spark catalog table here:

   https://github.com/apache/hudi/blob/d976671c7bbf6f7603cd219054dcdcee8d0632ba/hudi-spark-datasource/hudi-spark-common/src/main/scala/org/apache/hudi/DefaultSource.scala#L222

   This issue can be bypass if we using hive catalog. But I think it is not a proper fix solution. So my question is how should we fix this issue? Should we read this schema from `hoodie.properties` instead of spark catalog?


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1327091675

   @codope Got it, thanks Sagar.

   We are doing more test in Spark 3.1, seems this PR https://github.com/apache/hudi/pull/7297# didn't fixed all issues. @YannByron said there is another fix for a similar issue in https://github.com/apache/hudi/pull/6783. But @voonhous found another similar exception in our pipeline.

   ```log
   org.apache.hudi.exception.HoodieException: Exception when reading log file
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:377)
   	at org.apache.hudi.common.table.log.AbstractHoodieLogRecordReader.scanInternal(AbstractHoodieLogRecordReader.java:220)
   ...
   Caused by: org.apache.avro.AvroTypeException: Found decimal_25_4, expecting union
   	at org.apache.avro.io.ResolvingDecoder.doAction(ResolvingDecoder.java:292)
   	at org.apache.avro.io.parsing.Parser.advance(Parser.java:88)
   	at org.apache.avro.io.ResolvingDecoder.readIndex(ResolvingDecoder.java:267)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:179)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.readField(GenericDatumReader.java:232)
   	at org.apache.avro.generic.GenericDatumReader.readRecord(GenericDatumReader.java:222)
   	at org.apache.avro.generic.GenericDatumReader.readWithoutConversion(GenericDatumReader.java:175)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:153)
   	at org.apache.avro.generic.GenericDatumReader.read(GenericDatumReader.java:145)
   	at org.apache.hudi.common.table.log.block.HoodieAvroDataBlock$RecordIterator.next(HoodieAvroDataBlock.java:207)
   ```

   Will attach a test case later if I can figure how to trigger it in the unit test.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1328793614

   And I found there is another similar issue in `HoodieCatalogTable#initHoodieTable`

   https://github.com/apache/hudi/blob/e088faac9eca747f74a48f12358a3bb6f66c21d5/hudi-spark-datasource/hudi-spark-common/src/main/scala/org/apache/spark/sql/catalyst/catalog/HoodieCatalogTable.scala#L189


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1328460127

   Hi @codope

   I raised a new PR for fixing this issue: https://github.com/apache/hudi/pull/7307
   It is also based on the Alexey's fix.

   Could you help to review it. Really appreciate.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by GitBox <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1325873950

   The code for reproduce this issue: https://github.com/TengHuo/hudi/tree/HUDI-5271

   Just run test case `TestInsertTable`, it should work because I manually insert a read schema in `HoodieAvroDataBlock`. The test case will throw the exception if restore the change in `HoodieAvroDataBlock`.


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo commented on issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by "TengHuo (via GitHub)" <gi...@apache.org>.
TengHuo commented on issue #7284:
URL: https://github.com/apache/hudi/issues/7284#issuecomment-1506630705
> @TengHuo Since, #6358 is now merged. Can you try with the latest master? I could not reproduce. We can close the issue if you're good.
Thanks @codope. I just tested my test case based the latest master https://github.com/TengHuo/hudi/commit/969e7816738659015c85c8efd814182dd9e99190
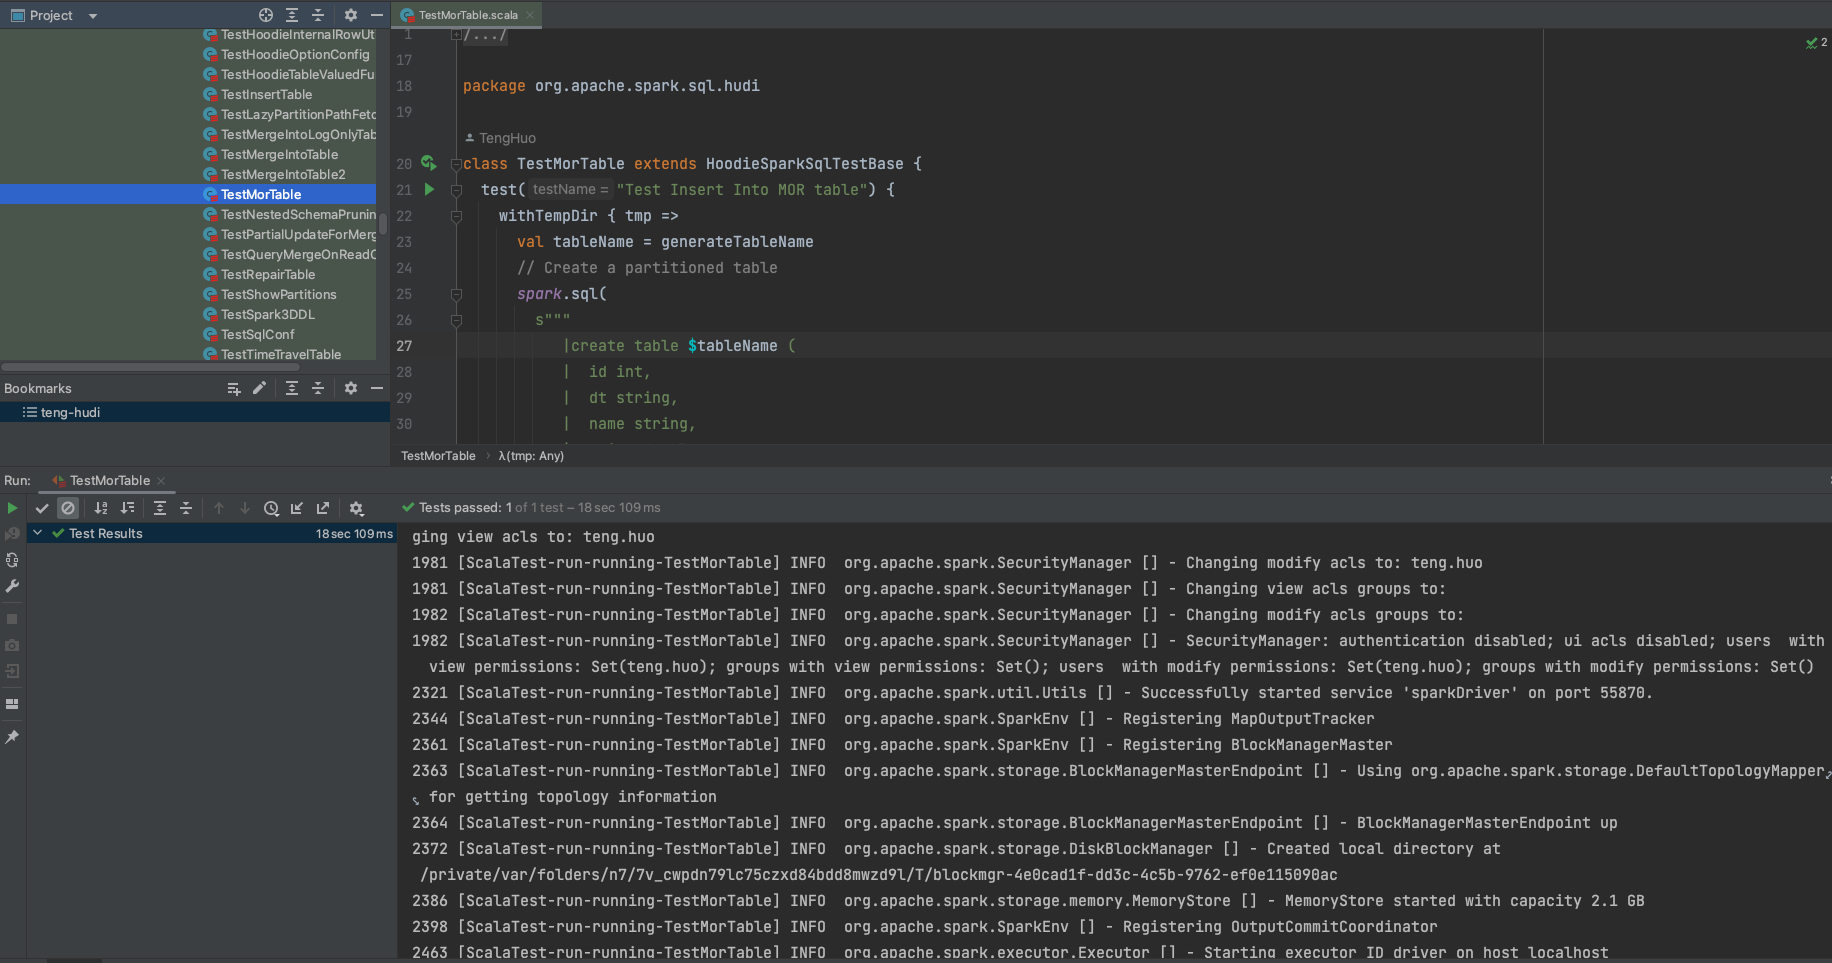
The test case can pass now. Let me close this issue as it is solved.
--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.
To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org
For queries about this service, please contact Infrastructure at:
users@infra.apache.org
[GitHub] [hudi] TengHuo closed issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
Posted by "TengHuo (via GitHub)" <gi...@apache.org>.
TengHuo closed issue #7284: [SUPPORT] Inconsistent reader and writer schema in HoodieAvroDataBlock cause exception
URL: https://github.com/apache/hudi/issues/7284


--
This is an automated message from the Apache Git Service.
To respond to the message, please log on to GitHub and use the
URL above to go to the specific comment.

To unsubscribe, e-mail: commits-unsubscribe@hudi.apache.org

For queries about this service, please contact Infrastructure at:
users@infra.apache.org