You are viewing a plain text version of this content. The canonical link for it is here.
Posted to commits@iotdb.apache.org by ro...@apache.org on 2023/09/05 12:55:11 UTC
[iotdb-docs] branch main updated: Pipe docs updates: Data-Sync & Streaming (#78)
This is an automated email from the ASF dual-hosted git repository.
rong pushed a commit to branch main
in repository https://gitbox.apache.org/repos/asf/iotdb-docs.git
The following commit(s) were added to refs/heads/main by this push:
new c1438e7 Pipe docs updates: Data-Sync & Streaming (#78)
c1438e7 is described below
commit c1438e7ae2437db3850c06e5372ea039b908927d
Author: Caideyipi <87...@users.noreply.github.com>
AuthorDate: Tue Sep 5 20:55:05 2023 +0800
Pipe docs updates: Data-Sync & Streaming (#78)
Co-authored-by: Steve Yurong Su <ro...@apache.org>
---
src/.vuepress/sidebar/V1.2.x/en.ts | 2 +
src/.vuepress/sidebar/V1.2.x/zh.ts | 2 +
src/.vuepress/sidebar_timecho/V1.2.x/en.ts | 3 +-
src/.vuepress/sidebar_timecho/V1.2.x/zh.ts | 3 +-
src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync.md | 486 +++++++++++++
.../V1.2.x/User-Manual/Data-Sync_timecho.md | 548 +++++++++++++++
.../{IoTDB-Data-Pipe_timecho.md => Streaming.md} | 757 ++++++++------------
...B-Data-Pipe_timecho.md => Streaming_timecho.md} | 773 +++++++++------------
...cription_timecho.md => Subscription_timecho.md} | 0
9 files changed, 1664 insertions(+), 910 deletions(-)
diff --git a/src/.vuepress/sidebar/V1.2.x/en.ts b/src/.vuepress/sidebar/V1.2.x/en.ts
index 3558079..cf830a7 100644
--- a/src/.vuepress/sidebar/V1.2.x/en.ts
+++ b/src/.vuepress/sidebar/V1.2.x/en.ts
@@ -84,6 +84,8 @@ export const enSidebar = {
{ text: 'Write Delete Data', link: 'Write-Delete-Data' },
{ text: 'Query Data', link: 'Query-Data' },
{ text: 'Operator and Expression', link: 'Operator-and-Expression' },
+ { text: 'Streaming', link: 'Streaming' },
+ { text: 'Data Sync', link: 'Data-Sync' },
{ text: 'Database Programming', link: 'Database-Programming' },
{ text: 'Security Management', link: 'Security-Management' },
{ text: 'Authority Management', link: 'Authority-Management' },
diff --git a/src/.vuepress/sidebar/V1.2.x/zh.ts b/src/.vuepress/sidebar/V1.2.x/zh.ts
index 4041511..c3d0066 100644
--- a/src/.vuepress/sidebar/V1.2.x/zh.ts
+++ b/src/.vuepress/sidebar/V1.2.x/zh.ts
@@ -84,6 +84,8 @@ export const zhSidebar = {
{ text: '数据增删', link: 'Write-Delete-Data' },
{ text: '数据查询', link: 'Query-Data' },
{ text: '运算符和表达式', link: 'Operator-and-Expression' },
+ { text: '流处理', link: 'Streaming' },
+ { text: '数据同步', link: 'Data-Sync' },
{ text: '数据库编程', link: 'Database-Programming' },
{ text: '安全控制', link: 'Security-Management' },
{ text: '权限管理', link: 'Authority-Management' },
diff --git a/src/.vuepress/sidebar_timecho/V1.2.x/en.ts b/src/.vuepress/sidebar_timecho/V1.2.x/en.ts
index e0908c2..1fb6b18 100644
--- a/src/.vuepress/sidebar_timecho/V1.2.x/en.ts
+++ b/src/.vuepress/sidebar_timecho/V1.2.x/en.ts
@@ -85,7 +85,8 @@ export const enSidebar = {
{ text: 'Write Delete Data', link: 'Write-Delete-Data' },
{ text: 'Query Data', link: 'Query-Data' },
{ text: 'Operator and Expression', link: 'Operator-and-Expression' },
- { text: 'Data Pipe', link: 'IoTDB-Data-Pipe_timecho' },
+ { text: 'Streaming', link: 'Streaming_timecho' },
+ { text: 'Data Sync', link: 'Data-Sync_timecho' },
{ text: 'Tiered Storage', link: 'Tiered-Storage_timecho' },
{ text: 'View', link: 'IoTDB-View_timecho' },
{ text: 'Database Programming', link: 'Database-Programming' },
diff --git a/src/.vuepress/sidebar_timecho/V1.2.x/zh.ts b/src/.vuepress/sidebar_timecho/V1.2.x/zh.ts
index bc3c047..ed9e457 100644
--- a/src/.vuepress/sidebar_timecho/V1.2.x/zh.ts
+++ b/src/.vuepress/sidebar_timecho/V1.2.x/zh.ts
@@ -85,7 +85,8 @@ export const zhSidebar = {
{ text: '数据增删', link: 'Write-Delete-Data' },
{ text: '数据查询', link: 'Query-Data' },
{ text: '运算符和表达式', link: 'Operator-and-Expression' },
- { text: '数据订阅', link: 'IoTDB-Data-Pipe_timecho' },
+ { text: '流处理', link: 'Streaming_timecho' },
+ { text: '数据同步', link: 'Data-Sync_timecho' },
{ text: '多级存储', link: 'Tiered-Storage_timecho' },
{ text: '视图', link: 'IoTDB-View_timecho' },
{ text: '数据库编程', link: 'Database-Programming' },
diff --git a/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync.md b/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync.md
new file mode 100644
index 0000000..1afdce6
--- /dev/null
+++ b/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync.md
@@ -0,0 +1,486 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# IoTDB 数据同步
+
+**IoTDB 数据同步功能可以将 IoTDB 的数据传输到另一个数据平台,我们将<font color=RED>一个数据同步任务称为 Pipe</font>。**
+
+**一个 Pipe 包含三个子任务(插件):**
+
+- 抽取(Extract)
+- 处理(Process)
+- 发送(Connect)
+
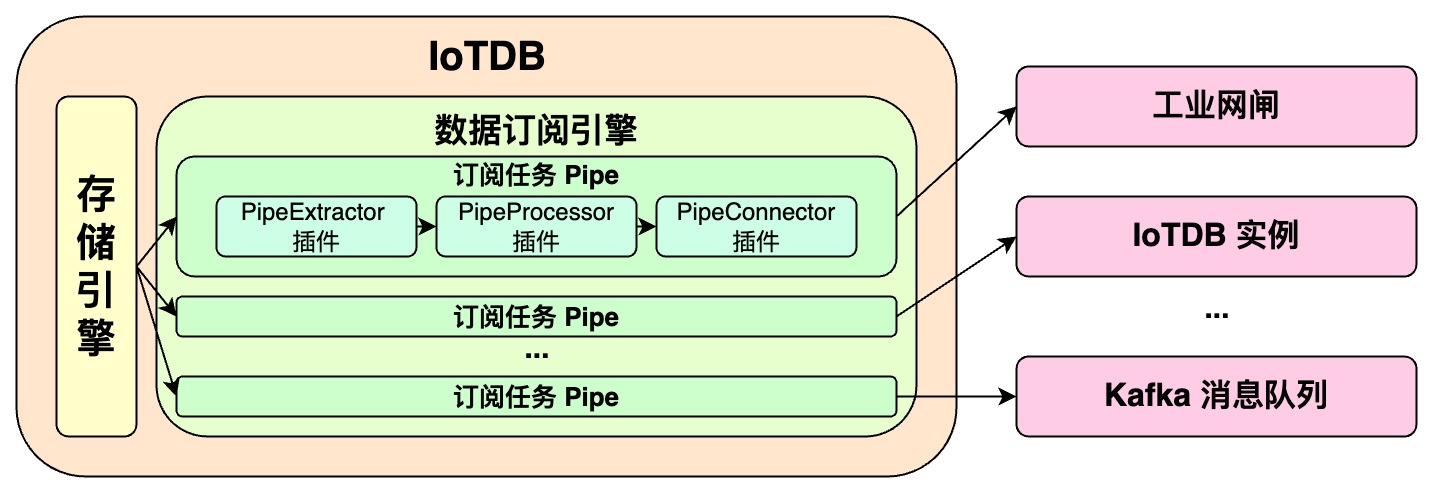
+**Pipe 允许用户自定义三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。** 在一个 Pipe 中,上述的子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
+
+**Pipe 任务的模型如下:**
+
+
+
+描述一个数据同步任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
+
+利用数据同步功能,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
+
+## 快速开始
+
+**🎯 目标:实现 IoTDB A -> IoTDB B 的全量数据同步**
+
+- 启动两个 IoTDB,A(datanode -> 127.0.0.1:6667) B(datanode -> 127.0.0.1:6668)
+- 创建 A -> B 的 Pipe,在 A 上执行
+
+ ```sql
+ create pipe a2b
+ with connector (
+ 'connector'='iotdb-thrift-connector',
+ 'connector.ip'='127.0.0.1',
+ 'connector.port'='6668'
+ )
+ ```
+- 启动 A -> B 的 Pipe,在 A 上执行
+
+ ```sql
+ start pipe a2b
+ ```
+- 向 A 写入数据
+
+ ```sql
+ INSERT INTO root.db.d(time, m) values (1, 1)
+ ```
+- 在 B 检查由 A 同步过来的数据
+
+ ```sql
+ SELECT ** FROM root
+ ```
+
+> ❗️**注:目前的 IoTDB -> IoTDB 的数据同步实现并不支持 DDL 同步**
+>
+> 即:不支持 ttl,trigger,别名,模板,视图,创建/删除序列,创建/删除存储组等操作
+>
+> **IoTDB -> IoTDB 的数据同步要求目标端 IoTDB:**
+>
+> * 开启自动创建元数据:需要人工配置数据类型的编码和压缩与发送端保持一致
+> * 不开启自动创建元数据:手工创建与源端一致的元数据
+
+## 同步任务管理
+
+### 创建同步任务
+
+可以使用 `CREATE PIPE` 语句来创建一条数据同步任务,示例 SQL 语句如下所示:
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定同步任务任务的名字
+WITH EXTRACTOR (
+ -- 默认的 IoTDB 数据抽取插件
+ 'extractor' = 'iotdb-extractor',
+ -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
+ 'extractor.pattern' = 'root.timecho',
+ -- 是否抽取历史数据
+ 'extractor.history.enable' = 'true',
+ -- 描述被抽取的历史数据的时间范围,表示最早时间
+ 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
+ -- 描述被抽取的历史数据的时间范围,表示最晚时间
+ 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
+ -- 是否抽取实时数据
+ 'extractor.realtime.enable' = 'true',
+)
+WITH PROCESSOR (
+ -- 默认的数据处理插件,即不做任何处理
+ 'processor' = 'do-nothing-processor',
+)
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+**创建同步任务时需要配置 PipeId 以及三个插件部分的参数:**
+
+
+| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
+| --------- | ------------------------------------------------- | --------------------------- | -------------------- | ------------------------------------------------------ | ------------------------- |
+| PipeId | 全局唯一标定一个同步任务的名称 | <font color=red>必填</font> | - | - | - |
+| extractor | Pipe Extractor 插件,负责在数据库底层抽取同步数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入同步任务 | 否 |
+| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
+| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
+
+示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据同步任务。IoTDB 还内置了其他的数据同步插件,**请查看“系统预置数据同步插件”一节**。
+
+**一个最简的 CREATE PIPE 语句示例如下:**
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定任务任务的名字
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
+
+**注意:**
+
+- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
+- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
+- CONNECTOR 具备自复用能力。对于不同的任务,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
+
+ - 例如,有下面 pipe1, pipe2 两个任务的声明:
+
+ ```sql
+ CREATE PIPE pipe1
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.host' = 'localhost',
+ 'connector.thrift.port' = '9999',
+ )
+
+ CREATE PIPE pipe2
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.port' = '9999',
+ 'connector.thrift.host' = 'localhost',
+ )
+ ```
+
+ - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
+- 请不要构建出包含数据循环同步的应用场景(会导致无限循环):
+
+ - IoTDB A -> IoTDB B -> IoTDB A
+ - IoTDB A -> IoTDB A
+
+### 启动任务
+
+CREATE PIPE 语句成功执行后,任务相关实例会被创建,但整个任务的运行状态会被置为 STOPPED,即任务不会立刻处理数据。
+
+可以使用 START PIPE 语句使任务开始处理数据:
+
+```sql
+START PIPE <PipeId>
+```
+
+### 停止任务
+
+使用 STOP PIPE 语句使任务停止处理数据:
+
+```sql
+STOP PIPE <PipeId>
+```
+
+### 删除任务
+
+使用 DROP PIPE 语句使任务停止处理数据(当任务状态为 RUNNING 时),然后删除整个任务同步任务:
+
+```sql
+DROP PIPE <PipeId>
+```
+
+用户在删除任务前,不需要执行 STOP 操作。
+
+### 展示任务
+
+使用 SHOW PIPES 语句查看所有任务:
+
+```sql
+SHOW PIPES
+```
+
+查询结果如下:
+
+```sql
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+```
+
+可以使用 `<PipeId>` 指定想看的某个同步任务状态:
+
+```sql
+SHOW PIPE <PipeId>
+```
+
+您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
+
+```sql
+SHOW PIPES
+WHERE CONNECTOR USED BY <PipeId>
+```
+
+### 任务运行状态迁移
+
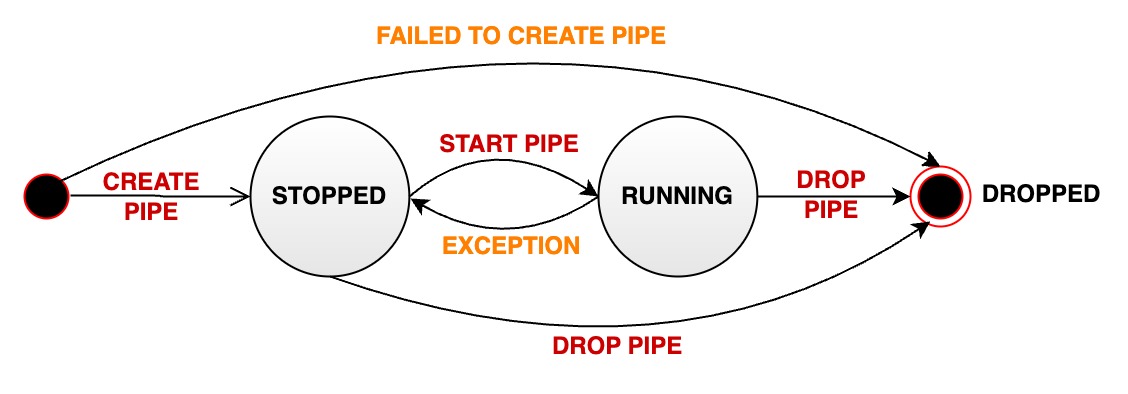
+一个数据同步 pipe 在其被管理的生命周期中会经过多种状态:
+
+- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
+ - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
+ - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
+ - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
+- **RUNNING:** pipe 正在正常工作
+- **DROPPED:** pipe 任务被永久删除
+
+下图表明了所有状态以及状态的迁移:
+
+
+
+## 系统预置数据同步插件
+
+### 查看预置插件
+
+用户可以按需查看系统中的插件。查看插件的语句如图所示。
+
+```sql
+SHOW PIPEPLUGINS
+```
+
+### 预置 extractor 插件
+
+#### iotdb-extractor
+
+作用:抽取 IoTDB 内部的历史或实时数据进入 pipe。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ---------------------------------- | ------------------------------------------------ | -------------------------------------- | --------------------------------- |
+| extractor | iotdb-extractor | String: iotdb-extractor | required |
+| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
+| extractor.history.enable | 是否同步历史数据 | Boolean: true, false | optional: true |
+| extractor.history.start-time | 同步历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
+| extractor.history.end-time | 同步历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
+| extractor.realtime.enable | 是否同步实时数据 | Boolean: true, false | optional: true |
+
+> 🚫 **extractor.pattern 参数说明**
+>
+> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
+> * 在底层实现中,当检测到 pattern 为 root(默认值)时,同步效率较高,其他任意格式都将降低性能
+> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
+>
+> * root.aligned.1TS
+> * root.aligned.1TS.\`1\`
+> * root.aligned.100TS
+>
+> 的数据会被同步;
+>
+> * root.aligned.\`1\`
+> * root.aligned.\`123\`
+>
+> 的数据不会被同步。
+
+> ❗️**extractor.history 的 start-time,end-time 参数说明**
+>
+> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
+
+> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
+>
+> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
+> * **arrival time:** 数据到达 IoTDB 系统内的时间。
+>
+> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
+
+> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
+>
+> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
+> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
+>
+> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
+>
+> 用户可以指定 iotdb-extractor 进行:
+>
+> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
+> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
+> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
+> * 禁止同时设置 `extractor.history.enable` 和 `extractor.realtime.enable` 为 `false`
+
+### 预置 processor 插件
+
+#### do-nothing-processor
+
+作用:不对 extractor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| processor | do-nothing-processor | String: do-nothing-processor | required |
+
+### 预置 connector 插件
+
+#### iotdb-thrift-sync-connector(别名:iotdb-thrift-connector)
+
+作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
+使用 Thrift RPC 框架传输数据,单线程 blocking IO 模型。
+保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致。
+
+限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------------------------------- | --------------------------------------------------------------------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------- |
+| connector | iotdb-thrift-connector 或 iotdb-thrift-sync-connector | String: iotdb-thrift-connector 或 iotdb-thrift-sync-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
+| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
+| connector.batch.enable | 是否开启日志攒批发送模式,用于提高传输吞吐,降低 IOPS | Boolean: true, false | optional: true |
+| connector.batch.max-delay-seconds | 在开启日志攒批发送模式时生效,表示一批数据在发送前的最长等待时间(单位:s) | Integer | optional: 1 |
+| connector.batch.size-bytes | 在开启日志攒批发送模式时生效,表示一批数据最大的攒批大小(单位:byte) | Long | optional: 16 * 1024 * 1024 (16MiB) |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### iotdb-thrift-async-connector
+
+作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
+使用 Thrift RPC 框架传输数据,多线程 async non-blocking IO 模型,传输性能高,尤其适用于目标端为分布式时的场景。
+不保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致,但是保证数据发送的完整性(at-least-once)。
+
+限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------------------------------- | --------------------------------------------------------------------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------- |
+| connector | iotdb-thrift-async-connector | String: iotdb-thrift-async-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
+| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
+| connector.batch.enable | 是否开启日志攒批发送模式,用于提高传输吞吐,降低 IOPS | Boolean: true, false | optional: true |
+| connector.batch.max-delay-seconds | 在开启日志攒批发送模式时生效,表示一批数据在发送前的最长等待时间(单位:s) | Integer | optional: 1 |
+| connector.batch.size-bytes | 在开启日志攒批发送模式时生效,表示一批数据最大的攒批大小(单位:byte) | Long | optional: 16 * 1024 * 1024 (16MiB) |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### iotdb-legacy-pipe-connector
+
+作用:主要用于 IoTDB(v1.2.0+)向更低版本的 IoTDB 传输数据,使用 v1.2.0 版本前的数据同步(Sync)协议。
+使用 Thrift RPC 框架传输数据。单线程 sync blocking IO 模型,传输性能较弱。
+
+限制:源端 IoTDB 版本需要在 v1.2.0+,目标端 IoTDB 版本可以是 v1.2.0+、v1.1.x(更低版本的 IoTDB 理论上也支持,但是未经测试)。
+
+注意:理论上 v1.2.0+ IoTDB 可作为 v1.2.0 版本前的任意版本的数据同步(Sync)接收端。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ------------------ | --------------------------------------------------------------------- | ----------------------------------- | --------------------------------- |
+| connector | iotdb-legacy-pipe-connector | String: iotdb-legacy-pipe-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | required |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | required |
+| connector.user | 目标端 IoTDB 的用户名,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
+| connector.password | 目标端 IoTDB 的密码,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
+| connector.version | 目标端 IoTDB 的版本,用于伪装自身实际版本,绕过目标端的版本一致性检查 | String | optional: 1.1 |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### do-nothing-connector
+
+作用:不对 processor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| connector | do-nothing-connector | String: do-nothing-connector | required |
+
+## 权限管理
+
+### Pipe 任务
+
+
+| 权限名称 | 描述 |
+| ----------- | -------------------- |
+| CREATE_PIPE | 注册任务。路径无关。 |
+| START_PIPE | 开启任务。路径无关。 |
+| STOP_PIPE | 停止任务。路径无关。 |
+| DROP_PIPE | 卸载任务。路径无关。 |
+| SHOW_PIPES | 查询任务。路径无关。 |
+
+### Pipe 插件
+
+
+| 权限名称 | 描述 |
+| ----------------- | ------------------------ |
+| CREATE_PIPEPLUGIN | 注册任务插件。路径无关。 |
+| DROP_PIPEPLUGIN | 开启任务插件。路径无关。 |
+| SHOW_PIPEPLUGINS | 查询任务插件。路径无关。 |
+
+## 配置参数
+
+在 iotdb-common.properties 中:
+
+```Properties
+####################
+### Pipe Configuration
+####################
+
+# Uncomment the following field to configure the pipe lib directory.
+# For Windows platform
+# If its prefix is a drive specifier followed by "\\", or if its prefix is "\\\\", then the path is
+# absolute. Otherwise, it is relative.
+# pipe_lib_dir=ext\\pipe
+# For Linux platform
+# If its prefix is "/", then the path is absolute. Otherwise, it is relative.
+# pipe_lib_dir=ext/pipe
+
+# The maximum number of threads that can be used to execute the pipe subtasks in PipeSubtaskExecutor.
+# The actual value will be min(pipe_subtask_executor_max_thread_num, max(1, CPU core number / 2)).
+# pipe_subtask_executor_max_thread_num=5
+
+# The connection timeout (in milliseconds) for the thrift client.
+# pipe_connector_timeout_ms=900000
+
+# The maximum number of selectors that can be used in the async connector.
+# pipe_async_connector_selector_number=1
+
+# The core number of clients that can be used in the async connector.
+# pipe_async_connector_core_client_number=8
+
+# The maximum number of clients that can be used in the async connector.
+# pipe_async_connector_max_client_number=16
+```
+
+## 功能特性
+
+### 最少一次语义保证 **at-least-once**
+
+数据同步功能向外部系统传输数据时,提供 at-least-once 的传输语义。在大部分场景下,同步功能可提供 exactly-once 保证,即所有数据被恰好同步一次。
+
+但是在以下场景中,可能存在部分数据被同步多次 **(断点续传)** 的情况:
+
+- 临时的网络故障:某次数据传输请求失败后,系统会进行重试发送,直至到达最大尝试次数
+- Pipe 插件逻辑实现异常:插件运行中抛出错误,系统会进行重试发送,直至到达最大尝试次数
+- 数据节点宕机、重启等导致的数据分区切主:分区变更完成后,受影响的数据会被重新传输
+- 集群不可用:集群可用后,受影响的数据会重新传输
+
+### 源端:数据写入与 Pipe 处理、发送数据异步解耦
+
+数据同步功能中,数据传输采用的是异步复制模式。
+
+数据同步与写入操作完全脱钩,不存在对写入关键路径的影响。该机制允许框架在保证持续数据同步的前提下,保持时序数据库的写入速度。
+
+### 源端:高可用集群部署时,Pipe 服务高可用
+
+当发送端 IoTDB 为高可用集群部署模式时,数据同步服务也将是高可用的。 数据同步框架将监控每个数据节点的数据同步进度,并定期做轻量级的分布式一致性快照以保存同步状态。
+
+- 当发送端集群某数据节点宕机时,数据同步框架可以利用一致性快照以及保存在副本上的数据快速恢复同步,以此实现数据同步服务的高可用。
+- 当发送端集群整体宕机并重启时,数据同步框架也能使用快照恢复同步服务。
diff --git a/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync_timecho.md b/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync_timecho.md
new file mode 100644
index 0000000..0006daf
--- /dev/null
+++ b/src/zh/UserGuide/V1.2.x/User-Manual/Data-Sync_timecho.md
@@ -0,0 +1,548 @@
+<!--
+
+ Licensed to the Apache Software Foundation (ASF) under one
+ or more contributor license agreements. See the NOTICE file
+ distributed with this work for additional information
+ regarding copyright ownership. The ASF licenses this file
+ to you under the Apache License, Version 2.0 (the
+ "License"); you may not use this file except in compliance
+ with the License. You may obtain a copy of the License at
+
+ http://www.apache.org/licenses/LICENSE-2.0
+
+ Unless required by applicable law or agreed to in writing,
+ software distributed under the License is distributed on an
+ "AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
+ KIND, either express or implied. See the License for the
+ specific language governing permissions and limitations
+ under the License.
+
+-->
+
+# IoTDB 数据同步
+
+**IoTDB 数据同步功能可以将 IoTDB 的数据传输到另一个数据平台,我们将<font color=RED>一个数据同步任务称为 Pipe</font>。**
+
+**一个 Pipe 包含三个子任务(插件):**
+
+- 抽取(Extract)
+- 处理(Process)
+- 发送(Connect)
+
+**Pipe 允许用户自定义三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。** 在一个 Pipe 中,上述的子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
+
+**Pipe 任务的模型如下:**
+
+
+
+描述一个数据同步任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
+
+利用数据同步功能,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
+
+## 快速开始
+
+**🎯 目标:实现 IoTDB A -> IoTDB B 的全量数据同步**
+
+- 启动两个 IoTDB,A(datanode -> 127.0.0.1:6667) B(datanode -> 127.0.0.1:6668)
+- 创建 A -> B 的 Pipe,在 A 上执行
+
+ ```sql
+ create pipe a2b
+ with connector (
+ 'connector'='iotdb-thrift-connector',
+ 'connector.ip'='127.0.0.1',
+ 'connector.port'='6668'
+ )
+ ```
+- 启动 A -> B 的 Pipe,在 A 上执行
+
+ ```sql
+ start pipe a2b
+ ```
+- 向 A 写入数据
+
+ ```sql
+ INSERT INTO root.db.d(time, m) values (1, 1)
+ ```
+- 在 B 检查由 A 同步过来的数据
+
+ ```sql
+ SELECT ** FROM root
+ ```
+
+> ❗️**注:目前的 IoTDB -> IoTDB 的数据同步实现并不支持 DDL 同步**
+>
+> 即:不支持 ttl,trigger,别名,模板,视图,创建/删除序列,创建/删除存储组等操作
+>
+> **IoTDB -> IoTDB 的数据同步要求目标端 IoTDB:**
+>
+> * 开启自动创建元数据:需要人工配置数据类型的编码和压缩与发送端保持一致
+> * 不开启自动创建元数据:手工创建与源端一致的元数据
+
+## 同步任务管理
+
+### 创建同步任务
+
+可以使用 `CREATE PIPE` 语句来创建一条数据同步任务,示例 SQL 语句如下所示:
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定同步任务任务的名字
+WITH EXTRACTOR (
+ -- 默认的 IoTDB 数据抽取插件
+ 'extractor' = 'iotdb-extractor',
+ -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
+ 'extractor.pattern' = 'root.timecho',
+ -- 是否抽取历史数据
+ 'extractor.history.enable' = 'true',
+ -- 描述被抽取的历史数据的时间范围,表示最早时间
+ 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
+ -- 描述被抽取的历史数据的时间范围,表示最晚时间
+ 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
+ -- 是否抽取实时数据
+ 'extractor.realtime.enable' = 'true',
+ -- 描述实时数据的抽取方式
+ 'extractor.realtime.mode' = 'hybrid',
+)
+WITH PROCESSOR (
+ -- 默认的数据处理插件,即不做任何处理
+ 'processor' = 'do-nothing-processor',
+)
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+**创建同步任务时需要配置 PipeId 以及三个插件部分的参数:**
+
+
+| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
+| --------- | ------------------------------------------------- | --------------------------- | -------------------- | ------------------------------------------------------ | ------------------------- |
+| PipeId | 全局唯一标定一个同步任务的名称 | <font color=red>必填</font> | - | - | - |
+| extractor | Pipe Extractor 插件,负责在数据库底层抽取同步数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入同步任务 | 否 |
+| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
+| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
+
+示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据同步任务。IoTDB 还内置了其他的数据同步插件,**请查看“系统预置数据同步插件”一节**。
+
+**一个最简的 CREATE PIPE 语句示例如下:**
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定任务任务的名字
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
+
+**注意:**
+
+- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
+- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
+- CONNECTOR 具备自复用能力。对于不同的任务,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
+
+ - 例如,有下面 pipe1, pipe2 两个任务的声明:
+
+ ```sql
+ CREATE PIPE pipe1
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.host' = 'localhost',
+ 'connector.thrift.port' = '9999',
+ )
+
+ CREATE PIPE pipe2
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.port' = '9999',
+ 'connector.thrift.host' = 'localhost',
+ )
+ ```
+
+ - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
+- 在 extractor 为默认的 iotdb-extractor,且 extractor.forwarding-pipe-requests 为默认值 true 时,请不要构建出包含数据循环同步的应用场景(会导致无限循环):
+
+ - IoTDB A -> IoTDB B -> IoTDB A
+ - IoTDB A -> IoTDB A
+
+### 启动任务
+
+CREATE PIPE 语句成功执行后,任务相关实例会被创建,但整个任务的运行状态会被置为 STOPPED,即任务不会立刻处理数据。
+
+可以使用 START PIPE 语句使任务开始处理数据:
+
+```sql
+START PIPE <PipeId>
+```
+
+### 停止任务
+
+使用 STOP PIPE 语句使任务停止处理数据:
+
+```sql
+STOP PIPE <PipeId>
+```
+
+### 删除任务
+
+使用 DROP PIPE 语句使任务停止处理数据(当任务状态为 RUNNING 时),然后删除整个任务同步任务:
+
+```sql
+DROP PIPE <PipeId>
+```
+
+用户在删除任务前,不需要执行 STOP 操作。
+
+### 展示任务
+
+使用 SHOW PIPES 语句查看所有任务:
+
+```sql
+SHOW PIPES
+```
+
+查询结果如下:
+
+```sql
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+```
+
+可以使用 `<PipeId>` 指定想看的某个同步任务状态:
+
+```sql
+SHOW PIPE <PipeId>
+```
+
+您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
+
+```sql
+SHOW PIPES
+WHERE CONNECTOR USED BY <PipeId>
+```
+
+### 任务运行状态迁移
+
+一个数据同步 pipe 在其被管理的生命周期中会经过多种状态:
+
+- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
+ - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
+ - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
+ - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
+- **RUNNING:** pipe 正在正常工作
+- **DROPPED:** pipe 任务被永久删除
+
+下图表明了所有状态以及状态的迁移:
+
+
+
+## 系统预置数据同步插件
+
+### 查看预置插件
+
+用户可以按需查看系统中的插件。查看插件的语句如图所示。
+
+```sql
+SHOW PIPEPLUGINS
+```
+
+### 预置 extractor 插件
+
+#### iotdb-extractor
+
+作用:抽取 IoTDB 内部的历史或实时数据进入 pipe。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ---------------------------------- | ------------------------------------------------ | -------------------------------------- | --------------------------------- |
+| extractor | iotdb-extractor | String: iotdb-extractor | required |
+| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
+| extractor.history.enable | 是否同步历史数据 | Boolean: true, false | optional: true |
+| extractor.history.start-time | 同步历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
+| extractor.history.end-time | 同步历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
+| extractor.realtime.enable | 是否同步实时数据 | Boolean: true, false | optional: true |
+| extractor.realtime.mode | 实时数据的抽取模式 | String: hybrid, log, file | optional: hybrid |
+| extractor.forwarding-pipe-requests | 是否转发由其他 Pipe (通常是数据同步)写入的数据 | Boolean: true, false | optional: true |
+
+> 🚫 **extractor.pattern 参数说明**
+>
+> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
+> * 在底层实现中,当检测到 pattern 为 root(默认值)时,同步效率较高,其他任意格式都将降低性能
+> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
+>
+> * root.aligned.1TS
+> * root.aligned.1TS.\`1\`
+> * root.aligned.100TS
+>
+> 的数据会被同步;
+>
+> * root.aligned.\`1\`
+> * root.aligned.\`123\`
+>
+> 的数据不会被同步。
+> * root.\_\_system 的数据不会被 pipe 抽取,即不会被同步到目标端。用户虽然可以在 extractor.pattern 中包含任意前缀,包括带有(或覆盖) root.\__system 的前缀,但是 root.__system 下的数据总是会被 pipe 忽略的
+
+> ❗️**extractor.history 的 start-time,end-time 参数说明**
+>
+> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
+
+> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
+>
+> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
+> * **arrival time:** 数据到达 IoTDB 系统内的时间。
+>
+> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
+
+> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
+>
+> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
+> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
+>
+> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
+>
+> 用户可以指定 iotdb-extractor 进行:
+>
+> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
+> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
+> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
+> * 禁止同时设置 `extractor.history.enable` 和 `extractor.realtime.enable` 为 `false`
+
+> 📌 **extractor.realtime.mode:数据抽取的模式**
+>
+> * log:该模式下,任务仅使用操作日志进行数据处理、发送
+> * file:该模式下,任务仅使用数据文件进行数据处理、发送
+> * hybrid:该模式,考虑了按操作日志逐条目发送数据时延迟低但吞吐低的特点,以及按数据文件批量发送时发送吞吐高但延迟高的特点,能够在不同的写入负载下自动切换适合的数据抽取方式,首先采取基于操作日志的数据抽取方式以保证低发送延迟,当产生数据积压时自动切换成基于数据文件的数据抽取方式以保证高发送吞吐,积压消除时自动切换回基于操作日志的数据抽取方式,避免了采用单一数据抽取算法难以平衡数据发送延迟或吞吐的问题。
+
+> 🍕 **extractor.forwarding-pipe-requests:是否允许转发从另一 pipe 传输而来的数据**
+>
+> * 如果要使用 pipe 构建 A -> B -> C 的数据同步,那么 B -> C 的 pipe 需要将该参数为 true 后,A -> B 中 A 通过 pipe 写入 B 的数据才能被正确转发到 C
+> * 如果要使用 pipe 构建 A \<-> B 的双向数据同步(双活),那么 A -> B 和 B -> A 的 pipe 都需要将该参数设置为 false,否则将会造成数据无休止的集群间循环转发
+
+### 预置 processor 插件
+
+#### do-nothing-processor
+
+作用:不对 extractor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| processor | do-nothing-processor | String: do-nothing-processor | required |
+
+### 预置 connector 插件
+
+#### iotdb-thrift-sync-connector(别名:iotdb-thrift-connector)
+
+作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
+使用 Thrift RPC 框架传输数据,单线程 blocking IO 模型。
+保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致。
+
+限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------------------------------- | --------------------------------------------------------------------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------- |
+| connector | iotdb-thrift-connector 或 iotdb-thrift-sync-connector | String: iotdb-thrift-connector 或 iotdb-thrift-sync-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
+| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
+| connector.batch.enable | 是否开启日志攒批发送模式,用于提高传输吞吐,降低 IOPS | Boolean: true, false | optional: true |
+| connector.batch.max-delay-seconds | 在开启日志攒批发送模式时生效,表示一批数据在发送前的最长等待时间(单位:s) | Integer | optional: 1 |
+| connector.batch.size-bytes | 在开启日志攒批发送模式时生效,表示一批数据最大的攒批大小(单位:byte) | Long | optional: 16 * 1024 * 1024 (16MiB) |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### iotdb-thrift-async-connector
+
+作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
+使用 Thrift RPC 框架传输数据,多线程 async non-blocking IO 模型,传输性能高,尤其适用于目标端为分布式时的场景。
+不保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致,但是保证数据发送的完整性(at-least-once)。
+
+限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------------------------------- | --------------------------------------------------------------------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------- |
+| connector | iotdb-thrift-async-connector | String: iotdb-thrift-async-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
+| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
+| connector.batch.enable | 是否开启日志攒批发送模式,用于提高传输吞吐,降低 IOPS | Boolean: true, false | optional: true |
+| connector.batch.max-delay-seconds | 在开启日志攒批发送模式时生效,表示一批数据在发送前的最长等待时间(单位:s) | Integer | optional: 1 |
+| connector.batch.size-bytes | 在开启日志攒批发送模式时生效,表示一批数据最大的攒批大小(单位:byte) | Long | optional: 16 * 1024 * 1024 (16MiB) |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### iotdb-legacy-pipe-connector
+
+作用:主要用于 IoTDB(v1.2.0+)向更低版本的 IoTDB 传输数据,使用 v1.2.0 版本前的数据同步(Sync)协议。
+使用 Thrift RPC 框架传输数据。单线程 sync blocking IO 模型,传输性能较弱。
+
+限制:源端 IoTDB 版本需要在 v1.2.0+,目标端 IoTDB 版本可以是 v1.2.0+、v1.1.x(更低版本的 IoTDB 理论上也支持,但是未经测试)。
+
+注意:理论上 v1.2.0+ IoTDB 可作为 v1.2.0 版本前的任意版本的数据同步(Sync)接收端。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ------------------ | --------------------------------------------------------------------- | ----------------------------------- | --------------------------------- |
+| connector | iotdb-legacy-pipe-connector | String: iotdb-legacy-pipe-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | required |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | required |
+| connector.user | 目标端 IoTDB 的用户名,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
+| connector.password | 目标端 IoTDB 的密码,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
+| connector.version | 目标端 IoTDB 的版本,用于伪装自身实际版本,绕过目标端的版本一致性检查 | String | optional: 1.1 |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### iotdb-air-gap-connector
+
+作用:用于 IoTDB(v1.2.2+)向 IoTDB(v1.2.2+)跨单向数据网闸的数据同步。支持的网闸型号包括南瑞 Syskeeper 2000 等。
+该 Connector 使用 Java 自带的 Socket 实现数据传输,单线程 blocking IO 模型,其性能与 iotdb-thrift-sync-connector 相当。
+保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致。
+
+场景:例如,在电力系统的规范中
+
+> 1.I/II 区与 III 区之间的应用程序禁止采用 SQL 命令访问数据库和基于 B/S 方式的双向数据传输
+>
+> 2.I/II 区与 III 区之间的数据通信,传输的启动端由内网发起,反向的应答报文不容许携带数据,应用层的应答报文最多为 1 个字节,并且 1 个字节为全 0 或者全 1 两种状态
+
+限制:
+
+1. 源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.2+。
+2. 单向数据网闸需要允许 TCP 请求跨越,且每一个请求可返回一个全 1 或全 0 的 byte。
+3. 目标端 IoTDB 需要在 iotdb-common.properties 内,配置
+ a. pipe_air_gap_receiver_enabled=true
+ b. pipe_air_gap_receiver_port 配置 receiver 的接收端口
+
+
+| key | value | value 取值范围 | required or optional with default |
+| -------------------------------------- | ---------------------------------------------------------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------- |
+| connector | iotdb-air-gap-connector | String: iotdb-air-gap-connector | required |
+| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
+| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
+| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
+| connector.air-gap.handshake-timeout-ms | 发送端与接收端在首次尝试建立连接时握手请求的超时时长,单位:毫秒 | Integer | optional: 5000 |
+
+> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
+
+#### do-nothing-connector
+
+作用:不对 processor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| connector | do-nothing-connector | String: do-nothing-connector | required |
+
+## 权限管理
+
+### Pipe 任务
+
+
+| 权限名称 | 描述 |
+| ----------- | -------------------- |
+| CREATE_PIPE | 注册任务。路径无关。 |
+| START_PIPE | 开启任务。路径无关。 |
+| STOP_PIPE | 停止任务。路径无关。 |
+| DROP_PIPE | 卸载任务。路径无关。 |
+| SHOW_PIPES | 查询任务。路径无关。 |
+
+### Pipe 插件
+
+
+| 权限名称 | 描述 |
+| ----------------- | ------------------------ |
+| CREATE_PIPEPLUGIN | 注册任务插件。路径无关。 |
+| DROP_PIPEPLUGIN | 开启任务插件。路径无关。 |
+| SHOW_PIPEPLUGINS | 查询任务插件。路径无关。 |
+
+## 配置参数
+
+在 iotdb-common.properties 中:
+
+```Properties
+####################
+### Pipe Configuration
+####################
+
+# Uncomment the following field to configure the pipe lib directory.
+# For Windows platform
+# If its prefix is a drive specifier followed by "\\", or if its prefix is "\\\\", then the path is
+# absolute. Otherwise, it is relative.
+# pipe_lib_dir=ext\\pipe
+# For Linux platform
+# If its prefix is "/", then the path is absolute. Otherwise, it is relative.
+# pipe_lib_dir=ext/pipe
+
+# The maximum number of threads that can be used to execute the pipe subtasks in PipeSubtaskExecutor.
+# The actual value will be min(pipe_subtask_executor_max_thread_num, max(1, CPU core number / 2)).
+# pipe_subtask_executor_max_thread_num=5
+
+# The connection timeout (in milliseconds) for the thrift client.
+# pipe_connector_timeout_ms=900000
+
+# The maximum number of selectors that can be used in the async connector.
+# pipe_async_connector_selector_number=1
+
+# The core number of clients that can be used in the async connector.
+# pipe_async_connector_core_client_number=8
+
+# The maximum number of clients that can be used in the async connector.
+# pipe_async_connector_max_client_number=16
+
+# Whether to enable receiving pipe data through air gap.
+# The receiver can only return 0 or 1 in tcp mode to indicate whether the data is received successfully.
+# pipe_air_gap_receiver_enabled=false
+
+# The port for the server to receive pipe data through air gap.
+# pipe_air_gap_receiver_port=9780
+```
+
+## 功能特性
+
+### 最少一次语义保证 **at-least-once**
+
+数据同步功能向外部系统传输数据时,提供 at-least-once 的传输语义。在大部分场景下,同步功能可提供 exactly-once 保证,即所有数据被恰好同步一次。
+
+但是在以下场景中,可能存在部分数据被同步多次 **(断点续传)** 的情况:
+
+- 临时的网络故障:某次数据传输请求失败后,系统会进行重试发送,直至到达最大尝试次数
+- Pipe 插件逻辑实现异常:插件运行中抛出错误,系统会进行重试发送,直至到达最大尝试次数
+- 数据节点宕机、重启等导致的数据分区切主:分区变更完成后,受影响的数据会被重新传输
+- 集群不可用:集群可用后,受影响的数据会重新传输
+
+### 源端:数据写入与 Pipe 处理、发送数据异步解耦
+
+数据同步功能中,数据传输采用的是异步复制模式。
+
+数据同步与写入操作完全脱钩,不存在对写入关键路径的影响。该机制允许框架在保证持续数据同步的前提下,保持时序数据库的写入速度。
+
+### 源端:可自适应数据写入负载的数据传输策略
+
+支持根据写入负载,动态调整数据传输方式,同步默认使用 TsFile 文件与操作流动态混合传输(`'extractor.realtime.mode'='hybrid'`)。
+
+在数据写入负载高时,优先选择 TsFile 传输的方式。TsFile 压缩比高,节省网络带宽。
+
+在数据写入负载低时,优先选择操作流同步传输的方式。操作流传输实时性高。
+
+### 源端:高可用集群部署时,Pipe 服务高可用
+
+当发送端 IoTDB 为高可用集群部署模式时,数据同步服务也将是高可用的。 数据同步框架将监控每个数据节点的数据同步进度,并定期做轻量级的分布式一致性快照以保存同步状态。
+
+- 当发送端集群某数据节点宕机时,数据同步框架可以利用一致性快照以及保存在副本上的数据快速恢复同步,以此实现数据同步服务的高可用。
+- 当发送端集群整体宕机并重启时,数据同步框架也能使用快照恢复同步服务。
diff --git a/src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md b/src/zh/UserGuide/V1.2.x/User-Manual/Streaming.md
similarity index 58%
copy from src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md
copy to src/zh/UserGuide/V1.2.x/User-Manual/Streaming.md
index fe70bfc..f57baf6 100644
--- a/src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md
+++ b/src/zh/UserGuide/V1.2.x/User-Manual/Streaming.md
@@ -7,9 +7,9 @@
to you under the Apache License, Version 2.0 (the
"License"); you may not use this file except in compliance
with the License. You may obtain a copy of the License at
-
+
http://www.apache.org/licenses/LICENSE-2.0
-
+
Unless required by applicable law or agreed to in writing,
software distributed under the License is distributed on an
"AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
@@ -19,399 +19,30 @@
-->
-# IoTDB 数据订阅
+# IoTDB 流处理框架
-**IoTDB 数据订阅功能可以将 IoTDB 的数据传输到另一个数据平台,我们将<font color=RED>一个数据订阅任务称为 Pipe</font>。**
+IoTDB 流处理框架允许用户实现自定义的流处理逻辑,可以实现对存储引擎变更的监听和捕获、实现对变更数据的变形、实现对变形后数据的向外推送等逻辑。
-**一个 Pipe 包含三个子任务(插件):**
+我们将<font color=RED>一个数据流处理任务称为 Pipe</font>。一个流处理任务(Pipe)包含三个子任务:
- 抽取(Extract)
- 处理(Process)
- 发送(Connect)
-**Pipe 允许用户自定义三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。** 在一个 Pipe 中,上述的子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
+流处理框架允许用户使用 Java 语言自定义编写三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。
+在一个 Pipe 中,上述的三个子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:
+Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
**Pipe 任务的模型如下:**

+描述一个数据流处理任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。
+用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
+利用流处理框架,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
-描述一个数据订阅任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
-
-利用数据订阅功能,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
-
-## 快速开始
-
-**🎯 目标:实现 IoTDB A -> IoTDB B 的全量数据订阅**
-
-- 启动两个 IoTDB,A(datanode -> 127.0.0.1:6667) B(datanode -> 127.0.0.1:6668)
-
-- 创建 A -> B 的 Pipe,在 A 上执行
-
- ```sql
- create pipe a2b
- with connector (
- 'connector'='iotdb-thrift-connector',
- 'connector.ip'='127.0.0.1',
- 'connector.port'='6668'
- )
- ```
-
-- 启动 A -> B 的 Pipe,在 A 上执行
-
- ```sql
- start pipe a2b
- ```
-
-- 向 A 写入数据
-
- ```sql
- INSERT INTO root.db.d(time, m) values (1, 1)
- ```
-
-- 在 B 检查由 A 同步过来的数据
-
- ```sql
- SELECT ** FROM root
- ```
-
-> ❗️**注:目前的 IoTDB -> IoTDB 的数据订阅实现并不支持 DDL 同步**
->
-> 即:不支持 ttl,trigger,别名,模板,视图,创建/删除序列,创建/删除存储组等操作
->
-> **IoTDB -> IoTDB 的数据订阅要求目标端 IoTDB:**
->
-> * 开启自动创建元数据:需要人工配置数据类型的编码和压缩与发送端保持一致
-> * 不开启自动创建元数据:手工创建与源端一致的元数据
-
-## Pipe 同步任务管理
-
-### 创建流水线
-
-可以使用 `CREATE PIPE` 语句来创建一条数据订阅任务,SQL 语句如下所示:
-
-```sql
-CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流水线任务的名字
-WITH EXTRACTOR (
- -- 默认的 IoTDB 数据抽取插件
- 'extractor' = 'iotdb-extractor',
- -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
- 'extractor.pattern' = 'root.timecho',
- -- 是否抽取历史数据
- 'extractor.history.enable' = 'true',
- -- 描述被抽取的历史数据的时间范围,表示最早时间
- 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
- -- 描述被抽取的历史数据的时间范围,表示最晚时间
- 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
- -- 是否抽取实时数据
- 'extractor.realtime.enable' = 'true',
- -- 描述实时数据的抽取方式
- 'extractor.realtime.mode' = 'hybrid',
-)
-WITH PROCESSOR (
- -- 默认的数据处理插件,即不做任何处理
- 'processor' = 'do-nothing-processor',
-)
-WITH CONNECTOR (
- -- IoTDB 数据发送插件,目标端为 IoTDB
- 'connector' = 'iotdb-thrift-connector',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
- 'connector.ip' = '127.0.0.1',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
- 'connector.port' = '6667',
-)
-```
-
-**创建流水线时需要配置 PipeId 以及三个插件部分的参数:**
-
-| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
-| --------- | ------------------------------------------------- | --------------------------- | -------------------- | -------------------------------------------------------- | ------------------------- |
-| PipeId | 全局唯一标定一个同步流水线的名称 | <font color=red>必填</font> | - | - | - |
-| extractor | Pipe Extractor 插件,负责在数据库底层抽取同步数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入同步流水线 | 否 |
-| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
-| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
-
-示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据订阅任务。IoTDB 还内置了其他的数据订阅插件,**请查看“系统预置数据订阅插件”一节**。
-
-**一个最简的 CREATE PIPE 语句示例如下:**
-
-```sql
-CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流水线任务的名字
-WITH CONNECTOR (
- -- IoTDB 数据发送插件,目标端为 IoTDB
- 'connector' = 'iotdb-thrift-connector',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
- 'connector.ip' = '127.0.0.1',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
- 'connector.port' = '6667',
-)
-```
-
-其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
-
-**注意:**
-
-- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
-
-- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
-
-- CONNECTOR 具备自复用能力。对于不同的流水线,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
-
- - 例如,有下面 pipe1, pipe2 两个流水线的声明:
-
- ```sql
- CREATE PIPE pipe1
- WITH CONNECTOR (
- 'connector' = 'iotdb-thrift-connector',
- 'connector.thrift.host' = 'localhost',
- 'connector.thrift.port' = '9999',
- )
-
- CREATE PIPE pipe2
- WITH CONNECTOR (
- 'connector' = 'iotdb-thrift-connector',
- 'connector.thrift.port' = '9999',
- 'connector.thrift.host' = 'localhost',
- )
- ```
-
- - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
-
-- 请不要构建出包含数据循环同步的应用场景(会导致无限循环):
-
- - IoTDB A -> IoTDB B -> IoTDB A
- - IoTDB A -> IoTDB A
-
-### 启动流水线
-
-CREATE PIPE 语句成功执行后,流水线相关实例会被创建,但整个流水线的运行状态会被置为 STOPPED,即流水线不会立刻处理数据。
-
-可以使用 START PIPE 语句使流水线开始处理数据:
-
-```sql
-START PIPE <PipeId>
-```
-
-### 停止流水线
-
-使用 STOP PIPE 语句使流水线停止处理数据:
-
-```sql
-STOP PIPE <PipeId>
-```
-
-### 删除流水线
-
-使用 DROP PIPE 语句使流水线停止处理数据(当流水线状态为 RUNNING 时),然后删除整个流水线同步任务:
-
-```sql
-DROP PIPE <PipeId>
-```
-
-用户在删除流水线前,不需要执行 STOP 操作。
-
-### 展示流水线
-
-使用 SHOW PIPES 语句查看所有流水线:
-
-```sql
-SHOW PIPES
-```
-
-查询结果如下:
-
-```sql
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-```
-
-可以使用 `<PipeId>` 指定想看的某个同步任务状态:
-
-```sql
-SHOW PIPE <PipeId>
-```
-
-您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
-
-```sql
-SHOW PIPES
-WHERE CONNECTOR USED BY <PipeId>
-```
-
-### 流水线运行状态迁移
-
-一个数据订阅 pipe 在其被管理的生命周期中会经过多种状态:
-
-- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
- - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
- - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
- - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
-- **RUNNING:** pipe 正在正常工作
-- **DROPPED:** pipe 任务被永久删除
-
-下图表明了所有状态以及状态的迁移:
-
-
-
-## **系统预置数据订阅插件**
-
-### 预置 extractor
-
-#### iotdb-extractor
-
-作用:抽取 IoTDB 内部的历史或实时数据进入流水线。
-
-| key | value | value 取值范围 | required or optional with default |
-| ---------------------------- | ---------------------------------------------- | -------------------------------------- | --------------------------------- |
-| extractor | iotdb-extractor | String: iotdb-extractor | required |
-| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
-| extractor.history.enable | 是否同步历史数据 | Boolean: true, false | optional: true |
-| extractor.history.start-time | 同步历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
-| extractor.history.end-time | 同步历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
-| extractor.realtime.enable | 是否同步实时数据 | Boolean: true, false | optional: true |
-| extractor.realtime.mode | 实时数据的抽取模式 | String: hybrid, log, file | optional: hybrid |
-
-> 🚫 **extractor.pattern 参数说明**
->
-> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
->
-> * 在底层实现中,当检测到 pattern 为 root(默认值)时,同步效率较高,其他任意格式都将降低性能
->
-> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
->
-> * root.aligned.1TS
-> * root.aligned.1TS.\`1\`
-> * root.aligned.100TS
->
-> 的数据会被同步;
->
-> * root.aligned.\`1\`
-> * root.aligned.\`123\`
->
-> 的数据不会被同步。
->
-> * root.\_\_system 的数据不会被 pipe 抽取,即不会被同步到目标端。用户虽然可以在 extractor.pattern 中包含任意前缀,包括带有(或覆盖) root.\__system 的前缀,但是 root.__system 下的数据总是会被 pipe 忽略的
-
-
-
-> ❗️**extractor.history 的 start-time,end-time 参数说明**
->
-> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
-
-
-
-> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
->
-> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
-> * **arrival time:** 数据到达 IoTDB 系统内的时间。
->
-> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
-
-
-
-> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
->
-> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
-> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
->
-> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
->
-> 用户可以指定 iotdb-extractor 进行:
->
-> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
-> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
-> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
-> * 禁止同时设置 extractor.history.enable 和 extractor.relatime.enable 为 false
-
-
-
-> 📌 **extractor.realtime.mode:数据抽取的模式**
->
-> * log:该模式下,流水线仅使用操作日志进行数据处理、发送
-> * file:该模式下,流水线仅使用数据文件进行数据处理、发送
-> * hybrid:该模式,考虑了按操作日志逐条目发送数据时延迟低但吞吐低的特点,以及按数据文件批量发送时发送吞吐高但延迟高的特点,能够在不同的写入负载下自动切换适合的数据抽取方式,首先采取基于操作日志的数据抽取方式以保证低发送延迟,当产生数据积压时自动切换成基于数据文件的数据抽取方式以保证高发送吞吐,积压消除时自动切换回基于操作日志的数据抽取方式,避免了采用单一数据抽取算法难以平衡数据发送延迟或吞吐的问题。
-
-### 预置 processor
-
-#### do-nothing-processor
-
-作用:不对 extractor 传入的事件做任何的处理。
-
-| key | value | value 取值范围 | required or optional with default |
-| --------- | -------------------- | ---------------------------- | --------------------------------- |
-| processor | do-nothing-processor | String: do-nothing-processor | required |
-
-### 预置 connector
-
-#### iotdb-thrift-sync-connector(别名:iotdb-thrift-connector)
-
-作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
-使用 Thrift RPC 框架传输数据,单线程 blocking IO 模型。
-保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致。
-
-限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
-
-| key | value | value 取值范围 | required or optional with default |
-| -------------- | --------------------------------------------------- |---------------------------------------------------------------------------|------------------------------------------|
-| connector | iotdb-thrift-connector 或 iotdb-thrift-sync-connector | String: iotdb-thrift-connector 或 iotdb-thrift-sync-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
-| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### iotdb-thrift-async-connector
-
-作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
-使用 Thrift RPC 框架传输数据,多线程 async non-blocking IO 模型,传输性能高,尤其适用于目标端为分布式时的场景。
-不保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致,但是保证数据发送的完整性(at-least-once)。
-
-限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
-
-| key | value | value 取值范围 | required or optional with default |
-| -------------- |-------------------------------------------------------|---------------------------------------------------------------------------|------------------------------------------|
-| connector | iotdb-thrift-async-connector | String: iotdb-thrift-async-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
-| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### iotdb-legacy-pipe-connector
-
-作用:主要用于 IoTDB(v1.2.0+)向更低版本的 IoTDB 传输数据,使用 v1.2.0 版本前的数据同步(Sync)协议。
-使用 Thrift RPC 框架传输数据。单线程 sync blocking IO 模型,传输性能较弱。
-
-限制:源端 IoTDB 版本需要在 v1.2.0+,目标端 IoTDB 版本可以是 v1.2.0+、v1.1.x(更低版本的 IoTDB 理论上也支持,但是未经测试)。
-
-注意:理论上 v1.2.0+ IoTDB 可作为 v1.2.0 版本前的任意版本的数据同步(Sync)接收端。
-
-| key | value | value 取值范围 | required or optional with default |
-| ------------------ | ------------------------------------------------------------ | ---------------------------- | --------------------------------- |
-| connector | iotdb-legacy-pipe-connector | String: iotdb-legacy-pipe-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | required |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | required |
-| connector.user | 目标端 IoTDB 的用户名,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
-| connector.password | 目标端 IoTDB 的密码,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
-| connector.version | 目标端 IoTDB 的版本,用于伪装自身实际版本,绕过目标端的版本一致性检查 | String | optional: 1.1 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### do-nothing-connector
-
-作用:不对 processor 传入的事件做任何的处理。
-
-| key | value | value 取值范围 | required or optional with default |
-| --------- | -------------------- | ---------------------------- | --------------------------------- |
-| connector | do-nothing-connector | String: do-nothing-connector | required |
-
-## 自定义数据订阅插件开发
+## 自定义流处理插件开发
### 编程开发依赖
@@ -421,18 +52,18 @@ WHERE CONNECTOR USED BY <PipeId>
<dependency>
<groupId>org.apache.iotdb</groupId>
<artifactId>pipe-api</artifactId>
- <version>1.2.0</version>
+ <version>1.2.1</version>
<scope>provided</scope>
</dependency>
```
### 事件驱动编程模型
-数据订阅插件的用户编程接口设计,参考了事件驱动编程模型的通用设计理念。事件(Event)是用户编程接口中的数据抽象,而编程接口与具体的执行方式解耦,只需要专注于描述事件(数据)到达系统后,系统期望的处理方式即可。
+流处理插件的用户编程接口设计,参考了事件驱动编程模型的通用设计理念。事件(Event)是用户编程接口中的数据抽象,而编程接口与具体的执行方式解耦,只需要专注于描述事件(数据)到达系统后,系统期望的处理方式即可。
-在数据订阅插件的用户编程接口中,事件是数据库数据写入操作的抽象。事件由单机同步引擎捕获,按照同步三个阶段的流程,依次传递至 PipeExtractor 插件,PipeProcessor 插件和 PipeConnector 插件,并依次在三个插件中触发用户逻辑的执行。
+在流处理插件的用户编程接口中,事件是数据库数据写入操作的抽象。事件由单机流处理引擎捕获,按照流处理三个阶段的流程,依次传递至 PipeExtractor 插件,PipeProcessor 插件和 PipeConnector 插件,并依次在三个插件中触发用户逻辑的执行。
-为了兼顾端侧低负载场景下的同步低延迟和端侧高负载场景下的同步高吞吐,同步引擎会动态地在操作日志和数据文件中选择处理对象,因此,同步的用户编程接口要求用户提供下列两类事件的处理逻辑:操作日志写入事件 TabletInsertionEvent 和数据文件写入事件 TsFileInsertionEvent。
+为了兼顾端侧低负载场景下的流处理低延迟和端侧高负载场景下的流处理高吞吐,流处理引擎会动态地在操作日志和数据文件中选择处理对象,因此,流处理的用户编程接口要求用户提供下列两类事件的处理逻辑:操作日志写入事件 TabletInsertionEvent 和数据文件写入事件 TsFileInsertionEvent。
#### **操作日志写入事件(TabletInsertionEvent)**
@@ -474,11 +105,11 @@ IoTDB 的存储引擎是 LSM 结构的。数据写入时会先将写入操作落
在极端的网络情况下,直接传输数据文件相比传输数据写入的操作要更加经济,它会占用更低的网络带宽,能实现更快的传输速度。当然,天下没有免费的午餐,对文件中的数据进行计算处理,相比直接对内存中的数据进行计算处理时,需要额外付出文件 I/O 的代价。但是,正是磁盘数据文件和内存写入操作两种结构各有优劣的存在,给了系统做动态权衡调整的机会,也正是基于这样的观察,插件的事件模型中才引入了数据文件写入事件。
-综上,数据文件写入事件出现在同步插件的事件流中,存在下面两种情况:
+综上,数据文件写入事件出现在流处理插件的事件流中,存在下面两种情况:
-(1)历史数据抽取:一个同步任务开始前,所有已经落盘的写入数据都会以 TsFile 的形式存在。一个同步任务开始后,采集历史数据时,历史数据将以 TsFileInsertionEvent 作为抽象;
+(1)历史数据抽取:一个流处理任务开始前,所有已经落盘的写入数据都会以 TsFile 的形式存在。一个流处理任务开始后,采集历史数据时,历史数据将以 TsFileInsertionEvent 作为抽象;
-(2)实时数据抽取:一个同步任务进行时,当数据流中实时处理操作日志写入事件的速度慢于写入请求速度一定进度之后,未来得及处理的操作日志写入事件会被被持久化至磁盘,以 TsFile 的形式存在,这一些数据被同步引擎采集到后,会以 TsFileInsertionEvent 作为抽象。
+(2)实时数据抽取:一个流处理任务进行时,当数据流中实时处理操作日志写入事件的速度慢于写入请求速度一定进度之后,未来得及处理的操作日志写入事件会被被持久化至磁盘,以 TsFile 的形式存在,这一些数据被流处理引擎抽取到后,会以 TsFileInsertionEvent 作为抽象。
```java
/**
@@ -496,13 +127,14 @@ public interface TsFileInsertionEvent extends Event {
}
```
-### 自定义数据订阅插件编程接口定义
+### 自定义流处理插件编程接口定义
-基于自定义数据订阅插件编程接口,用户可以轻松编写数据抽取插件、 数据处理插件和数据发送插件,从而使得同步功能灵活适配各种工业场景。
+基于自定义流处理插件编程接口,用户可以轻松编写数据抽取插件、数据处理插件和数据发送插件,从而使得流处理功能灵活适配各种工业场景。
#### 数据抽取插件接口
-数据抽取是同步数据从数据抽取到数据发送三阶段的第一阶段。数据抽取插件(PipeExtractor)是同步引擎和存储引擎的桥梁,它通过监听存储引擎的行为,捕获各种数据写入事件。
+数据抽取是流处理数据从数据抽取到数据发送三阶段的第一阶段。数据抽取插件(PipeExtractor)是流处理引擎和存储引擎的桥梁,它通过监听存储引擎的行为,
+捕获各种数据写入事件。
```java
/**
@@ -582,7 +214,8 @@ public interface PipeExtractor extends PipePlugin {
#### 数据处理插件接口
-数据处理是同步数据从数据抽取到数据发送三阶段的第二阶段。数据处理插件(PipeProcessor)主要用于过滤和转换由数据抽取插件(PipeExtractor)捕获的各种事件。
+数据处理是流处理数据从数据抽取到数据发送三阶段的第二阶段。数据处理插件(PipeProcessor)主要用于过滤和转换由数据抽取插件(PipeExtractor)捕获的
+各种事件。
```java
/**
@@ -682,7 +315,8 @@ public interface PipeProcessor extends PipePlugin {
#### 数据发送插件接口
-数据发送是同步数据从数据抽取到数据发送三阶段的第三阶段。数据发送插件(PipeConnector)主要用于发送经由数据处理插件(PipeProcessor)处理过后的各种事件,它作为数据订阅框架的网络实现层,接口上应允许接入多种实时通信协议和多种连接器。
+数据发送是流处理数据从数据抽取到数据发送三阶段的第三阶段。数据发送插件(PipeConnector)主要用于发送经由数据处理插件(PipeProcessor)处理过后的
+各种事件,它作为流处理框架的网络实现层,接口上应允许接入多种实时通信协议和多种连接器。
```java
/**
@@ -803,13 +437,15 @@ public interface PipeConnector extends PipePlugin {
}
```
-## 自定义数据订阅插件管理
+## 自定义流处理插件管理
-为了保证用户自定义插件在实际生产中的灵活性和易用性,系统还需要提供对插件进行动态统一管理的能力。本章节介绍的数据订阅插件管理语句提供了对插件进行动态统一管理的入口。
+为了保证用户自定义插件在实际生产中的灵活性和易用性,系统还需要提供对插件进行动态统一管理的能力。
+本章节介绍的流处理插件管理语句提供了对插件进行动态统一管理的入口。
### 加载插件语句
-在 IoTDB 中,若要在系统中动态载入一个用户自定义插件,则首先需要基于 PipeExtractor、 PipeProcessor 或者 PipeConnector 实现一个具体的插件类,然后需要将插件类编译打包成 jar 可执行文件,最后使用加载插件的管理语句将插件载入 IoTDB。
+在 IoTDB 中,若要在系统中动态载入一个用户自定义插件,则首先需要基于 PipeExtractor、 PipeProcessor 或者 PipeConnector 实现一个具体的插件类,
+然后需要将插件类编译打包成 jar 可执行文件,最后使用加载插件的管理语句将插件载入 IoTDB。
加载插件的管理语句的语法如图所示。
@@ -819,7 +455,9 @@ AS <全类名>
USING <JAR 包的 URI>
```
-例如,用户实现了一个全类名为 edu.tsinghua.iotdb.pipe.ExampleProcessor 的数据处理插件,打包后的 jar 资源包存放到了 https://example.com:8080/iotdb/pipe-plugin.jar 上,用户希望在同步引擎中使用这个插件,将插件标记为 example。那么,这个数据处理插件的创建语句如图所示。
+例如,用户实现了一个全类名为 edu.tsinghua.iotdb.pipe.ExampleProcessor 的数据处理插件,
+打包后的 jar 资源包存放到了 https://example.com:8080/iotdb/pipe-plugin.jar 上,用户希望在流处理引擎中使用这个插件,
+将插件标记为 example。那么,这个数据处理插件的创建语句如图所示。
```sql
CREATE PIPEPLUGIN example
@@ -843,25 +481,279 @@ DROP PIPEPLUGIN <别名>
SHOW PIPEPLUGINS
```
+## 系统预置的流处理插件
+
+### 预置 extractor 插件
+
+#### iotdb-extractor
+
+作用:抽取 IoTDB 内部的历史或实时数据进入 pipe。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ---------------------------- | ------------------------------------------------ | -------------------------------------- | --------------------------------- |
+| extractor | iotdb-extractor | String: iotdb-extractor | required |
+| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
+| extractor.history.enable | 是否抽取历史数据 | Boolean: true, false | optional: true |
+| extractor.history.start-time | 抽取的历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
+| extractor.history.end-time | 抽取的历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
+| extractor.realtime.enable | 是否抽取实时数据 | Boolean: true, false | optional: true |
+
+> 🚫 **extractor.pattern 参数说明**
+>
+> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
+> * 在底层实现中,当检测到 pattern 为 root(默认值)时,抽取效率较高,其他任意格式都将降低性能
+> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
+>
+> * root.aligned.1TS
+> * root.aligned.1TS.\`1\`
+> * root.aligned.100T
+>
+> 的数据会被抽取;
+>
+> * root.aligned.\`1\`
+> * root.aligned.\`123\`
+>
+> 的数据不会被抽取。
+
+> ❗️**extractor.history 的 start-time,end-time 参数说明**
+>
+> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
+
+> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
+>
+> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
+> * **arrival time:** 数据到达 IoTDB 系统内的时间。
+>
+> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
+
+> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
+>
+> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
+> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
+>
+> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
+>
+> 用户可以指定 iotdb-extractor 进行:
+>
+> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
+> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
+> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
+> * 禁止同时设置 `extractor.history.enable` 和 `extractor.realtime.enable` 为 `false`
+
+### 预置 processor 插件
+
+#### do-nothing-processor
+
+作用:不对 extractor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| processor | do-nothing-processor | String: do-nothing-processor | required |
+
+### 预置 connector 插件
+
+#### do-nothing-connector
+
+作用:不对 processor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| connector | do-nothing-connector | String: do-nothing-connector | required |
+
+## 流处理任务管理
+
+### 创建流处理任务
+
+使用 `CREATE PIPE` 语句来创建流处理任务。以数据同步流处理任务的创建为例,示例 SQL 语句如下:
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流处理任务的名字
+WITH EXTRACTOR (
+ -- 默认的 IoTDB 数据抽取插件
+ 'extractor' = 'iotdb-extractor',
+ -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
+ 'extractor.pattern' = 'root.timecho',
+ -- 是否抽取历史数据
+ 'extractor.history.enable' = 'true',
+ -- 描述被抽取的历史数据的时间范围,表示最早时间
+ 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
+ -- 描述被抽取的历史数据的时间范围,表示最晚时间
+ 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
+ -- 是否抽取实时数据
+ 'extractor.realtime.enable' = 'true',
+)
+WITH PROCESSOR (
+ -- 默认的数据处理插件,即不做任何处理
+ 'processor' = 'do-nothing-processor',
+)
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+**创建流处理任务时需要配置 PipeId 以及三个插件部分的参数:**
+
+
+| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
+| --------- | --------------------------------------------------- | --------------------------- | -------------------- | -------------------------------------------------------- | ------------------------- |
+| PipeId | 全局唯一标定一个流处理任务的名称 | <font color=red>必填</font> | - | - | - |
+| extractor | Pipe Extractor 插件,负责在数据库底层抽取流处理数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入流处理任务 | 否 |
+| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
+| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
+
+示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据流处理任务。IoTDB 还内置了其他的流处理插件,**请查看“系统预置流处理插件”一节**。
+
+**一个最简的 CREATE PIPE 语句示例如下:**
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流处理任务的名字
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
+
+**注意:**
+
+- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
+- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
+- CONNECTOR 具备自复用能力。对于不同的流处理任务,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
+
+ - 例如,有下面 pipe1, pipe2 两个流处理任务的声明:
+
+ ```sql
+ CREATE PIPE pipe1
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.host' = 'localhost',
+ 'connector.thrift.port' = '9999',
+ )
+
+ CREATE PIPE pipe2
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.port' = '9999',
+ 'connector.thrift.host' = 'localhost',
+ )
+ ```
+
+ - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
+- 请不要构建出包含数据循环同步的应用场景(会导致无限循环):
+
+ - IoTDB A -> IoTDB B -> IoTDB A
+ - IoTDB A -> IoTDB A
+
+### 启动流处理任务
+
+CREATE PIPE 语句成功执行后,流处理任务相关实例会被创建,但整个流处理任务的运行状态会被置为 STOPPED,即流处理任务不会立刻处理数据。
+
+可以使用 START PIPE 语句使流处理任务开始处理数据:
+
+```sql
+START PIPE <PipeId>
+```
+
+### 停止流处理任务
+
+使用 STOP PIPE 语句使流处理任务停止处理数据:
+
+```sql
+STOP PIPE <PipeId>
+```
+
+### 删除流处理任务
+
+使用 DROP PIPE 语句使流处理任务停止处理数据(当流处理任务状态为 RUNNING 时),然后删除整个流处理任务流处理任务:
+
+```sql
+DROP PIPE <PipeId>
+```
+
+用户在删除流处理任务前,不需要执行 STOP 操作。
+
+### 展示流处理任务
+
+使用 SHOW PIPES 语句查看所有流处理任务:
+
+```sql
+SHOW PIPES
+```
+
+查询结果如下:
+
+```sql
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+```
+
+可以使用 `<PipeId>` 指定想看的某个流处理任务状态:
+
+```sql
+SHOW PIPE <PipeId>
+```
+
+您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
+
+```sql
+SHOW PIPES
+WHERE CONNECTOR USED BY <PipeId>
+```
+
+### 流处理任务运行状态迁移
+
+一个流处理 pipe 在其被管理的生命周期中会经过多种状态:
+
+- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
+ - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
+ - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
+ - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
+- **RUNNING:** pipe 正在正常工作
+- **DROPPED:** pipe 任务被永久删除
+
+下图表明了所有状态以及状态的迁移:
+
+
+
## 权限管理
-### Pipe 任务
+### 流处理任务
+
+
+| 权限名称 | 描述 |
+| ----------- | -------------------------- |
+| CREATE_PIPE | 注册流处理任务。路径无关。 |
+| START_PIPE | 开启流处理任务。路径无关。 |
+| STOP_PIPE | 停止流处理任务。路径无关。 |
+| DROP_PIPE | 卸载流处理任务。路径无关。 |
+| SHOW_PIPES | 查询流处理任务。路径无关。 |
-| 权限名称 | 描述 |
-| ----------- | ---------------------- |
-| CREATE_PIPE | 注册流水线。路径无关。 |
-| START_PIPE | 开启流水线。路径无关。 |
-| STOP_PIPE | 停止流水线。路径无关。 |
-| DROP_PIPE | 卸载流水线。路径无关。 |
-| SHOW_PIPES | 查询流水线。路径无关。 |
+### 流处理任务插件
-### Pipe 插件
-| 权限名称 | 描述 |
-| ----------------- | -------------------------- |
-| CREATE_PIPEPLUGIN | 注册流水线插件。路径无关。 |
-| DROP_PIPEPLUGIN | 开启流水线插件。路径无关。 |
-| SHOW_PIPEPLUGINS | 查询流水线插件。路径无关。 |
+| 权限名称 | 描述 |
+| ----------------- | ------------------------------ |
+| CREATE_PIPEPLUGIN | 注册流处理任务插件。路径无关。 |
+| DROP_PIPEPLUGIN | 开启流处理任务插件。路径无关。 |
+| SHOW_PIPEPLUGINS | 查询流处理任务插件。路径无关。 |
## 配置参数
@@ -887,47 +779,4 @@ SHOW PIPEPLUGINS
# The connection timeout (in milliseconds) for the thrift client.
# pipe_connector_timeout_ms=900000
-
-# The maximum number of selectors that can be used in the async connector.
-# pipe_async_connector_selector_number=1
-
-# The core number of clients that can be used in the async connector.
-# pipe_async_connector_core_client_number=8
-
-# The maximum number of clients that can be used in the async connector.
-# pipe_async_connector_max_client_number=16
```
-
-## 功能特性
-
-### 最少一次语义保证 **at-least-once**
-
-数据订阅功能向外部系统传输数据时,提供 at-least-once 的传输语义。在大部分场景下,同步功能可提供 exactly-once 保证,即所有数据被恰好同步一次。
-
-但是在以下场景中,可能存在部分数据被同步多次**(断点续传)**的情况:
-
-- 临时的网络故障:某次数据传输请求失败后,系统会进行重试发送,直至到达最大尝试次数
-- Pipe 插件逻辑实现异常:插件运行中抛出错误,系统会进行重试发送,直至到达最大尝试次数
-- 数据节点宕机、重启等导致的数据分区切主:分区变更完成后,受影响的数据会被重新传输
-- 集群不可用:集群可用后,受影响的数据会重新传输
-
-### 源端:数据写入与 Pipe 处理、发送数据异步解耦
-
-数据订阅功能中,数据传输采用的是异步复制模式。
-
-数据订阅与写入操作完全脱钩,不存在对写入关键路径的影响。该机制允许框架在保证持续数据订阅的前提下,保持时序数据库的写入速度。
-
-### 源端:可自适应数据写入负载的数据传输策略
-
-支持根据写入负载,动态调整数据传输方式,同步默认使用 TsFile 文件与操作流动态混合传输(`'extractor.realtime.mode'='hybrid'`)。
-
-在数据写入负载高时,优先选择 TsFile 传输的方式。TsFile 压缩比高,节省网络带宽。
-
-在数据写入负载低时,优先选择操作流同步传输的方式。操作流传输实时性高。
-
-### 源端:高可用集群部署时,Pipe 服务高可用
-
-当发送端 IoTDB 为高可用集群部署模式时,数据订阅服务也将是高可用的。 数据订阅框架将监控每个数据节点的数据订阅进度,并定期做轻量级的分布式一致性快照以保存同步状态。
-
-- 当发送端集群某数据节点宕机时,数据订阅框架可以利用一致性快照以及保存在副本上的数据快速恢复同步,以此实现数据订阅服务的高可用。
-- 当发送端集群整体宕机并重启时,数据订阅框架也能使用快照恢复同步服务。
diff --git a/src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md b/src/zh/UserGuide/V1.2.x/User-Manual/Streaming_timecho.md
similarity index 58%
rename from src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md
rename to src/zh/UserGuide/V1.2.x/User-Manual/Streaming_timecho.md
index fe70bfc..1951392 100644
--- a/src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Pipe_timecho.md
+++ b/src/zh/UserGuide/V1.2.x/User-Manual/Streaming_timecho.md
@@ -7,9 +7,9 @@
to you under the Apache License, Version 2.0 (the
"License"); you may not use this file except in compliance
with the License. You may obtain a copy of the License at
-
+
http://www.apache.org/licenses/LICENSE-2.0
-
+
Unless required by applicable law or agreed to in writing,
software distributed under the License is distributed on an
"AS IS" BASIS, WITHOUT WARRANTIES OR CONDITIONS OF ANY
@@ -19,399 +19,30 @@
-->
-# IoTDB 数据订阅
+# IoTDB 流处理框架
-**IoTDB 数据订阅功能可以将 IoTDB 的数据传输到另一个数据平台,我们将<font color=RED>一个数据订阅任务称为 Pipe</font>。**
+IoTDB 流处理框架允许用户实现自定义的流处理逻辑,可以实现对存储引擎变更的监听和捕获、实现对变更数据的变形、实现对变形后数据的向外推送等逻辑。
-**一个 Pipe 包含三个子任务(插件):**
+我们将<font color=RED>一个数据流处理任务称为 Pipe</font>。一个流处理任务(Pipe)包含三个子任务:
- 抽取(Extract)
- 处理(Process)
- 发送(Connect)
-**Pipe 允许用户自定义三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。** 在一个 Pipe 中,上述的子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
+流处理框架允许用户使用 Java 语言自定义编写三个子任务的处理逻辑,通过类似 UDF 的方式处理数据。
+在一个 Pipe 中,上述的三个子任务分别由三种插件执行实现,数据会依次经过这三个插件进行处理:
+Pipe Extractor 用于抽取数据,Pipe Processor 用于处理数据,Pipe Connector 用于发送数据,最终数据将被发至外部系统。
**Pipe 任务的模型如下:**

+描述一个数据流处理任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。
+用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
+利用流处理框架,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
-描述一个数据订阅任务,本质就是描述 Pipe Extractor、Pipe Processor 和 Pipe Connector 插件的属性。用户可以通过 SQL 语句声明式地配置三个子任务的具体属性,通过组合不同的属性,实现灵活的数据 ETL 能力。
-
-利用数据订阅功能,可以搭建完整的数据链路来满足端*边云同步、异地灾备、读写负载分库*等需求。
-
-## 快速开始
-
-**🎯 目标:实现 IoTDB A -> IoTDB B 的全量数据订阅**
-
-- 启动两个 IoTDB,A(datanode -> 127.0.0.1:6667) B(datanode -> 127.0.0.1:6668)
-
-- 创建 A -> B 的 Pipe,在 A 上执行
-
- ```sql
- create pipe a2b
- with connector (
- 'connector'='iotdb-thrift-connector',
- 'connector.ip'='127.0.0.1',
- 'connector.port'='6668'
- )
- ```
-
-- 启动 A -> B 的 Pipe,在 A 上执行
-
- ```sql
- start pipe a2b
- ```
-
-- 向 A 写入数据
-
- ```sql
- INSERT INTO root.db.d(time, m) values (1, 1)
- ```
-
-- 在 B 检查由 A 同步过来的数据
-
- ```sql
- SELECT ** FROM root
- ```
-
-> ❗️**注:目前的 IoTDB -> IoTDB 的数据订阅实现并不支持 DDL 同步**
->
-> 即:不支持 ttl,trigger,别名,模板,视图,创建/删除序列,创建/删除存储组等操作
->
-> **IoTDB -> IoTDB 的数据订阅要求目标端 IoTDB:**
->
-> * 开启自动创建元数据:需要人工配置数据类型的编码和压缩与发送端保持一致
-> * 不开启自动创建元数据:手工创建与源端一致的元数据
-
-## Pipe 同步任务管理
-
-### 创建流水线
-
-可以使用 `CREATE PIPE` 语句来创建一条数据订阅任务,SQL 语句如下所示:
-
-```sql
-CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流水线任务的名字
-WITH EXTRACTOR (
- -- 默认的 IoTDB 数据抽取插件
- 'extractor' = 'iotdb-extractor',
- -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
- 'extractor.pattern' = 'root.timecho',
- -- 是否抽取历史数据
- 'extractor.history.enable' = 'true',
- -- 描述被抽取的历史数据的时间范围,表示最早时间
- 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
- -- 描述被抽取的历史数据的时间范围,表示最晚时间
- 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
- -- 是否抽取实时数据
- 'extractor.realtime.enable' = 'true',
- -- 描述实时数据的抽取方式
- 'extractor.realtime.mode' = 'hybrid',
-)
-WITH PROCESSOR (
- -- 默认的数据处理插件,即不做任何处理
- 'processor' = 'do-nothing-processor',
-)
-WITH CONNECTOR (
- -- IoTDB 数据发送插件,目标端为 IoTDB
- 'connector' = 'iotdb-thrift-connector',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
- 'connector.ip' = '127.0.0.1',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
- 'connector.port' = '6667',
-)
-```
-
-**创建流水线时需要配置 PipeId 以及三个插件部分的参数:**
-
-| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
-| --------- | ------------------------------------------------- | --------------------------- | -------------------- | -------------------------------------------------------- | ------------------------- |
-| PipeId | 全局唯一标定一个同步流水线的名称 | <font color=red>必填</font> | - | - | - |
-| extractor | Pipe Extractor 插件,负责在数据库底层抽取同步数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入同步流水线 | 否 |
-| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
-| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
-
-示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据订阅任务。IoTDB 还内置了其他的数据订阅插件,**请查看“系统预置数据订阅插件”一节**。
-
-**一个最简的 CREATE PIPE 语句示例如下:**
-
-```sql
-CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流水线任务的名字
-WITH CONNECTOR (
- -- IoTDB 数据发送插件,目标端为 IoTDB
- 'connector' = 'iotdb-thrift-connector',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
- 'connector.ip' = '127.0.0.1',
- -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
- 'connector.port' = '6667',
-)
-```
-
-其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
-
-**注意:**
-
-- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
-
-- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
-
-- CONNECTOR 具备自复用能力。对于不同的流水线,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
-
- - 例如,有下面 pipe1, pipe2 两个流水线的声明:
-
- ```sql
- CREATE PIPE pipe1
- WITH CONNECTOR (
- 'connector' = 'iotdb-thrift-connector',
- 'connector.thrift.host' = 'localhost',
- 'connector.thrift.port' = '9999',
- )
-
- CREATE PIPE pipe2
- WITH CONNECTOR (
- 'connector' = 'iotdb-thrift-connector',
- 'connector.thrift.port' = '9999',
- 'connector.thrift.host' = 'localhost',
- )
- ```
-
- - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
-
-- 请不要构建出包含数据循环同步的应用场景(会导致无限循环):
-
- - IoTDB A -> IoTDB B -> IoTDB A
- - IoTDB A -> IoTDB A
-
-### 启动流水线
-
-CREATE PIPE 语句成功执行后,流水线相关实例会被创建,但整个流水线的运行状态会被置为 STOPPED,即流水线不会立刻处理数据。
-
-可以使用 START PIPE 语句使流水线开始处理数据:
-
-```sql
-START PIPE <PipeId>
-```
-
-### 停止流水线
-
-使用 STOP PIPE 语句使流水线停止处理数据:
-
-```sql
-STOP PIPE <PipeId>
-```
-
-### 删除流水线
-
-使用 DROP PIPE 语句使流水线停止处理数据(当流水线状态为 RUNNING 时),然后删除整个流水线同步任务:
-
-```sql
-DROP PIPE <PipeId>
-```
-
-用户在删除流水线前,不需要执行 STOP 操作。
-
-### 展示流水线
-
-使用 SHOW PIPES 语句查看所有流水线:
-
-```sql
-SHOW PIPES
-```
-
-查询结果如下:
-
-```sql
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
-+-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
-```
-
-可以使用 `<PipeId>` 指定想看的某个同步任务状态:
-
-```sql
-SHOW PIPE <PipeId>
-```
-
-您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
-
-```sql
-SHOW PIPES
-WHERE CONNECTOR USED BY <PipeId>
-```
-
-### 流水线运行状态迁移
-
-一个数据订阅 pipe 在其被管理的生命周期中会经过多种状态:
-
-- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
- - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
- - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
- - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
-- **RUNNING:** pipe 正在正常工作
-- **DROPPED:** pipe 任务被永久删除
-
-下图表明了所有状态以及状态的迁移:
-
-
-
-## **系统预置数据订阅插件**
-
-### 预置 extractor
-
-#### iotdb-extractor
-
-作用:抽取 IoTDB 内部的历史或实时数据进入流水线。
-
-| key | value | value 取值范围 | required or optional with default |
-| ---------------------------- | ---------------------------------------------- | -------------------------------------- | --------------------------------- |
-| extractor | iotdb-extractor | String: iotdb-extractor | required |
-| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
-| extractor.history.enable | 是否同步历史数据 | Boolean: true, false | optional: true |
-| extractor.history.start-time | 同步历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
-| extractor.history.end-time | 同步历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
-| extractor.realtime.enable | 是否同步实时数据 | Boolean: true, false | optional: true |
-| extractor.realtime.mode | 实时数据的抽取模式 | String: hybrid, log, file | optional: hybrid |
-
-> 🚫 **extractor.pattern 参数说明**
->
-> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
->
-> * 在底层实现中,当检测到 pattern 为 root(默认值)时,同步效率较高,其他任意格式都将降低性能
->
-> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
->
-> * root.aligned.1TS
-> * root.aligned.1TS.\`1\`
-> * root.aligned.100TS
->
-> 的数据会被同步;
->
-> * root.aligned.\`1\`
-> * root.aligned.\`123\`
->
-> 的数据不会被同步。
->
-> * root.\_\_system 的数据不会被 pipe 抽取,即不会被同步到目标端。用户虽然可以在 extractor.pattern 中包含任意前缀,包括带有(或覆盖) root.\__system 的前缀,但是 root.__system 下的数据总是会被 pipe 忽略的
-
-
-
-> ❗️**extractor.history 的 start-time,end-time 参数说明**
->
-> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
-
-
-
-> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
->
-> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
-> * **arrival time:** 数据到达 IoTDB 系统内的时间。
->
-> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
-
-
-
-> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
->
-> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
-> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
->
-> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
->
-> 用户可以指定 iotdb-extractor 进行:
->
-> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
-> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
-> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
-> * 禁止同时设置 extractor.history.enable 和 extractor.relatime.enable 为 false
-
-
-
-> 📌 **extractor.realtime.mode:数据抽取的模式**
->
-> * log:该模式下,流水线仅使用操作日志进行数据处理、发送
-> * file:该模式下,流水线仅使用数据文件进行数据处理、发送
-> * hybrid:该模式,考虑了按操作日志逐条目发送数据时延迟低但吞吐低的特点,以及按数据文件批量发送时发送吞吐高但延迟高的特点,能够在不同的写入负载下自动切换适合的数据抽取方式,首先采取基于操作日志的数据抽取方式以保证低发送延迟,当产生数据积压时自动切换成基于数据文件的数据抽取方式以保证高发送吞吐,积压消除时自动切换回基于操作日志的数据抽取方式,避免了采用单一数据抽取算法难以平衡数据发送延迟或吞吐的问题。
-
-### 预置 processor
-
-#### do-nothing-processor
-
-作用:不对 extractor 传入的事件做任何的处理。
-
-| key | value | value 取值范围 | required or optional with default |
-| --------- | -------------------- | ---------------------------- | --------------------------------- |
-| processor | do-nothing-processor | String: do-nothing-processor | required |
-
-### 预置 connector
-
-#### iotdb-thrift-sync-connector(别名:iotdb-thrift-connector)
-
-作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
-使用 Thrift RPC 框架传输数据,单线程 blocking IO 模型。
-保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致。
-
-限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
-
-| key | value | value 取值范围 | required or optional with default |
-| -------------- | --------------------------------------------------- |---------------------------------------------------------------------------|------------------------------------------|
-| connector | iotdb-thrift-connector 或 iotdb-thrift-sync-connector | String: iotdb-thrift-connector 或 iotdb-thrift-sync-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
-| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### iotdb-thrift-async-connector
-
-作用:主要用于 IoTDB(v1.2.0+)与 IoTDB(v1.2.0+)之间的数据传输。
-使用 Thrift RPC 框架传输数据,多线程 async non-blocking IO 模型,传输性能高,尤其适用于目标端为分布式时的场景。
-不保证接收端 apply 数据的顺序与发送端接受写入请求的顺序一致,但是保证数据发送的完整性(at-least-once)。
-
-限制:源端 IoTDB 与 目标端 IoTDB 版本都需要在 v1.2.0+。
-
-| key | value | value 取值范围 | required or optional with default |
-| -------------- |-------------------------------------------------------|---------------------------------------------------------------------------|------------------------------------------|
-| connector | iotdb-thrift-async-connector | String: iotdb-thrift-async-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | optional: 与 connector.node-urls 任选其一填写 |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | optional: 与 connector.node-urls 任选其一填写 |
-| connector.node-urls | 目标端 IoTDB 任意多个 DataNode 节点的数据服务端口的 url | String。例:'127.0.0.1:6667,127.0.0.1:6668,127.0.0.1:6669', '127.0.0.1:6667' | optional: 与 connector.ip:connector.port 任选其一填写 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### iotdb-legacy-pipe-connector
-
-作用:主要用于 IoTDB(v1.2.0+)向更低版本的 IoTDB 传输数据,使用 v1.2.0 版本前的数据同步(Sync)协议。
-使用 Thrift RPC 框架传输数据。单线程 sync blocking IO 模型,传输性能较弱。
-
-限制:源端 IoTDB 版本需要在 v1.2.0+,目标端 IoTDB 版本可以是 v1.2.0+、v1.1.x(更低版本的 IoTDB 理论上也支持,但是未经测试)。
-
-注意:理论上 v1.2.0+ IoTDB 可作为 v1.2.0 版本前的任意版本的数据同步(Sync)接收端。
-
-| key | value | value 取值范围 | required or optional with default |
-| ------------------ | ------------------------------------------------------------ | ---------------------------- | --------------------------------- |
-| connector | iotdb-legacy-pipe-connector | String: iotdb-legacy-pipe-connector | required |
-| connector.ip | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip | String | required |
-| connector.port | 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port | Integer | required |
-| connector.user | 目标端 IoTDB 的用户名,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
-| connector.password | 目标端 IoTDB 的密码,注意该用户需要支持数据写入、TsFile Load 的权限 | String | optional: root |
-| connector.version | 目标端 IoTDB 的版本,用于伪装自身实际版本,绕过目标端的版本一致性检查 | String | optional: 1.1 |
-
-> 📌 请确保接收端已经创建了发送端的所有时间序列,或是开启了自动创建元数据,否则将会导致 pipe 运行失败。
-
-#### do-nothing-connector
-
-作用:不对 processor 传入的事件做任何的处理。
-
-| key | value | value 取值范围 | required or optional with default |
-| --------- | -------------------- | ---------------------------- | --------------------------------- |
-| connector | do-nothing-connector | String: do-nothing-connector | required |
-
-## 自定义数据订阅插件开发
+## 自定义流处理插件开发
### 编程开发依赖
@@ -421,18 +52,18 @@ WHERE CONNECTOR USED BY <PipeId>
<dependency>
<groupId>org.apache.iotdb</groupId>
<artifactId>pipe-api</artifactId>
- <version>1.2.0</version>
+ <version>1.2.1</version>
<scope>provided</scope>
</dependency>
```
### 事件驱动编程模型
-数据订阅插件的用户编程接口设计,参考了事件驱动编程模型的通用设计理念。事件(Event)是用户编程接口中的数据抽象,而编程接口与具体的执行方式解耦,只需要专注于描述事件(数据)到达系统后,系统期望的处理方式即可。
+流处理插件的用户编程接口设计,参考了事件驱动编程模型的通用设计理念。事件(Event)是用户编程接口中的数据抽象,而编程接口与具体的执行方式解耦,只需要专注于描述事件(数据)到达系统后,系统期望的处理方式即可。
-在数据订阅插件的用户编程接口中,事件是数据库数据写入操作的抽象。事件由单机同步引擎捕获,按照同步三个阶段的流程,依次传递至 PipeExtractor 插件,PipeProcessor 插件和 PipeConnector 插件,并依次在三个插件中触发用户逻辑的执行。
+在流处理插件的用户编程接口中,事件是数据库数据写入操作的抽象。事件由单机流处理引擎捕获,按照流处理三个阶段的流程,依次传递至 PipeExtractor 插件,PipeProcessor 插件和 PipeConnector 插件,并依次在三个插件中触发用户逻辑的执行。
-为了兼顾端侧低负载场景下的同步低延迟和端侧高负载场景下的同步高吞吐,同步引擎会动态地在操作日志和数据文件中选择处理对象,因此,同步的用户编程接口要求用户提供下列两类事件的处理逻辑:操作日志写入事件 TabletInsertionEvent 和数据文件写入事件 TsFileInsertionEvent。
+为了兼顾端侧低负载场景下的流处理低延迟和端侧高负载场景下的流处理高吞吐,流处理引擎会动态地在操作日志和数据文件中选择处理对象,因此,流处理的用户编程接口要求用户提供下列两类事件的处理逻辑:操作日志写入事件 TabletInsertionEvent 和数据文件写入事件 TsFileInsertionEvent。
#### **操作日志写入事件(TabletInsertionEvent)**
@@ -474,11 +105,11 @@ IoTDB 的存储引擎是 LSM 结构的。数据写入时会先将写入操作落
在极端的网络情况下,直接传输数据文件相比传输数据写入的操作要更加经济,它会占用更低的网络带宽,能实现更快的传输速度。当然,天下没有免费的午餐,对文件中的数据进行计算处理,相比直接对内存中的数据进行计算处理时,需要额外付出文件 I/O 的代价。但是,正是磁盘数据文件和内存写入操作两种结构各有优劣的存在,给了系统做动态权衡调整的机会,也正是基于这样的观察,插件的事件模型中才引入了数据文件写入事件。
-综上,数据文件写入事件出现在同步插件的事件流中,存在下面两种情况:
+综上,数据文件写入事件出现在流处理插件的事件流中,存在下面两种情况:
-(1)历史数据抽取:一个同步任务开始前,所有已经落盘的写入数据都会以 TsFile 的形式存在。一个同步任务开始后,采集历史数据时,历史数据将以 TsFileInsertionEvent 作为抽象;
+(1)历史数据抽取:一个流处理任务开始前,所有已经落盘的写入数据都会以 TsFile 的形式存在。一个流处理任务开始后,采集历史数据时,历史数据将以 TsFileInsertionEvent 作为抽象;
-(2)实时数据抽取:一个同步任务进行时,当数据流中实时处理操作日志写入事件的速度慢于写入请求速度一定进度之后,未来得及处理的操作日志写入事件会被被持久化至磁盘,以 TsFile 的形式存在,这一些数据被同步引擎采集到后,会以 TsFileInsertionEvent 作为抽象。
+(2)实时数据抽取:一个流处理任务进行时,当数据流中实时处理操作日志写入事件的速度慢于写入请求速度一定进度之后,未来得及处理的操作日志写入事件会被被持久化至磁盘,以 TsFile 的形式存在,这一些数据被流处理引擎抽取到后,会以 TsFileInsertionEvent 作为抽象。
```java
/**
@@ -496,13 +127,14 @@ public interface TsFileInsertionEvent extends Event {
}
```
-### 自定义数据订阅插件编程接口定义
+### 自定义流处理插件编程接口定义
-基于自定义数据订阅插件编程接口,用户可以轻松编写数据抽取插件、 数据处理插件和数据发送插件,从而使得同步功能灵活适配各种工业场景。
+基于自定义流处理插件编程接口,用户可以轻松编写数据抽取插件、数据处理插件和数据发送插件,从而使得流处理功能灵活适配各种工业场景。
#### 数据抽取插件接口
-数据抽取是同步数据从数据抽取到数据发送三阶段的第一阶段。数据抽取插件(PipeExtractor)是同步引擎和存储引擎的桥梁,它通过监听存储引擎的行为,捕获各种数据写入事件。
+数据抽取是流处理数据从数据抽取到数据发送三阶段的第一阶段。数据抽取插件(PipeExtractor)是流处理引擎和存储引擎的桥梁,它通过监听存储引擎的行为,
+捕获各种数据写入事件。
```java
/**
@@ -582,7 +214,8 @@ public interface PipeExtractor extends PipePlugin {
#### 数据处理插件接口
-数据处理是同步数据从数据抽取到数据发送三阶段的第二阶段。数据处理插件(PipeProcessor)主要用于过滤和转换由数据抽取插件(PipeExtractor)捕获的各种事件。
+数据处理是流处理数据从数据抽取到数据发送三阶段的第二阶段。数据处理插件(PipeProcessor)主要用于过滤和转换由数据抽取插件(PipeExtractor)捕获的
+各种事件。
```java
/**
@@ -682,7 +315,8 @@ public interface PipeProcessor extends PipePlugin {
#### 数据发送插件接口
-数据发送是同步数据从数据抽取到数据发送三阶段的第三阶段。数据发送插件(PipeConnector)主要用于发送经由数据处理插件(PipeProcessor)处理过后的各种事件,它作为数据订阅框架的网络实现层,接口上应允许接入多种实时通信协议和多种连接器。
+数据发送是流处理数据从数据抽取到数据发送三阶段的第三阶段。数据发送插件(PipeConnector)主要用于发送经由数据处理插件(PipeProcessor)处理过后的
+各种事件,它作为流处理框架的网络实现层,接口上应允许接入多种实时通信协议和多种连接器。
```java
/**
@@ -803,13 +437,15 @@ public interface PipeConnector extends PipePlugin {
}
```
-## 自定义数据订阅插件管理
+## 自定义流处理插件管理
-为了保证用户自定义插件在实际生产中的灵活性和易用性,系统还需要提供对插件进行动态统一管理的能力。本章节介绍的数据订阅插件管理语句提供了对插件进行动态统一管理的入口。
+为了保证用户自定义插件在实际生产中的灵活性和易用性,系统还需要提供对插件进行动态统一管理的能力。
+本章节介绍的流处理插件管理语句提供了对插件进行动态统一管理的入口。
### 加载插件语句
-在 IoTDB 中,若要在系统中动态载入一个用户自定义插件,则首先需要基于 PipeExtractor、 PipeProcessor 或者 PipeConnector 实现一个具体的插件类,然后需要将插件类编译打包成 jar 可执行文件,最后使用加载插件的管理语句将插件载入 IoTDB。
+在 IoTDB 中,若要在系统中动态载入一个用户自定义插件,则首先需要基于 PipeExtractor、 PipeProcessor 或者 PipeConnector 实现一个具体的插件类,
+然后需要将插件类编译打包成 jar 可执行文件,最后使用加载插件的管理语句将插件载入 IoTDB。
加载插件的管理语句的语法如图所示。
@@ -819,7 +455,9 @@ AS <全类名>
USING <JAR 包的 URI>
```
-例如,用户实现了一个全类名为 edu.tsinghua.iotdb.pipe.ExampleProcessor 的数据处理插件,打包后的 jar 资源包存放到了 https://example.com:8080/iotdb/pipe-plugin.jar 上,用户希望在同步引擎中使用这个插件,将插件标记为 example。那么,这个数据处理插件的创建语句如图所示。
+例如,用户实现了一个全类名为 edu.tsinghua.iotdb.pipe.ExampleProcessor 的数据处理插件,
+打包后的 jar 资源包存放到了 https://example.com:8080/iotdb/pipe-plugin.jar 上,用户希望在流处理引擎中使用这个插件,
+将插件标记为 example。那么,这个数据处理插件的创建语句如图所示。
```sql
CREATE PIPEPLUGIN example
@@ -843,25 +481,295 @@ DROP PIPEPLUGIN <别名>
SHOW PIPEPLUGINS
```
+## 系统预置的流处理插件
+
+### 预置 extractor 插件
+
+#### iotdb-extractor
+
+作用:抽取 IoTDB 内部的历史或实时数据进入 pipe。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| ---------------------------------- | ------------------------------------------------ | -------------------------------------- | --------------------------------- |
+| extractor | iotdb-extractor | String: iotdb-extractor | required |
+| extractor.pattern | 用于筛选时间序列的路径前缀 | String: 任意的时间序列前缀 | optional: root |
+| extractor.history.enable | 是否抽取历史数据 | Boolean: true, false | optional: true |
+| extractor.history.start-time | 抽取的历史数据的开始 event time,包含 start-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MIN_VALUE |
+| extractor.history.end-time | 抽取的历史数据的结束 event time,包含 end-time | Long: [Long.MIN_VALUE, Long.MAX_VALUE] | optional: Long.MAX_VALUE |
+| extractor.realtime.enable | 是否抽取实时数据 | Boolean: true, false | optional: true |
+| extractor.realtime.mode | 实时数据的抽取模式 | String: hybrid, log, file | optional: hybrid |
+| extractor.forwarding-pipe-requests | 是否抽取由其他 Pipe (通常是数据同步)写入的数据 | Boolean: true, false | optional: true |
+
+> 🚫 **extractor.pattern 参数说明**
+>
+> * Pattern 需用反引号修饰不合法字符或者是不合法路径节点,例如如果希望筛选 root.\`a@b\` 或者 root.\`123\`,应设置 pattern 为 root.\`a@b\` 或者 root.\`123\`(具体参考 [单双引号和反引号的使用时机](https://iotdb.apache.org/zh/Download/#_1-0-版本不兼容的语法详细说明))
+> * 在底层实现中,当检测到 pattern 为 root(默认值)时,抽取效率较高,其他任意格式都将降低性能
+> * 路径前缀不需要能够构成完整的路径。例如,当创建一个包含参数为 'extractor.pattern'='root.aligned.1' 的 pipe 时:
+ >
+ > * root.aligned.1TS
+> * root.aligned.1TS.\`1\`
+> * root.aligned.100T
+ >
+ > 的数据会被抽取;
+ >
+ > * root.aligned.\`1\`
+> * root.aligned.\`123\`
+ >
+ > 的数据不会被抽取。
+> * root.\_\_system 的数据不会被 pipe 抽取。用户虽然可以在 extractor.pattern 中包含任意前缀,包括带有(或覆盖) root.\__system 的前缀,但是 root.__system 下的数据总是会被 pipe 忽略的
+
+> ❗️**extractor.history 的 start-time,end-time 参数说明**
+>
+> * start-time,end-time 应为 ISO 格式,例如 2011-12-03T10:15:30 或 2011-12-03T10:15:30+01:00
+
+> ✅ **一条数据从生产到落库 IoTDB,包含两个关键的时间概念**
+>
+> * **event time:** 数据实际生产时的时间(或者数据生产系统给数据赋予的生成时间,是数据点中的时间项),也称为事件时间。
+> * **arrival time:** 数据到达 IoTDB 系统内的时间。
+>
+> 我们常说的乱序数据,指的是数据到达时,其 **event time** 远落后于当前系统时间(或者已经落库的最大 **event time**)的数据。另一方面,不论是乱序数据还是顺序数据,只要它们是新到达系统的,那它们的 **arrival time** 都是会随着数据到达 IoTDB 的顺序递增的。
+
+> 💎 **iotdb-extractor 的工作可以拆分成两个阶段**
+>
+> 1. 历史数据抽取:所有 **arrival time** < 创建 pipe 时**当前系统时间**的数据称为历史数据
+> 2. 实时数据抽取:所有 **arrival time** >= 创建 pipe 时**当前系统时间**的数据称为实时数据
+>
+> 历史数据传输阶段和实时数据传输阶段,**两阶段串行执行,只有当历史数据传输阶段完成后,才执行实时数据传输阶段。**
+>
+> 用户可以指定 iotdb-extractor 进行:
+>
+> * 历史数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'false'` )
+> * 实时数据抽取(`'extractor.history.enable' = 'false'`, `'extractor.realtime.enable' = 'true'` )
+> * 全量数据抽取(`'extractor.history.enable' = 'true'`, `'extractor.realtime.enable' = 'true'` )
+> * 禁止同时设置 `extractor.history.enable` 和 `extractor.realtime.enable` 为 `false`
+
+> 📌 **extractor.realtime.mode:数据抽取的模式**
+>
+> * log:该模式下,任务仅使用操作日志进行数据处理、发送
+> * file:该模式下,任务仅使用数据文件进行数据处理、发送
+> * hybrid:该模式,考虑了按操作日志逐条目发送数据时延迟低但吞吐低的特点,以及按数据文件批量发送时发送吞吐高但延迟高的特点,能够在不同的写入负载下自动切换适合的数据抽取方式,首先采取基于操作日志的数据抽取方式以保证低发送延迟,当产生数据积压时自动切换成基于数据文件的数据抽取方式以保证高发送吞吐,积压消除时自动切换回基于操作日志的数据抽取方式,避免了采用单一数据抽取算法难以平衡数据发送延迟或吞吐的问题。
+
+> 🍕 **extractor.forwarding-pipe-requests:是否允许转发从另一 pipe 传输而来的数据**
+>
+> * 如果要使用 pipe 构建 A -> B -> C 的数据同步,那么 B -> C 的 pipe 需要将该参数为 true 后,A -> B 中 A 通过 pipe 写入 B 的数据才能被正确转发到 C
+> * 如果要使用 pipe 构建 A \<-> B 的双向数据同步(双活),那么 A -> B 和 B -> A 的 pipe 都需要将该参数设置为 false,否则将会造成数据无休止的集群间循环转发
+
+### 预置 processor 插件
+
+#### do-nothing-processor
+
+作用:不对 extractor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| processor | do-nothing-processor | String: do-nothing-processor | required |
+
+### 预置 connector 插件
+
+#### do-nothing-connector
+
+作用:不对 processor 传入的事件做任何的处理。
+
+
+| key | value | value 取值范围 | required or optional with default |
+| --------- | -------------------- | ---------------------------- | --------------------------------- |
+| connector | do-nothing-connector | String: do-nothing-connector | required |
+
+## 流处理任务管理
+
+### 创建流处理任务
+
+使用 `CREATE PIPE` 语句来创建流处理任务。以数据同步流处理任务的创建为例,示例 SQL 语句如下:
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流处理任务的名字
+WITH EXTRACTOR (
+ -- 默认的 IoTDB 数据抽取插件
+ 'extractor' = 'iotdb-extractor',
+ -- 路径前缀,只有能够匹配该路径前缀的数据才会被抽取,用作后续的处理和发送
+ 'extractor.pattern' = 'root.timecho',
+ -- 是否抽取历史数据
+ 'extractor.history.enable' = 'true',
+ -- 描述被抽取的历史数据的时间范围,表示最早时间
+ 'extractor.history.start-time' = '2011.12.03T10:15:30+01:00',
+ -- 描述被抽取的历史数据的时间范围,表示最晚时间
+ 'extractor.history.end-time' = '2022.12.03T10:15:30+01:00',
+ -- 是否抽取实时数据
+ 'extractor.realtime.enable' = 'true',
+ -- 描述实时数据的抽取方式
+ 'extractor.realtime.mode' = 'hybrid',
+)
+WITH PROCESSOR (
+ -- 默认的数据处理插件,即不做任何处理
+ 'processor' = 'do-nothing-processor',
+)
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+**创建流处理任务时需要配置 PipeId 以及三个插件部分的参数:**
+
+
+| 配置项 | 说明 | 是否必填 | 默认实现 | 默认实现说明 | 是否允许自定义实现 |
+| --------- | --------------------------------------------------- | --------------------------- | -------------------- | -------------------------------------------------------- | ------------------------- |
+| PipeId | 全局唯一标定一个流处理任务的名称 | <font color=red>必填</font> | - | - | - |
+| extractor | Pipe Extractor 插件,负责在数据库底层抽取流处理数据 | 选填 | iotdb-extractor | 将数据库的全量历史数据和后续到达的实时数据接入流处理任务 | 否 |
+| processor | Pipe Processor 插件,负责处理数据 | 选填 | do-nothing-processor | 对传入的数据不做任何处理 | <font color=red>是</font> |
+| connector | Pipe Connector 插件,负责发送数据 | <font color=red>必填</font> | - | - | <font color=red>是</font> |
+
+示例中,使用了 iotdb-extractor、do-nothing-processor 和 iotdb-thrift-connector 插件构建数据流处理任务。IoTDB 还内置了其他的流处理插件,**请查看“系统预置流处理插件”一节**。
+
+**一个最简的 CREATE PIPE 语句示例如下:**
+
+```sql
+CREATE PIPE <PipeId> -- PipeId 是能够唯一标定流处理任务的名字
+WITH CONNECTOR (
+ -- IoTDB 数据发送插件,目标端为 IoTDB
+ 'connector' = 'iotdb-thrift-connector',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 ip
+ 'connector.ip' = '127.0.0.1',
+ -- 目标端 IoTDB 其中一个 DataNode 节点的数据服务 port
+ 'connector.port' = '6667',
+)
+```
+
+其表达的语义是:将本数据库实例中的全量历史数据和后续到达的实时数据,同步到目标为 127.0.0.1:6667 的 IoTDB 实例上。
+
+**注意:**
+
+- EXTRACTOR 和 PROCESSOR 为选填配置,若不填写配置参数,系统则会采用相应的默认实现
+- CONNECTOR 为必填配置,需要在 CREATE PIPE 语句中声明式配置
+- CONNECTOR 具备自复用能力。对于不同的流处理任务,如果他们的 CONNECTOR 具备完全相同 KV 属性的(所有属性的 key 对应的 value 都相同),**那么系统最终只会创建一个 CONNECTOR 实例**,以实现对连接资源的复用。
+
+ - 例如,有下面 pipe1, pipe2 两个流处理任务的声明:
+
+ ```sql
+ CREATE PIPE pipe1
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.host' = 'localhost',
+ 'connector.thrift.port' = '9999',
+ )
+
+ CREATE PIPE pipe2
+ WITH CONNECTOR (
+ 'connector' = 'iotdb-thrift-connector',
+ 'connector.thrift.port' = '9999',
+ 'connector.thrift.host' = 'localhost',
+ )
+ ```
+
+ - 因为它们对 CONNECTOR 的声明完全相同(**即使某些属性声明时的顺序不同**),所以框架会自动对它们声明的 CONNECTOR 进行复用,最终 pipe1, pipe2 的CONNECTOR 将会是同一个实例。
+- 在 extractor 为默认的 iotdb-extractor,且 extractor.forwarding-pipe-requests 为默认值 true 时,请不要构建出包含数据循环同步的应用场景(会导致无限循环):
+
+ - IoTDB A -> IoTDB B -> IoTDB A
+ - IoTDB A -> IoTDB A
+
+### 启动流处理任务
+
+CREATE PIPE 语句成功执行后,流处理任务相关实例会被创建,但整个流处理任务的运行状态会被置为 STOPPED,即流处理任务不会立刻处理数据。
+
+可以使用 START PIPE 语句使流处理任务开始处理数据:
+
+```sql
+START PIPE <PipeId>
+```
+
+### 停止流处理任务
+
+使用 STOP PIPE 语句使流处理任务停止处理数据:
+
+```sql
+STOP PIPE <PipeId>
+```
+
+### 删除流处理任务
+
+使用 DROP PIPE 语句使流处理任务停止处理数据(当流处理任务状态为 RUNNING 时),然后删除整个流处理任务流处理任务:
+
+```sql
+DROP PIPE <PipeId>
+```
+
+用户在删除流处理任务前,不需要执行 STOP 操作。
+
+### 展示流处理任务
+
+使用 SHOW PIPES 语句查看所有流处理任务:
+
+```sql
+SHOW PIPES
+```
+
+查询结果如下:
+
+```sql
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+| ID| CreationTime | State|PipeExtractor|PipeProcessor|PipeConnector|ExceptionMessage|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-kafka|2022-03-30T20:58:30.689|RUNNING| ...| ...| ...| None|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+|iotdb-iotdb|2022-03-31T12:55:28.129|STOPPED| ...| ...| ...| TException: ...|
++-----------+-----------------------+-------+-------------+-------------+-------------+----------------+
+```
+
+可以使用 `<PipeId>` 指定想看的某个流处理任务状态:
+
+```sql
+SHOW PIPE <PipeId>
+```
+
+您也可以通过 where 子句,判断某个 \<PipeId\> 使用的 Pipe Connector 被复用的情况。
+
+```sql
+SHOW PIPES
+WHERE CONNECTOR USED BY <PipeId>
+```
+
+### 流处理任务运行状态迁移
+
+一个流处理 pipe 在其被管理的生命周期中会经过多种状态:
+
+- **STOPPED:** pipe 处于停止运行状态。当管道处于该状态时,有如下几种可能:
+ - 当一个 pipe 被成功创建之后,其初始状态为暂停状态
+ - 用户手动将一个处于正常运行状态的 pipe 暂停,其状态会被动从 RUNNING 变为 STOPPED
+ - 当一个 pipe 运行过程中出现无法恢复的错误时,其状态会自动从 RUNNING 变为 STOPPED
+- **RUNNING:** pipe 正在正常工作
+- **DROPPED:** pipe 任务被永久删除
+
+下图表明了所有状态以及状态的迁移:
+
+
+
## 权限管理
-### Pipe 任务
+### 流处理任务
+
+
+| 权限名称 | 描述 |
+| ----------- | -------------------------- |
+| CREATE_PIPE | 注册流处理任务。路径无关。 |
+| START_PIPE | 开启流处理任务。路径无关。 |
+| STOP_PIPE | 停止流处理任务。路径无关。 |
+| DROP_PIPE | 卸载流处理任务。路径无关。 |
+| SHOW_PIPES | 查询流处理任务。路径无关。 |
-| 权限名称 | 描述 |
-| ----------- | ---------------------- |
-| CREATE_PIPE | 注册流水线。路径无关。 |
-| START_PIPE | 开启流水线。路径无关。 |
-| STOP_PIPE | 停止流水线。路径无关。 |
-| DROP_PIPE | 卸载流水线。路径无关。 |
-| SHOW_PIPES | 查询流水线。路径无关。 |
+### 流处理任务插件
-### Pipe 插件
-| 权限名称 | 描述 |
-| ----------------- | -------------------------- |
-| CREATE_PIPEPLUGIN | 注册流水线插件。路径无关。 |
-| DROP_PIPEPLUGIN | 开启流水线插件。路径无关。 |
-| SHOW_PIPEPLUGINS | 查询流水线插件。路径无关。 |
+| 权限名称 | 描述 |
+| ----------------- | ------------------------------ |
+| CREATE_PIPEPLUGIN | 注册流处理任务插件。路径无关。 |
+| DROP_PIPEPLUGIN | 开启流处理任务插件。路径无关。 |
+| SHOW_PIPEPLUGINS | 查询流处理任务插件。路径无关。 |
## 配置参数
@@ -887,47 +795,4 @@ SHOW PIPEPLUGINS
# The connection timeout (in milliseconds) for the thrift client.
# pipe_connector_timeout_ms=900000
-
-# The maximum number of selectors that can be used in the async connector.
-# pipe_async_connector_selector_number=1
-
-# The core number of clients that can be used in the async connector.
-# pipe_async_connector_core_client_number=8
-
-# The maximum number of clients that can be used in the async connector.
-# pipe_async_connector_max_client_number=16
```
-
-## 功能特性
-
-### 最少一次语义保证 **at-least-once**
-
-数据订阅功能向外部系统传输数据时,提供 at-least-once 的传输语义。在大部分场景下,同步功能可提供 exactly-once 保证,即所有数据被恰好同步一次。
-
-但是在以下场景中,可能存在部分数据被同步多次**(断点续传)**的情况:
-
-- 临时的网络故障:某次数据传输请求失败后,系统会进行重试发送,直至到达最大尝试次数
-- Pipe 插件逻辑实现异常:插件运行中抛出错误,系统会进行重试发送,直至到达最大尝试次数
-- 数据节点宕机、重启等导致的数据分区切主:分区变更完成后,受影响的数据会被重新传输
-- 集群不可用:集群可用后,受影响的数据会重新传输
-
-### 源端:数据写入与 Pipe 处理、发送数据异步解耦
-
-数据订阅功能中,数据传输采用的是异步复制模式。
-
-数据订阅与写入操作完全脱钩,不存在对写入关键路径的影响。该机制允许框架在保证持续数据订阅的前提下,保持时序数据库的写入速度。
-
-### 源端:可自适应数据写入负载的数据传输策略
-
-支持根据写入负载,动态调整数据传输方式,同步默认使用 TsFile 文件与操作流动态混合传输(`'extractor.realtime.mode'='hybrid'`)。
-
-在数据写入负载高时,优先选择 TsFile 传输的方式。TsFile 压缩比高,节省网络带宽。
-
-在数据写入负载低时,优先选择操作流同步传输的方式。操作流传输实时性高。
-
-### 源端:高可用集群部署时,Pipe 服务高可用
-
-当发送端 IoTDB 为高可用集群部署模式时,数据订阅服务也将是高可用的。 数据订阅框架将监控每个数据节点的数据订阅进度,并定期做轻量级的分布式一致性快照以保存同步状态。
-
-- 当发送端集群某数据节点宕机时,数据订阅框架可以利用一致性快照以及保存在副本上的数据快速恢复同步,以此实现数据订阅服务的高可用。
-- 当发送端集群整体宕机并重启时,数据订阅框架也能使用快照恢复同步服务。
diff --git a/src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Subscription_timecho.md b/src/zh/UserGuide/V1.2.x/User-Manual/Subscription_timecho.md
similarity index 100%
rename from src/zh/UserGuide/V1.2.x/User-Manual/IoTDB-Data-Subscription_timecho.md
rename to src/zh/UserGuide/V1.2.x/User-Manual/Subscription_timecho.md